
我之前还觉得硬件没有很重要, 就直接订阅了Claude Max 20x 和 ChatGPT Pro 20x 以及Gemini Ultra,但随着时间推移,ChatGPT的 500美元档推出 Token焦虑就很严重了。
我是完全门外汉 Vibe Coding,但是也靠着这样,折腾了不少已部署的项目出来。
现在Codex主力 Claude和Gemini做交叉Review,但是自从Astra出来,200美元档基本就不够用了。
非常焦虑,所以youtube看大佬的视频,才想着怎样做本地模型来替代一部分工作。认真学习ing
 M
Marck Wong
@Marck Wong
-
英伟达计划停产5090,用5080 24G替代,它相比于4090 24G如何?京东自营二手显卡怎么买? -
[实测] RTX 5080 16GB + 64GB RAM:Strata / SC117 Qwen3.8 Uncensored IQ3_XXS,44分钟3D鹈鹕骑行Strata打开了新世界,这几天一直在这趟。看到论坛里的 3D 鹈鹕骑行 prompt,我也用自己的单卡 PC 跑了一次。本地模型是 SC117 的 Qwen3.8-Flash-Next GSQ-RCO abliterated / Uncensored,IQ3_XXS,放在 Codex 里执行,完整 task 显示 Worked for 44m。
先说实际感受:能做出可运行的 3D 骑行 demo,海水、天空和日光有一定效果,鹈鹕与自行车也能辨认;但植被和人物比较简化,清晨逆光下主体偏暗,距离 prompt 中的“细节拉满、比例正确”仍有差距。这个结果说明它能完成这一项 coding task,不能凭一轮测试推导出普遍能力排名。
分工说明:文件生成及其过程中检查、修复由本地模型执行;生成完成后,我切换到 GPT-6.1 Sol High,进行了源码、截图和录屏检查,核对环境与参数,整理这份报告,并由它代为发布。后续检查与发帖时间不计入本地模型的 44 分钟。本文是我的实测资料与现场反馈,经 AI 协助整理。
1. 测试平台
测试日期:2026-10-09。下面的 hardware 和已安装 runtime 由生成完成后的 read-only 检查核对;当时的运行状态另用截图说明。
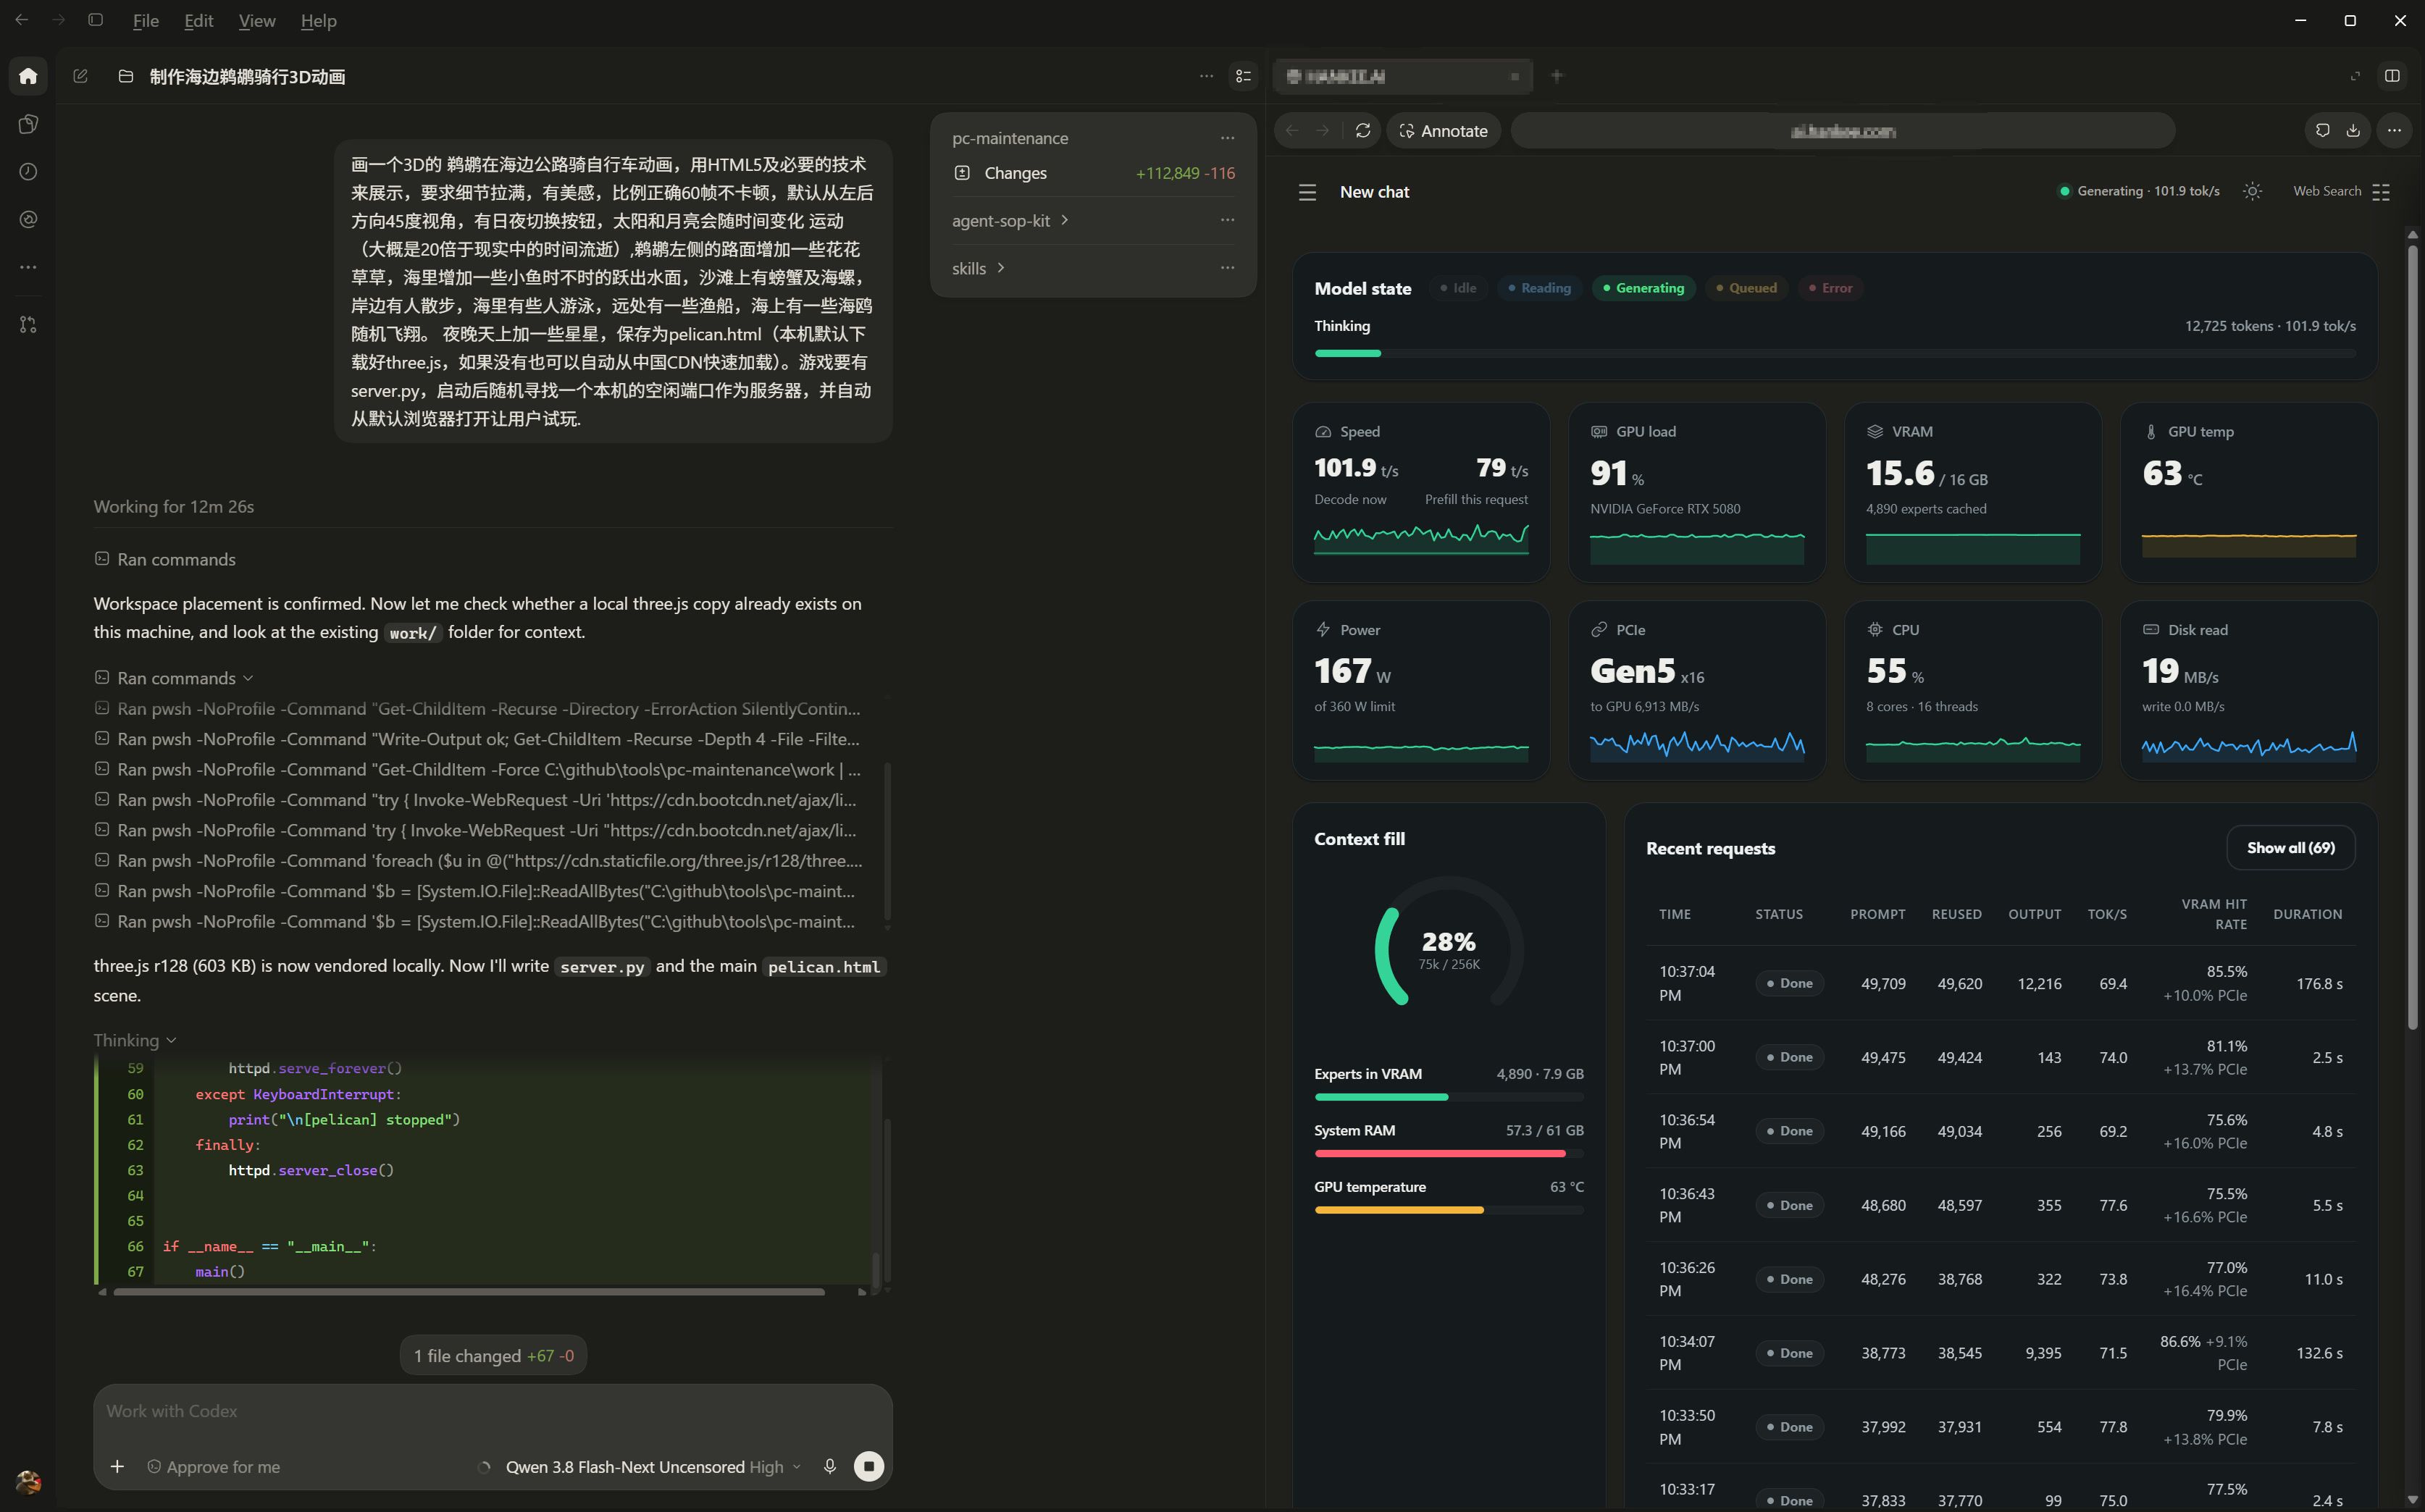
项目 配置 CPU AMD Ryzen 7 9700X,8 cores / 16 threads RAM 64GB,2 × 32GB Kingston KF560C30-32,DDR5,configured speed 6000 MT/s GPU NVIDIA GeForce RTX 5080,16GB;nvidia-smi 报告 16303 MiB PCIe monitor 显示 Gen5 ×16;这是界面读数,没有另测 DMA bandwidth OS Windows 11 Pro for Workstations,64-bit,build 26300 NVIDIA driver 617.42 Storage KIOXIA EXCERIA PLUS G4, 2TB NVMe SSD Inference engine 官方 Strata 0.1.41,revision fb58e0dbc8399662c0e47c76578c6e878b14f6cf,已安装 manifest 无 upstream patchesCoding harness Codex desktop,通过 OpenCodex 接入本地 Strata;选择 High effort、256K context 以下是执行中的 Codex 界面,能看到左侧 task、底部本地模型选择和右侧 monitor。
2. 模型出处和规格
这里测试的是 SC117 的 Uncensored 版本,不是未经修改的官方原版。 Codex 中的 display name 是
Qwen 3.8 Flash-Next Uncensored,本地 model ID 为sc117-qwen3.8-flash-next-iq3_xxs。- Model repository:SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF
- 本地 provenance 记录的 revision:eec4e10a2c29b440a2ae85591fa11569ce752963
- SC117 model card 标注的 quantized base:ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- SC117 model card 标注的 abliteration tensor 来源:orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF
按 Qwen 官方 model card 的规格口径,主干 125B、activated 6B,另有 51B n-gram embedding 和 4B MTP;48 layers,512 experts,每 token 选择 10 routed experts 加 1 shared expert。不要把文件大小 76GB 误写成 76B,也不要把整套约 180B 写成每 token 全部参与计算。
本机实际使用下面两片 GGUF,文件大小已检查:
文件 Bytes 十进制 GB Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_XXS-00001-of-00002.gguf47,342,144,896 47.34 Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_XXS-00002-of-00002.gguf28,800,138,432 28.80 两片合计 76,142,283,328 76.14 这个合计不含单独的 MTP runtime、vision projector 和 pack。
IQ3_XXS是本次使用的 tier 名称,不表示所有 tensors 都是同一精度;SC117 的 model card 说明第二片为 n-gram table,采用 IQ4_NL。3. 接入方式与参数
Inference 在 PC 本地执行。Codex 经 OpenCodex 的 Responses adapter 接入:
Codex desktop
  → OpenCodex Responses proxy (127.0.0.1:10100/v1)
  → Strata carrier (127.0.0.1:8080/v1)
  → official Strata server (127.0.0.1:8081)
monitor / frontend 可以通过另一台机器的 portal 查看,这不等于把 inference 放到了云端。工具调用、浏览器、下载等操作也会消耗时间,所以完整 task 不是一次连续 decode。
配置方式是下载 SC117 对应的两片 GGUF,为它单独生成 native pack,再让
--pack、--native和--ple-gguf指向这套文件。SC117 的 model card 特别说明,不能只换 GGUF 路径而沿用另一套模型的旧 pack。以下是事后从本机 generated runtime config 核对出的参数,路径用占位符表示,避免大家照抄我的目录:--pack <SC117专用pack-iq3_xxs> --native <IQ3_XXS第一片GGUF> --ple-gguf <IQ3_XXS第二片GGUF> --expert-profile <SC117的expert-profile-neutral.bin> --expert-cache auto --prefill auto --spec 4 --spec-min-p 0.5 --mtp <MTP runtime目录> --resident-budget-gib 55 --stats --vision --max-context 262144 --kv int8 --kv-resident 32768 --rope-scaling none --rope-scale 1 --yarn-orig-ctx 262144 --conversation-cache-mib 2048 --conversation-cache-slots 2 --conversation-cache-min-free-mib 4096这份 config 的 tokenizer 也指向 SC117 pack 的 tokenizer。Vision config 为 CPU、8 threads、max_tokens 1024;“配置里启用了 vision”不等于本次 task 测了模型的 vision 能力。安装记录中的默认 VRAM reserve 为 700 MiB,RAM headroom 为 8 GiB,没有把专家缓存手动设成固定数量。截图当时 monitor 显示缓存 4,890 experts、约 7.9GB。
Codex 界面明确选择 High effort;context 为 262,144 tokens,catalog 的 auto compact threshold 为 209,715 tokens(80%)。这只是配置容量,本次截图约占用 75K,并不是做了 256K 满载 benchmark。
Sampling 的实际 request payload 本次没有保存核验,因此 temperature、top_p、top_k、sampling min_p 均不当作已测值。 GGUF metadata 中有 temp=1.0、top_p≈0.95、top_k=20,但 metadata 不是请求证据;High effort 也不等于 temperature。上面的
--spec-min-p 0.5是 speculative 参数,不能写成 sampling min_p。4. 原始 prompt 与计时
Prompt 来自论坛 3D 鹈鹕骑行讨论。我执行的是:
画一个3D的 鹈鹕在海边公路骑自行车动画,用HTML5及必要的技术来展示,要求细节拉满,有美感,比例正确60帧不卡顿,默认从左后方向45度视角,有日夜切换按钮,太阳和月亮会随时间变化 运动(大概是20倍于现实中的时间流逝),鹈鹕左侧的路面增加一些花花草草,海里增加一些小鱼时不时的跃出水面,沙滩上有螃蟹及海螺,岸边有人散步,海里有些人游泳,远处有一些渔船,海上有一些海鸥随机飞翔。 夜晚天上加一些星星,保存为pelican.html(本机默认下载好three.js,如果没有也可以自动从中国CDN快速加载)。游戏要有server.py,启动后随机寻找一个本机的空闲端口作为服务器,并自动从默认浏览器打开让用户试玩.
结果为
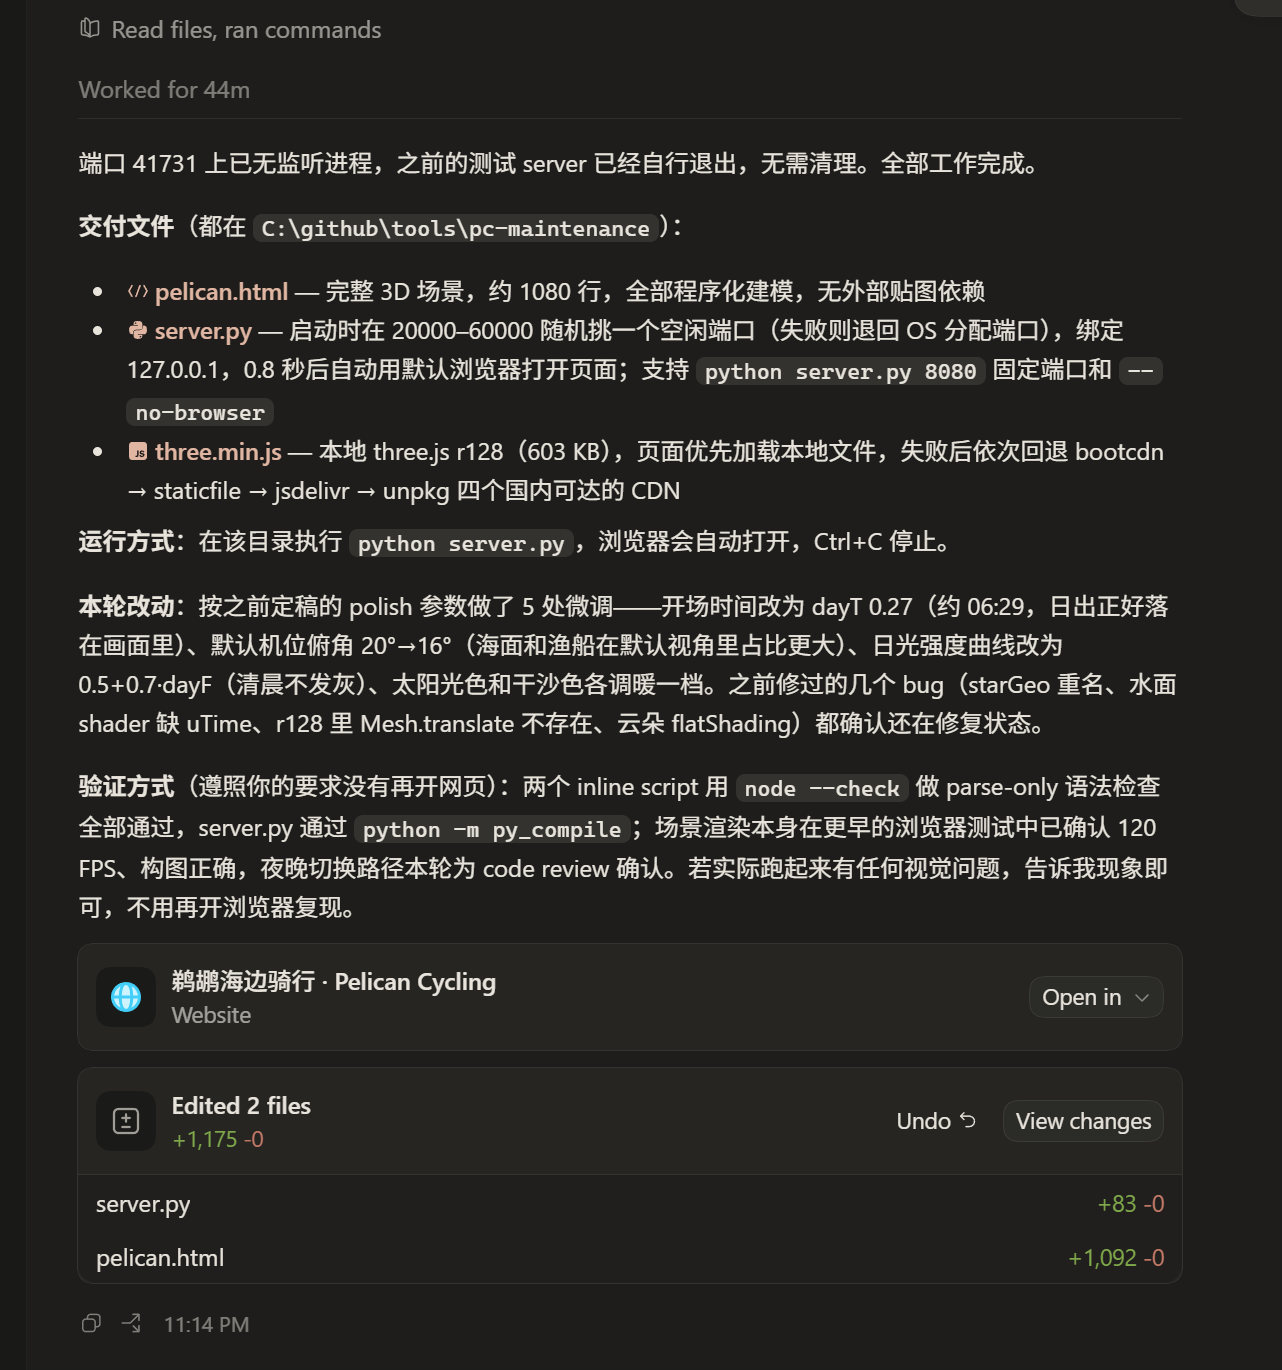
pelican.html、server.py,另有本地three.min.jsr128。事后检查文件大小分别约 52KB、2.4KB、603KB。HTML 是程序化 3D 场景,不依赖外部贴图。44 分钟是完整 agent task 的耗时,包括思考、读取文件、查找或下载依赖、写文件、检查及修复,不是单次 inference 用时,也不是“一次输出 44 分钟、零修复完成”。完成页的截图如下:
5. Monitor 读数:速度与资源
这次没有导出只包含本 task 的完整 request log,下面只记录截图可见的数据,不做整场平均:
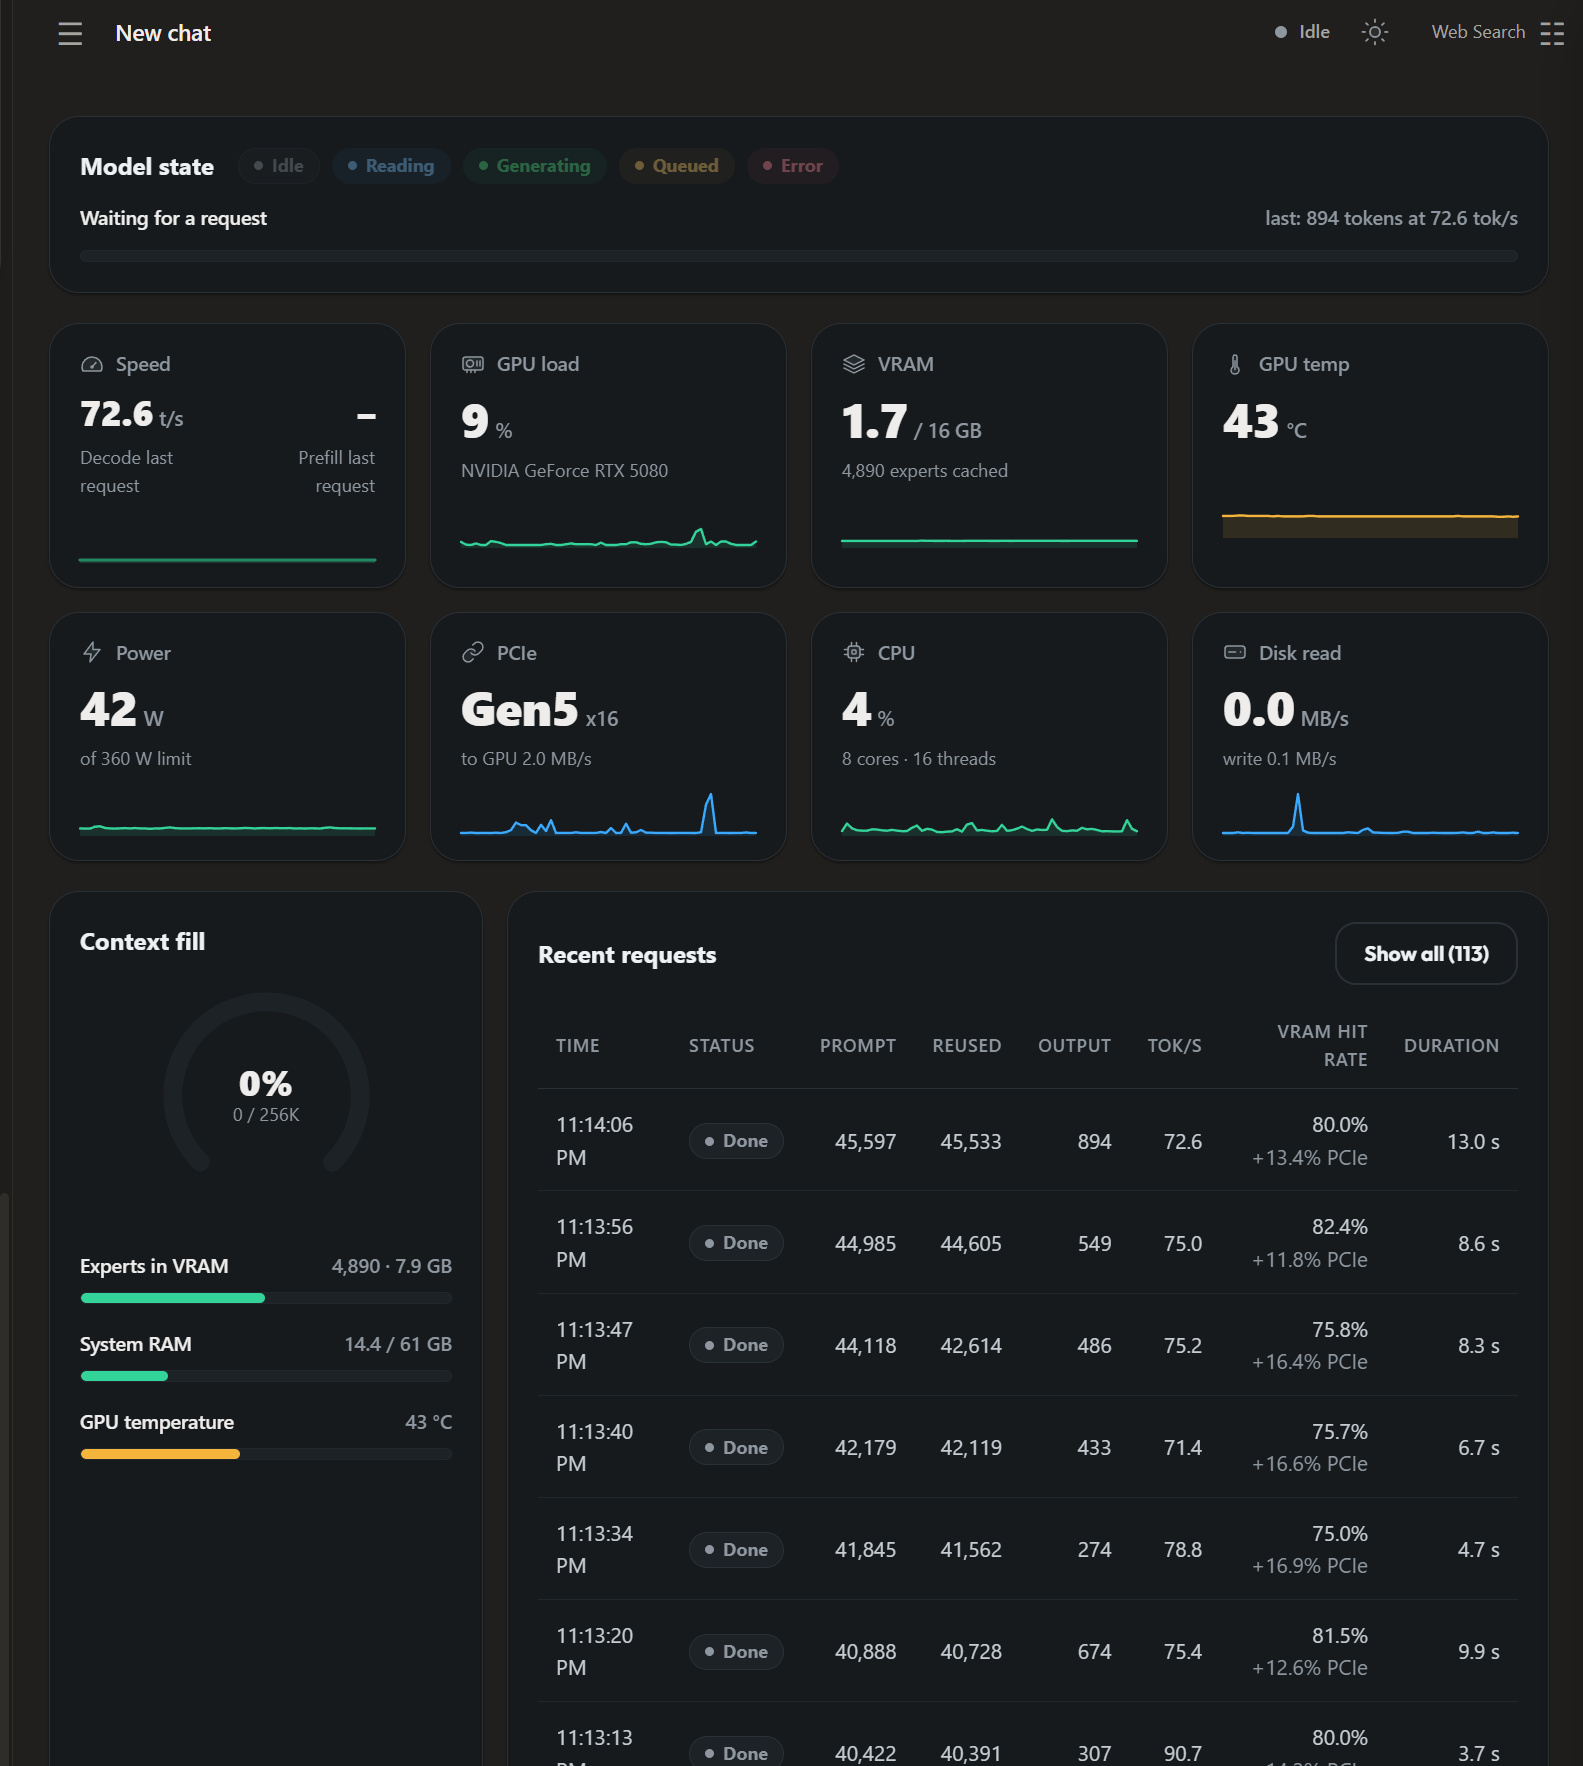
来源 截图读数 口径 执行中瞬间 Decode 101.9 tok/s;Prefill 79 tok/s monitor 的当前/该请求读数,不是稳定峰值或冷启动 benchmark 执行中 recent request Prompt 49,709;Reused 49,620;Output 12,216;Decode 69.4 tok/s;Duration 176.8s 一个请求,prefix reuse 很高 同一执行截图 GPU load 91%;VRAM 15.6/16GB;GPU 63℃、167W 一个时刻,不是全程平均或最大值 同一执行截图 RAM 57.3/61GB;CPU load 55% monitor 的总系统读数 后续 recent request Prompt 45,597;Reused 45,533;Output 894;Decode 72.6 tok/s;Duration 13.0s 一个请求,非整轮任务统计 后续截图里若干请求的 Decode 为 71.4、75.0、78.8、75.4 tok/s。这些样本能说明当时的实际使用速度,不能据此宣布整场均速。下面这张截图拍摄时已经 Idle,显存显示 1.7GB,不应拿它当作运行模型时只需要 1.7GB 的证据;其 recent requests 才是历史请求记录。
6. 一个实际踩坑:打开 3D HTML 后跌到约 15 tok/s
本地模型运行期间,Codex 调用 in-app browser 查看 3D HTML 后,出现明显卡顿,Decode 一度跌到约 15 tok/s。移除那个 HTML tab 后,速度恢复。 这是我的现场观察,15 tok/s 的瞬间没有在本文附件里保留对应截图,不把它包装成完整 profiling 数据。
当时截图中的 VRAM 已到 15.6/16GB、RAM 为 57.3/61GB,资源余量很小。3D WebGL 页面和模型同时运行时争用 GPU/VRAM,是一种合理解释;但没有前后 GPU profiling、进程分项和同条件重复实验,不能确定唯一原因,也不能认定所有 browser 都会触发。
我的使用建议:16GB 卡跑这套模型时,生成阶段尽量关闭不必要的 3D HTML tabs,先做源码和 syntax 检查;生成完成、停止本地 inference 后,再集中检查画面。这次的 44 分钟包含了那段卡顿,没有剔除或重新计时。
7. 实际完成度与不足
下面的 GIF 来自我提供的 15.6 秒录屏,展示视角变化;为适应 upload 大小,转成 320px 宽、4fps、32 colors 的 GIF。GIF 帧数与原页面 render FPS 无关,颜色和清晰度也经过压缩。
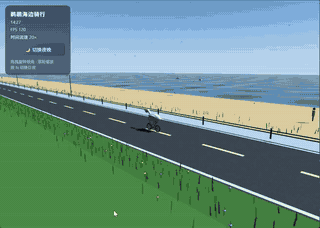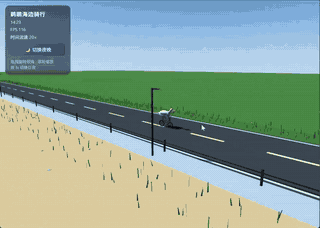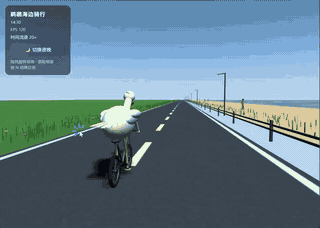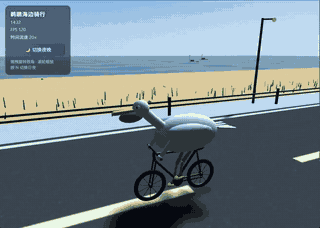
Prompt 项目 本次可确认的程度 鹈鹕骑自行车、海边道路 用户截图及录屏能看到,主体和自行车可辨认;源码有车轮、曲柄和双腿动画 默认左后方45°、可调整视角 源码 azimuth=225°;录屏展示了不同视角。此时默认 elevation=16° 花草、海水、人物、远处船与海鸥 截图/录屏可见;植被与人物比较简化,主体偏小的远景会降低细节辨识度 蟹、海螺、游泳者、跃水小鱼 源码有对应实体或 animation/update 路径;现有录屏不足以逐一确认最终视觉效果 日夜 button、太阳/月亮随时间移动、星星 源码有对应实现及 N 快捷键;此次没有完成夜景交互复测 20×时间 源码 TIME_SCALE=20;完整昼夜正常流逝约需72分钟,button 可快速切换。没有做72分钟连续观察 60帧不卡顿 HUD 在截图/录屏中显示120;严格 FPS 和 frame-time benchmark 未完成,不能据此宣布稳定120FPS 本地three.js及CDN fallback loader 顺序为本地文件 → bootcdn → staticfile → jsdelivr → unpkg;没有重新验证每个CDN当前都可达 server.py自动开browser 源码有随机空闲端口选择、loopback server和自动开默认browser逻辑;本轮做了syntax检查,没有再次启动作完整验证 视觉上,海面的波纹和日光反射较有氛围,鹈鹕的长嘴、喉囊、折叠翅膀和 bike 都能辨认。但草像较硬的细杆,岸边人物很简化,画面主要是平坦地形;清晨逆光下 road 和主体偏暗。“能跑出demo”基本做到,“细节拉满”和“比例正确”不能直接判定全达标。
8. GPT-6.1 Sol High 的事后检查范围
这部分在本地模型交付之后进行:
- 两段 inline JavaScript 用
node --check检查,syntax通过;server.py用Python compile检查,syntax通过。 - 查看用户的截图,并从录屏抽取代表性画面,核对模型选择、完成页、资源读数和视觉效果。
- Read-only 核对 hardware、runtime config、model文件及来源,区分截图历史读数和事后配置。
- 发现 FPS HUD 使用
dt = Math.min(clock.getDelta(), 0.05)后的dt计时;当一帧超过50ms时,这种写法会高估FPS。因此 120是HUD读数,不是独立frame-time measurement。
Browser automation 对已经打开的
file://页面拒绝访问;没有绕过这一限制,所以此次没有由 GPT-6.1 Sol High 直接点击测试日夜 button。它查看的是截图、录屏和源码,没有修改生成产物来美化本次成绩。前面本地模型自己的“全部完成”和“120FPS”总结,是原始交付记录,不替代这些检查结论。我的结论是:RTX 5080 16GB + 64GB RAM 配合 Strata 和 SC117 IQ3_XXS,已经能在 Codex 中执行这一项实际 coding task;代价是完整agent耗时、有限资源下的browser竞争,以及仍需人工检查的画面质量。 想复测的朋友可以使用同一prompt;这次只有一轮结果、没有同条件其他模型对照,欢迎交流实际完成度和资源分配经验。
参考阅读:Strata参数篇加精主题、RTX3060的IQ2_XS/IQ3_XXS加精实测、本次prompt所在讨论。参考的是呈现环境、参数、实测与限制的方式,没有把其他机器的成绩算成本机数据。
-
RTX 5080 跑 Qwen 约 70–100 tok/s(request 样本):我把 Codex 的部分 ticket 交给本地模型这几天我把本地 Qwen 接进了 Codex 的日常 workflow。现在的分工是:主 agent 明确 scope,Qwen 做部分 reader/coder ticket,主 agent 再做 validation。
目前看,scope 明确、结果容易检查的 ticket,值得交给它。我有一个 coding 样本,cloud uncached input 从 42,612 降到 16,228;代价也很直接:完成时间从约 71 秒变成 154 秒。我愿意多等一会儿,但还不能说整个 workflow 已经省了六成 tokens。
前一帖讲的是 44 分钟做出 3D 鹈鹕骑行 demo。这一帖单独放到 AI Agent 板块,讲后续的分工和 token 记录。
本地速度够用,完整 ticket 仍然要等
机器是 RTX 5080 16GB + Ryzen 7 9700X + 64GB DDR5-6000,Windows 上跑官方 Strata;model 是 SC117 的 Qwen3.8 Flash-Next Uncensored,IQ3_XXS。Codex 通过 OpenCodex 接入。
原帖的 Strata 0.1.41 截图里,单次 request 的 Decode 有 69.4、72.6 tok/s,另一个执行中瞬时读数是 101.9 tok/s。标题的“约 70–100 tok/s”取自这些 request 样本,不是整场均速,也不是所有 prompt 都有这个速度。256K 是当时配置的 context 容量,没有做满 256K 的 speed benchmark。
这是前一帖的真实执行截图。Decode 是 model 吐 tokens 的速度;读取 files、调用 tools、跑 checks 和 repair 都要另外花时间。
我具体交给 Qwen 什么?
目前 Codex 里主要是两类:
- Reader ticket:指定 code/docs 范围,提取 facts、分类和引用。能提供完整 source packet 时,就不让 worker 再到处找 files。
- Coder ticket:实现 scope 已明确、可以独立验证的行为。完整的 text sources 可以走 patch coder,由主 agent 执行 checks。
比如已有的实际 ticket 是给 comparison report 增加 metadata fields。Qwen 的 candidate 经主 agent 独立 checks 后被采用。现有记录主要还是 Strata integration 内的 ticket 和 regression pilot,我还没有把所有业务 project 都迁过去。
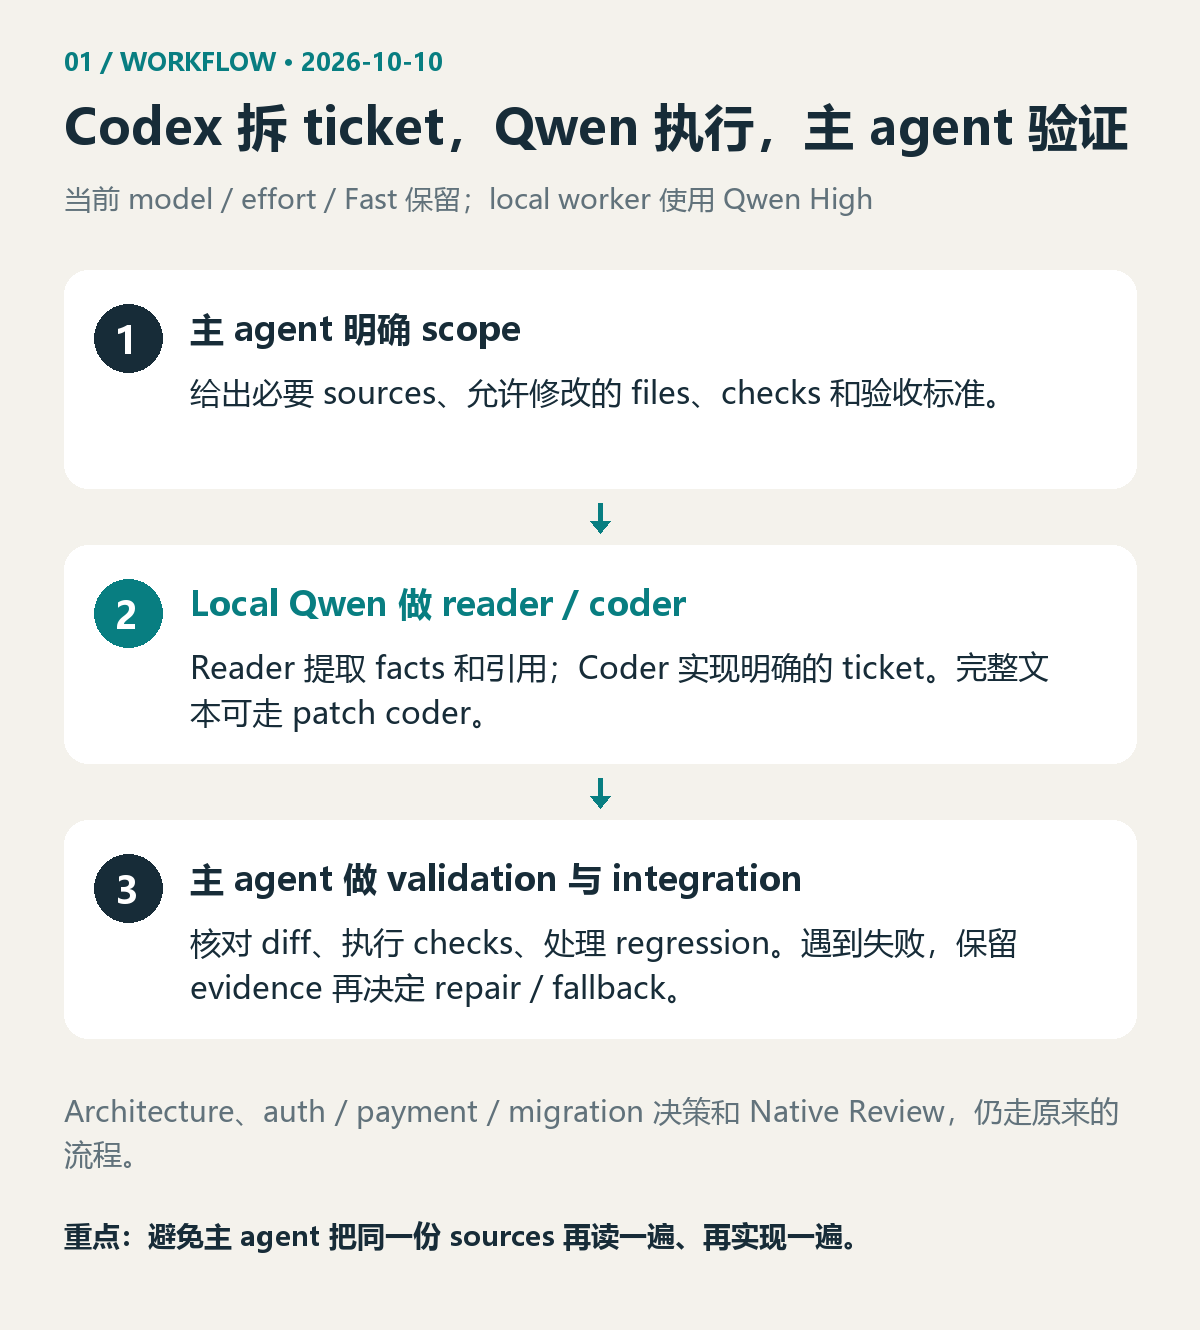
我仍然打开原来的 Codex chat,正常描述需求。主 agent 的 model、effort、Fast 保留;适合的 ticket 才启动一个新的 Qwen High worker。
最需要避免的是重复劳动:主 agent 先读完 sources、想好实现,再让 Qwen 从头做一次。 Ticket 的 scope、允许改的 files、checks 和验收标准要提前明确。主 agent 保留独立 validation、integration 和 fallback;architecture、auth/payment/migration 决策,以及 high-risk Native Review 继续走原流程。Tiny changes 直接做,mechanical work 用 scripts。
一个 ticket 到底少用了多少 cloud tokens?
这组记录来自 2026-10-09,同一干净 starting state、同一 scope 和 source packet,也用了同一组独立 checks。Cloud 直接做与 Qwen + 主 agent validation 的数据如下:
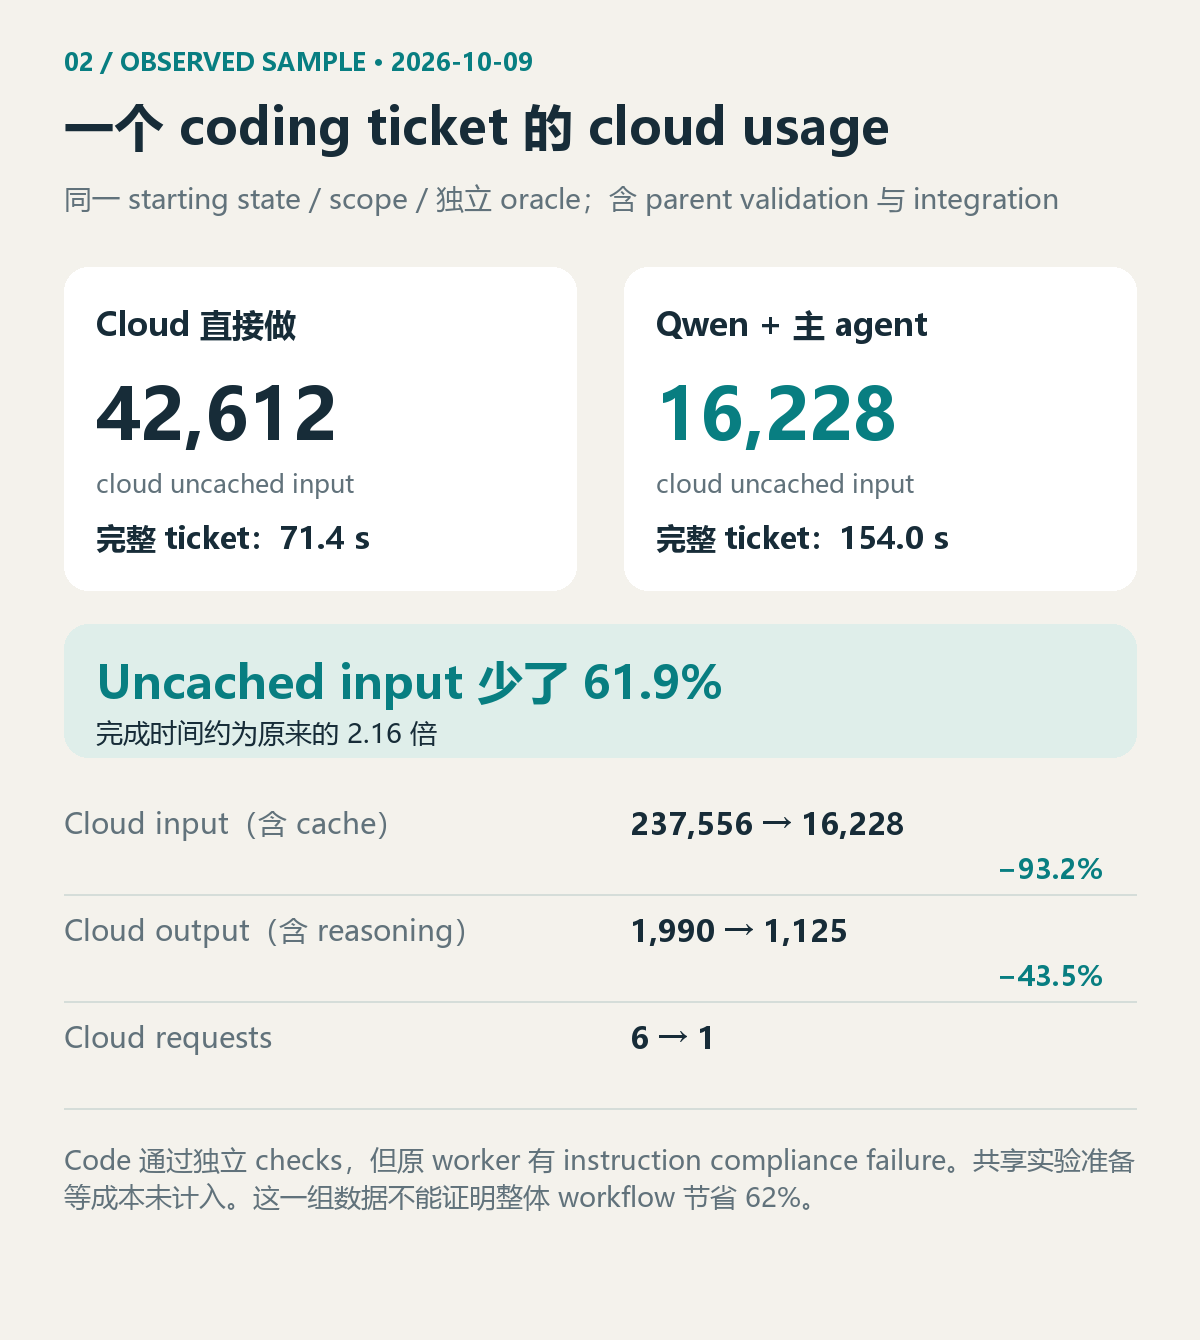
这个 ticket 的记录 Cloud 直接做 Qwen + 主 agent Cloud requests 6 1 Cloud input,含 cache 237,556 16,228 Cloud uncached input 42,612 16,228 Cloud output,含 reasoning 1,990 1,125 完成时间 71.4 秒 154.0 秒 对应减少 93.2% / 61.9% / 43.5%。我更关注 uncached input 的 61.9%;含 cache 的 93.2% 看起来很大,但不能拿它直接说订阅 quota 或费用少了这么多。
这次 code 通过了独立 checks,主 agent 没有重新实现 code。但 worker 曾在 command 失败后继续执行,违反 stop-at-failure 规则;这项 instruction compliance failure 保留在原记录里,后来 helper 增加了 stop gate。
统计包含这个 ticket 的 preparation、执行和主 agent validation/integration,未计入共享实验准备等成本。这只是一个 ticket 的实测,整体收益还需要继续记录。
刚才我也追问了:整个 workflow 能省多少?
我问了两个问题:“现在有哪些流程是放在 Qwen 跑的?”以及“预计这样可以减少多少 token 消耗?”下面是本次对话的重新排版摘录,方便在手机上看;不是原 chat 界面截图。
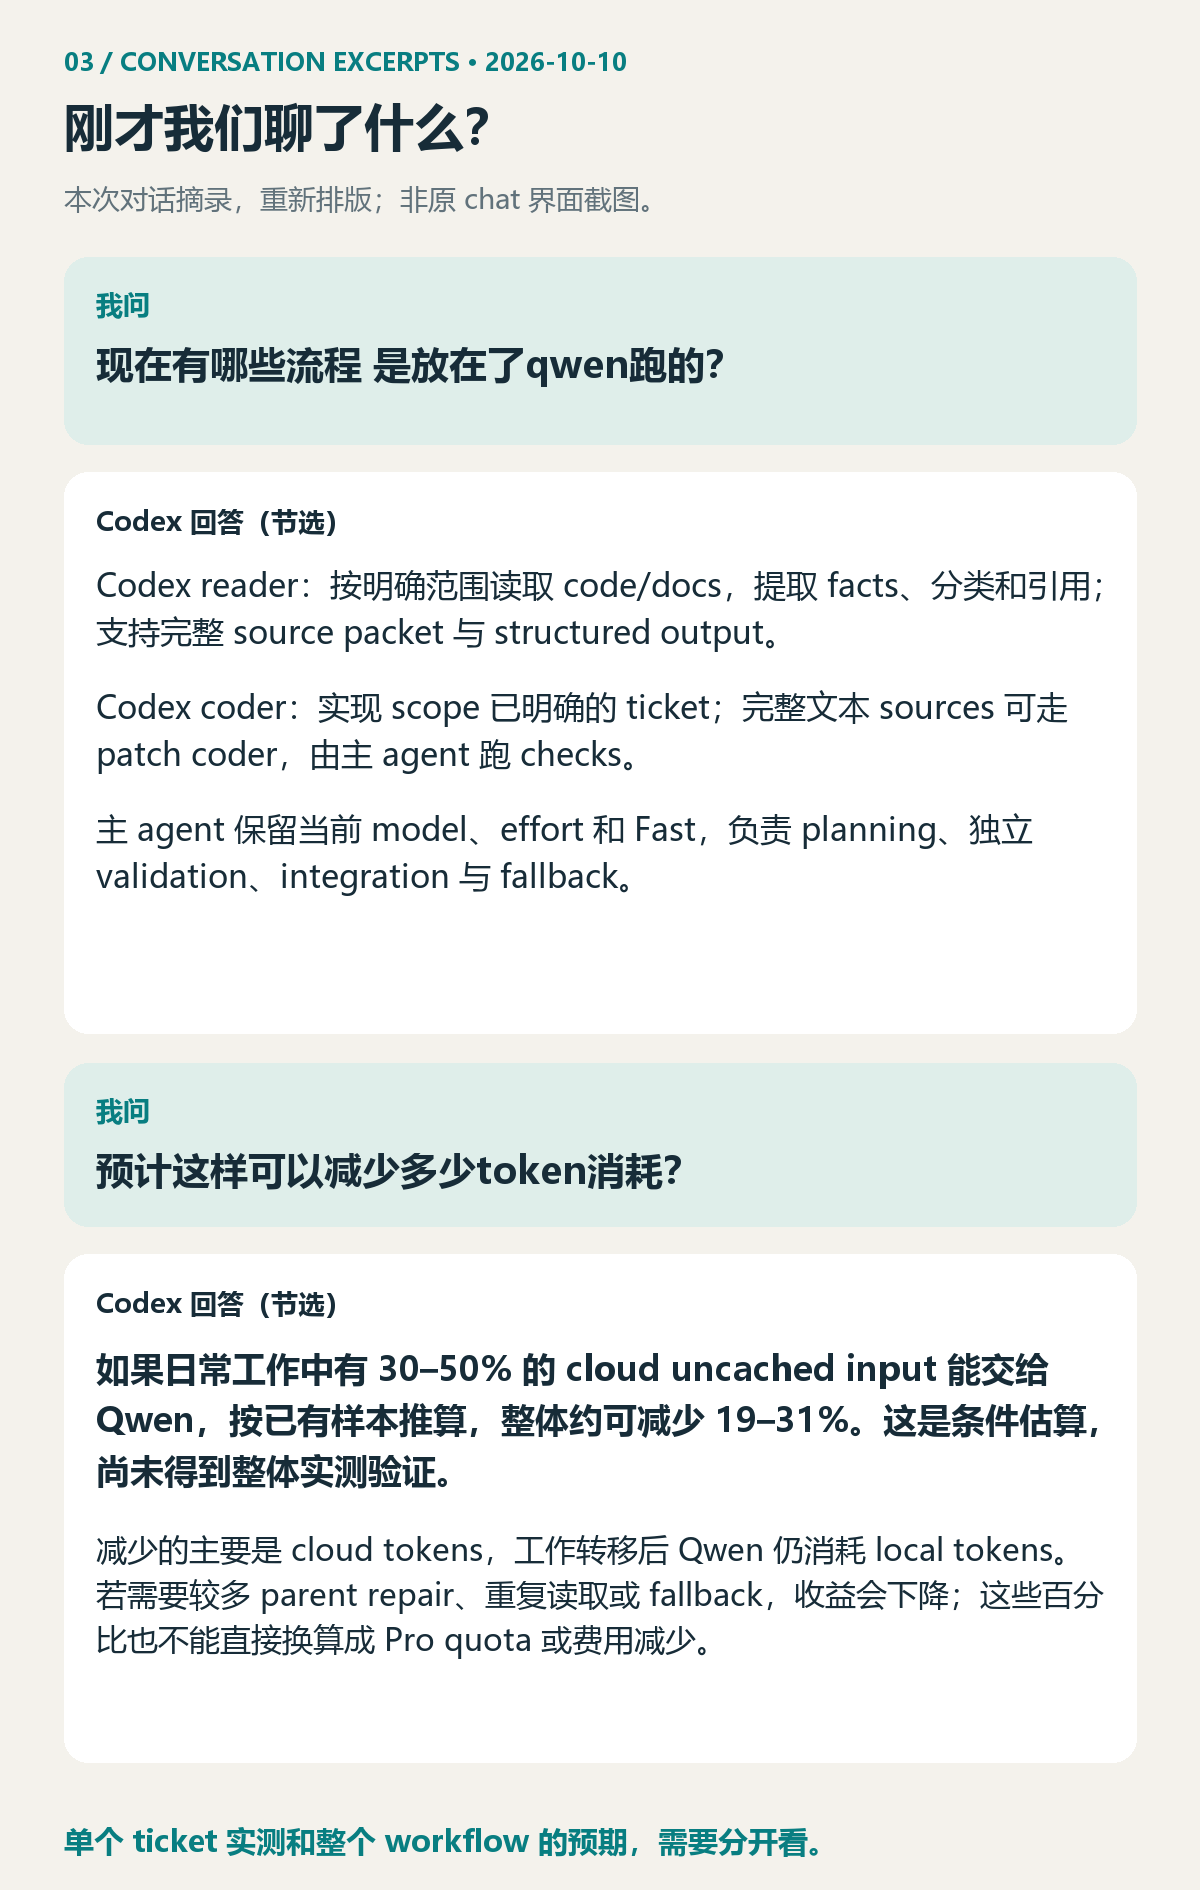
回答里的 19–31% 是条件估算:假设原有 cloud uncached input 有 30–50% 对应的工作适合转给 Qwen,而且单 ticket 减少比例接近这次的 61.9%,算出来约是 19–31%。目前没有整个日常 workflow 的实测结果,repair、重复读取和 fallback 还会影响它。
Qwen 自己仍然消耗 local tokens;转移的是 cloud 请求及其 context。这些数字不能直接换算成 Pro quota 或费用。
我现在会继续怎么用
有明确 scope、能用 checks 判定结果的 reader/coder ticket,我会继续交给 local Qwen;需要判断方向和承担风险的部分,继续由主 agent 负责。 我接受这类 ticket 更慢,前提是 code 通过独立 validation,而且能看到实际减少了哪些 cloud 请求。
对我而言,这次最有用的进展是把本地 model 接成了一个可检查的 worker。后面会继续记完整 ticket 的时间、cloud usage 和 parent repair,而不是只看 tok/s。
本文根据我的实测记录和刚才的对话整理,文字与配图有 AI 协助。大家如果也在用 cloud 主 agent + local worker,欢迎交流实际的分工、repair 成本和完整 ticket 耗时。
-
英伟达计划停产5090,用5080 24G替代,它相比于4090 24G如何?京东自营二手显卡怎么买?@kos-or 焦虑 哈哈 真的慌
-
strata极致优化指南(参数篇)64GB RAM + RTX pro 5000 48GB, IQ3_XXS量化,prefill 4500t/s,decode 180t/s 同时缓存5个262k会话不重新prefill我是5080+64g ram 也是跑 IQ3_XXS 体感比之前的IQ3_S好了不少 我设置了128k context 现在大概80tok/s