
终于看到有人用单独的 vision 方案了,我一直这么用。
-
我的4×3090终于不再“绑在一起”:双卡200K MoE + 单卡Vision Sidecar,本地Agent开始Token自由 -
把只支持 5090 的推理引擎跑在 4090/4080 上,性能全面超过 SGLang在 Ada 上跑 NInfer:RTX 4090 + 4080 双卡部署记
NInfer 是一个为 RTX 5090 单卡硬编码的手写 C++/CUDA 推理引擎,CMake 第 9 行就拒绝任何非
sm_120a架构。借助一个被上游拒收的社区移植分支,我们把它跑在了 RTX 4090 与 4080 上,两张卡都全面超过原先的 SGLang 部署。日期 2026-09-15 主机 Ubuntu 24.04.4 · 内核 7.0.0-31-generic 模型 Qwen3.8-27B-Uncensored-NInfer · groupwise-int · 18.21 GB 状态 已接入生产客户端 RTX 4090 RTX 4080 --- --- --- 显存 49,140 MiB 32,760 MiB 端口 / model-id :8001 / 4090:8002 / 4080并发 3 2 KV 池 786,432 350,208 可同时吃满 262K 的通道 3 1 decode 单路 115.5 tok/s 88.2 tok/s decode 满并发 207.5 tok/s(3 路) 128.1 tok/s(2 路) prefill(长上下文) 1,068 tok/s 701 tok/s 权重 / 启动后空闲 16.9 / 1.98 GiB 16.9 / 1.13 GiB 启动耗时 12.0 s 12.0 s
一、环境与构建
上游
Neroued/ninfer的 CMake 对非sm_120a直接FATAL_ERROR,官方只支持 RTX 5090。下面用的是社区的 Ada 移植分支memoriaru/ninfer的sm89-ada-port(1 个 commit、18 个文件,上游以「难以维护」为由拒收,已落后上游 93 个 commit,想跟进得自己 rebase)。组件 版本 / 值 OS / 内核 Ubuntu 24.04.4 LTS · 7.0.0-31-generic GPU 0 RTX 4090 · 49,140 MiB · UUID GPU-aaaaaaaa-…(nvidia-smi -L查)GPU 1 RTX 4080 · 32,760 MiB · UUID GPU-bbbbbbbb-…驱动 580.159.04(只支持到 CUDA 13.0) CUDA 工具链 13.1.115(NInfer 硬要求 ≥ 13.1) 源码 memoriaru/ninfer@baf9feb3e41039c7ce92323b9f4f0f732e120866二进制 ninfer-serve177 MiB模型 fullmetaljackass/Qwen3.8-27B-Uncensored-NInfer· 18.21 GB · groupwise-int驱动版本差一档,但能跑。 驱动 580.159.04 报告支持到 CUDA 13.0,而引擎要求工具链 ≥ 13.1。靠 CUDA minor version compatibility——13.1 编出的二进制能跑在支持 13.0 的驱动上——实测无问题,全程零运行期错误。不需要升级驱动。
# 1. 工具链(与系统原有 CUDA 12.8 并存,不动 /usr/local/cuda 符号链接)
sudo apt-get install -y cuda-toolkit-13-1
sudo apt-get install -y pkg-config libavformat-dev libavcodec-dev \
                        libavutil-dev libswscale-dev libcurl4-openssl-dev

# 2. 源码
git clone --depth 1 --branch sm89-ada-port \
    https://github.com/memoriaru/ninfer.git src

# 3. 配置 —— 打印 "arch=89 NVFP4=OFF" 即为正确
cmake -S src -B build -G Ninja -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES=89 \
  -DCMAKE_CUDA_COMPILER=/usr/local/cuda-13.1/bin/nvcc \
  -DCUDAToolkit_ROOT=/usr/local/cuda-13.1 \
  -DNINFER_BUILD_APPS=ON

# 4. 编译 —— 288 步,零错误
ninja -C build -j6
FFmpeg 那几个 dev 包是视频/多模态路径的硬依赖,缺了 CMake 直接失败。系统里有运行时库不够,必须有头文件和
.pc。Ubuntu 24.04 自带的 FFmpeg 6.1.1 正好满足版本下限(libavformat 60 / libavcodec 60 / libavutil 58 / libswscale 7)。编译耗时最久的单个文件是
src/ops/linear/w8/w8_small_t.cu——正是移植里被改造的那个(136 个 kernel 实例从静态共享内存挪到动态)。它编过了,就说明那套绕开 48 KB 限制的办法在 Ada 上成立。
二、跑的是什么模型
下载地址:https://huggingface.co/fullmetaljackass/Qwen3.8-27B-Uncensored-NInfer
格式 / 体积 .ninfer单文件 · 18.21 GB ·weights_id: groupwise-int基座 orcarouter/Qwen3.8-27B-Uncensored←Qwen/Qwen3.8-27B能力 文本 + 视觉 + MTP 投机解码 · 上下文 262,144 · 中英 许可 Apache-2.0 架构是 Qwen3.8-27B:64 层 dense,其中 16 层 full-attention + 48 层 linear-attention(GDN)——这个混合结构决定了 KV 只要 32.4 KB/token。
三点要注意:
- 仓库里只有 3 个文件(
.gitattributes/README.md/.ninfer),没有 safetensors、config.json、tokenizer——全部内嵌在单文件里。这个格式只能给 NInfer 用,喂不了 vLLM / SGLang / llama.cpp。 - 标签里写着
RTX-5090:打包者的目标平台是 Blackwell。Ada 能跑是本文移植的结果,不是发布者的承诺。 - ★必须选
groupwise-int的 artifact。同一个模型的 NVFP4 版本在 Ada 上永远不能用(FP4 张量核是 Blackwell 硬件)。判别方法:.ninfer文件开头是明文 JSON manifest,用 HTTP Range 取前 1.5 MB 就能读出identity.weights_id,不必下整个 18 GB。
三、RTX 4090:NInfer 对比 SGLang
同一天、同一张卡、同一段 prompt、同一套计时方法,512 token 输出,关闭 thinking。这是本文里最干净的一组对照。
项目 SGLang 0.5.19 NInfer 变化 模型 twolven abliterated W4-AWQ · 19 GB Uncensored groupwise-int · 18.2 GB 换了基座 KV 数据类型 fp8_e4m3 int8 — KV 池 451,959 786,432 +74% 单请求上下文 262,144 262,144 持平 并发上限 2 3 +1 可同时吃满 262K 的通道 1 3 ×3 投机解码 NEXTN 树形 topk4/steps5/draft16 MTP 线性 draft3 + lm-head-draft 降级为线性 启动耗时 ~82 s 12.0 s −85% 启动后空闲显存 4.16 GB 1.98 GiB 更紧 decode 单路 101.4 115.5 +14% decode 双路合计 173.2 178.3 +3% decode 三路合计 配置上限 2,未测 207.5 — prefill(长上下文) ~1,115 @207K 1,068 @249,952 基本持平 一个漂亮的整除:
--max-concurrency 3配--kv-capacity auto,引擎解出的 KV 池是 786,432 = 3 × 262,144,页表12,288 / 12,288也刚好用满。3 是「每一路都能吃满满上下文」的最大档,4 路需要 1,048,576,差 26 万装不下。对比之下 SGLang 的 451,959 连两路满上下文(524,288)都装不下——第二路会在准入阶段被
AddReqResult.NO_TOKEN直接拒绝。两处口径说明:
- SGLang 的三路那一栏不是「测了跑不动」,是配置上做不到——
--max-running-requests 2写死了。短请求场景下它未必输,把上限调到 3 再测大概率也能跑。NInfer 站得住的优势是长上下文:786,432 的池子能让三路同时吃满 262K。 - SGLang 那个 prefill 数字采集时有其它客户端并发流量,被污染过,可比性一般。
四、RTX 4080:NInfer 对比 SGLang
4080 上原本跑的是另一个模型(cyankiwi AWQ-INT4),所以这组对照不如 4090 那组严格,配置差异已逐项列出。
项目 SGLang 0.5.19 NInfer 变化 模型 cyankiwi AWQ-INT4 Uncensored groupwise-int 换了模型 KV 池 151,419 350,208 +131% 单请求上下文 147,456 262,144 +78% 并发上限 1 2 +1 投机解码 NEXTN 链式 topk1/steps5/draft6 MTP 线性 draft3 + lm-head-draft — 启动后空闲显存 2.97 GB 1.13 GiB 更紧 decode 单路 未测该模型 88.2 见下 decode 双路合计 并发上限 1 128.1 — prefill(长上下文) 未测 701 @200,932 — 4080 的速度对照要打折看。 被替换掉的那个 SGLang 服务(cyankiwi AWQ-INT4)我们没有测过它的 tok/s。同一张卡上另一个模型 twolven-AWQ 的历史记录是 56–64 tok/s(峰值 68,2026-08-21,上下文 131,072)。拿它和 NInfer 的 88.2 比是 +40~55%——但那是不同模型、不同日期、不同上下文长度的数字,只能当指示性参考,不能当严格 A/B。4090 那一组才是同日同条件的干净对照。
五、启动器与服务单元
两张卡用同一个二进制、同一个 artifact,靠
CUDA_VISIBLE_DEVICES绑 UUID 区分,端口与--model-id沿用原 SGLang 的值,客户端零改动。/data/launchers/start-ninfer-4090.sh#!/bin/bash export CUDA_VISIBLE_DEVICES=GPU-aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa export LD_LIBRARY_PATH=/usr/local/cuda-13.1/lib64:$LD_LIBRARY_PATH exec /data/ninfer-build/build/apps/ninfer-serve \ /data/ninfer-models/qwen3_8_27b_uncensored.ninfer \ --host 0.0.0.0 --port 8001 --model-id 4090 \ --max-context 262144 --kv-capacity auto --max-concurrency 3 \ --kv-dtype int8 --vision \ --spec mtp --draft-tokens 3 --lm-head-draft \ --pending-timeout-ms 600000 \ --request-log-jsonl /data/ninfer-build/reqlog-4090.jsonl \ --log-stats-interval-ms 5000/data/launchers/start-ninfer-4080.sh#!/bin/bash export CUDA_VISIBLE_DEVICES=GPU-bbbbbbbb-bbbb-bbbb-bbbb-bbbbbbbbbbbb export LD_LIBRARY_PATH=/usr/local/cuda-13.1/lib64:$LD_LIBRARY_PATH exec /data/ninfer-build/build/apps/ninfer-serve \ /data/ninfer-models/qwen3_8_27b_uncensored.ninfer \ --host 0.0.0.0 --port 8002 --model-id 4080 \ --max-context 262144 --kv-capacity auto --max-concurrency 2 \ --kv-dtype int8 --vision \ --spec mtp --draft-tokens 3 --lm-head-draft \ --pending-timeout-ms 600000 \ --request-log-jsonl /data/ninfer-build/reqlog-4080.jsonl \ --log-stats-interval-ms 5000参数逐项说明
参数 作用与取值理由 --model-id覆盖 artifact 自报的 identity.model_id。沿用原 SGLang 的served-model-name(4090 / 4080),客户端配置一行都不用改--max-context单条序列的逻辑上限。超出会明确报 context_length_exceeded而不是静默截断--kv-capacity auto按「权重之后的剩余显存 − 1 GiB headroom」反推最大合法容量。所以启动后空闲显存必然落在 1 GiB 出头,那是设计值不是意外 --max-concurrency启动时固定,运行期不可变,引擎硬上限是 1–8。4090 取 3 是为了保证每路都能吃满 262,144 --kv-dtype int8可选 bf16 / int8 / fp8 / nvfp4 / k8v4。nvfp4 在 Ada 上不可用--vision必须显式加,否则不加载视觉的 GPU 分配,多模态请求会失败 --spec mtp --draft-tokens 3MTP 投机解码,draft window 范围 0–5。作者全部基准都用 3 --lm-head-draft启用优化过的 proposal head。该 artifact 内含 text/draft_head张量--pending-timeout-ms默认只有 30,000(30 秒),覆盖 preparation + 媒体获取 + 引擎 FIFO 准入的全过程。长 prompt 场景必须调大,理由见第七节 --request-log-jsonl机器可读的测量日志。含 prefix_cache_hit_tokens与prefix_reuse_path,是排查缓存的唯一直接手段。纯元数据,不含 prompt 文本或图片/etc/systemd/system/ninfer-4090.service(4080 的同构,仅 Conflicts 与 ExecStart 不同)[Unit] Description=NInfer 4090 Qwen3.8-27B-Uncensored groupwise-int+MTP+Vision After=network-online.target Wants=network-online.target Conflicts=sglang-4090-twolven.service sglang-4090-heretic.service StartLimitIntervalSec=0 [Service] Type=simple User=<你的用户名> ExecStart=/data/launchers/start-ninfer-4090.sh Restart=always RestartSec=10 TimeoutStartSec=600 KillSignal=SIGTERM TimeoutStopSec=60 StandardOutput=journal StandardError=journal [Install] WantedBy=multi-user.targetConflicts=让新旧引擎互斥:启动任意一个会自动停掉另一个,回滚就是一条systemctl start。旧的 SGLang launcher 与 unit 全部保留,只是disable。
六、启动日志:容量账怎么读
RTX 4090
engine ready  | qwen3.8-27b/groupwise-int | total 12.0s | weights 16.9 GiB
capacity      | KV 786,432 tokens, int8, auto | pages 12,288/12,288 | runtime 28.2 GiB | free 1.98 GiB
context cache | 3 active + 3 cached device states | host 8 states, 8.00 GiB KV | private 6 | shared 4 | anchors 2
media         | 12 preprocess workers | cache 1.00 GiB | live 2.00 GiB
listening on http://0.0.0.0:8001 | model 4090 | auth disabled
RTX 4080
engine ready | qwen3.8-27b/groupwise-int | total 12.0s | weights 16.9 GiB capacity | KV 350,208 tokens, int8, auto | pages 5,472/8,192 | runtime 13.3 GiB | free 1.13 GiB context cache | 2 active + 2 cached device states | host 8 states, 8.00 GiB KV | private 4 | shared 4 | anchors 2 media | 12 preprocess workers | cache 1.00 GiB | live 2.00 GiB listening on http://0.0.0.0:8002 | model 4080 | auth disabled- device states 是 GDN recurrent state 槽位,投机解码回滚要用。这个模型一份 state 是
48 GDN 层 × 48 value heads × 128×128 FP32 ≈ 144 MiB,默认 active 与 cached 各等于并发数,所以每加一路并发约多吃 288 MiB。 - host 8 states / 8.00 GiB KV 在主机内存里,不占显存,是 Device/Host 两级缓存的第二级。长上下文前缀被挤出显存时落到这里,比重算快得多。
- pages 12,288/12,288:4090 的页表刚好用满,4080 的
5,472/8,192还有余量——那是--max-context 262144预留的寻址空间,不是浪费。
七、上线之后才暴露的三件事
跑通只是开始。下面三条在基准测试里完全看不到,只有真实客户端接上去才会撞上,也是这次部署里最值钱的经验。
7.1 前缀缓存决定一切:226 秒对 0.4 秒
把
--request-log-jsonl打开后,request_done事件里有prefix_cache_hit_tokens和prefix_reuse_path两个字段。同一个会话连续几轮的真实记录:消息数 prompt 命中 命中率 真算 reuse_path TTFT 174 107,124 0 0.0% 107,124 root226.2s 176 107,451 107,429 100.0% 22 private_endpoint0.4s 114 171,957 0 0.0% 171,957 root145.0s 116 173,779 173,721 100.0% 58 private_endpoint0.6s 118 174,291 174,125 99.9% 166 private_endpoint0.6s 17.4 万 token 的 prompt,第二轮只真算了 58 个 token,TTFT 从 145 秒降到 0.6 秒。 首轮走
root(全量重算)是不可避免的冷启动成本,之后每轮几乎免费。直接推论:别轻易重启。 每次重启引擎都会清空前缀缓存,所有活跃会话的下一轮都要重付一次全量 prefill。两个 17 万 token 的会话同时冷启动 = 大约 4 分钟不可用。调参时把改动攒到一起,一次重启改完。
7.2 prefill 是串行的,
--max-concurrency给的是 decode 通道throughput | 5.0s | prefill 1.43k tok/s | decode 4.2 tok/s | running 2 (prefill 1, decode-ready 1)注意
prefill 1:并发设成 3,同时在跑的请求可以有 3 个,但任一时刻只有一条在 prefill。两个客户端同时发大请求时,第二个的 TTFT = 自己的 prefill + 前面那个的全部 prefill。实测一条请求queue 2m 20.9s,纯粹是在等前一条 prefill 完。加并发数解决不了这个——瓶颈是 prefill 吞吐(本机 1.2~1.4k tok/s),不是通道数。
7.3
--pending-timeout-ms默认 30 秒,长 prompt 场景必炸req#104 failed during generation | HTTP 503 | request queue timeout # 等了 30 秒 req#105 failed during generation | HTTP 503 | request queue timeout # 等了 30 秒 req#106 failed during generation | HTTP 503 | request queue timeout # 等了 31 秒这个计时从 preparation 之前就开始,覆盖媒体获取和引擎 FIFO 准入的全过程。只要有一条大请求在 prefill(十几万 token = 2 分钟以上),排在它后面的一律 30 秒判死。改成 600,000(10 分钟)后,那条等了 2 分 21 秒的请求正常完成了。
这三条是连环的:串行 prefill 造成长队列 → 30 秒默认超时把队列里的人杀掉 → 而如果缓存命中,这些长 prefill 根本不会发生。先保证缓存能用,再把超时调大兜底。
八、视觉的隐藏上限:32,768 merged token
这条在任何文档的显眼处都找不到,但多图会话一定会撞上。接上真实客户端后出现的第二个 400:
{"code":"media_budget_exceeded","message":"vision raw patches exceed processor budget"}
req#78 rejected during prepare | HTTP 400 | media budget exceeded | messages 162 | media 20 | tools 27
根因是两个编译期常量(
prepared_prompt.h):inline constexpr std::uint64_t kMaximumPromptVisionTokens = 32'768; // 整请求 inline constexpr std::uint64_t kMaximumVisionItemTokens = 16'384; // 单张图 inline constexpr std::uint64_t kRawPatchesPerVisionToken = 4; // frontend.cpp vision_tokens = min(options.max_context, kMaximumPromptVisionTokens); // → 32,768注意那个
min():纯文本能到--max-context的 262,144,但一旦带图,视觉部分的上限就是 32,768。 这两个值没有任何命令行参数可以调。换算(
patch_size 16+merge_size 2,即每个 merged token = 32×32 像素):图片 像素 raw patches 视觉 token 单请求可容纳 3840×2160 8.29 M 32,400 8,100 4 张 1920×1080 2.07 M 8,100 2,025 16 张 1280×720 0.92 M 3,600 900 36 张 640×360 0.23 M 900 225 145 张 一个攒了 20 张 1080p 截图的会话 =
20 × 2,025 = 40,500 > 32,768,整条请求被拒。一个说明打包意图的细节。 artifact 内嵌的
preprocessor_config.json里size.longest_edge = 16,777,216像素,而kMaximumVisionItemTokens × 4 × 256 = 16,777,216——两个数字完全相等。打包者是刻意把单图上限顶满的:这个 artifact 是为「一张超大图」调的,不是为「很多张图」调的。对照之下,NInfer 引擎结构体里image_max_pixels的默认值只有1024×1024。怎么修:改客户端,别改 artifact
image_max_pixels读自 artifact 内嵌的longest_edge,而smart_resize_image()对超限图片是等比缩小而不是拒绝(processor.cpp:85)。所以把这个值调小确实能让更多图片装进预算——但那会让所有客户端的单图精度一起下降。更好的做法是在客户端侧限制。 我们的客户端(DeepSeek Harness)提供了 provider 级参数,逐图缩放 + 超预算时把最旧的图换成文字占位符:
requestImagePixelBudget: 1048576      # 逐图 ≤1 Mpx,1080p 缩到 ~1365×768,每张 2,025 → 1,024 token
requestImageMaxBytes:    393216       # 逐图编码目标 384 KB
maxRequestImageBytes:    12582912     # 整请求 12 MB,超出替换最旧的图
改完之后同样 20 张图的请求顺利通过。关键是这样做只影响那一个客户端——我们另一条直连 API 的截图判读链路仍然拿到未缩放的 1080p 原图(实测
prompt 2,061,正好等于 2,025 个未缩放的视觉 token)。单位错配是根本原因。 客户端按字节限额,引擎按像素/patches限额。截图压缩率极高,20 MB 的字节额度能装下远超 32,768 视觉 token 的内容,所以字节限额永远不会先触发。要对症就得用像素单位的那个参数。
九、能力与质量验证
三项在 Ada 上此前无人验证过的能力,加一组质量回归。
项目 结果 视觉(sm_89 首次跑通) 通过 640×360 图,四行文字逐字正确 + 形状识别正确,0.6–1.4 s。issue #189 的移植作者只测了文本负载,ViT 路径在 Ada 上没有任何先例 tool call 双向通过 tools+tool_choice:auto→finish_reason: tool_calls与正确的 JSON 参数;role:tool结果回传后正确续写长上下文 通过 4090 吃下 249,952 token(上限的 95%);4080 吃下 200,932 token 超长保护 正确 明确报 context_length_exceeded,不静默截断智商 12 题 12 / 12(开 thinking),与原模型历史满分一致 拒答 8 题 0 / 8 完全去审 MTP 接受率 4090 53.5–68.1%;4080 67.3–73.5%(强内容相关,见下) 一条容易踩的测量陷阱。 同一套智商题,关 thinking 只有 9/12,开 thinking 是 12/12。错的三题全是数理推理(时钟夹角、鸡兔同笼、星期推算)。测模型智力必须开 thinking,否则会系统性低估。
MTP 接受率与内容类型强相关。引用作者在 5090 上的分类基准(groupwise-int,draft=3):Structured 89.5%、Code 76.3%、Translation 74.9%,而 Story 只有 37.9%。对应的 decode 是 224.4 / 200.3 / 198.1 / 130.4 tok/s——同一套配置,写作类比结构化输出慢了 42%。所以单一场景的 tok/s 数字意义有限。
十、性能天花板在哪
拿作者在 RTX 5090 上的官方基准做硬件缩放换算,两条线独立验证。
指标 5090(作者) 4090(实测) 硬件比 换算预期 偏差 decode · Code 类 200.3 115.5 带宽 1.78× 112.5 +2.7% prefill · ~26 万 token 1,609.7 1,068 算力 ≈1.5× ~1,073 −0.5% 两条线都精确落在硬件缩放预期上,误差都在 3% 以内。结论是当前配置已经跑在硬件极限,不存在「参数没调好」的空间——能动的只有「每 token 读多少字节」和「每轮吐多少 token」这两件事。
顺带解释一个反常现象:issue #189 的移植作者在 RTX 4090 上只跑出 85.4 / 88.8 tok/s,反而不如我们在更弱的 4080 上跑出的 88.2。原因有二——他跑在 Windows/WDDM(自述有 3.4 GB 桌面合成器基线),且 MTP 接受率只有 53.5–58.3%。Linux 上不要拿那个数字当 Ada 的上限。
还没实施的三条杠杆
方向 机制与预期 风险 --kv-dtype k8v4K 8bit + V 4bit,每 token KV 字节降 25%。4090 上 786,432 ÷ 0.75 = 1,048,576 = 4 × 262,144——并发可升到 4 且每路仍吃满 262K。满上下文时 KV 约占每步流量 1/3,砍 V 一半 → 总流量 −12%4-bit V cache 无任何公开质量数据,作者全部基准都用 int8 --draft-tokens 3 → 4/5verify 那一步无论窗口多长权重只读一次,窗口越长=每次权重读取吐越多 token。按 Code 类接受率 76.3% 推,draft=4 可到 1+4×0.76 ≈ 4.04tokens/round,约 +23%。作者从未发布过窗口扫描数据强内容相关,写作类(接受率 37.9%)可能反而变慢 并发 → 8 作者 5090 数据:C=1 185.8 → C=2 247.0(1.33×)→ C=4 309.5(1.67×)→ C=8 535.0(2.88×)。我们 C=3 已达 1.80× 每路上下文压到约 9.8 万,与「保满 262K」冲突
十一、踩过的坑
- 首次启动必定 FAILURE 一次。 日志是
ERROR cannot bind 0.0.0.0:8001——Conflicts=停旧服务与新服务抢端口之间有竞态。Restart=always10 秒后重试即成功,不是故障。开机场景不会出现(旧服务已 disable,没有竞态对象)。 pkill -f ninfer-serve会杀掉执行它的 shell 自己,因为那条命令的 command line 里也含这个字符串。用pkill -f "[n]infer-serve"。- 通过 ssh 用
nohup … &起守护进程不可靠——日志文件都没被创建。直接上 systemd。 - 三个默认值在长 prompt 场景下都偏小:
--pending-timeout-ms30 秒(排队必炸)、视觉预算 32,768 merged token(多图会话必炸)、以及客户端侧按字节而非像素限额(永远不先触发)。这三条在单请求基准里全都看不见。 - 先开
--request-log-jsonl再排障。prefix_reuse_path一个字段就能区分「缓存没命中」和「缓存不工作」——前者是冷启动,后者才是 bug。我们一度以为是后者,日志证明是前者。 - 不必为了验证格式下载整个 18 GB。
.ninfer是私有单文件格式,但开头就是明文 JSON manifest。用 HTTP Range 取前 1.5 MB 就能读出identity.weights_id,并数清vision/(333 个张量)和mtp/(12 个张量)命名空间是否存在。 - 在中国大陆需要走 HF 镜像。 本机
huggingface.co被 DNS 污染(解析到 Facebook 的 IPv6 段2a03:2880:…,curl 卡在 SYN-SENT)。配HF_ENDPOINT=https://hf-mirror.com后正常。 - 装 CUDA 前先做 apt 模拟。
apt-get install -s数Remv行确认为 0 再执行。实测cuda-toolkit-13-1是 63 新装 + 1 升级(cuda-toolkit-config-common纯配置包)、零删除,不碰驱动、dkms、libnvidia-*。装完要复核/usr/local/cuda符号链接没有被改走。
十二、值不值得
值得,但要清楚自己押上了什么。
收益是真实的:4090 上 KV 池 +74%、并发从 2 到 3 且每路都能吃满 262K、单路 decode +14%、启动快 85%;4080 上 KV +131%、上下文 +78%。视觉和 tool call 都完整可用。
代价同样真实:两张卡现在跑同一个引擎、同一个 artifact,而这个引擎的 Ada 支持来自一个 0 star、单 commit、上游明确拒收、已落后 93 commit 的 fork。 引擎与模型的多样性都没了,它出问题两张卡一起受影响。上游每前进一步,这个分支的 rebase 成本就高一分。
我们的对冲是保留完整回滚路径——旧的 SGLang launcher 和 unit 一个都没删,只是
disable,Conflicts=会在启动旧服务时自动停掉 NInfer:sudo systemctl start sglang-4090-twolven # 4090 回退 sudo systemctl start sglang-4080-awq-int4 # 4080 回退如果只带走一条:先确认前缀缓存在你的客户端上真的命中(开
--request-log-jsonl看prefix_reuse_path)。命中与不命中之间是 226 秒和 0.4 秒的差距,比任何参数调优都重要一个数量级。如果你手上是 5090,这些移植工作一样都不用做,直接用上游;如果是 Ada 消费卡,上面这条路是通的,但请把它当成一个需要你自己维护的分支,而不是一个能长期依赖的上游产品。
全部数值为 2026-09-15 单机实测。5090 数字引自 NInfer 仓库
docs/performance.md。
硬件 RTX 4090 48 GB + RTX 4080 32 GB · Ubuntu 24.04.4 · CUDA 13.1.115 · 驱动 580.159.04 - 仓库里只有 3 个文件(
-
SGLang HiCache 三层 KV 缓存实测:4090 48G 单卡跑通 Qwen3.8-27B 去审(256K + MTP + 视觉全占) -
SGLang HiCache 三层 KV 缓存实测:4090 48G 单卡跑通 Qwen3.8-27B 去审(256K + MTP + 视觉全占)@CHIA-AN-YANG 生产出来的视频片段质量非常不稳定,片段之间人物面孔没办法保持一致,等我生产好了发给你鉴赏。
-
SGLang HiCache 三层 KV 缓存实测:4090 48G 单卡跑通 Qwen3.8-27B 去审(256K + MTP + 视觉全占)@zhenyu-huang
我把YouTube上做AI视频的视频教程链接发给他,让他自己下载视频,然后每秒截一帧,自己识别图片学习。
并且让他下载教程的音频,让他把音频转成文字,学习教程文字内容。
奇怪,没有人好奇黄易的《寻秦记》小说写的是什么吗?这个才是重点^-^ -
SGLang HiCache 三层 KV 缓存实测:4090 48G 单卡跑通 Qwen3.8-27B 去审(256K + MTP + 视觉全占)SGLang HiCache 三层 KV 缓存实测:4090 48G 单卡跑通 Qwen3.8-27B 去审(256K + MTP + 视觉全占)
看到坛里 32G Blackwell 用三层 KV 缓存跑 Qwen3.8-27B 的帖子,分享下我这边 4090 48G 的实测。48G 的余量正好把 MTP 投机 + HiCache 多会话复用 + 满 256K 上下文 + 去审 四样同时占全,不用二选一。已稳定跑生产十来天。
用途 / 工作流
这台 4090 上的去审大模型是整条视频生产线的大脑:
- 输入:黄易武侠小说《寻秦记》原文
- 4090(本机):去审 Qwen3.8-27B 作为 agent,读小说→按叙述句细拆分镜→生成每段画面的提示词与音画同步脚本
- 4080 32G:跑 ComfyUI 的 MiniMax H3 去审工作流,按 4090 给的分镜逐段出视频
- 简言之:4090 指挥、4080 出片,全流程去审、长上下文(整部小说 + 分镜历史)常驻
正因为反复处理同一部小说的长上下文(大量共享前缀),HiCache 的前缀复用命中率才高得离谱(见下)。
硬件 & 模型
- GPU:RTX 4090 48GB(Ada 魔改,1008 GB/s)
- 主机:Ubuntu,系统内存 62GB
- 模型:Qwen3.8-27B-HERETIC 去审版 · FP8(compressed-tensors,~30GB)
- HuggingFace:https://huggingface.co/OptimizeLLM/Qwen3.8-27B-heretic-MTP-FP8
- 架构:Dense 稠密(非 MoE)+ 混合注意力(48 linear/GDN + 16 full)+ 原生视觉 VL
- 引擎:SGLang 0.5.17
HiCache 三层 KV 缓存
层 内容 容量 L1 GPU(热) fp8 KV,显存 270,278 token(~8.6G) L2 主机内存(温) --hicache-size 24504,447 token(24G) L3 NVMe(冷) 未启用(纯内存,足够用) — - 上下文窗口:256K(
--context-length 262144),KV 池 270K 保满 262K 有余 - 写策略:
write_through;io-backendkernel+ mem-layoutpage_first
性能实测
- 吞吐:thinking-off ~63–76 tok/s(峰 76);thinking-on ~35–47 tok/s
- MTP 投机:链式 NEXTN 工作正常,accept len 3.8–4.2(no_think)
- 前缀缓存命中率:~88.5%(累计 prompt 3000 万+ token,命中占八九成)
- L2 内存池:503,430 / 504,447 ≈ 99.8% 满(小说前缀被反复复用,LRU 淘汰)
- 前缀复用提速:命中时首 token 冷 2.6s → 暖 0.67s(快 ~75%),17 万 token 长前缀单次直接命中免重算
稳定性 / 运行时长
- 当前配置(去审 FP8 + hicache 24G):连续 ~20 小时零崩溃,已服务 3000 万+ token
- 去审 Qwen3.8 生产线:~11 天,端点对各 agent 一直在线
- 主机连续开机:2 周 4 天
启动参数
python -m sglang.launch_server \
  --model-path /data/qwen3.8-27b-heretic-fp8 --served-model-name 4090 --host 0.0.0.0 --port 8001 \
  --context-length 262144 --max-running-requests 1 --mem-fraction-static 0.98 \
  --kv-cache-dtype fp8_e4m3 \
  --speculative-algorithm NEXTN --speculative-eagle-topk 1 --speculative-num-steps 5 --speculative-num-draft-tokens 6 \
  --enable-hierarchical-cache --hicache-size 24 --hicache-write-policy write_through \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder --trust-remote-code --sleep-on-idle
几个踩坑 / 权衡
- HiCache 的真正价值是「多会话 KV 复用免 prefill」,不是跑更大上下文——我这种「反复喂同一部小说」的场景命中率 88.5%,省掉八九成重复 prefill,指挥出片的节奏快很多。
- FP8 权重大(30G)→ 树形投机与满 256K 不可兼得:所以用链式 NEXTN(
topk1/steps5/draft6),保满 262K;想上树形投机就得牺牲上下文。 --page-size必须为 1:page-size 64 与混合 mamba 模型 + hicache 不兼容,会 Segmentation fault 崩溃,别踩。- 内存成本:hicache 24G 常驻内存,多卡各开一份会把内存吃紧(我这边 4090 指挥 + 4080 出片同时跑,62G 内存 + swap 就满了),按机器内存量力而行。
小结
一台 4090 48G 当「导演」(去审长上下文 agent 读小说、拆分镜),一台 4080 32G 当「摄制组」(ComfyUI MiniMax H3 去审工作流出片)。4090 相比 32G 卡的最大不同:不用在速度(MTP)和会话持久(HiCache)之间二选一,还能同时保满 256K + 去审。三层 KV 缓存实测命中 ~88.5%,稳定跑生产已 ~11 天。同样搞长篇小说转视频的欢迎交流。
-
SGLang HiCache实测:KV缓存放进内存和SSD,多开Agent终于舒服了,5090/RTX Pro5000/4080S 32G/4090 48G等显卡福音!贴一下我的4090 48G模型配置:4090 (GPU0) 生产情况汇总
模型
项 值 模型路径 OptimizeLLM/Qwen3.8-27B-heretic-MTP-FP8全名 Qwen3.8-27B HERETIC 定向消融去审版 · FP8 量化 compressed-tensors FP8(KV cache 亦 fp8_e4m3),消融 KL 0.065 架构 Dense 稠密(非 MoE)· 混合注意力(48 linear/GDN + 16 full)· 原生视觉 VL 端点 served-model-name= 4090@0.0.0.0:8001服务
项 值 systemd 单元 sglang-4090-heretic状态 active / enabled(开机默认) 引擎 SGLang 0.5.17 备选模型 twolven(Qwen3.8-27B INT4 AWQ 去审,并发2, sglang-4090-twolven,disabled 手动,也已配 hicache)运行参数
--model-path /data/qwen3.8-27b-heretic-fp8 --served-model-name 4090
--host 0.0.0.0 --port 8001
--context-length 262144              # 满 256K 上下文
--max-running-requests 1             # 单发 conc1
--mem-fraction-static 0.98
--kv-cache-dtype fp8_e4m3
--mamba-full-memory-ratio 1.0 --mamba-scheduler-strategy extra_buffer --mamba-track-interval 2048
# 投机解码(链式 NEXTN/MTP):
--speculative-algorithm NEXTN --speculative-eagle-topk 1 --speculative-num-steps 5 --speculative-num-draft-tokens 6
# 前缀缓存(hicache,纯内存):
--enable-hierarchical-cache --hicache-size 24 --hicache-write-policy write_through
--disable-overlap-schedule --sleep-on-idle
--reasoning-parser qwen3 --tool-call-parser qwen3_coder --trust-remote-code
--enable-metrics --enable-cache-report --mm-feature-transport cpu
容量 / 显存
项 值 KV 池(显存) 270,278 token → 保满 262K(富余 8,134) hicache 内存池 504,447 token(24G 内存,前缀冷备) 显存占用 46.0G / 49.1G Token 性能(历史实测)
口径 吞吐 accept len thinking-off(代码) ~63-76 tok/s(峰 76) 3.8-4.2 thinking-on(中文推理,temp1.0) ~35-47 tok/s 1.75-2.5 链式投机;FP8 权重大 → 树形投机与满 262K 不可兼得,链式为「保满上下文」最优档。
前缀缓存(hicache)效果
- 命中时:冷 2.6s → 暖 0.67s(首 token 快 ~75%),
#cached-token跳过重算。 - 独有价值:多 session / 前缀总量 > 270K 时,被显存淘汰的前缀从内存 504K 捞回复用,不重算。
- 命中率随流量:有共享前缀则高(实测 0.999),全独立请求则 0。
备注
- page-size 64 与 hybrid mamba 模型 + hicache 不兼容(段错误崩溃),必须 page-size 1。
- hicache 24G + comfyui 重度工作流同时用会内存吃紧(62G 机器),需留意 swap。
- 命中时:冷 2.6s → 暖 0.67s(首 token 快 ~75%),
-
4080&4090不同模型token性能测试@demo 记得是通过加载mmproj 启用视觉, 但是mmproj 和MTP没办法同时开,后面没用这个模型。
推荐vllm跑https://huggingface.co/llmfan46/Qwen3.6-27B-uncensored-heretic-v2-GPTQ-Int4 , 这个有视觉, 我一直跑着,很稳定。
4080 32G启动参数:exec /data/vllm-env/bin/vllm serve /data/models/heretic-gptq-int4 \ --served-model-name 4080 \ --port 8002 \ --max-model-len 262144 \ --max-num-seqs 1 \ --gpu-memory-utilization 0.96 \ --enable-prefix-caching \ --kv-cache-dtype fp8 \ --trust-remote-code \ --reasoning-parser qwen3 \ --enable-auto-tool-choice \ --tool-call-parser qwen3_coder \ --speculative-config '{"method":"mtp","num_speculative_tokens":3}' -
4080&4090不同模型token性能测试 -
4080&4090不同模型token性能测试 -
4080&4090不同模型token性能测试@blackjack 不在日本。图片是EDIX参展时拍的,估计大家喜欢看,就放上去了。
-
4080&4090不同模型token性能测试@blackjack 图片更新了
-
4080&4090不同模型token性能测试@blackjack 明天找时间上图
-
4080&4090不同模型token性能测试两块显卡:【RTX 4080 32GB】 和 【RTX 4090 48GB】, 都接的显卡坞(x4@PCI-E 3)。最近完整看完了“老特抡锤者”频道的相关视频,也参考了论坛里各位大神的经验分享,随后针对不同模型、量化版本、上下文长度以及MTP 参数进行了多轮测试。把测试结果整理出来,供大家参考。
【20260529更新_2】
4090 / 4080 当前生产配置(亮点:Uncensored 模型驱动Hermes,什么活都不拒绝)
参数 4090 4080 GPU RTX 4090 48GB (Ada) RTX 4080 32GB (Ada) 框架 vLLM 0.21.0 vLLM 0.21.0 Service vllm-4090-27b-fp8vllm-4080-heretic-gptq模型 官方 Qwen3.6-27B-FP8 llmfan46 Heretic v2 GPTQ-Int4 客户端用途 Claude Code Hermes Censored 
 uncensored (MPOA)
量化 FP8 E4M3 block 128×128 GPTQ-Int4 (Marlin) KV dtype fp8 fp8 max-model-len 262144 (256K) 262144 (256K) max-num-seqs 1 1 gpu-mem-util 0.97 0.96 MTP s 5 3 tool-call-parser qwen3_coder qwen3_coder reasoning-parser qwen3 qwen3 prefix-caching vision/video 内嵌 内嵌bench tok/s 54.2 62.7 bench accept 54% 61% 实际场景 73-76 tok/s(高命中 99% accept) 接近一致 【20260529更新_1】
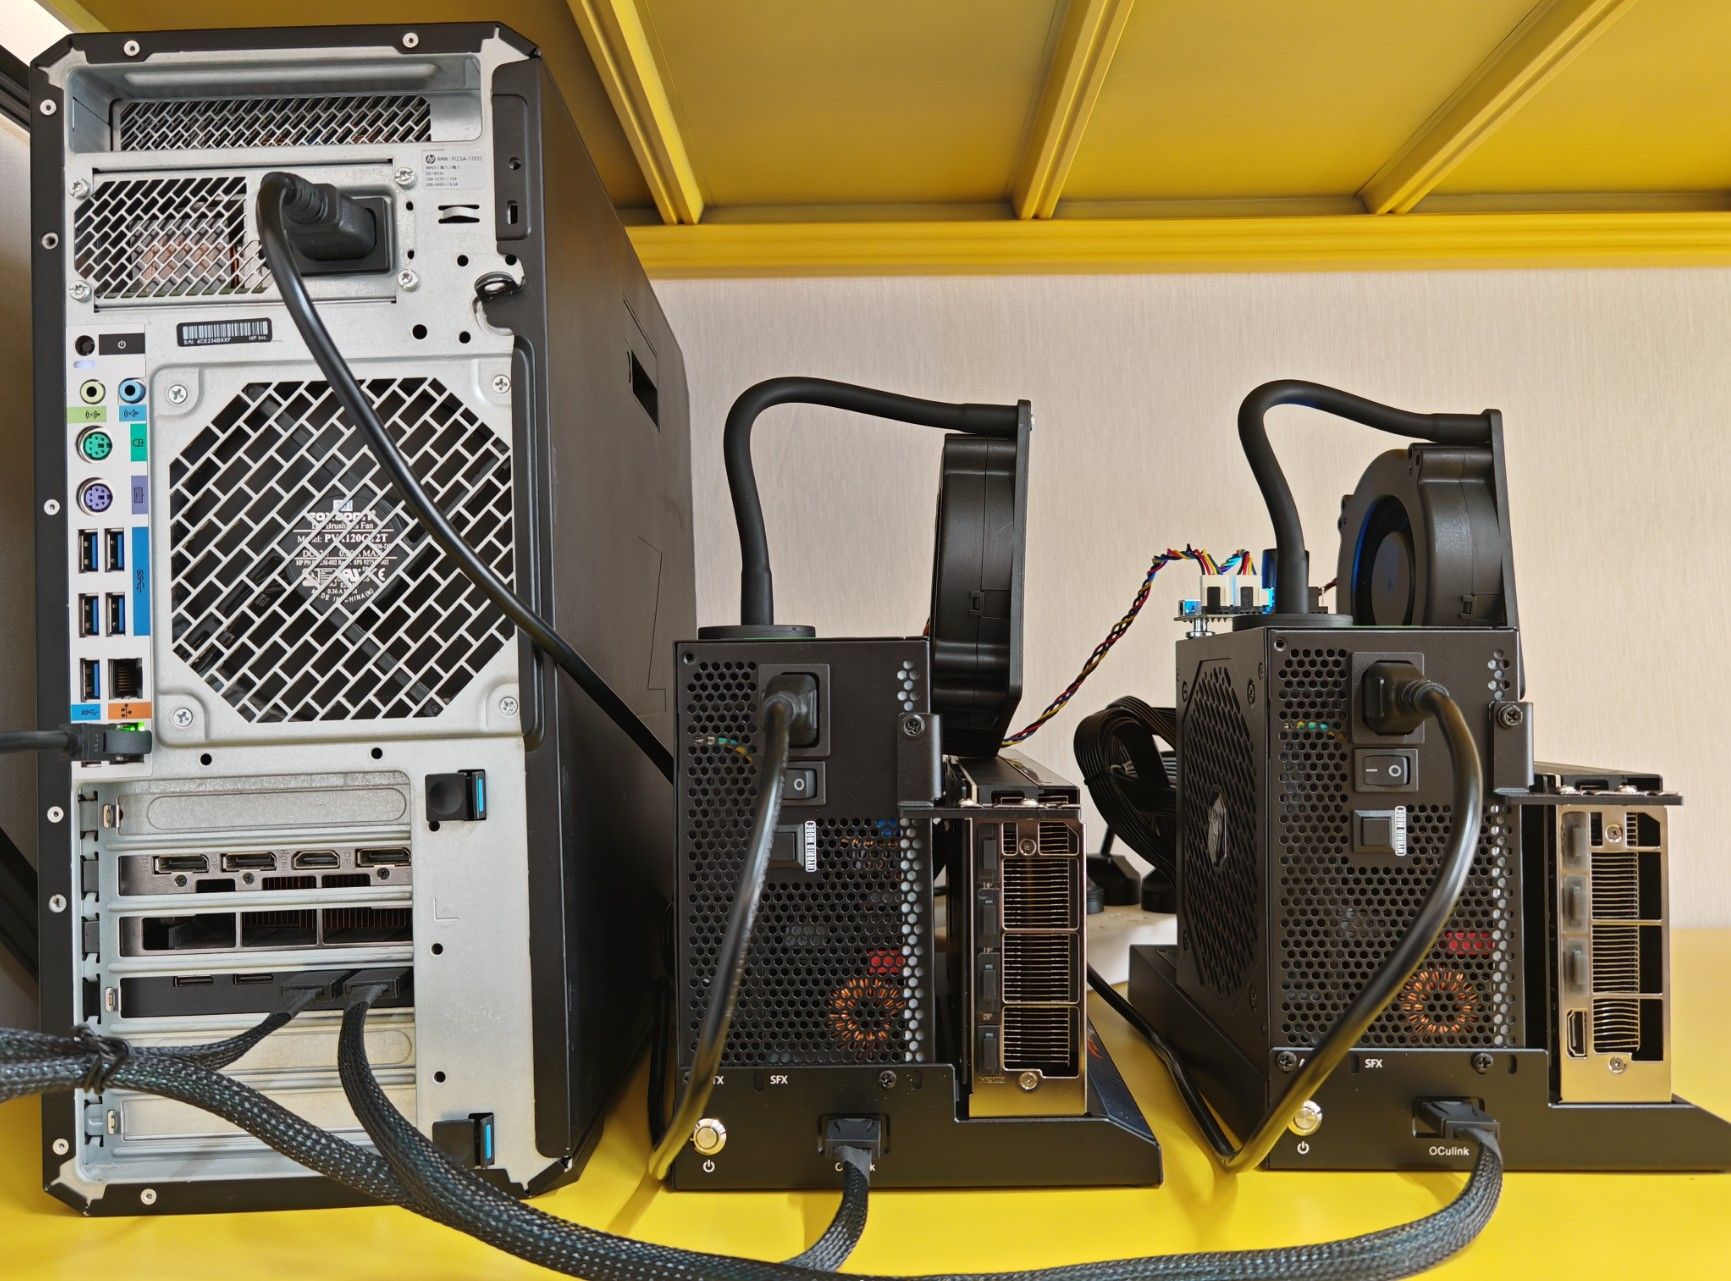
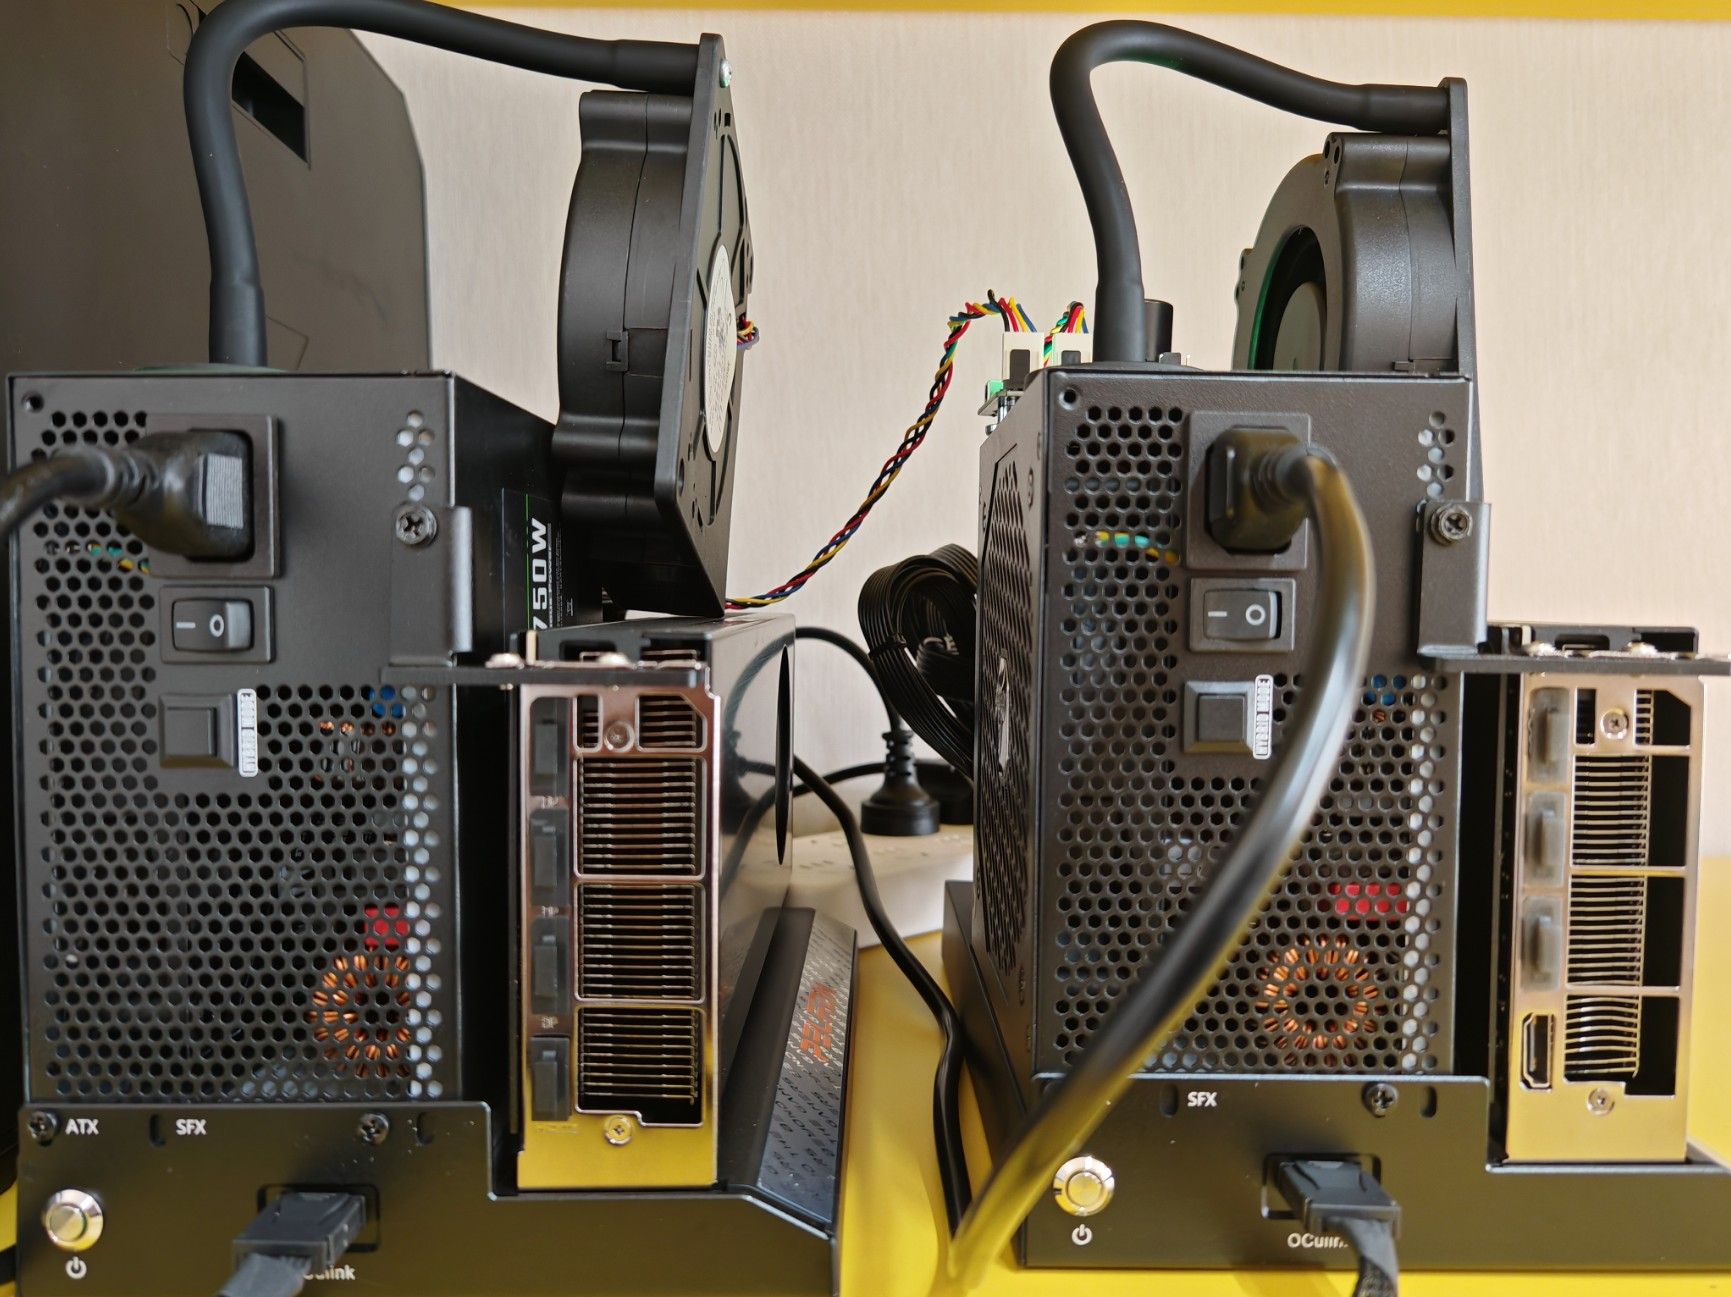
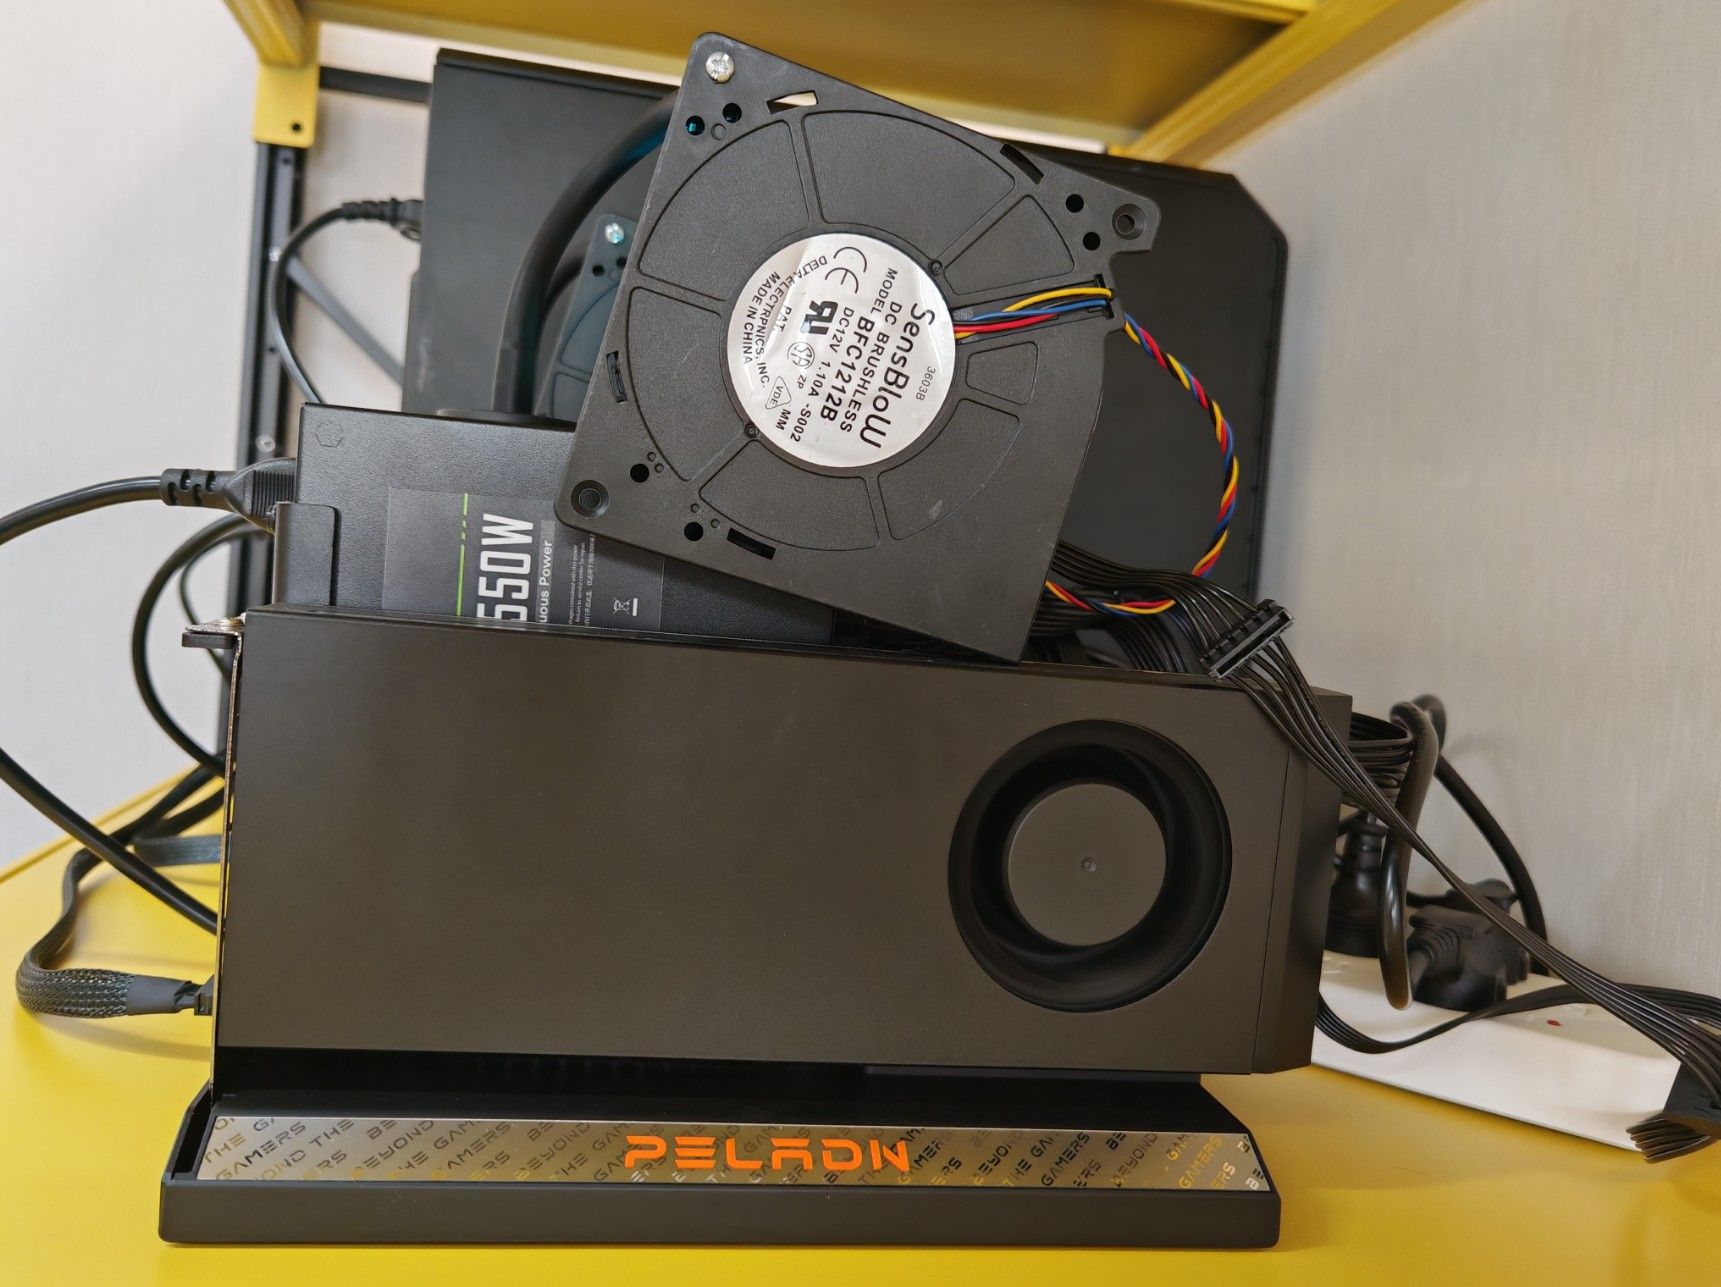
【先上图,证明不是云】
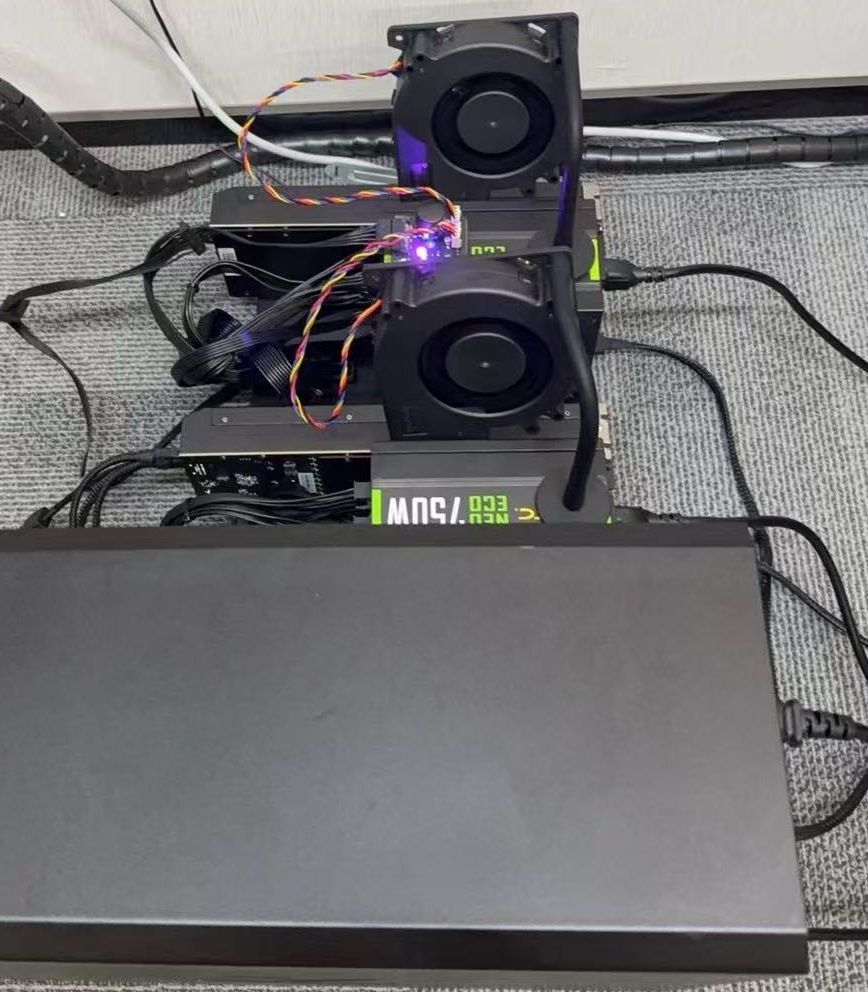
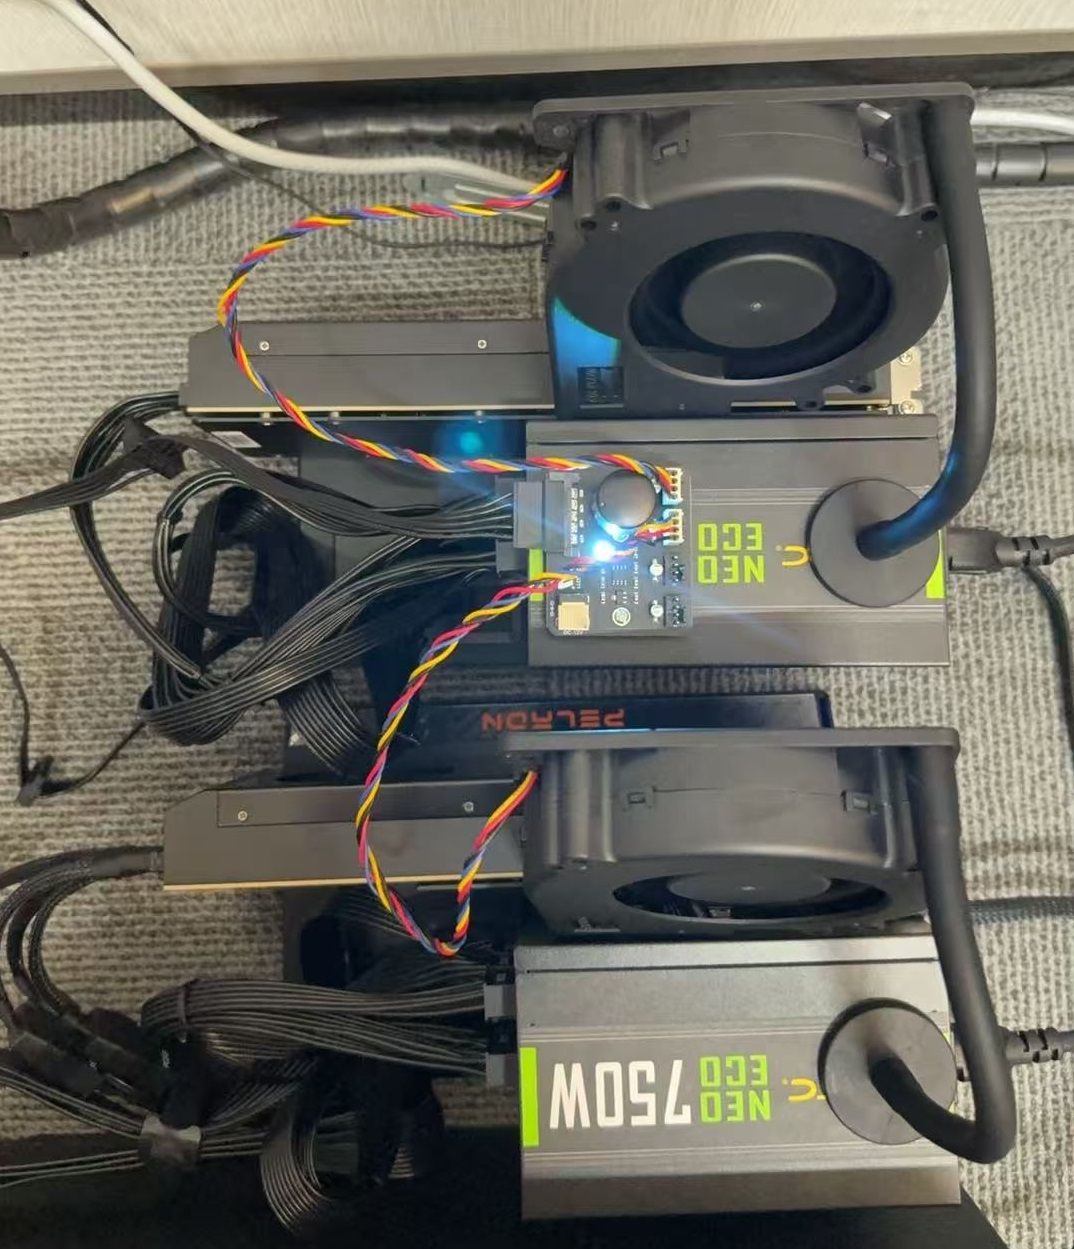
【平台信息】
类别 项 配置 机型 型号 HP Z4 G4 Workstation 电源 750 W CPU 型号 Intel Xeon W-2133 主频 3.6 GHz 核 / 线程 6 核 / 12 线程 内存 类型 DDR4 容量 32 GB GPU 0 型号 RTX 4090(魔改) 显存 48 GB 用途 主推理 GPU 1 型号 RTX 4080(魔改) 显存 32 GB 用途 副推理 GPU 2 型号 RTX 2080 Ti(魔改) 显存 22 GB 用途 ComfyUI 显存合计 102 GB 系统盘 类型 NVMe M.2 SSD 容量 256 GB 数据盘 挂载点 /data容量 458 GB 系统 OS Ubuntu 24.04 LTS 内核 Linux 6.17.0-29-generic 【4090 token 性能历史】
时间 模型 + 后端 量化 ctx MTP 视觉 uncensored 单流 tok/s 并发 tok/s 2026-05-17 Qwen3.6-27B-FP8 vLLM FP8 + FP8 KV 256K s=3 37 — 2026-05-21 QuantTrio AWQ Dense vLLM AWQ INT4 + FP8 KV 256K s=3 81 208 (并发3) 2026-05-23 中 QuantTrio AWQ-6Bit vLLM AWQ 6-bit 256K s=3 68 124 (并发2, 反慢) 2026-05-23 中 QuantTrio 35B-A3B vLLM AWQ INT4 256K s=3 107 351 (并发5) 2026-05-23 晚 35B-A3B 无 MTP vLLM AWQ INT4 + batched=16384 256K 关145 337 (并发5) 2026-05-24 Qwen3.6-27B-FP8 vLLM FP8 + FP8 KV + prefix-cache 256K s=5 60.8 — 2026-05-24 Qwen3.6-27B-FP8 vLLM 同上 256K s=7 63.8 — 2026-05-24 Qwen3.6-27B-FP8 vLLM 同上 256K s=8 64.0(边际死) — 2026-05-25 Heretic Q8 llama.cpp(试) Q8 + q8_0 KV 256K n=3 63.4 — 2026-05-25 Heretic Q8 llama.cpp(试) 同上 256K n=5 66.5 — 2026-05-25 Heretic GPTQ-Int4 vLLM(失败) GPTQ-Int4 256K s=3 — 21(accept 1.25% broken) — 2026-05-25 Heretic Q8 llama.cpp  当前 default
Q8 + q8_0 KV 256K n=7 68.7 — 【4080 token 性能历史】
时间 模型 + 后端 量化 ctx MTP 视觉 uncensored 单流 tok/s 2026-05-09 QuantTrio AWQ Dense vLLM 0.20.1 AWQ INT4 + FP8 KV 128K s=3 62.9 2026-05-11 同上 vLLM 0.20.2(regression) AWQ INT4 128K s=2 45.6 2026-05-22 HauhauCS 27B Aggressive llama.cpp Q4_K_P GGUF 256K 无(mmproj 互斥)32 2026-05-23 QuantTrio 35B-A3B vLLM AWQ INT4 + FP8 KV + seqs=1 256K 无 106 2026-05-23 同上 同上 256K s=1 77 2026-05-23 同上 同上 256K s=2 93 2026-05-23 QuantTrio 35B-A3B vLLM 同上 256K s=3 117 2026-05-24 SummonGov 27B-MTP graft Q6_K_P GGUF + q8 KV 64K n=1 40.1 2026-05-24 同上 同上 64K n=2 50.1 2026-05-24 同上 同上 64K n=3 55.7 2026-05-24 同上 同上 64K n=5 58.9 2026-05-24 同上 同上 64K n=7 55.3 2026-05-24 SummonGov 27B-MTP Q4_K_P GGUF + q8 KV 64K n=3 20.6(accept 2% broken) 2026-05-24 同上 同上 64K n=5 62.5 2026-05-24 同上 同上 64K n=7 56.8 2026-05-24 llmfan46 Heretic Q6_K llama.cpp Q6_K + q8 KV 64K n=3 57.0 2026-05-24 同上 同上 64K n=5 61.6 2026-05-24 同上 同上 64K n=7 56.5 2026-05-24 同上 q8_0 KV @ 256K Q6_K + q8 KV 256K n=5 OOM 差 836 MiB 2026-05-24 同上 q5_1 KV @ 256K Q6_K + q5_1 KV 256K n=5 慢(flash-attn 不兼容) 2026-05-24 同上 q5_0 KV @ 256K Q6_K + q5_0 KV 256K n=5 12(slow path) 2026-05-24 同上 iq4_nl KV @ 256K Q6_K + iq4_nl KV 256K n=5 26(slow path) 2026-05-24 Heretic GPTQ-Int4 vLLM(失败) GPTQ INT4 256K s=3 — 21(accept 1.25%) 2026-05-24 llmfan46 Heretic Q6_K llama.cpp 当前 defaultQ6_K + q4_0 KV 256K n=5 58-62 -
7900XTX + llama.cpp Qwen3.6 27B TurboQuant + MTP 测试结果分享这个太棒了
 ,先顶再抄作业。