

结论先行: 现阶段我最好的选择,配置表贴在最后
优缺点
 优点
真的聪明:个人体感比我现在配置的sglang+qwen 3.8 27b AWQ+Dflash明显聪明,思考快3倍以上
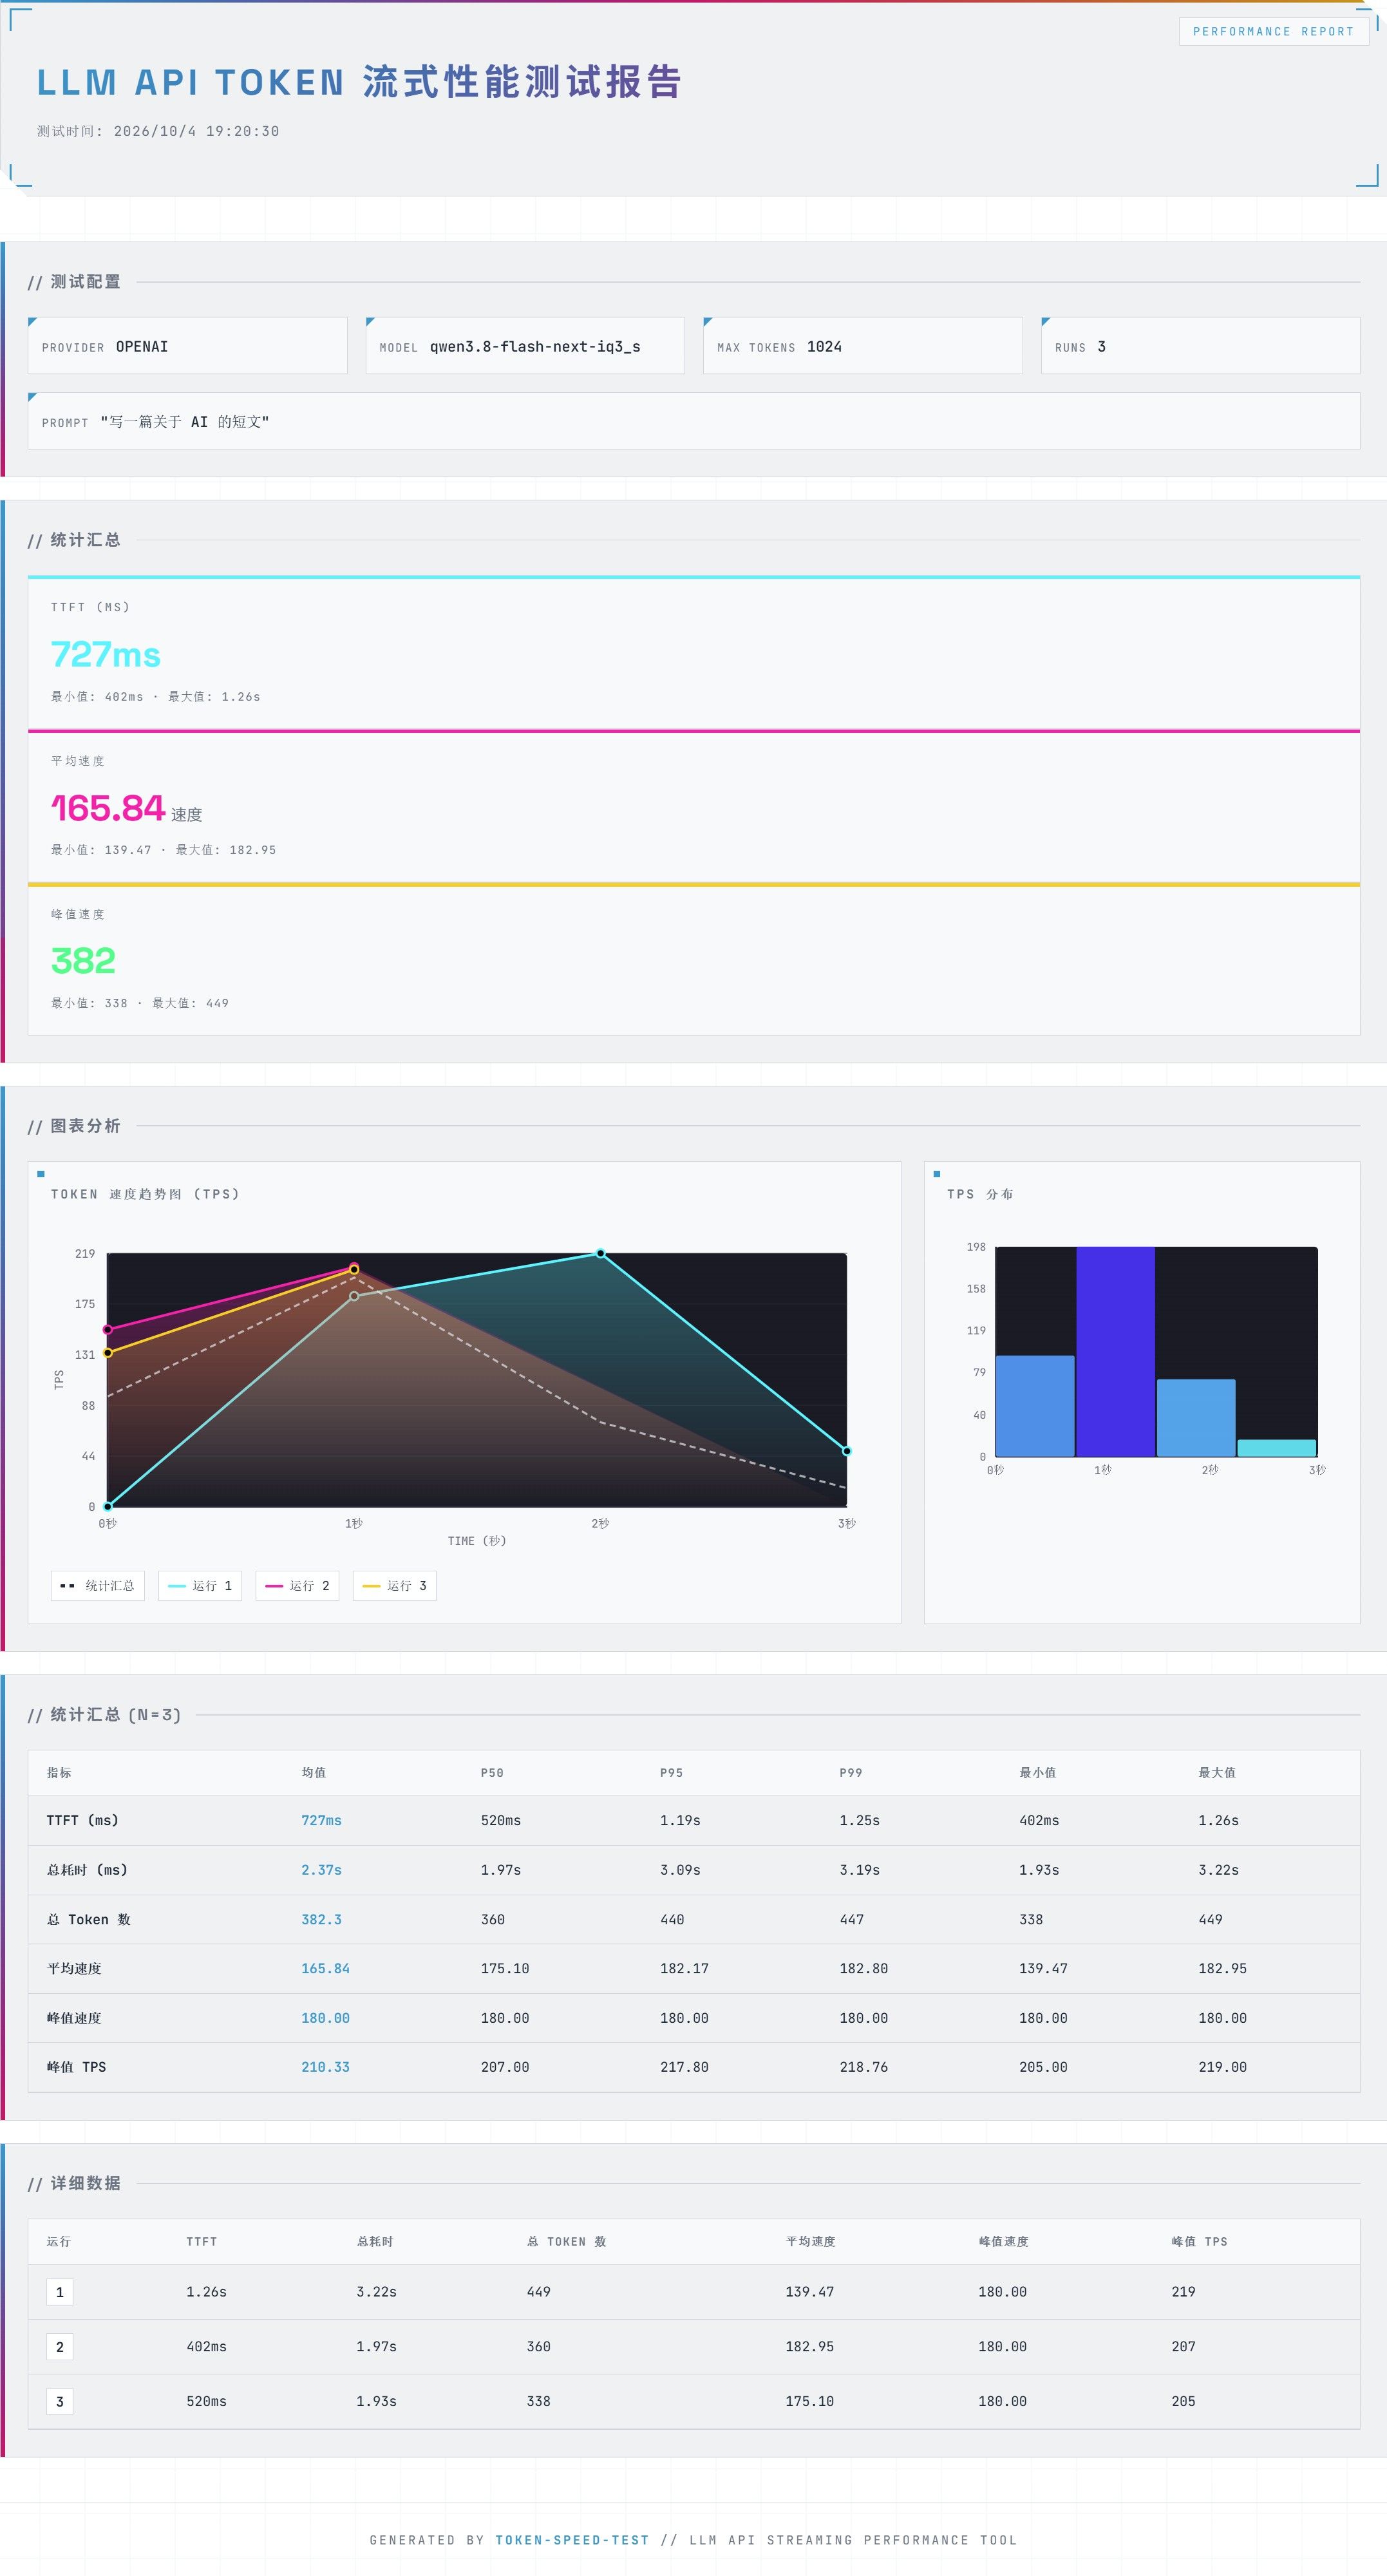
速度可用:纯吐字 ≈232 tok/s、峰值 TPS 219、首字 727ms,远快于阅读速度,用DSH,稳定维持在120 tok/s以上
上下文:262K 满,论坛有人测试到512K(几乎无损)到1M
 缺点
不支持多路并发:引擎原生限制,配置层面无解,源码里写死的
对内存和显存要求高:论坛5070 12G + 64G,大概跑到40 toks/s
硬件配置
GPU RTX 4090 48GB(改版),驱动 617.14
CPU Intel Core Ultra 7 270K Plus 核心数 24 (8P+16E)
内存 128 GB
主板 Z890 AERO G Gigabyte Co., Ltd. 芯片组 Intel Z890
硬盘 ZHITAITiPlus7100s4TB
系统 Windows 10 Enterprise LTSC 2024 (24H2)
部署参考:
引擎仓库 https://github.com/Niko1221/Strata
我用的模型 https://huggingface.co/SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF
无审查部署教程 https://www.xgdn.com/90.html
视频介绍 https://www.youtube.com/watch?v=2DI9MWPXyaw&t=975s
量化:最高的 IQ3_S(模型文件 51.28 + 26.82 = 78.1 GB)
启动后
GPU,显存,CPU,内存占用:
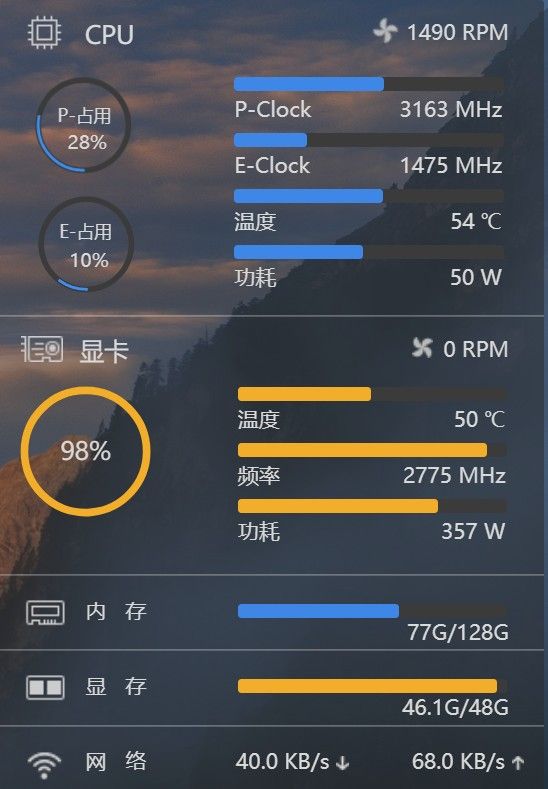
三个关键调优(实测数据):
1️⃣ 显存预留:默认值会让性能掉 10 倍  ️
--vram-reserve-mib 原生默认写 700。
实测:
值 空闲显存 实测速度
700(默认) 364 MiB 13.5 tok/s 
1500 ~1000 MiB 138.4 tok/s
3000(我用) ~2600 MiB 139.4 tok/s
700 和 1500 之间有隐患,掉下去损失 10 倍且极不稳定(WDDM 换页)。1500 以上性能完全持平,所以填 3000 = 白拿 2.5 GB 显存给别的程序,零性能代价。
2️⃣ CPU 专家池:23 砍到 15,反而快 8%
--pool-workers 默认 = 物理核 − 1 = 我这台的 23。
实测:
workers 速度
23(默认) 125.6 tok/s
15 135.5 tok/s
为什么少了更快? 专家缓存命中率 99.5%,很多层根本没 CPU 活;而这个池是屏障同步的,每层都要等所有 worker 到齐,一个 token 要过 48 层。让 23 个线程为 0~2 个任务全部醒来再停靠,同步开销远大于工作量。
3️⃣ 混合架构必调:--pool-affinity auto
默认 all 按 Windows 的核枚举顺序取核 —— 我实测探出来是交错的:
所以 --pool-affinity auto + 15 workers 拿到的是前 15 个位置 = 5 P 核 + 10 E 核而 默认auto(P 核优先)拿到 7 P + 8 E。
配置 实际核分布 速度
--pool-affinity all + 23 workers 7 P + 16 E 125.6
--pool-affinity all + 15 workers 5 P + 10 E 135.5
--pool-affinityauto + 15 7 P + 8 E 144.1
第二行:丢了 2 个 P 核还快了 7.9% —— 证明 E 核的屏障拖累 > P 核算力损失。
原生负优化的参数:
参数 结果
--pcie-frac 0.75 111.3, 比默认 0.55 低 20%
--spec 6 132.8, 比 4 低 2%
--spec-min-p 0.3/0.7 131.6 / 129.4,默认 0.5 最优
--suffix-draft 8、--prefill auto:16384 都在 ±2% 噪声内
后两项我第一次单次测量时显示 +6.8% / +10.3%,做 4 次交错测量后发现是纯噪声(基线自己就 ±6% 波动)。单次测量的"提升"基本都是假的。
性能实测
用 token-speed-tester 打真实服务(--max-tokens 1024 -r 3,提示词"写一篇关于 AI 的短文"),原始报告:
配置文件
文件位置:D:\Strata-main\variants\iq3_s-workers15-auto.json
json
{
"exe": "D:\Strata-main\engine\strata.exe",
"args": [
"--pack",
"D:\Strata-data\packs\iq3_s",
"--native",
"D:\Strata-Models\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf",
"--ple-gguf",
"D:\Strata-Models\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf",
"--expert-profile",
"D:\Strata-main\data\expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"auto",
"--spec",
"4",
"--spec-min-p",
"0.5",
"--mtp",
"D:\Strata-data\mtp\rt",
"--max-context",
"262144",
"--kv",
"int8",
"--kv-resident",
"32768",
"--vision",
"--vram-reserve-mib",
"3000",
"--control-vector-scaled",
"D:\Strata-main\data\experimental-speed-projection\Qwen3.8-Flash-Next-experimental-speed-projection.gguf:1.0",
"--control-vector-layer-range",
"4",
"44",
"--cvec-mode",
"project",
"--cvec-dir",
"per-layer",
"--pool-workers",
"15",
"--pool-affinity",
"auto"
],
"cwd": "D:\Strata-main",
"tokenizer": "D:\Strata-data\packs\iq3_s\tokenizer",
"model_name": "qwen3.8-flash-next-iq3_s",
"log": "D:\Strata-main\strata-iq3_s.log",
"lib_dirs": [
"D:\Strata-main\.venv\Lib\site-packages\nvidia\cu13\bin\x86_64"
],
"port": 8001,
"host": "0.0.0.0",
"gpu": 0,
"gpus_asked": true,
"vision": {
"exe": "D:\Strata-main\engine\strata-vision.exe",
"mmproj": "D:\Strata-Models\mmproj-Qwen3.8-Flash-Next-BF16.gguf",
"model": "D:\Strata-Models\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf",
"gpu": true,
"max_tokens": 1024
}
}