跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
perterP

perter

@perter
王侯将相
取消关注 关注
关于
帖子
176
主题
18
分享
0
群组
1
粉丝
1
关注
0

帖子

最新 最佳 有争议的

  • 【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
    perterP perter
    AI音视频画图 rtx5070 comfyui minimax

    适用人群:

    • 想跑 MiniMax H3 / Ref2VA / FL2VA
    • 想做长视频、动作戏、打斗、镜头衔接
    • 想在有限显存下追求画质最大化

    🟥 为什么 12GB 显存也能跑长视频?

    AI 视频推理显存需求动辄 24GB+,但通过 精度压缩、分段推理、显存碎片管理、软硬件分治,12GB 卡依然能做到:

    • 长视频分段生成(>60 秒)
    • 高动态动作戏稳定推理
    • 4K 超分放大(RTX VSR)
    • 画质不衰减的连续镜头

    下面是完整的工作流拆解。


    🟦 一、硬件与环境约束

    🖥️ 核心配置

    项目 配置
    GPU RTX 5070(12GB VRAM)
    CPU Ryzen 5700X
    RAM 64GB
    存储 SSD (48GB虚拟内存)

    🔒 稳定策略:功耗墙锁死 80%

    锁功耗墙的好处:

    • 避免瞬时电流尖峰导致黑屏
    • 显存颗粒温度更低
    • 长时间推理不掉帧
    • 显卡寿命更健康
    • 性能下降不足5%

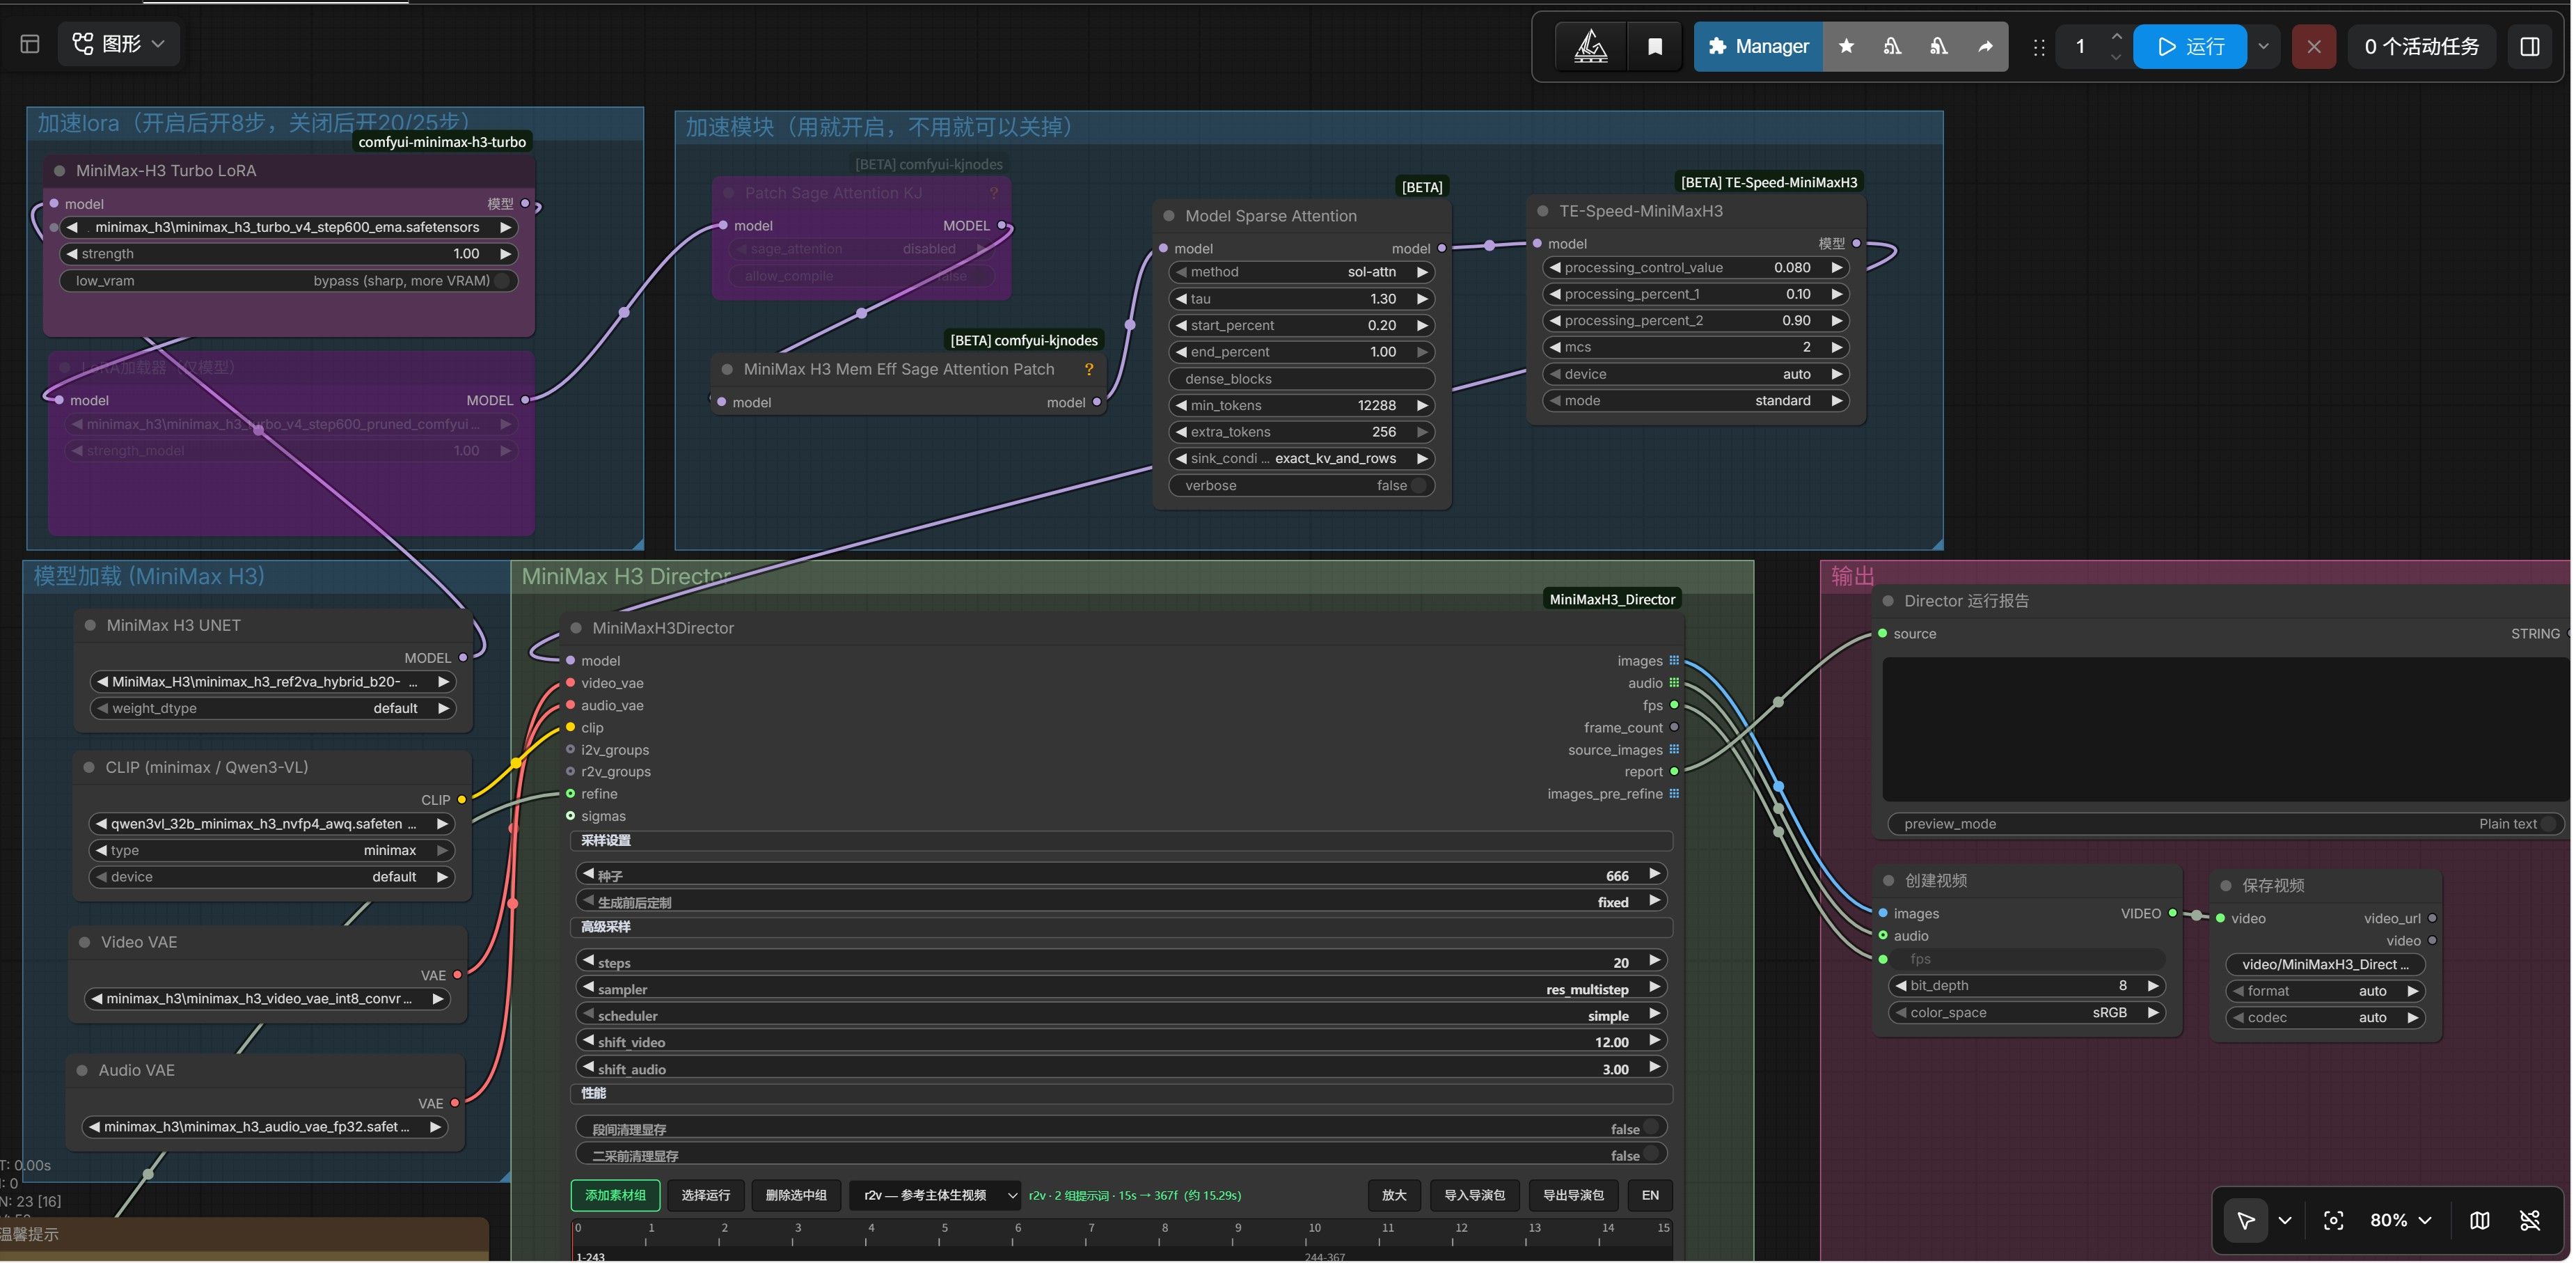
    🟦 二、模型与推理工作流(ComfyUI)

    🧬 1. 混合权重(Hybrid)

    兼顾 Ref2VA 的可控性 与 FL2VA 的画质:

    minimax_h3_ref2va_hybrid_b20-49_pruned_w4a8_mixed.safetensors
    qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
    minimax_h3_video_vae_int8_convrot.safetensors
    minimax_h3_audio_vae_fp32.safetensors
    

    加速 LoRA:

    minimax_h3_turbo_v4_step600_ema.safetensors
    

    ⚙️ 2. 精度方案:W4A8(黄金分割点)

    精度 显存占用 画质 推荐度
    FP16 高 优秀 ❌ 12GB 不稳
    INT8 ConvRot 中 良好 ✔ 可用
    W4A8 低 良好 ⭐ 最佳平衡
    NVFP4 低 良好 ✔ 50系专用

    🚀 3. 加速引擎

    • MiniMax H3 Mem Eff Patch / Sage Attention Patch
    • Block Sparse Attention
    • TE-Speed-MiniMaxH3 (3.5+)

    三者组合可减少 35–50% 推理时间。


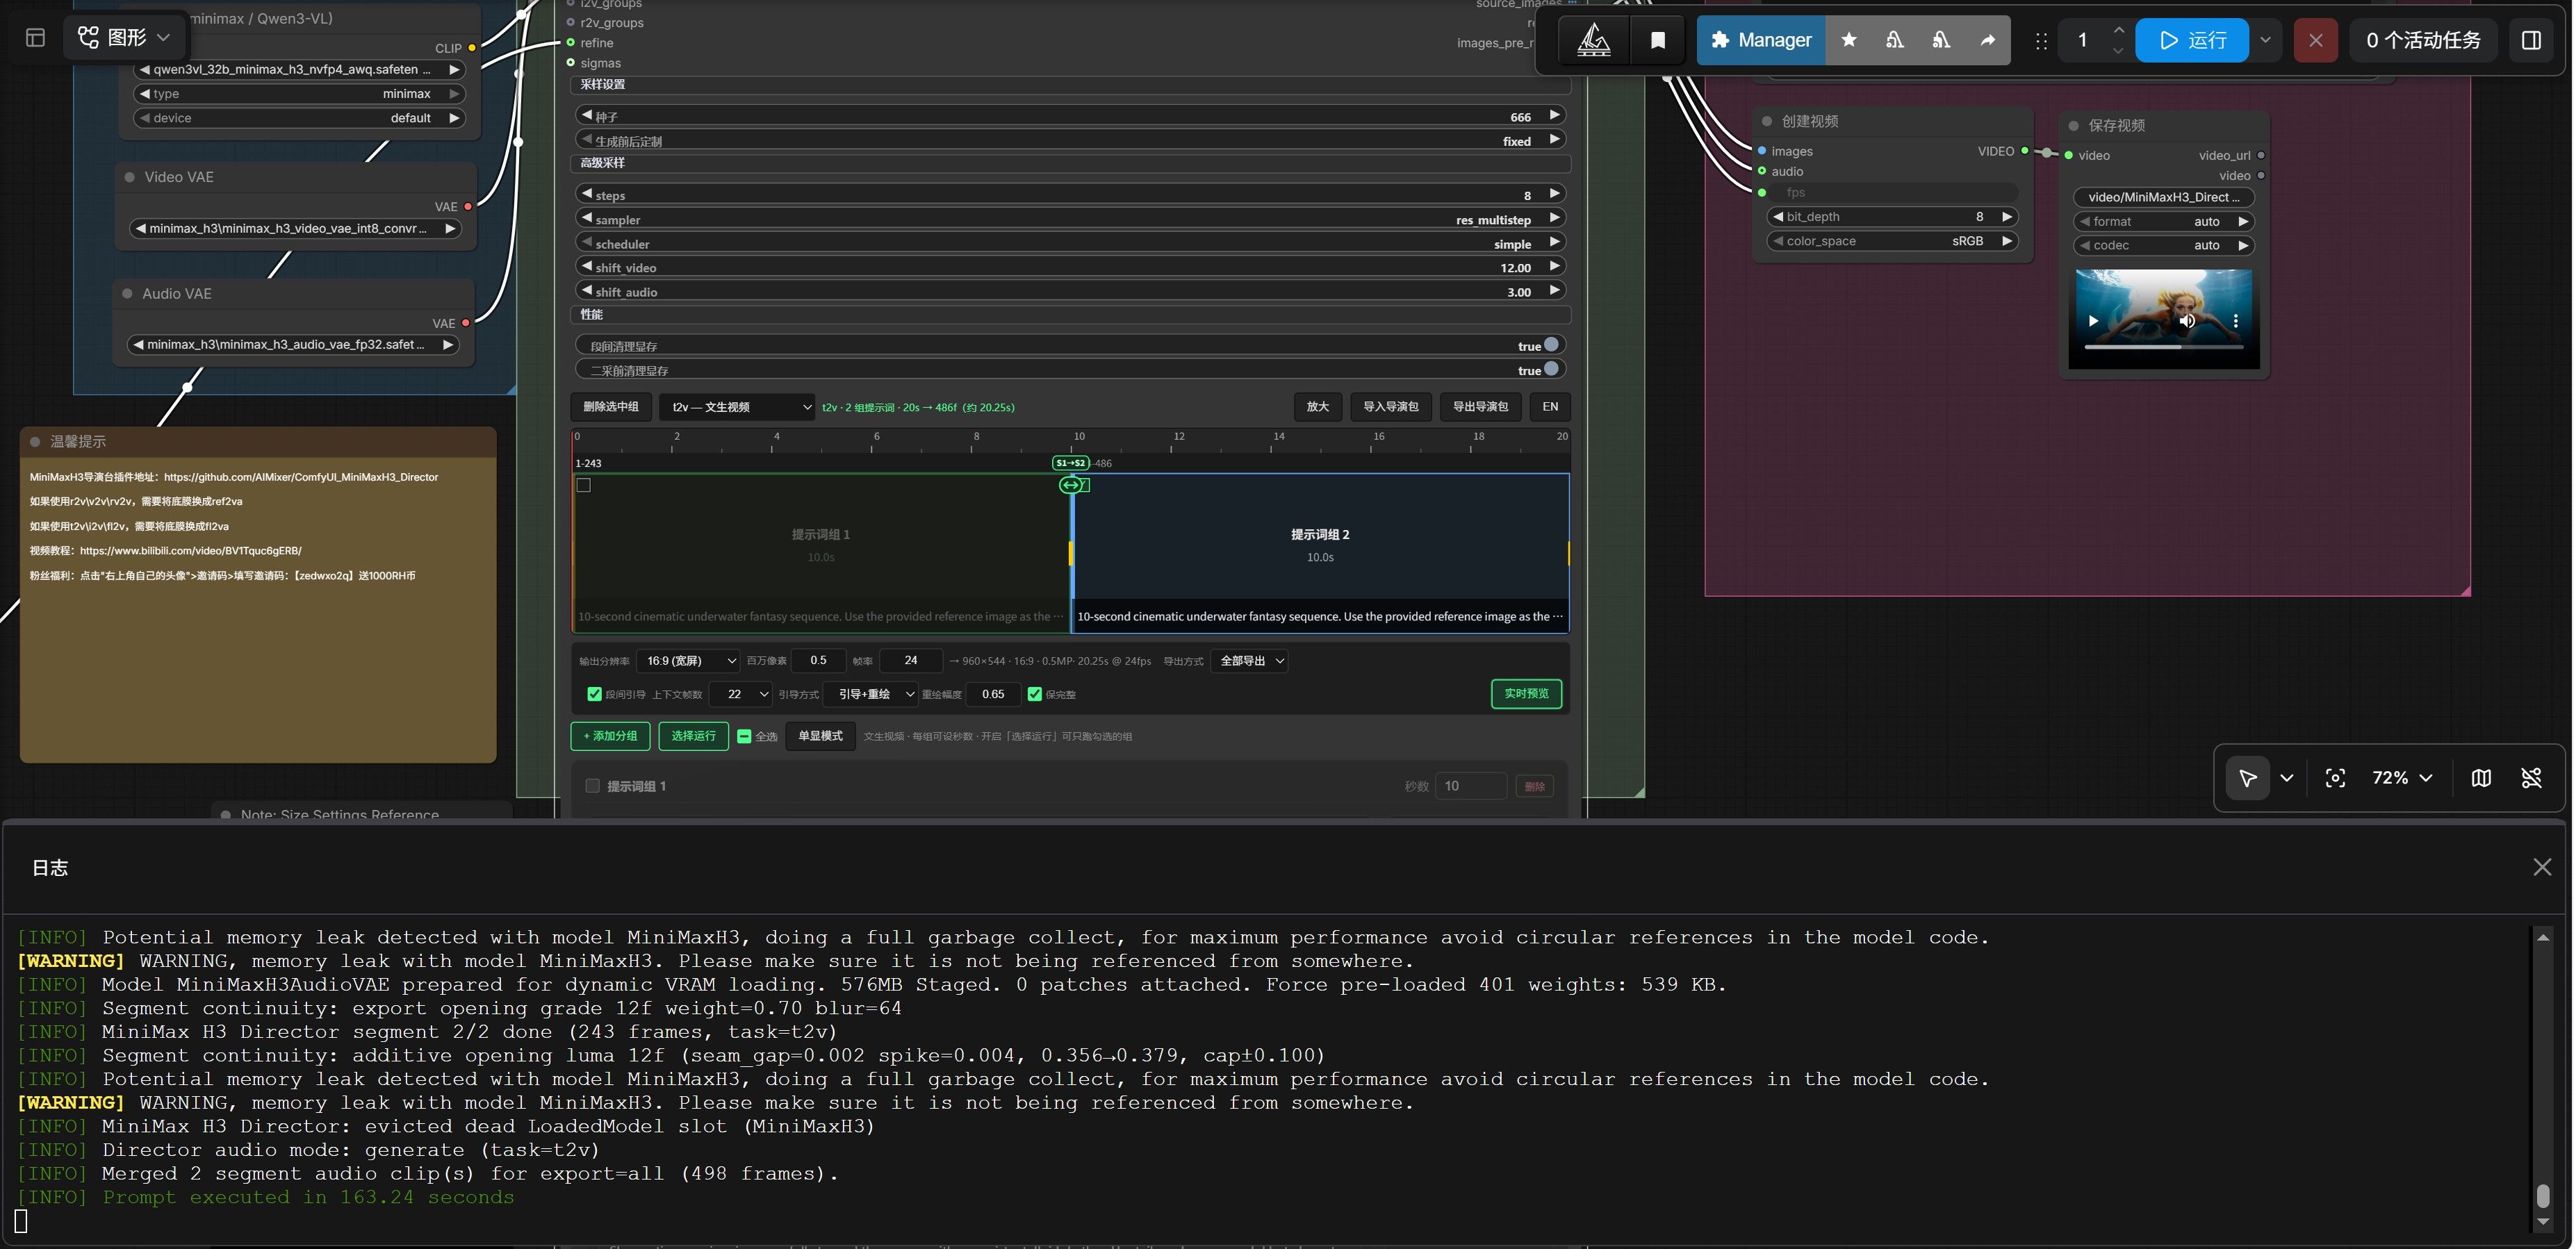
    🎬 4. 动态步数策略

    场景类型 步数 10 秒0.5M视频推理时间
    文戏 / 静态 6-step ~150s
    动作戏 / 打斗 8-step ~200s

    🔁 5. 分段生成 + 引导重绘策略(长视频关键)

    核心逻辑:

    • 使用“minmax h3 导演台”节点进行分段
    • 每段生成 10 秒 视频
    • 下一段以上一段的 尾帧 作为视频和声音引导
    • 重绘幅度设为 0.65
      建议:勾选每段生成后清理一次显存。

    效果:

    • 动作连续性提升一个档次
    • 长视频画质不衰减
    • 镜头衔接自然无跳帧

    🟦 三、画质放大与修复(The “4K Strategy”)

    目标: 在不进行离线 4K 推理的情况下,最终输出依然达到 4K 观感。


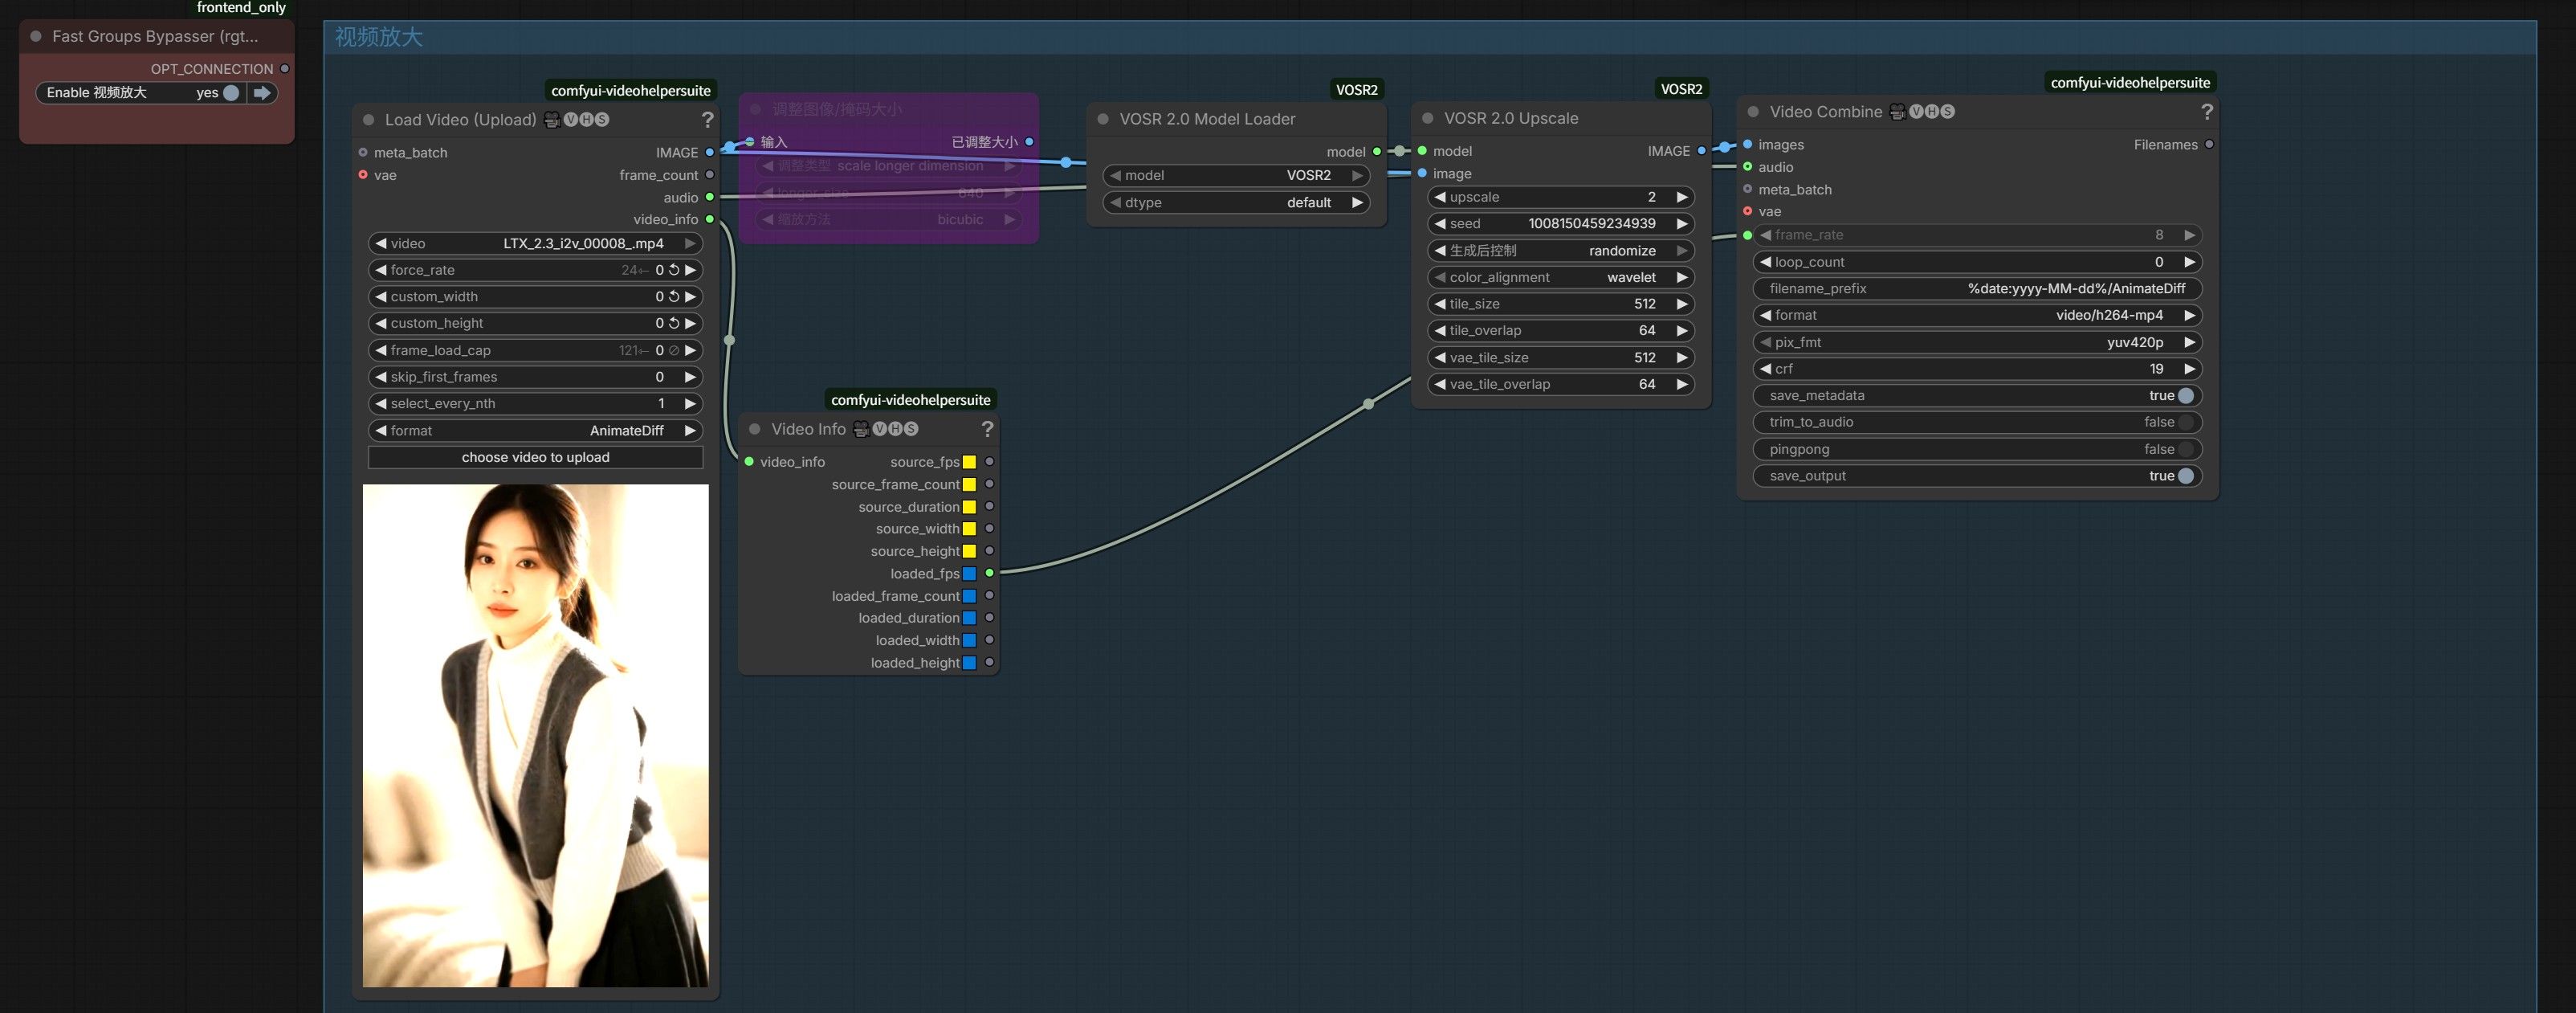
    🧩 第一阶段:视频质量修复(VOSR 2.0)

    输入:960×544
    输出:1080p

    VOSR 的优势:

    • 修复硬线条
    • 修复文字
    • 修复人物皮肤

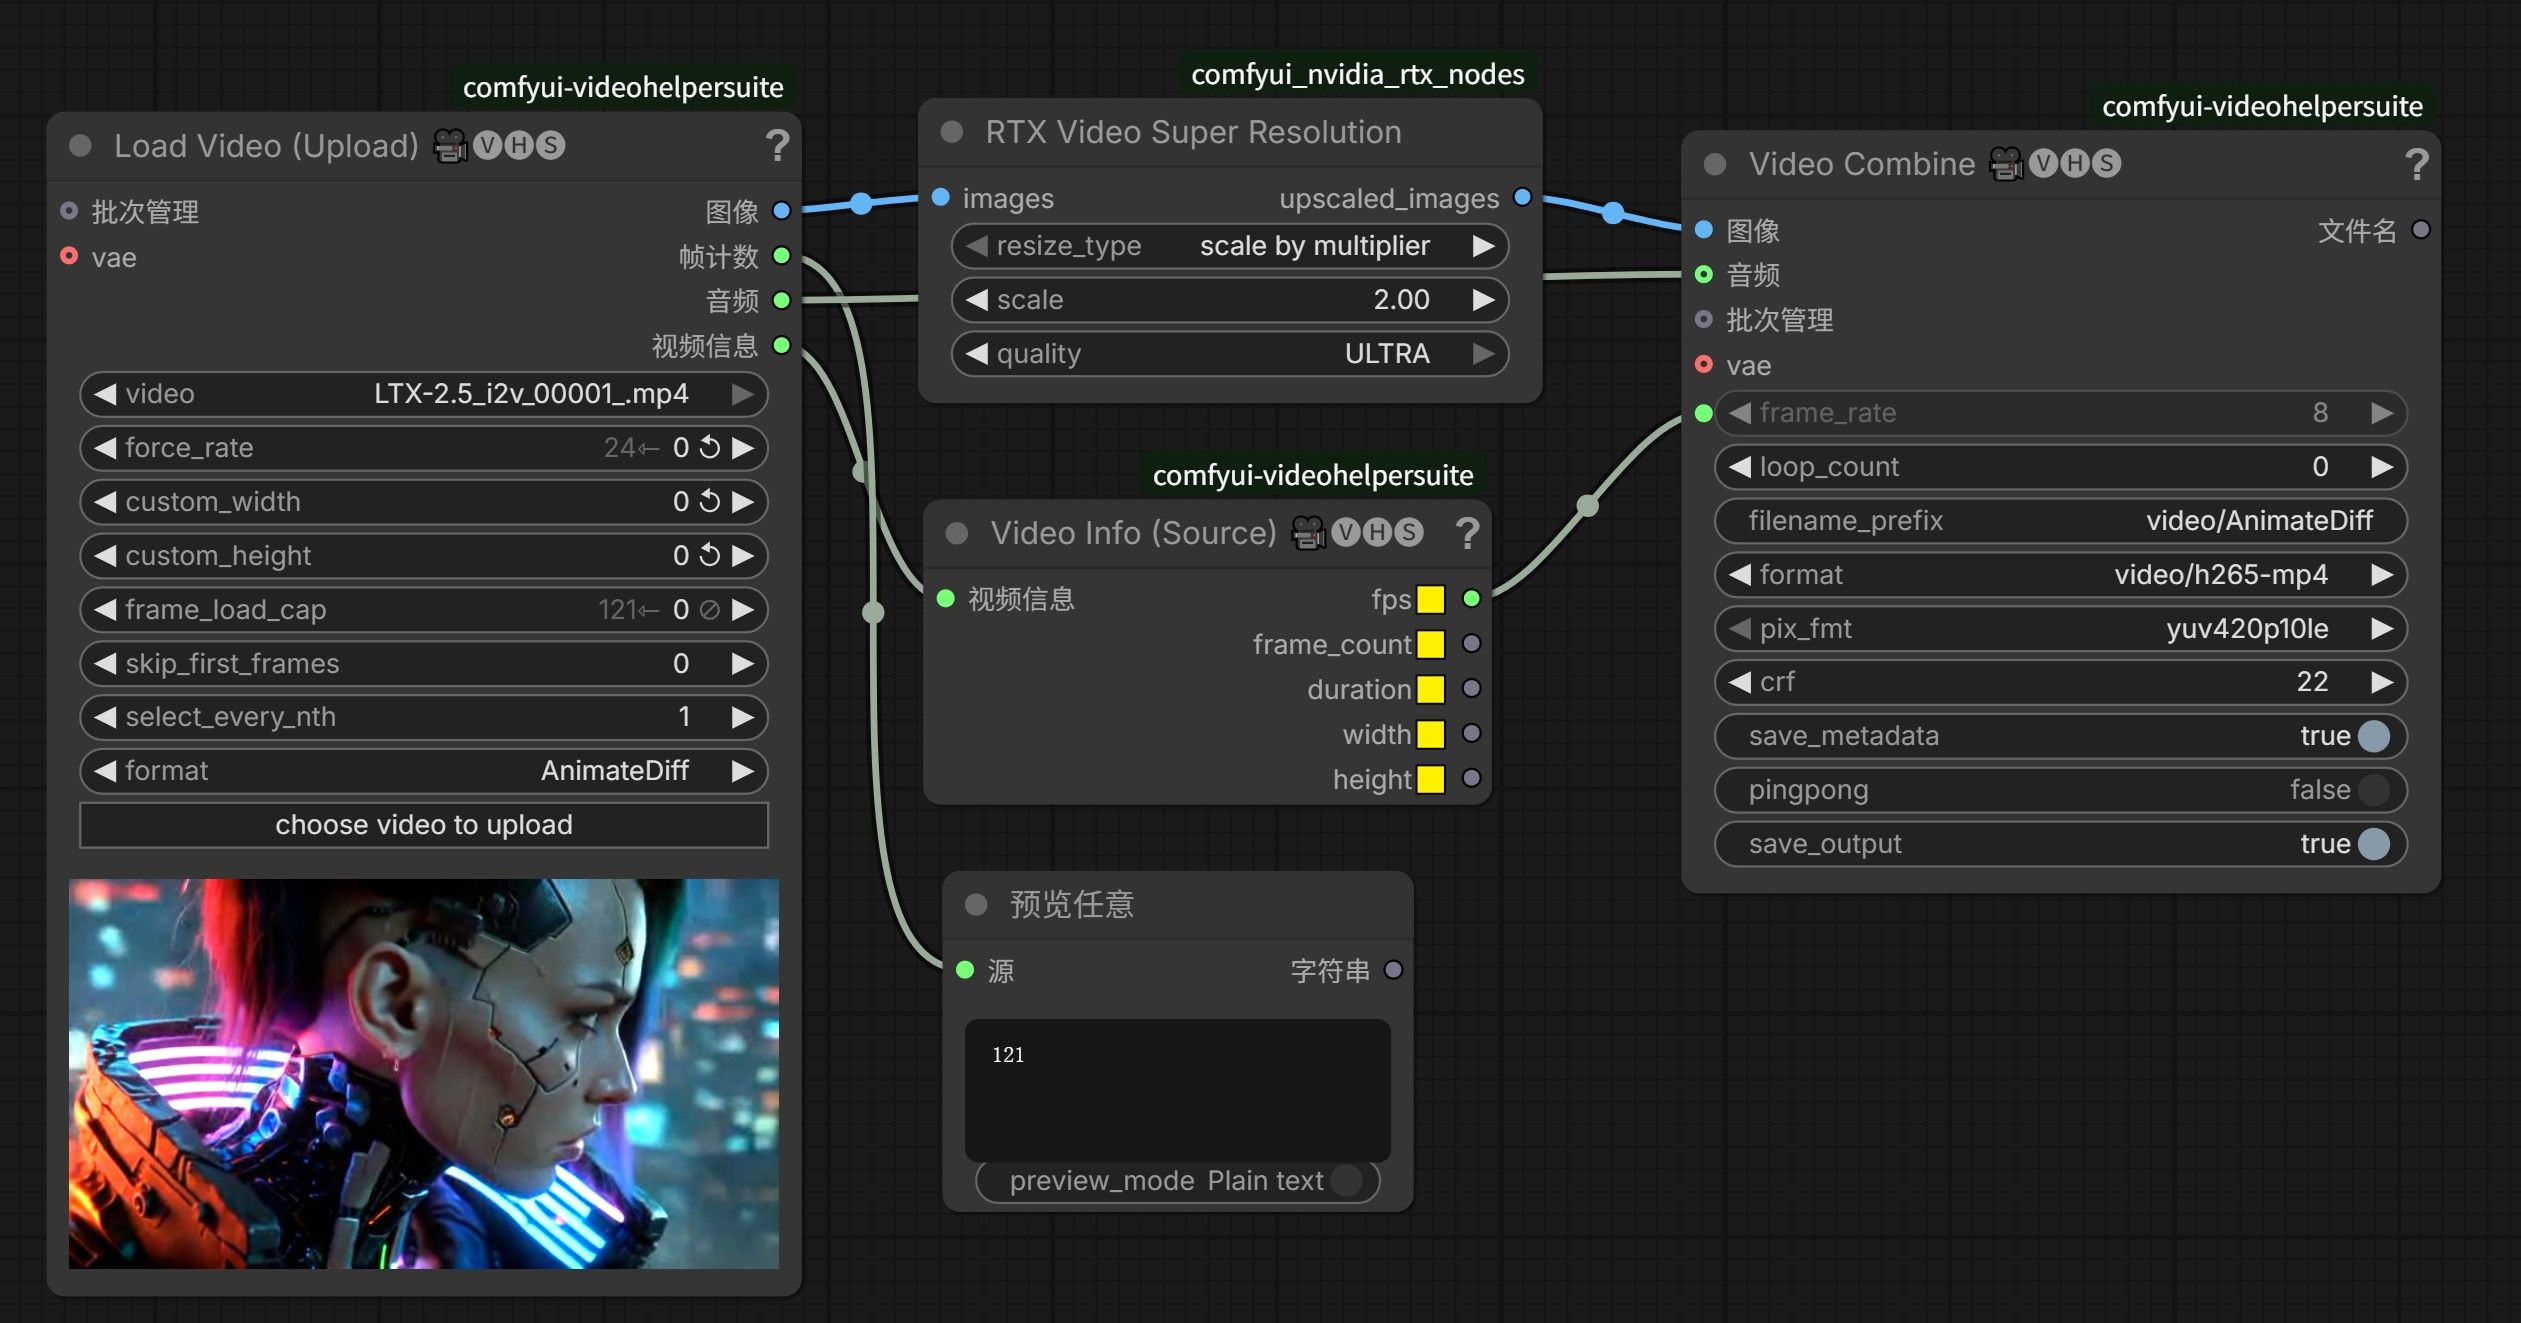
    📈 第二阶段:视频超分放大(RTX VSR)

    RTX+Video+Super+Resolution视频放大
    输入:1080p
    输出:4K

    • 基于 TensorRT 引擎
    • 几乎不占显存
    • 画质提升显著
    • 适合长视频放大

    🟩 四、最终总结

    即使只有 12GB 显存:

    • 通过 W4A8 精度压缩
    • 加速LORA
    • 分段重绘策略
    • VOSR + RTX VSR 两段式增强

    依然可以实现:

    • 长视频生成
    • 动作戏稳定推理
    • 4K 观感输出
    • 画质不衰减的连续镜头

    如果你也在用 50 系列或 40 系列显卡跑 MiniMax H3,欢迎在评论区分享你的工作流参数。

    Youtube Video


  • 新无审查版(484K)来了!Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF 完全支持Strata
    perterP perter
    LLM讨论区 qwen-flash strata 量化

    🧩 1. 模型简介

    该版本基于官方 GSQ‑RCO 量化模型,对其中 144 个“write‑to‑residual-stream”投影张量进行了 **abliteration(拒答方向消融)**处理,移除内置安全拒答方向,使模型更自由但也更不安全。
    模型仍保持原始 GSQ‑RCO 的量化结构与所有学习到的量化参数。
    引用:模型拒答方向被移除,需自行提供安全审查与访问控制 。


    🧬 2. Abliteration 做了什么?

    ✦ 2.1 替换的内容

    • 共 144 个张量被替换,覆盖全部 48 层
    • 替换来源:已存在的 abliterated 版本
    • 保留:所有 GSQ 学到的量化值与 block scale
      引用:144 个目标张量被替换,其他 1079 个保持字节一致 。

    ✦ 2.2 替换方式

    • Byte-level GGUF → GGUF tensor transplant(直接字节替换)
    • 9 个专家张量需重新编码为 Q2_0,但仍使用 GSQ 学到的 block scale
      引用:未进行任何 dequantize→quantize 循环,避免新增误差 。

    ✦ 2.3 为什么这样做?

    GSQ‑RCO 的量化值是学习得到的,重新量化会破坏其结构,因此唯一正确的 abliteration 方法是:

    在量化后的 GGUF 文件中直接替换目标张量
    引用:这是唯一保持 GSQ 工作的 abliteration 路径 。


    📦 3. 四个量化等级(Tier)与体积变化

    引用:各 tier 的体积变化与状态表格 。

    Tier 总大小 相比上游变化 状态
    IQ3_S 83.86 GB +0.25 GB 已构建 & 已验证
    IQ3_XXS 76.14 GB +0.30 GB 已构建 & 已验证
    IQ2_XS 78.47 GB +0.44 GB 已构建 & 已验证
    Q2_0 76.82 GB +0.40 GB 已构建 & 已验证

    增加的体积主要来自:

    • 96 个小张量仅存在 Q8_0 版本 → 需要提升类型
      引用:小张量导致 +0.25~0.44 GB 的体积增加 。

    ⚙️ 4. 性能影响

    • decode:104.5 tok/s → 104.4 tok/s(几乎无变化)
    • prefill:略微下降 1.7%
    • 专家缓存槽位:减少约 0.7%

    总体性能几乎与上游一致。


    🔧 5. Strata 引擎迁移注意事项

    关键点:

    • 必须重新构建 native pack
    • 官方 pack 的 native_experts.txt 不能复用
    • 迁移错误会导致 ArenaExpertSource
    • shard 2 自动识别
    • vision projector 可复用上游版本

    下载地址:(不会安装的可以让AI助手帮你安装)
    https://huggingface.co/SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF/tree/main

    追加最新去审查方法 (不用重新下载权重文件)

    • 安装原版(已经安装的可以跳过)
      https://github.com/Niko1221/Strata

    • 下载去拒绝(Abliterated)模型文件(484K)Qwen3.8-Flash-Next-abliterated-GSQ-RCO-Strata-GGUF

    • 修改配置文件 strata-<model>.json 追加以下向量设置:

    --control-vector-scaled <path>/Huihui-Qwen3.8-Flash-Next-refusal-direction-r.gguf:1.0
    --control-vector-layer-range 1 47 --cvec-mode project --cvec-dir
    
    • 重新启动

  • 【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
    perterP perter
    AI音视频画图 rtx5070 comfyui minimax

    MiniMax+H3+导演台全能工作流_加速版工作流

    image.jpeg

    实测 10 秒0.5M视频8step推理时间163秒
    image.jpeg
    MiniMax+H3+导演台全能工作流_加速版.json


  • 【极速版】Qwen-Image-2.1 Viggle Turbo v0.3:6步出图速度提升5倍!
    perterP perter
    AI音视频画图 图片生成 comfyui

    🚀Qwen-Image-2.1 Viggle Turbo 6步生成、速度提升5倍!
    这是一款把 40步扩散→6步 的模型,会带来什么体验?更快?更稳?更强?本帖带你一次看懂 Viggle Turbo 的核心亮点、安装要点、ComfyUI使用、已知限制与版本差异。

    🌟 一、模型定位:Qwen-Image-2.1 的极速精炼版
    Viggle Turbo 是对 Qwen-Image-2.1 的极速精炼版本,将原本 40 步的生成流程压缩到 6 步,并保持高质量输出。
    速度提升约 5×
    支持 文本转图像、指令编辑、1–3 张参考图像编辑
    无需分类器指导(No CFG)

    ⚙️ 二、版本升级:v0.3 vs v0.2.1
    v0.3(当前主推)
    颗粒更少、表面更干净、纹理更柔和
    仍保持与基础模型接近的多样性
    小字表现与 v0.2.1 接近
    不是严格升级:如果你喜欢更锐利的风格,v0.2.1 仍可选

    新增 9 步模式
    前 7 步使用 Turbo,后 2 步切回基础模型补细节
    小字更容易正确
    速度仍比基础模型快约 3.5×

    🔧 三、核心参数(Turbo 的灵魂)
    6步 SIGMAS(必须保持)

    [1.0, 0.9375, 0.875, 0.75, 0.5, 0.25]
    

    关键规则
    true_cfg_scale = 1.0(无 CFG)

    步数变化:只在高噪声端增减步数(5步、7步)

    移动低噪声节点会让图像更柔和

    🧩 四、文件结构与使用方式
    LoRA 文件(推荐)
    r256(1.3GB) 主力版本
    r128(0.7GB)适合 ComfyUI 工作流

    单文件 Transformer(合并版)
    提供 int8、fp8、GGUF 多种量化格式

    合并后会损失部分 LoRA 更新效果(约 30%)

    🖥️ 五、ComfyUI 使用要点
    官方提供 自定义节点 + 工作流 JSON
    下载地址:https://huggingface.co/Viggle/Qwen-Image-2.1-viggle-turbo/tree/main/comfyui

    默认使用 int8 模型 + r128 LoRA,显存约 8GB 可跑到 1248×832 分辨率

    Turbo Sigmas 替代 KSampler 调度器(无 CFG、无负提示)

    编辑模式输出大小跟随参考图像 1

    🧪 六、已知限制(务必了解)
    复杂编辑:多引用、面部交换、身份保持仍可能弱于基础模型

    小文字:比基础模型更容易混乱

    颜色饱和度:略低于基础模型

    v0.3 在细纹理上比 v0.2.1 更柔


  • 【分享】无审查版DeepSeek-V4.1-Flash-1017-Uncensored-GSQ-RCO-IQ2_XXS-GGUF
    perterP perter
    LLM讨论区 deepseek 量化 本地模型

    🧩 1. 模型简介

    DeepSeek‑V4.1‑Flash‑1017‑Uncensored‑GSQ‑RCO‑IQ2_XXS‑GGUF基于:

    • 列表DeepSeek 官方模型:DeepSeek‑V4.1‑Flash‑1017
    • ISTA‑DASLab 的 GSQ‑RCO 量化版本
    • AtomicChat 的 Uncensored(去拒答)修改

    然后作者 Abiray 将去拒答修改 直接写入模型权重,生成新的 GGUF 文件。


    🧬 2. 为什么叫 Zero-LoRA?

    所有 86 个修改过的 tensor 已经直接写回 GGUF 主模型,不需要运行时加载 LoRA。。

    优点:

    • 启动更简单
    • 不需要额外 Adapter
    • 推理速度不会因为 LoRA 增加开销
    • llama.cpp / Strata 更容易兼容

    ⚙️ 3. 性能影响

    这是 ISTA‑DASLab 的量化技术。项目宣称:

    • 保留了 28 个 IQ1_M 路由专家层
    • 保留了 GSQ 校准结果
    • 尽可能保持原模型能力不损失

    可以理解成:
    总体性能几乎与上游一致。


    🔧 4. 下载地址

    需要本地执行,并且有去审查需要的可以在下面地址下载。

    无审查版DeepSeek-V4.1-Flash-1017-Uncensored-GSQ-RCO-IQ2_XXS-GGUF


  • 【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
    perterP perter
    AI音视频画图 rtx5070 comfyui minimax

    视频超分放大(RTX VSR) 工作流
    image.jpeg
    视频超分放大(RTX VSR).json


  • 【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
    perterP perter
    AI音视频画图 rtx5070 comfyui minimax

    视频放大修复(VOSR 2.0)工作流
    image.jpeg

    视频修复放大【VOSR2】.json


  • 【Minimax H3】卡通儿童ABC儿歌
    perterP perter
    AI音视频画图 minimax 视频生成 comfyui

    @Junjie-Heng 说:

    @terry 好勒哥 我下一个视频试试看用首尾帧生看看效果怎么样 🫡

    可以试一试minmax h3 导演台 参考下面的帖子
    https://lcz.me/topic/1743


  • 10-11 提示词挑战 :微缩岛屿
    perterP perter
    随便聊聊 编程 本地模型

    @kos-or
    加入反重复惩罚会抑制重复
    repetition_penalty=1.1
    penalty_last_n=128


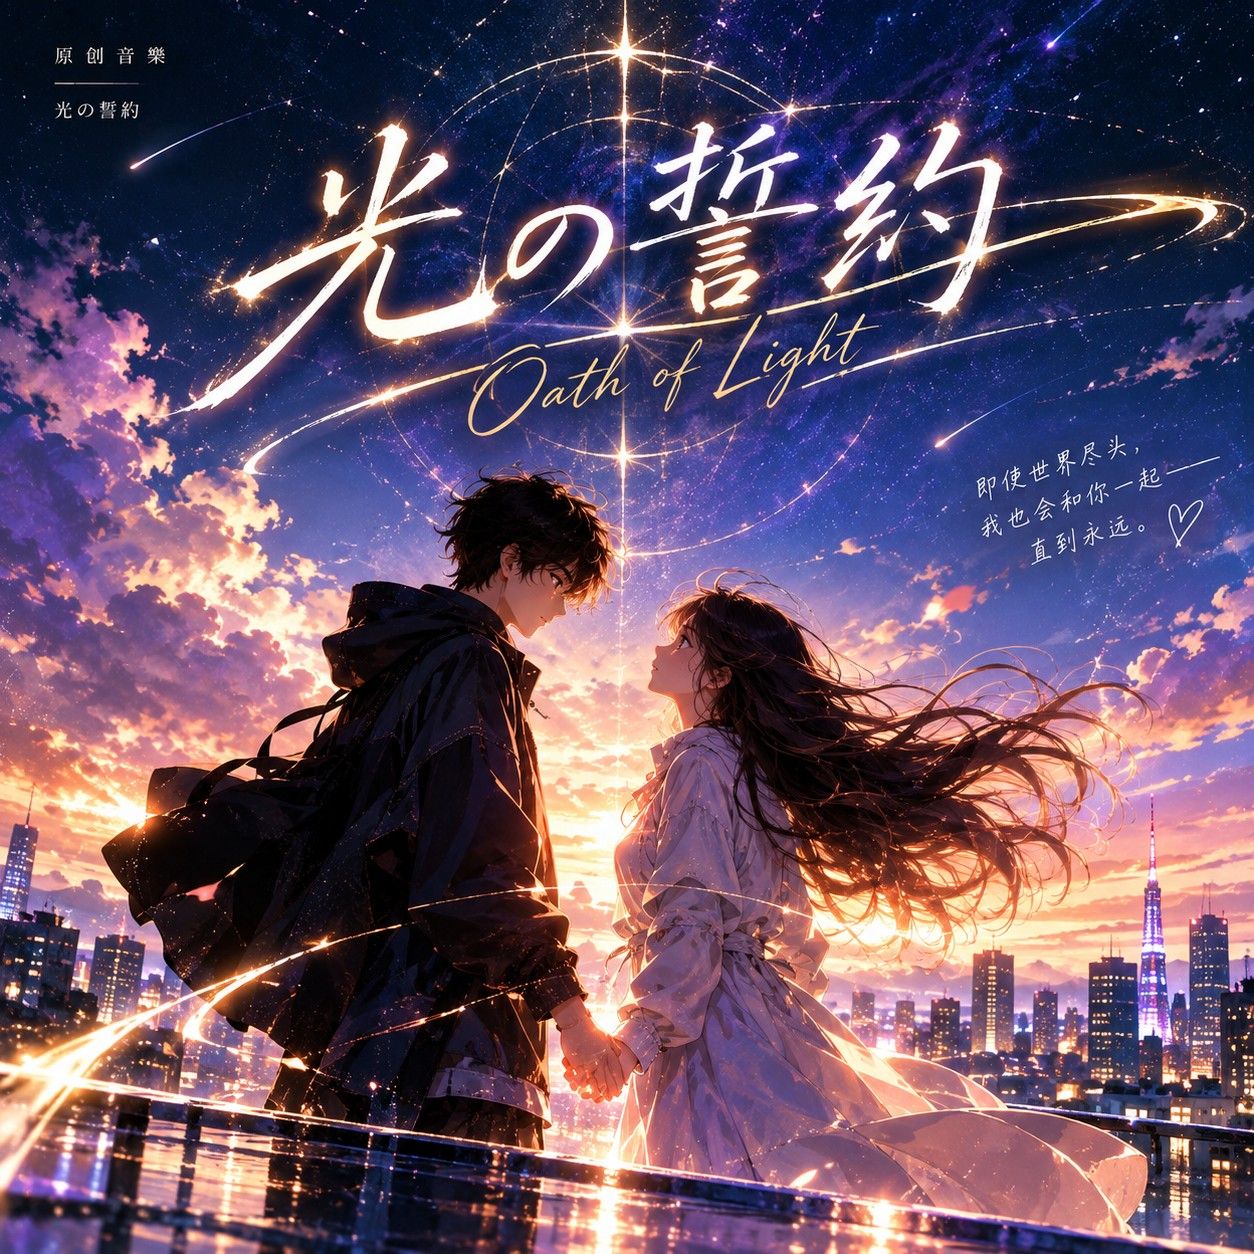
  • 【MiniMax-Music3本地生成】日文原创音乐:光の誓約 (Oath of Light)完整版
    perterP perter
    AI音视频画图 minimax 本地模型

    Oath of Light.mp3

    image_00001_14.jpg

    歌词

    [Intro]
    (激しいピアノの旋律から、疾走するギターリフへ)
    
    [Verse 1]
    壊れた空の 破片が降る
    終わりのない 迷宮の先へ
    握りしめた この痛みさえ
    明日を変える 鍵になるから
    
    [Pre-Chorus]
    立ち止まるな 運命(さだめ)の場所へ
    響き合う魂(こころ) 重なる鼓動
    怖くはない 君が隣にいれば
    
    [Chorus]
    光の誓約を 胸に刻み込んで
    どんな闇も 切り裂いてゆこう
    例え世界が 敵になっても
    守り抜くよ その涙も 未来も
    僕らは何度でも 空を飛べるから!
    
    [Verse 2]
    誰かの影に 隠れてた日々
    もう戻らない 昨日を捨てて
    君と描いた 地図を広げ
    信じた道へ 駆け抜けていく
    
    [Pre-Chorus]
    聞こえるだろう 遠い約束が
    終わりの合図 はじまりの鐘
    負けはしない 君と笑うために
    
    [Chorus]
    奇跡を起こして 夜を塗り替えて
    熱い火花 刃に宿して
    傷つくことさえ 力に変えて
    燃やし尽くす この命 捧げて
    輝くその先へ 今、飛び立つよ!
    
    [Bridge]
    (ピアノと歌声だけ)
    遠い日の 約束を
    忘れはしない 忘れないから
    この手で 掴み取るんだ
    明日という名の 陽光を
    
    [Final Chorus]
    光の誓約を 胸に刻み込んで
    どんな闇も 切り裂いてゆこう
    例え世界が 敵になっても
    守り抜くよ その涙も 未来も
    僕らは何度でも 空を飛べるから!
    
    [Outro]
    (ギターのフィードバック音と共に)
    君と共に 光の中へ...
    

    MiniMax-Music3本地生成ComfyUI官方原生工作流
    https://docs.comfy.org/tutorials/audio/minimax/minimax-music-3


  • 【分享】无审查版DeepSeek-V4.1-Flash-1017-Uncensored-GSQ-RCO-IQ2_XXS-GGUF
    perterP perter
    LLM讨论区 deepseek 量化 本地模型

    @terry 说:

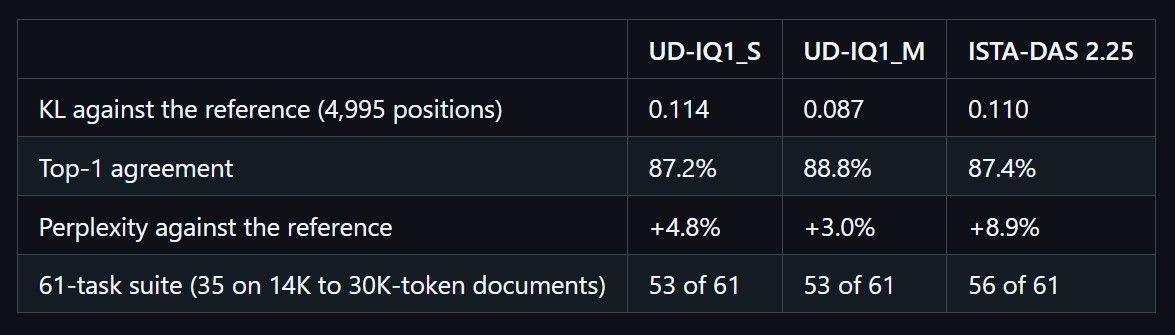
    我一直疑惑,IQ2真特么能干活吗?这都量化到姥姥家了。

    怎么说呢?至少比1-bit 版本(Unsloth 的 UD-IQ1_S 和 UD-IQ1_M DeepSeek )强一点点。
    image.jpeg


  • 新配置的X99 + 单卡7900XTX + 128G DDR3,生成速度
    perterP perter
    AI音视频画图 x99 7900xtx

    @梁晓伟 说:

    没有加速界面,硬跑,这速度也太慢了...

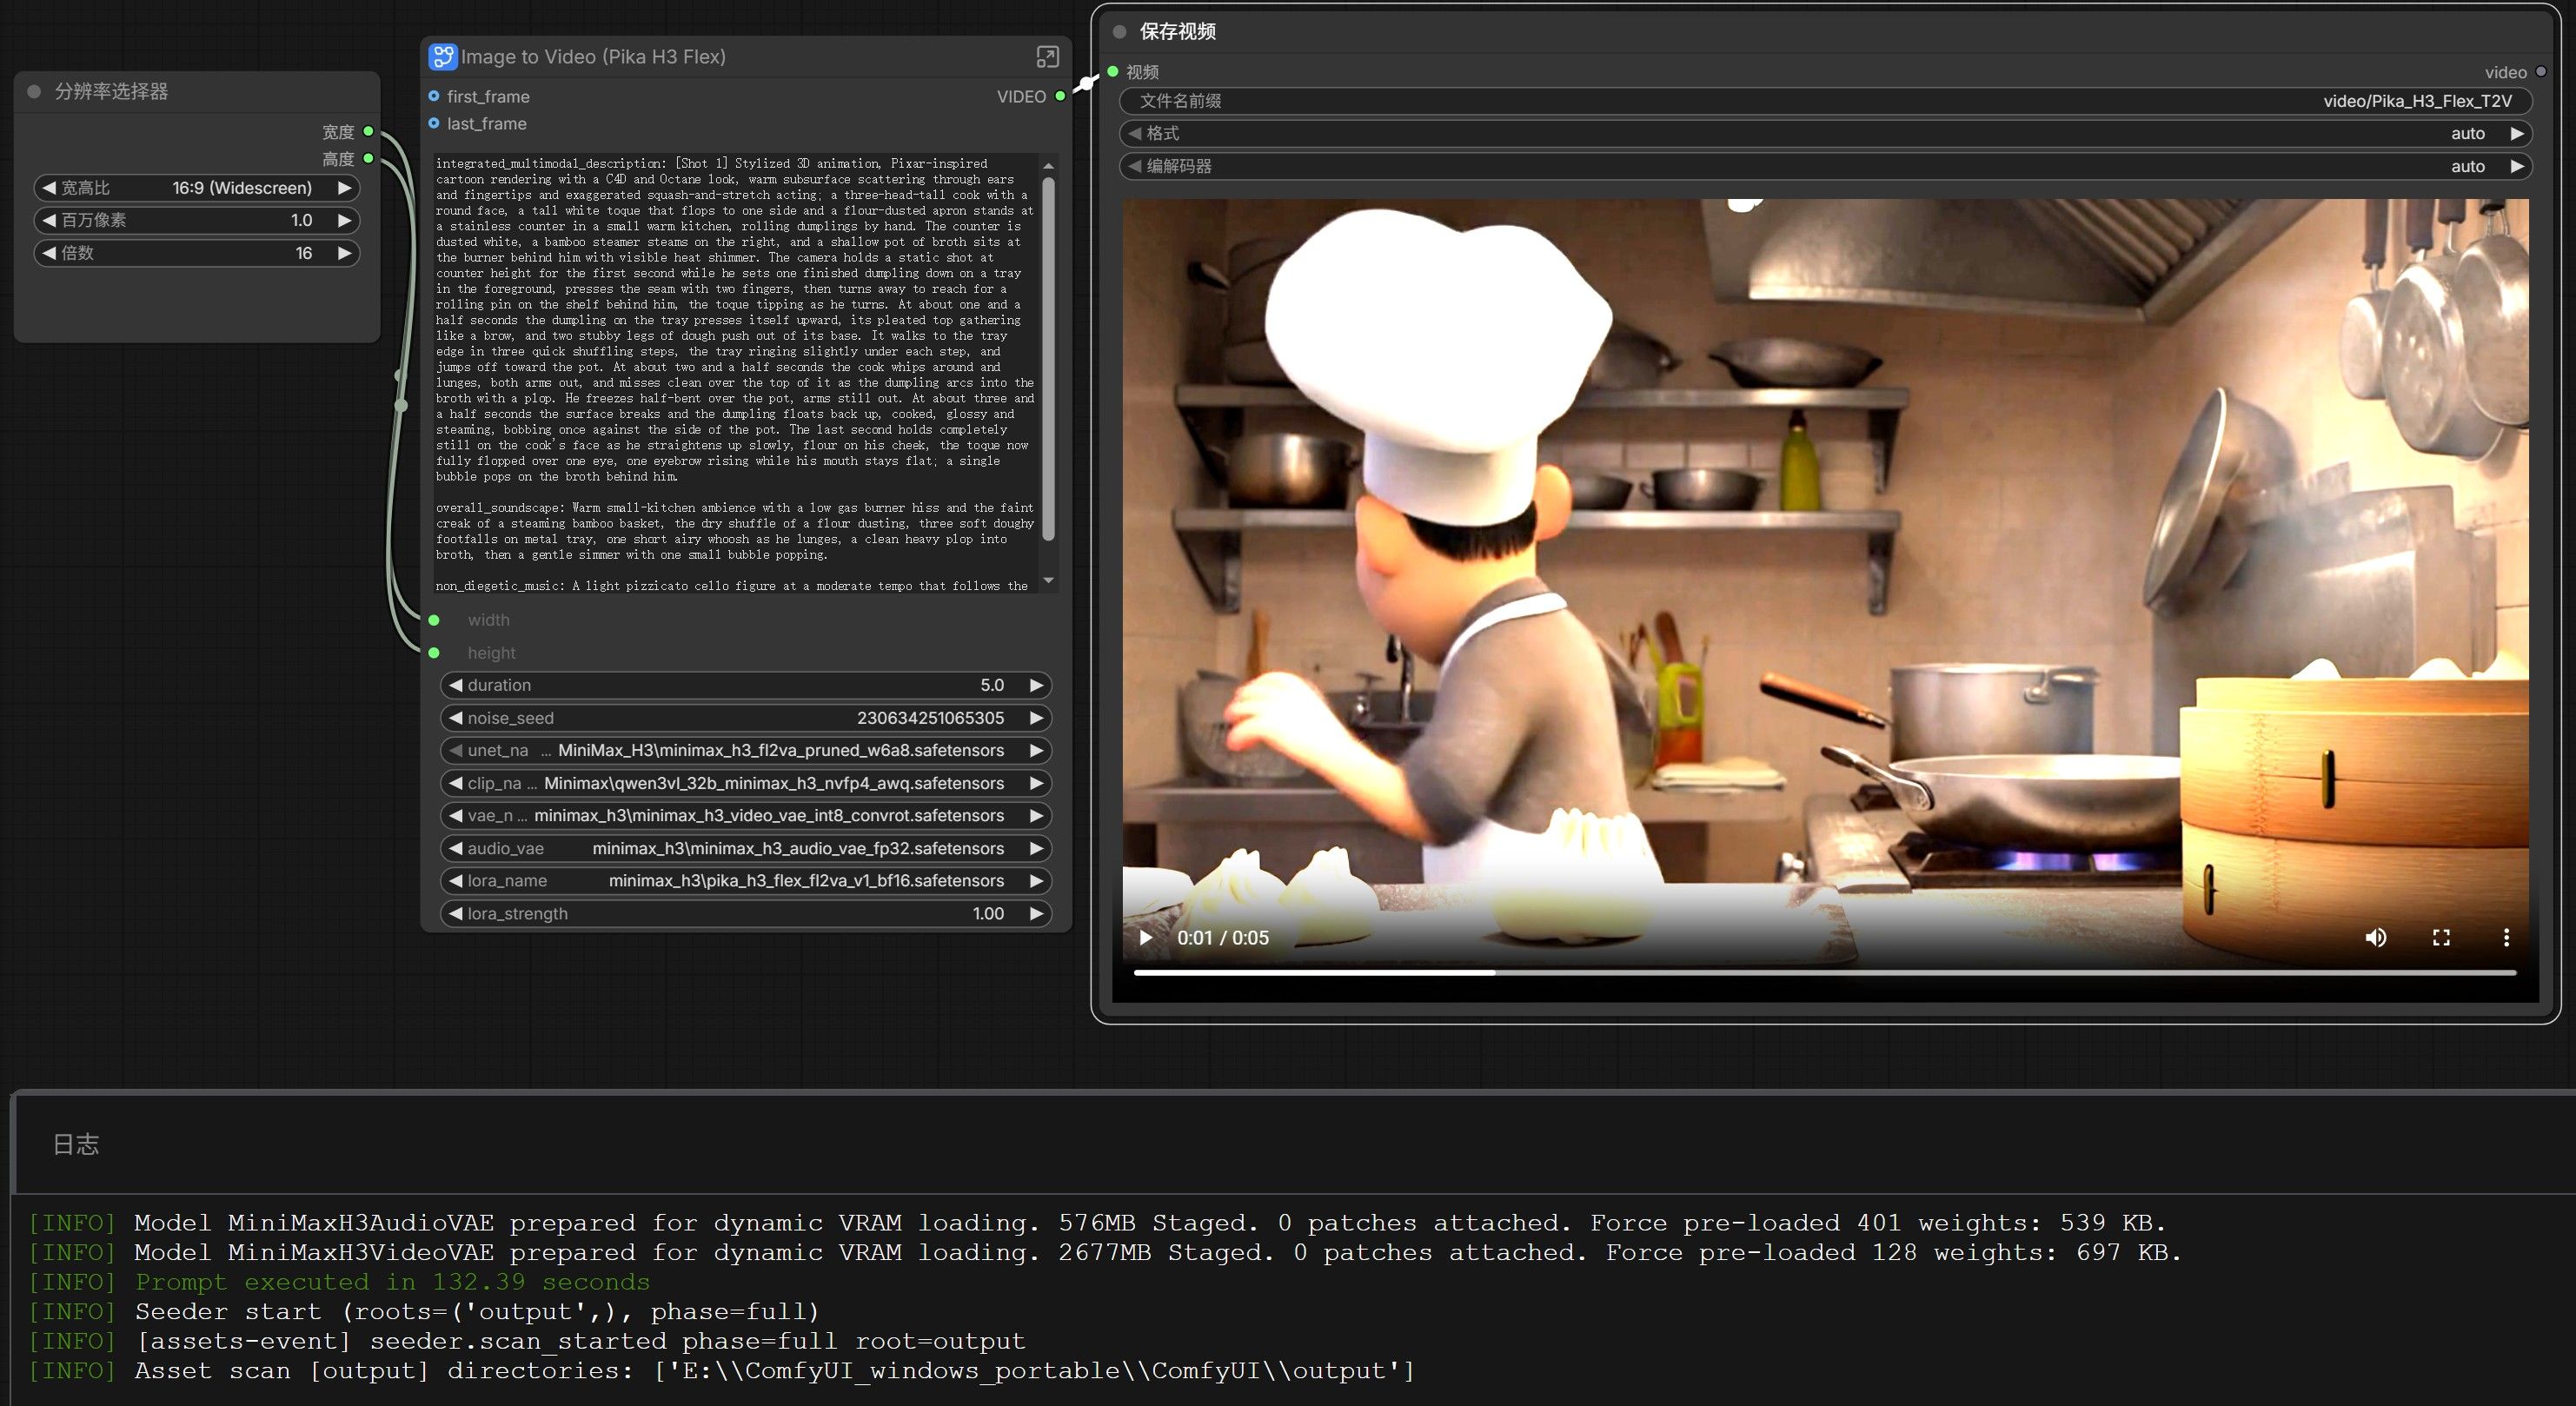
    你可以试一试目前比较流行的Pika-H3-Flex 6步加速。
    https://docs.comfy.org/zh/tutorials/video/pika/pika-h3-flex
    5070显卡1.0M/5s视频 Pika-H3-Flex官方工作流开加速跑6步(132s)
    image.jpeg


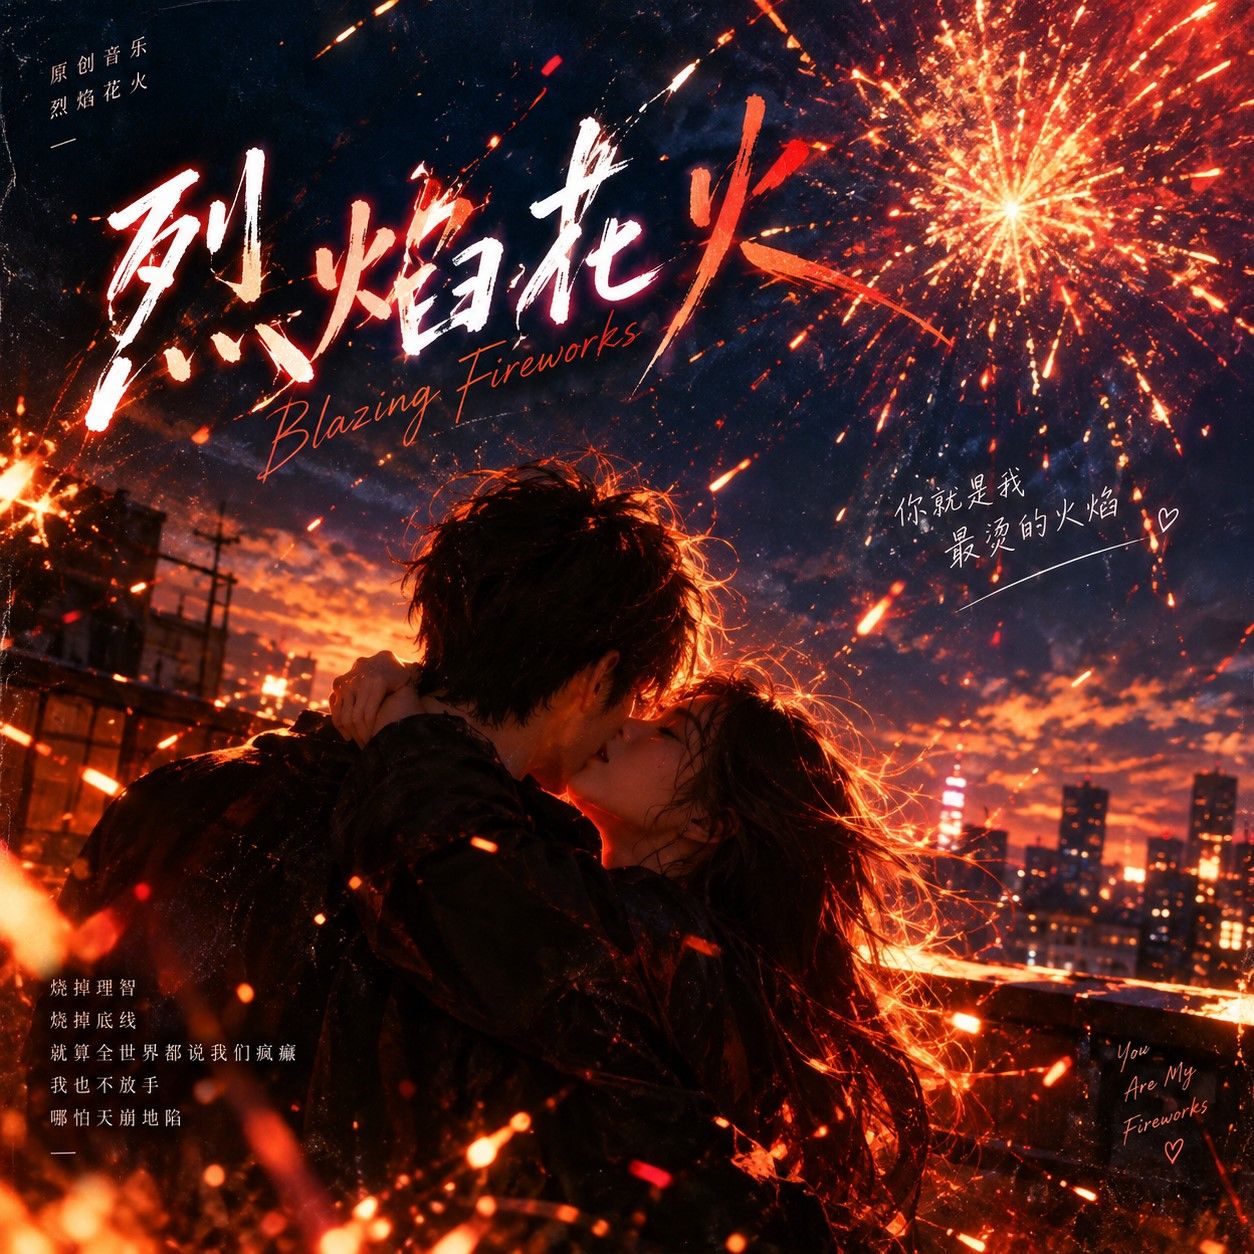
  • 【MiniMax-Music3本地生成】原创音乐:烈焰花火
    perterP perter
    AI音视频画图 minimax comfyui

    MiniMax-Music3本地生成ComfyUI官方原生工作流
    https://docs.comfy.org/tutorials/audio/minimax/minimax-music-3
    烈焰花火.jpg

    歌词

    [Verse 1]
    你摔门而出 雨淋湿了街
    我追到楼下 嗓子已喊哑
    这次是谁错 管他的算了
    你回头那一眼 我就投降了
    
    你的脾气像炸药 一点就着
    我的嘴太笨 总说错别怪我
    但每次冷战 你先投降煮面
    我就知道 这辈子逃不掉了
    
    [Pre-Chorus]
    不要说分开 (不想听)
    不要说再见 (别说了)
    拉住我的手 (抓紧了!)
    
    [Chorus]
    你就是我 最烫的火焰
    烧掉理智 烧掉底线
    就算全世界 都说我们疯癫
    我也不放手 哪怕天崩地陷
    
    Woah-oh-oh 烧吧烧吧
    Woah-oh-oh 烈焰花火
    
    [Verse 2]
    朋友都说 我变了很多
    以前自由 现在被你牵着走
    但你没看到 有多值得
    一个拥抱 就能治愈所有
    
    你骂我固执 我笑你啰嗦
    天生一对 谁也别说谁
    爱就爱了 管它天长地久
    此刻有你 我就足够
    
    [Pre-Chorus]
    不要说放弃 (我不听)
    不要说拜拜 (别想了)
    抱住就别松 (抱紧了!)
    
    [Chorus]
    你就是我 最烫的火焰
    烧掉理智 烧掉底线
    就算全世界 都说我们疯癫
    我也不放手 哪怕天崩地陷
    
    Woah-oh-oh 烧吧烧吧
    Woah-oh-oh 烈焰花火
    
    [Bridge]
    (只剩一把干净吉他,声音脆弱)
     不能没有你...
    
    [Final Chorus]
    你是我的 全部!!!!
    你就是我 最烫的火焰
    烧掉所有 烧掉一切
    就算世界 毁灭在眼前
    我牵着你 冲向终点
    
    Woah-oh-oh 烧吧烧吧
    Woah-oh-oh 烈焰花火
    Woah-oh-oh 直到尽头
    Woah-oh-oh 你是我的!!!
    

    烈焰花火.mp3


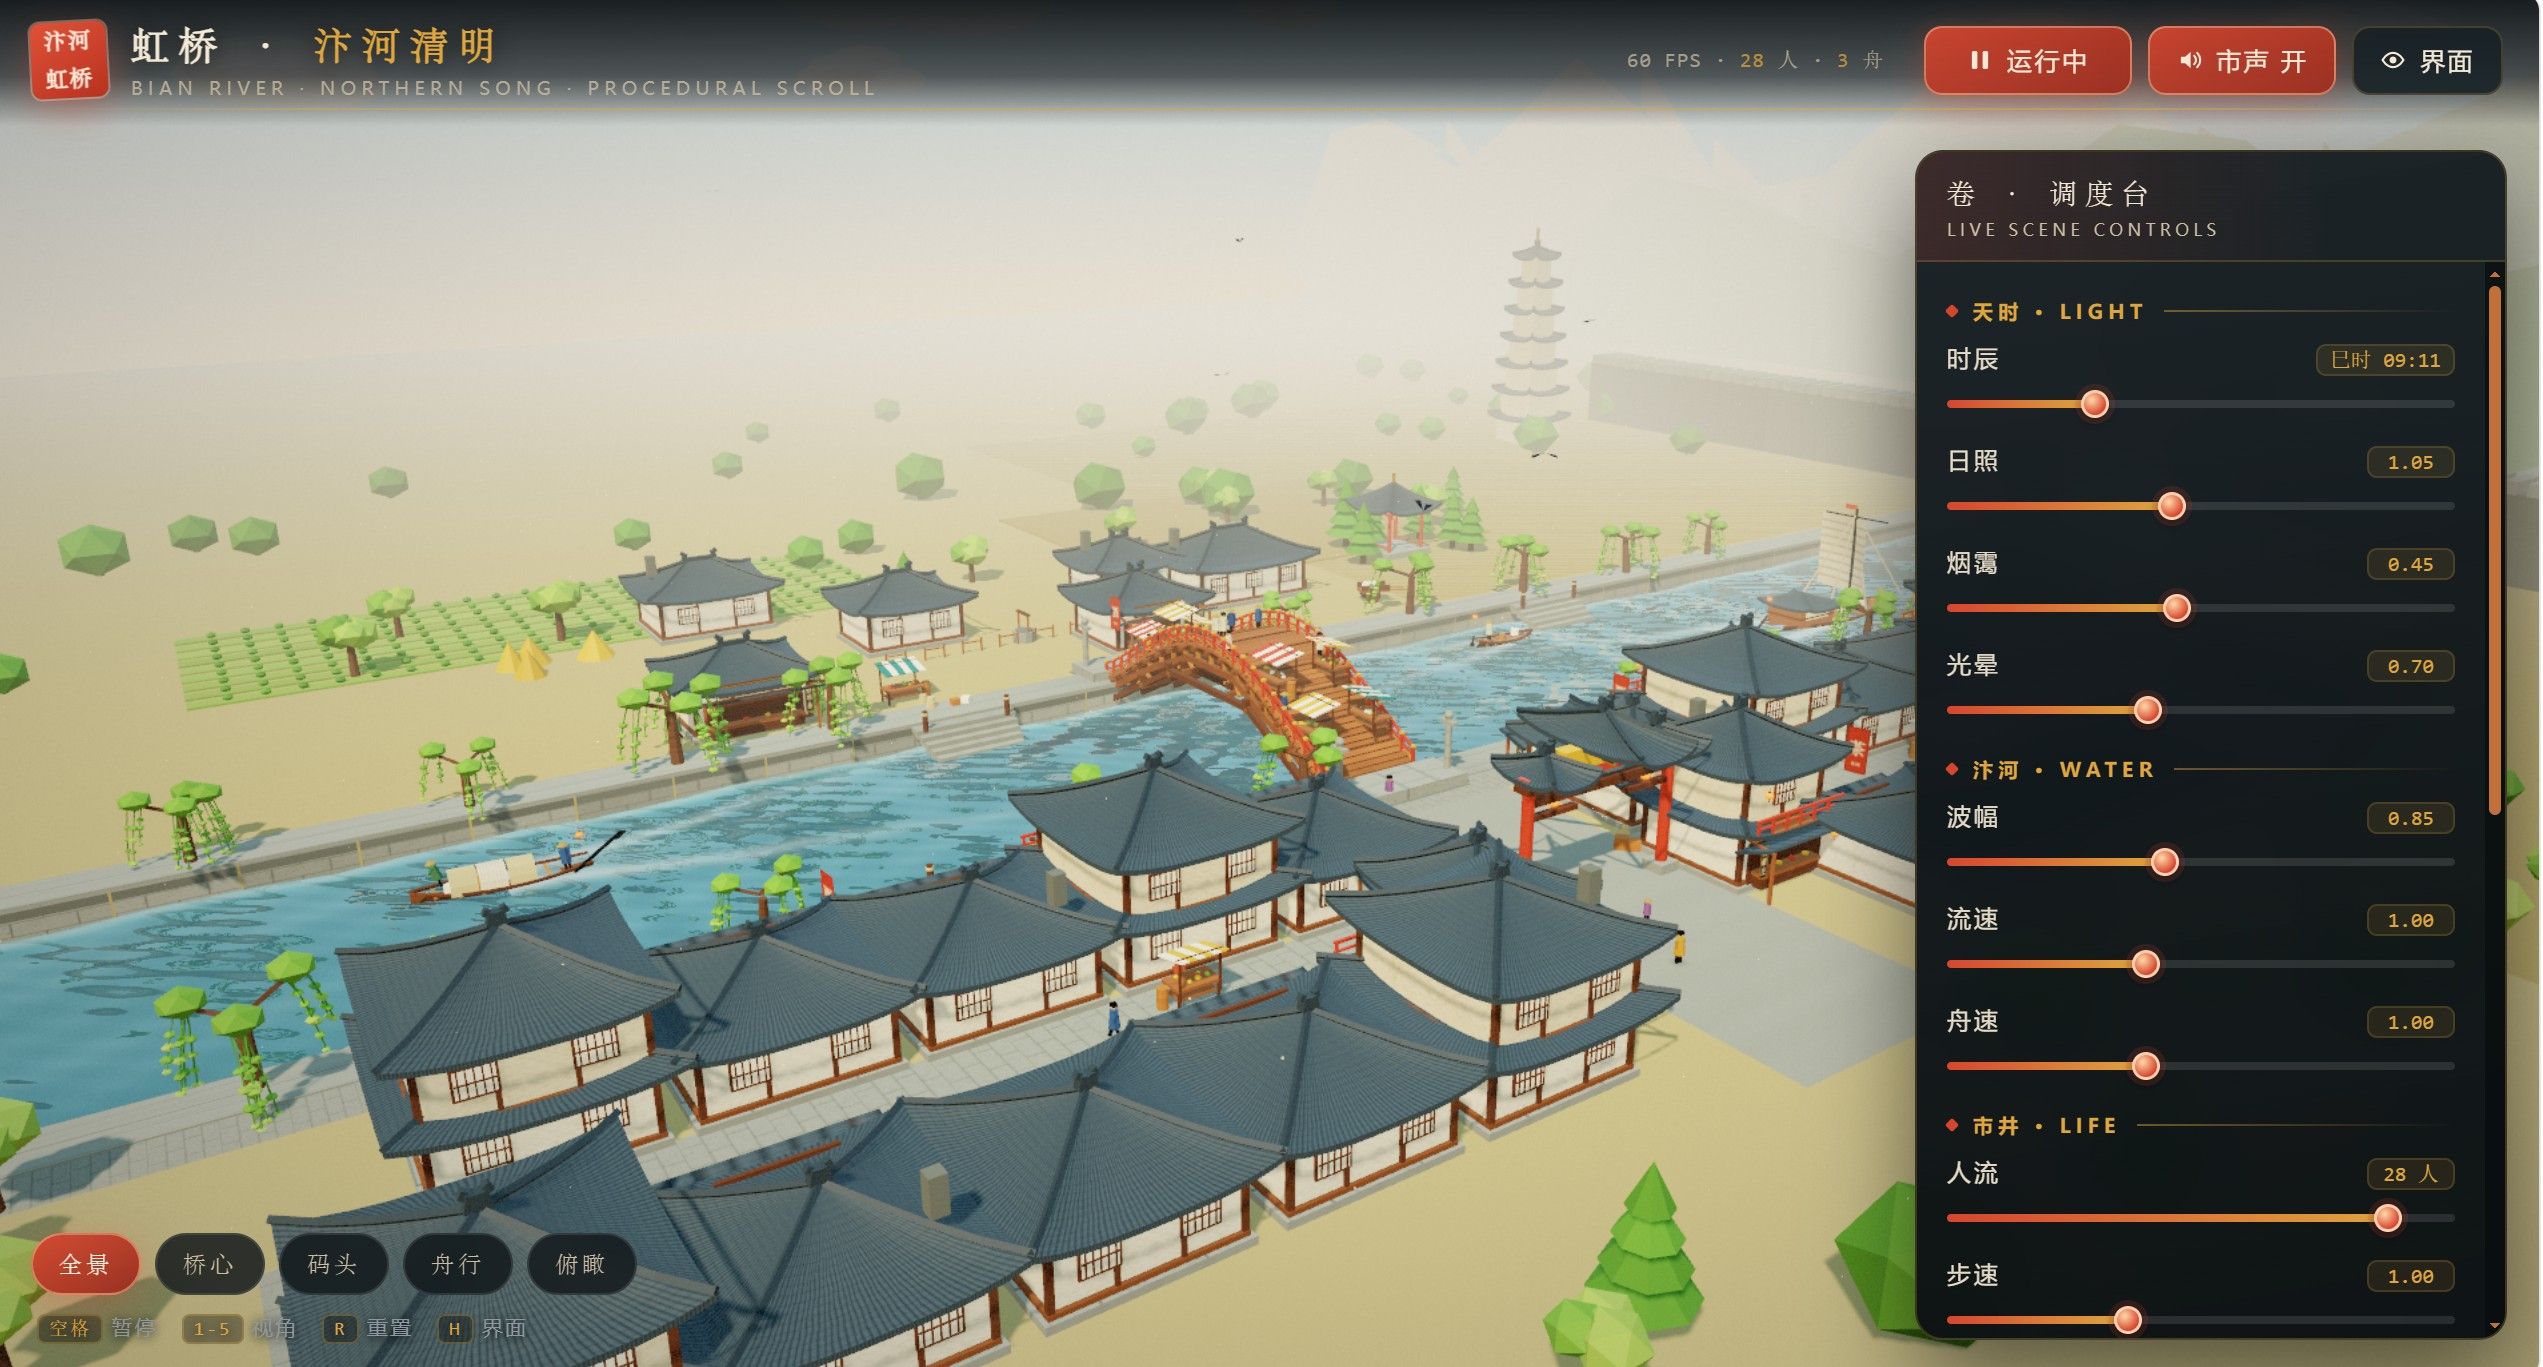
  • 【实测求助】5060 Ti 16GB + 量化Qwen 27B挑战《清明上河图》3D场景:代码能写出来,但Agent总是卡在最后一步,有人能完整跑通吗?
    perterP perter
    LLM讨论区 rtx5060 qwen-27b 本地模型

    @focuser-li
    Qoduck(QWEN4.0 27B ?)
    image.jpeg

    hongqiao-bianhe.html


  • 【最强 35B MoE 模型】Qwen3.8‑35B‑A3B‑Distill‑GGUF
    perterP perter
    LLM讨论区 qwen llama.cpp 量化

    🌟 模型简介

    首先申明Qwen3.8‑35B‑A3B‑Distill‑GGUF不是Qwen官方发布的模型, 是Empero将 Qwen3.8 前沿模型蒸馏到 Qwen3.6‑35B‑A3B 的 Mixture‑of‑Experts(MoE)架构版本,提供多种 GGUF 量化文件,可直接用于 llama.cpp、Ollama、LM Studio、Jan、KoboldCpp 等推理框架。

    模型特点:

    • 35B 总参数
    • 每 token 仅激活约 3B 参数(MoE 稀疏)
    • 推理速度显著快于同体量稠密模型

    🧠 架构细节

    • 30 层 Gated DeltaNet
    • 10 层 全注意力层
    • 256 个专家,每 token 路由 8 个专家

    ⚠️ 使用前注意

    加载此模型需要 支持 Qwen3.6 / Gated DeltaNet MoE 的新版 llama.cpp。
    旧版本会直接加载失败。


    📦 GGUF 文件列表(量化方式与大小)

    文件名 量化 大小 说明
    IQ2_M 12.558 GB 最小可用,16GB 显卡可跑
    Q2_K 13.839 GB 2-bit K-quant,兼容性好
    IQ3_M 16.340 GB 3-bit,高性价比
    Q3_K_M 17.664 GB 常规 3-bit K-quant
    IQ4_XS 19.628 GB 接近 Q4_K_M,体积更小
    Q4_K_M(推荐) 21.713 GB 质量与体积最佳平衡
    Q5_K_M 25.348 GB 更高质量
    Q6_K 29.209 GB 接近无损
    Q8_0 37.802 GB 最高质量量化
    BF16 71.067 GB 全精度参考版
    Vision Projector 0.899 GB 图像输入需要搭配此文件

    💻 VRAM / RAM 需求指南

    量化 GPU VRAM CPU RAM
    IQ2_M / Q2_K 16GB 16GB
    IQ3_M / Q3_K_M 20–24GB 24GB
    IQ4_XS / Q4_K_M 24GB 32GB
    Q5_K_M / Q6_K 32GB 48GB
    Q8_0 48GB 64GB
    BF16 80GB+ 96GB

    MoE 架构让 CPU 推理比稠密模型更可行。


    🛠 推理示例(llama.cpp)

    文本推理

    llama-cli -m Qwen3.8-35B-A3B-Q4_K_M.gguf \
      --temp 0.6 --top-p 0.95 --top-k 20 \
      -n 16384 -cnv
    

    模型属于 推理模型(reasoning model),回答开头会带结构化块,需要在最终输出中清理掉。


    图像推理(Vision)

    llama-mtmd-cli \
      -m Qwen3.8-35B-A3B-Q4_K_M.gguf \
      --mmproj mmproj-Qwen3.8-35B-A3B-F16.gguf \
      --image photo.jpg \
      -p "Describe this image."
    

    视觉模型来自 Qwen3.6‑35B‑A3B,蒸馏过程未评估视觉能力。


    🧩 Ollama / LM Studio / Jan / KoboldCpp

    直接加载 GGUF 文件即可,聊天模板已内置。
    推荐采样参数:temperature=0.6, top_p=0.95, top_k=20


    🔐 校验下载

    下载地址:Qwen3.8-35B-A3B-Distill-GGUF

    sha256sum -c SHA256SUMS --ignore-missing
    

    📜 许可

    模型权重使用 Apache‑2.0 许可。


  • 【ADM显卡优化】Strata v0.1.34 Windows 系统下的AMD 显卡一键启动
    perterP perter
    LLM讨论区 strata amd

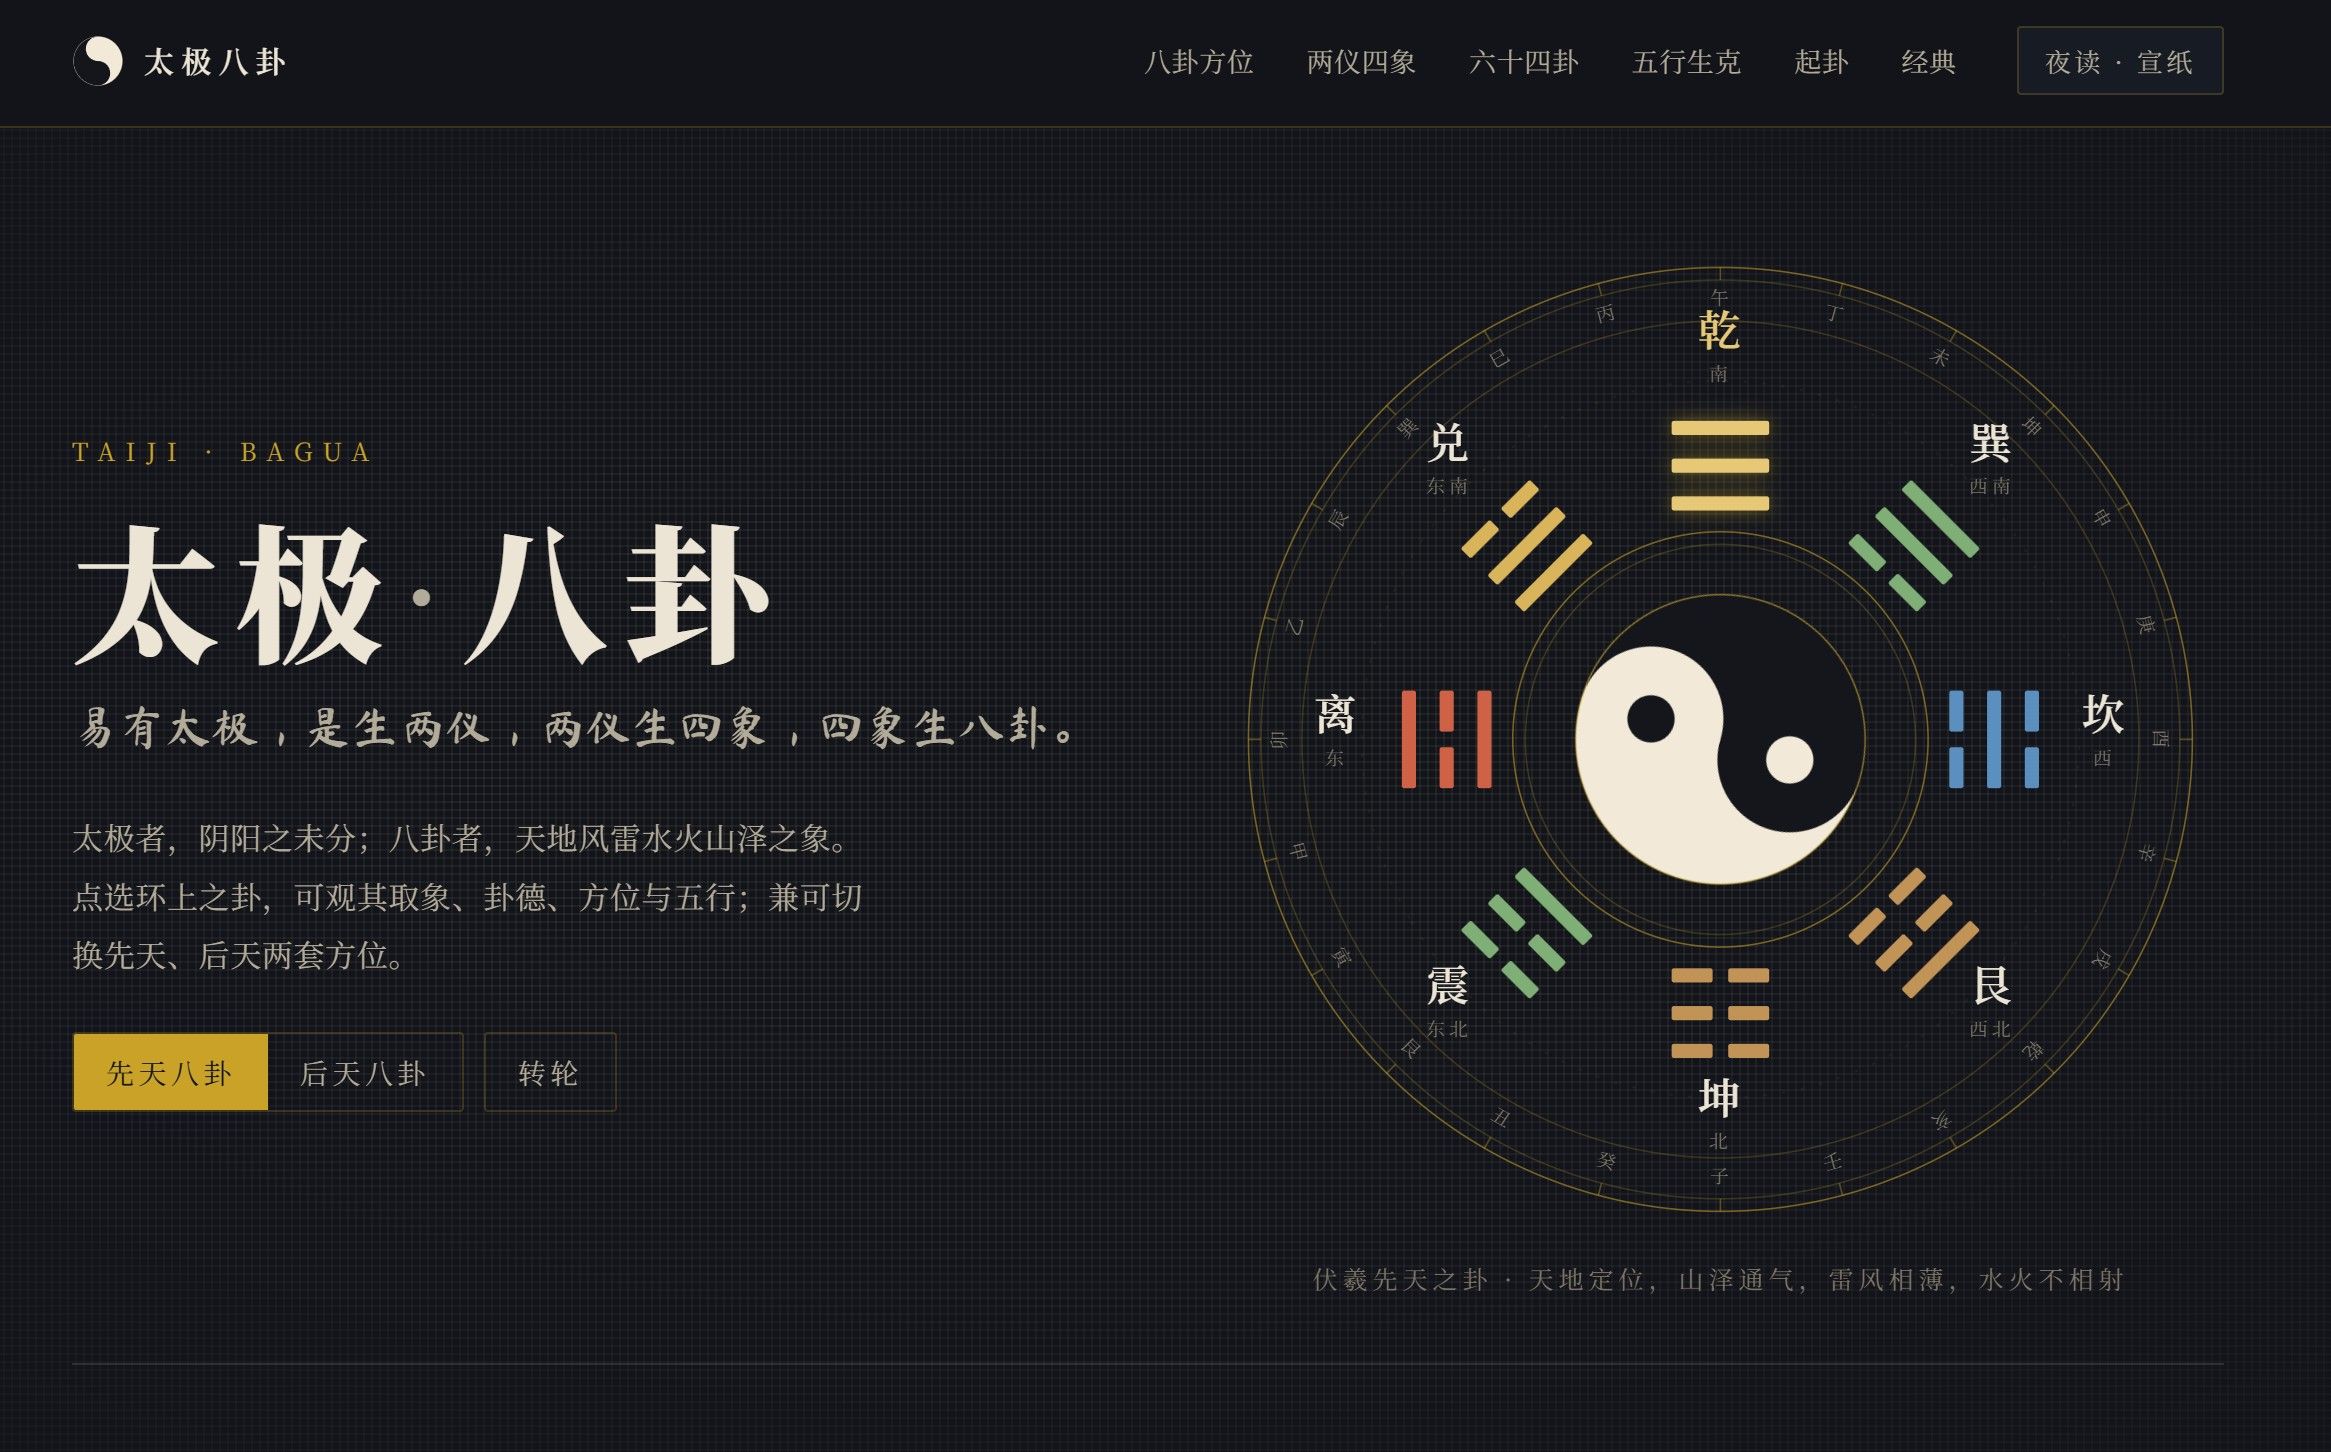
    Qwen3.8-Flash-Next_IQ3_XXS模型能力测试,一次生成。

    image.jpeg
    taiji-bagua.html


  • 【ADM显卡优化】Strata v0.1.34 Windows 系统下的AMD 显卡一键启动
    perterP perter
    LLM讨论区 strata amd

    Windows 系统下的 AMD 显卡:在 Windows 系统下,AMD 显卡的设置方式与 NVIDIA 显卡类似:双击即可START-HERE.bat。
    在没有 NVIDIA 显卡的 PC 上,Strata 会自动识别 AMD 显卡并下载现成的 AMD 引擎(strata-windows-x64-hip.zip)。该引擎包含所需的 ROCm 库,因此只需安装 AMD 驱动程序(AMD 软件:Adrenalin Edition)即可。支持的显卡:RX 7900 XT / XTX、RX 7800 XT /
    7700 XT、RX 9060 XT、RX 9070 / 9070 XT、Radeon AI PRO R9700、RX 6800 / 6900 系列。
    https://github.com/Niko1221/Strata/releases#release-v0.1.34

    安装手顺:

    • 使用 AI助手安装
      使用 AI 助手(例如 Hermess、 Deepseek harness、Claude Code、Cursor、Codex、GitHub Copilot 等)请将以下内容粘贴到其中:
    Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
    
    • 手动安装
      下载 Strata压缩包并解压缩(或git clone直接解压)。
      Windows 系统:双击运行START-HERE.bat。
      Linux系统:./setup.sh在 Strata 文件夹中运行。

  • 【ADM显卡优化】Strata v0.1.34 Windows 系统下的AMD 显卡一键启动
    perterP perter
    LLM讨论区 strata amd

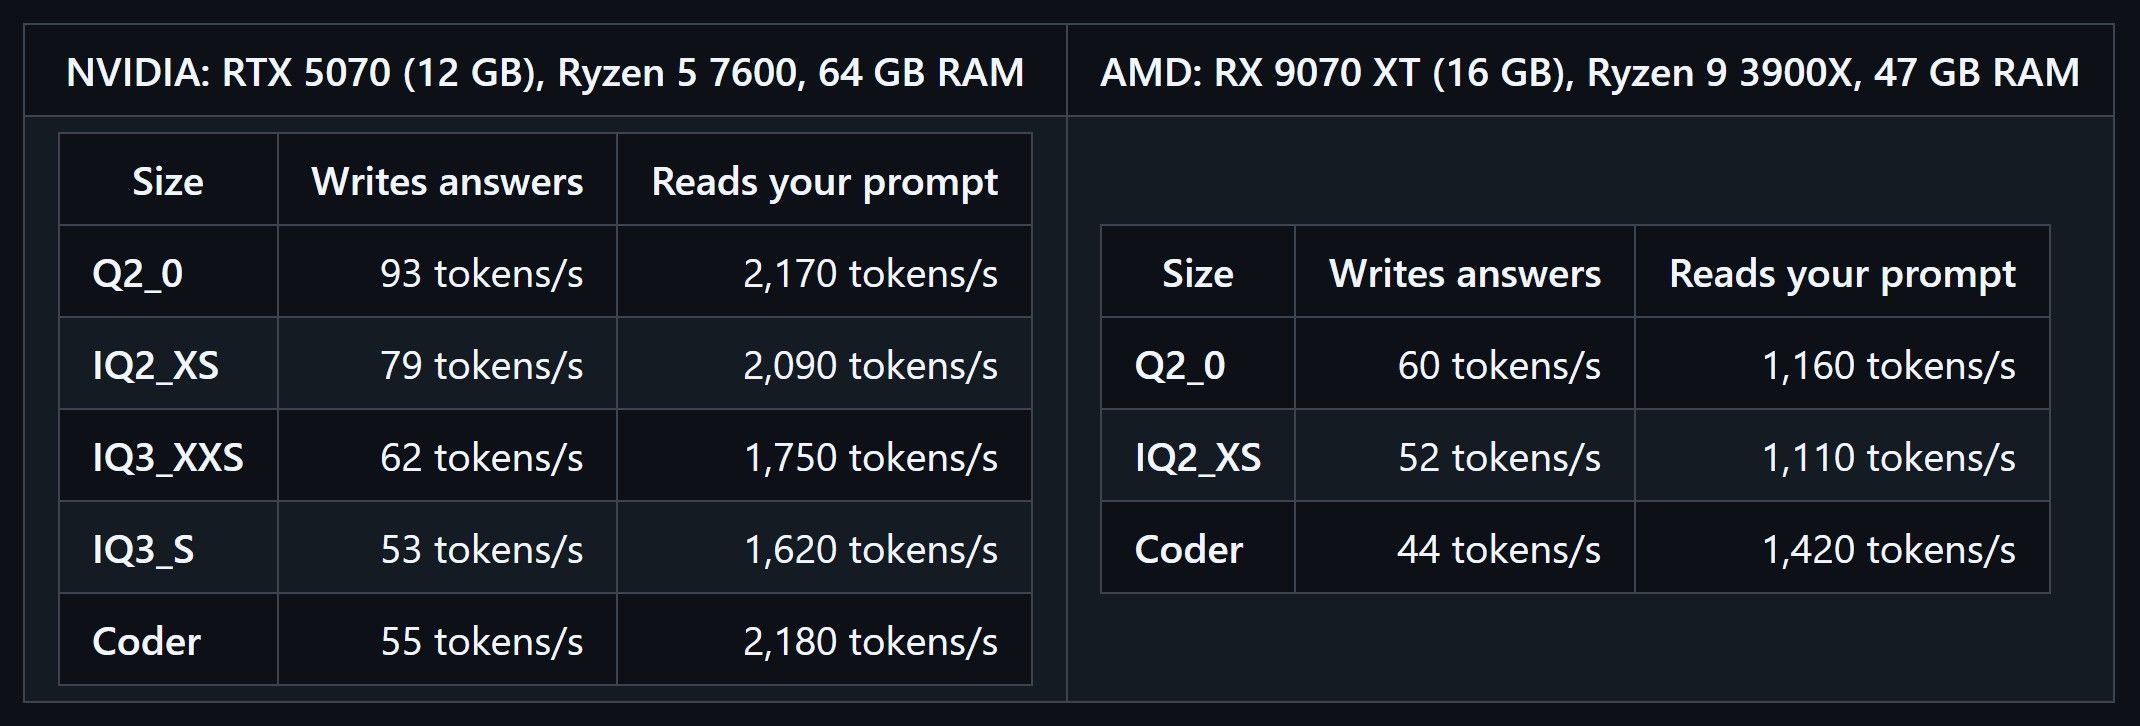
    Strata 可以在普通 PC 上运行Qwen3.8-Flash-Next——一个通常需要服务器的大型智能 AI 模型。它可以聊天、编写代码、读取图片,并与您的应用程序和编码代理协同工作,所有数据都不会离开您的 PC。
    两台普通游戏电脑性能参考。
    image.jpeg


  • 【实测】Strata 0.2.7.1 12GB NV显卡打了鸡血 RTX5070 IQ3_S平均超过110tok/s
    perterP perter
    LLM讨论区 rtx5070 strata 本地模型

    @J-Z-0
    主要变化是专家命中率提高了,以前普遍在70%左右,现在基本超过90%。Decode 从以前的50-80tok/s, 提高到90-110tok/s。


  • 晒一下X99 TF+ 2696v3 + 128G DDR3+7900xtx用strata运行IQ3_S的使用效果
    perterP perter
    LLM讨论区 x99 7900xtx strata

    @yi-song 说:

    如果两个对话同时开,速度会慢,不知道为什么。
    往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。

    你要开2个以上对话必须设定并发数,不然只能排队。
    "parallel": X (X 是并发会话数,最大 8 )
    "--conversation-cache-mib", "8192"
    这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组