

前言
一台 AMD Ryzen AI Max+ 395 迷你主机,124 GiB 统一内存,没有独立显存。同一个工作流、同一个 seed、同一批官方参考图,只换提示词首行的风格前缀,跑出 3D CGI 与传统 2D 动画两版 12 秒成片。
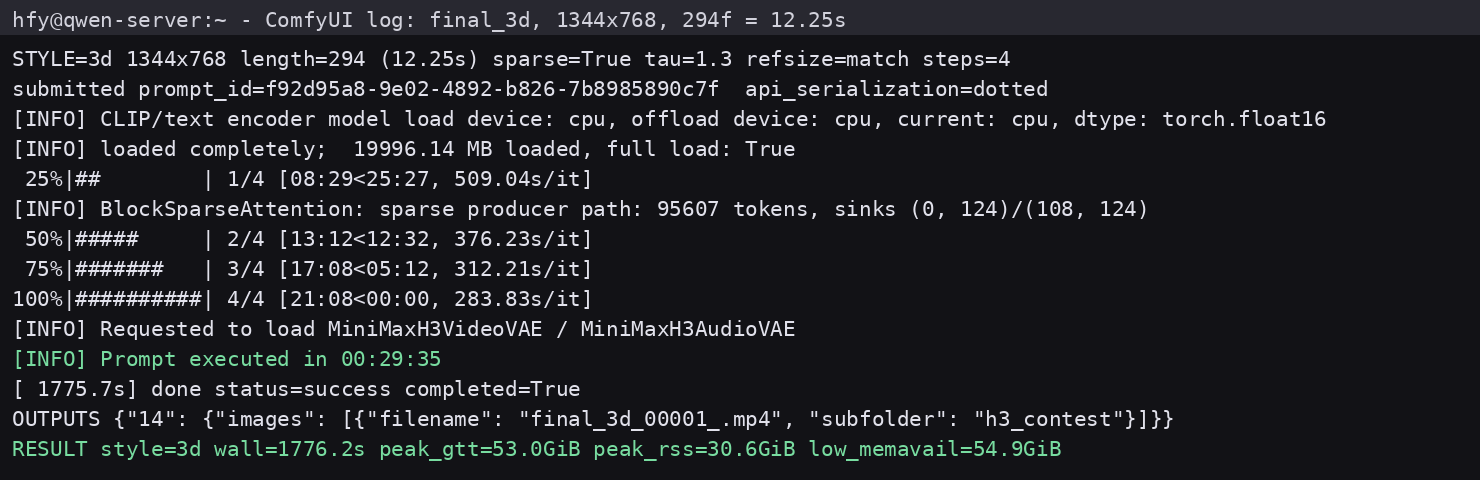
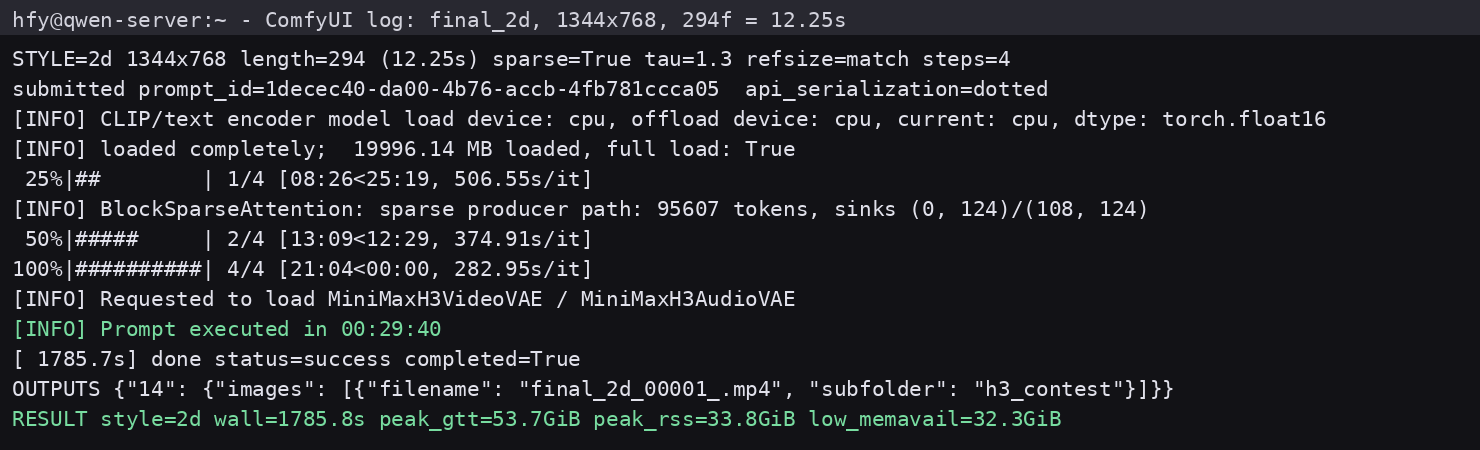
两条都没有分段、没有拼帧、没有二次插帧:294 帧一次生成,4 步蒸馏采样,一条 29 分 35 秒 / 29 分 40 秒。
- 3D CGI 成片:https://youtu.be/uGTPbueBr4Y
- 2D 传统动画成片:https://youtu.be/MD-a8tDzb9Y
硬件 / 软件环境
| 项 | 值 |
|---|---|
| 主机 | 单机,AMD Ryzen AI Max+ 395 / Radeon 8060S(gfx1151) |
| 内存 | 统一内存 124 GiB,GTT 上限 96–103 GiB |
| 系统 | Linux |
| 推理栈 | ROCm 版 PyTorch + ComfyUI 0.38.0,没有 CUDA、没有 CoreML |
| 输出 | h264 + aac 32 kHz 立体声,24 fps |
整机没有独立显存,53 GiB 的峰值全靠 GTT(系统内存划给 GPU 的窗口)撑着;启动时加 --highvram,让 19.5 GiB 的 DiT 常驻,避免每步来回搬运权重。
模型档案
minimax_h3_fl2va_pruned_int8_convrot.safetensors— 19.5 GiB(Ref2VA 基座,INT8)qwen3vl_32b_minimax_h3_int8_convrot.safetensors— 26 GiB(Qwen3-VL-32B 文本/视觉编码器,INT8)minimax_h3_video_vae_fp16.safetensors+minimax_h3_audio_vae_fp32.safetensors— 视频 / 音频 VAE- 4 步蒸馏 LoRA:
minimax_h3_fl2v_turbo_4step_v1.0_768p_comfyui_bf16.safetensors
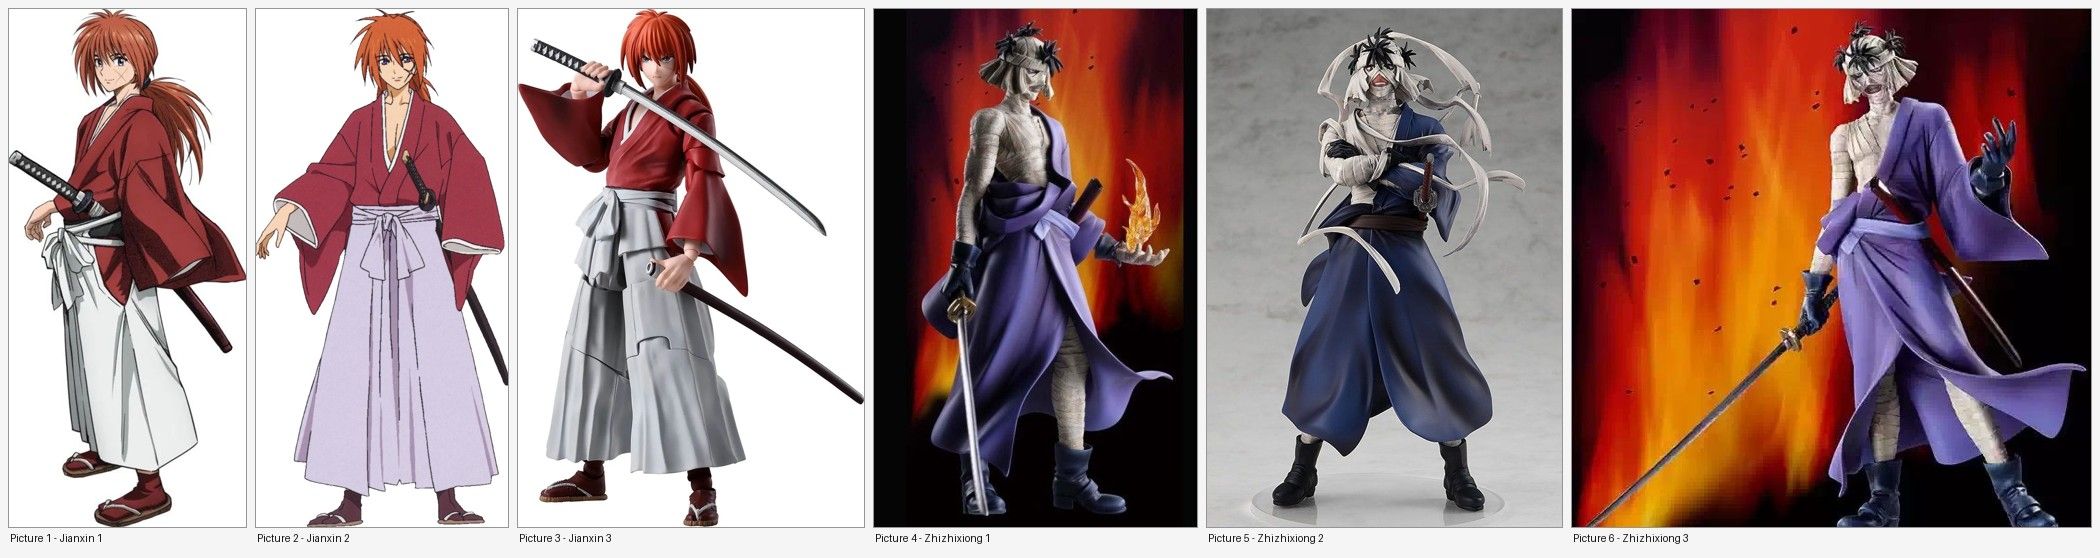
参考图走比赛题目给的 6 张(<Picture 1>–<Picture 6>),先逐张核对哈希,确认没有错位:
Picture 1–3→ 剑心(橙红刺发、左颊十字疤、红色羽织、白色袴)Picture 4–6→ 志志雄(绷带缠绕的面部与四肢、紫色长袍、尖刺发髻)
![参考图对照]
关键参数(两条片子除 Style 之外完全一致)
| 项 | 3D 版 | 2D 版 |
|---|---|---|
| 风格前缀 | (Style: 3D CGI) |
(Style: 2D traditional anime) |
| 模型 | minimax_h3_fl2va_pruned_int8_convrot |
同 |
| 文本 / 视觉编码器 | qwen3vl_32b_minimax_h3_int8_convrot |
同 |
| 分辨率 | 1344 × 768 | 同 |
| 帧数 | 294(12.25 s @ 24 fps) | 同 |
| 采样 | euler / simple,4 步(turbo LoRA) |
同 |
| cfg | 1.0 | 同 |
| Shift / Audio Shift | 12 / 3 | 同 |
| seed | 42 | 42 |
| 参考图尺寸 | ref_image_size=match |
同 |
| 稀疏注意力 | Sol-Attn,tau=1.3,start_percent=0.2 |
同 |
| 注意力后端 | CK flash attention(--use-ck-attention) |
同 |
| 音频 | 模型原生音频,aac 32 kHz 立体声 | 同 |
为什么 124 GiB 能一次跑完 294 帧
- 4 步蒸馏 LoRA:基座要 50 步,套上 turbo LoRA 后 4 步出片,这是最大单项加速,也是"一条半小时"和"一条三小时"的分界。
- Sol-Attn 稀疏注意力:
BlockSparseAttention,selection=sol-attn,tau=1.3,start_percent=0.2,min_tokens=12288,sinks 用exact_kv_and_rows。124 帧 @1344×768 实测 575.2 s → 484.3 s(1.19×),抽帧逐张比对无画质差异。 - CK flash attention:全程开启,替代默认 SDPA。
- 文本/视觉编码器固定到 CPU:gfx1151 上视觉塔的 conv 在 ROCm 会崩(见踩坑 ②),改到 CPU 只编码一次,DiT 采样仍在 GPU,GTT 反而更宽裕。
补充一句:SageAttention 也试过,更慢且画质漂移,已弃用。
带 6 张参考图后序列长度从 73k 涨到 95 607 token(6 个 ref_img 段 + text / audio / video),4 步采样共 21 分钟出头,单步 283–509 s/it。
实测耗时
| 版本 | Prompt executed | 墙钟 | 4 步采样 | 编码 + VAE + 其余 | 峰值 GTT | 主机 RSS |
|---|---|---|---|---|---|---|
| 3D | 00:29:35 |
1776.2 s | 1268 s(21:08) | 约 508 s | 53.0 GiB | 30.6 GiB |
| 2D | 00:29:40 |
1785.8 s | 1264 s(21:04) | 约 522 s | 53.7 GiB | 33.8 GiB |
两条几乎同时长:2D 版多出的 9.6 s 落在编码与 VAE 解码上,采样反而略快 4 s——风格前缀对计算量没有实质影响,只改变模型先验。
成片校验
| 项 | 3D | 2D |
|---|---|---|
| 分辨率 | 1344 × 768 | 1344 × 768 |
| 帧率 / 帧数 | 24 fps / 294 帧 | 24 fps / 294 帧 |
| 时长 | 12.25 s | 12.25 s |
| 视频编码 | h264 | h264 |
| 音频 | aac 32 kHz 立体声,非静音 | 同 |
| 文件大小 | 13.9 MB | 12.8 MB |
直接在 1344×768 采样,无缩放、无补帧、无裁切。帧数取 294 是因为 H3 要求 帧数 % 17 == 5,294 是 12 s 档最接近的合法值。
Prompt(统一英文,只切 Style)
3D 版:
(Style: 3D CGI) Masterpiece, high quality, cinematic lighting.
Subject: A fierce battle sequence featuring two characters based on the reference images—a red-clad swordsman (Jianxin) and a purple-robed warrior (Zhizhixiong).
Action: The camera begins with a dynamic low-angle tracking shot. The swordsman in red dashes forward with a long sword, leaving a glowing trail, while the warrior in purple stands firm and executes a sweeping counter-attack with a flaming effect. They clash in the center of the frame, creating a shockwave of energy and sparks. The camera rapidly orbits around them as the fiery battle intensifies, concluding with the red-clad swordsman landing gracefully while the purple warrior points his weapon forward, both facing the camera.
Environment: Dramatic background with embers floating in the air, high contrast lighting.
<Character reference: Jianxin is <Picture 1>, <Picture 2>, <Picture 3>. Zhizhixiong is <Picture 4>, <Picture 5>, <Picture 6>. Keep their faces, hairstyles and costumes exactly as shown.>
2D 版:首行换成 (Style: 2D traditional anime),其余一字不差。
<Picture N> 是 H3 原生的 1-based 引用标签,节点侧 ref_images.ref_image_0..5 按同样顺序绑定。
工作流
节点链(API 格式 JSON 见附件 workflow-3d.json / workflow-2d.json,两版只差提示词与文件名):
UNETLoader (h3_fl2va_pruned_int8_convrot)
CLIPLoader (qwen3vl_32b_minimax_h3_int8_convrot)
  ├─ LoraLoaderModelOnly (fl2v_turbo_4step_v1.0_768p, strength 1.0)
  ├─ BlockSparseAttention (Sol-Attn, tau=1.3, start_percent=0.2)
  └─ MiniMaxH3SigmaShift (video 12 / audio 3)
MiniMaxH3ReferenceToVideo (1344×768, length 294, ref_image_size=match)
  └─ KSampler (4 步, euler/simple, cfg 1.0, seed 42)
       ├─ VAEDecode (video) ─┐
       └─ VAEDecodeAudio ────┴─ CreateVideo (24 fps) → SaveVideo
6 个 LoadImage 分别接到 ref_images.ref_image_0 … ref_image_5。导入 JSON 即可还原整张节点图。
画面对照
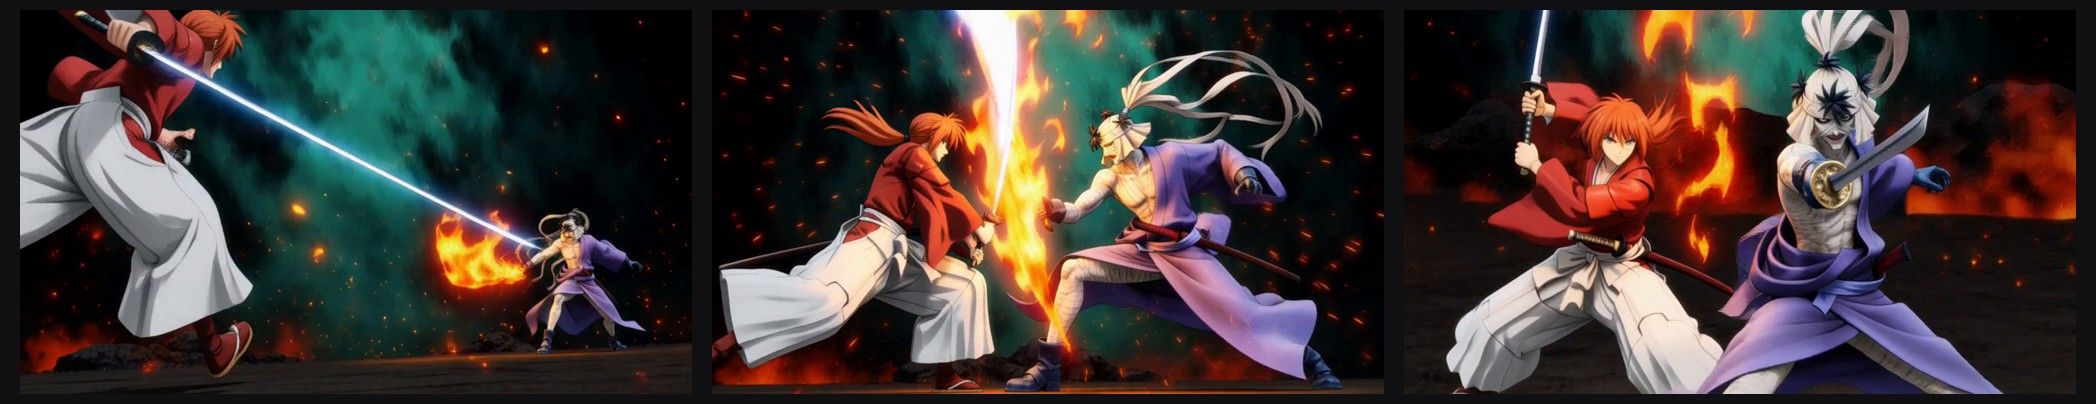
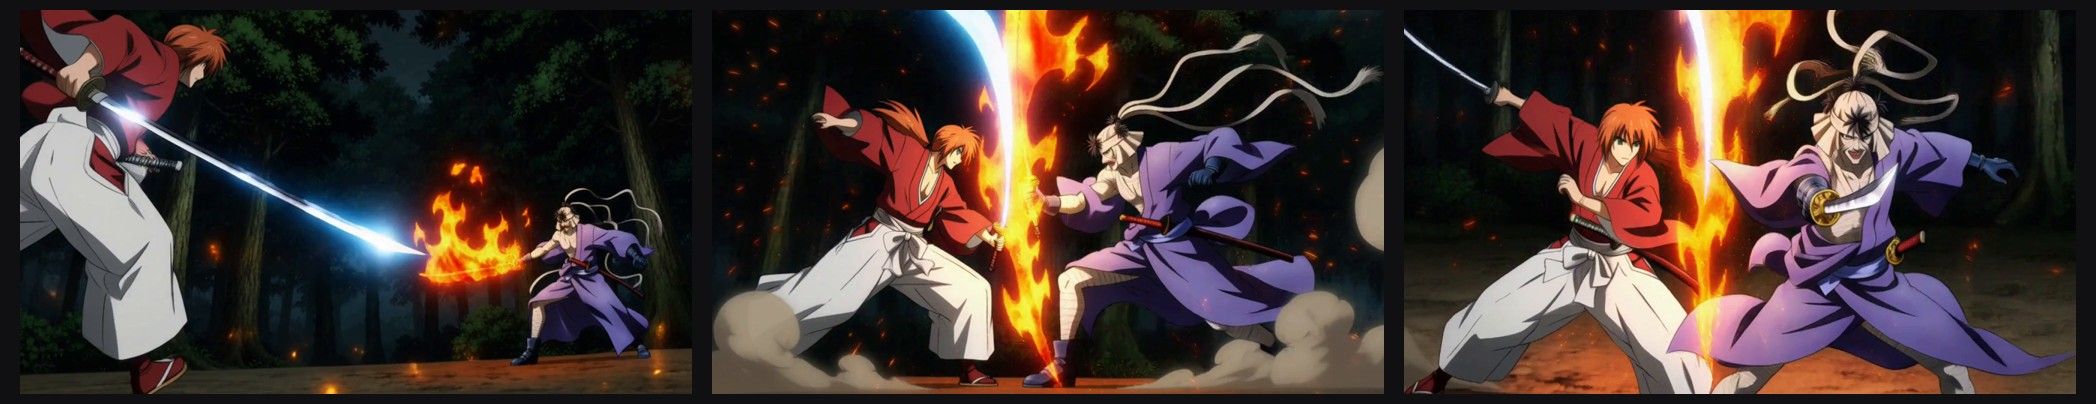
两版都完成了 prompt 要求的动作:红衣剑客突进、火焰横扫反击、中央交锋、低角度环绕运镜、结尾双方持刃相对。
- 3D 版:材质光滑、光影立体,接近三维渲染质感;火星与火焰柱构成包围式构图,轮廓光明显。
- 2D 版:线条清晰、色块分明,典型赛璐璐手绘调性;剑刃交错与橙黄光带形成对角线构图,红发剑士与缠脸紫袍对手的对决更"动画化"。
2D 版压力更大——平面化最容易把脸型和服装简化掉,实测十字疤、绷带和紫袍都在,但环境火焰的层次比 3D 版单薄,这是风格化本身的代价。
两个值得记录的坑(都很隐蔽)
① autogrow 子输入必须用点号 key,否则参考图静默失效。
MiniMaxH3ReferenceToVideo.ref_images 是 autogrow 输入,API 格式里子输入 key 必须是 ref_images.ref_image_0 这种点号形式。一开始写成嵌套对象 {"ref_images": {"ref_image_0": ...}},执行器直接丢弃、ref_images=None,不报错也不告警,出片是"通用仙侠"形象。对照组实验里"有参考图"和"完全没有参考图"两版视频逐位相同(meanabsdiff = 0.000),才确认参考图从未生效。
② gfx1151 上视觉编码器 conv 必崩,把编码器放 CPU 解决。
接线修好后,Qwen3VL 视觉塔的 patch-embed conv 在 ROCm 上稳定崩溃:先是 tpp.c:86 (__pthread_tpp_change_priority) glibc 断言 abort,限制 OMP_NUM_THREADS 后变成 segfault,栈顶固定在 comfy/text_encoders/qwen3vl.py preprocess_embed → qwen35.py:472。与图片张数无关(1 张也崩)。最终把文本/视觉编码器固定在 CPU(text_encoder_device() 加环境变量开关,H3_TE_CPU=1),只编码一次,DiT 采样仍在 GPU,问题消失。
复现
同环境(gfx1151 + ROCm PyTorch + ComfyUI 0.38.0 + 上述四个权重)用同一 prompt、同一 seed、同一工作流重跑即可复现:seed 42,4 步,294 帧。
需要留意的三点:
- 内存下限是刚需:权重 19.5 + 26 GiB,加 95 607 token 的 4 步采样,峰值 GTT 53 GiB。
- 4 步 turbo LoRA 是 768p 档训练的,再往上堆分辨率采样时间会非线性上升(1280×768 单步 395–577 s),交互可用的上限就是 832×480–1344×768。
- 音频是模型原生输出,不要额外混音;
CreateVideo里 24 fps 与 294 帧要对齐,否则时长会漂。
附件
-
workflow-3d.json/workflow-2d.json:完整 API 工作流workflow-3d.json
workflow-2d.json -
log-3d.png/log-2d.png:完整运行日志截图(含 4 步进度条与Prompt executedTotal Time)
-
frames-3d.jpg/frames-2d.jpg:关键帧(0 s / 6.7 s / 10 s)
参考图版权归原作者,本贴仅用于比赛展示。