@perter 沒有96gb,試不了 不過試過iq4_s,prefill和decode大幅一降,prefill 4xx t/s,decode 20-30 t/s
昨天更新strata到能並發的版本,現在上生產的iq3_s,竟然能開到384k ctx window + 2並發,prefill能維持在11xx t/s,decode 60-70t/s (thinking low),真不可思議

@perter 沒有96gb,試不了不過試過iq4_s,prefill和decode大幅一降,prefill 4xx t/s,decode 20-30 t/s
昨天更新strata到能並發的版本,現在上生產的iq3_s,竟然能開到384k ctx window + 2並發,prefill能維持在11xx t/s,decode 60-70t/s (thinking low),真不可思議
可以分享一下怎樣做嗎?我周未有空也可以試試
先交代:本帖所有速度数字均为 no thinking(不思考模式)(请求带
chat_template_kwargs: {"enable_thinking": false})。官方docs/DETAILS.md写明未设定时模型默认 high,所以本帖数字与官方速度表、与论坛里各帖的数字不是同一把尺,对比前请先钉死 thinking 档位。唯一例外:文末 GSM8K 吞吐参考(thinking on),只作工作量对照。
| 项 | 值 |
|---|---|
| GPU | AMD Radeon PRO W7800 48GB(gfx1100 / RDNA3 / wave32) |
| CPU | Ryzen 5 7500F(6 核,AVX-512 + VNNI) |
| 内存 | 30GB DDR5-6000 双通道 |
| 系统 | Linux,ROCm 7.2.4,hipBLASLt 1.2.2(100202),PCIe Gen4 x16 |
| 引擎 | 本地 HIP 编译(gfx1100);生产二进制 sha256 b3bcb0f5…(0.1.34 build);此前 0.1.27/0.1.29 做过完整对照 |
| 模型 | ISTA-DASLab IQ3_XXS(两 shard,HF revision ed59f92…)+ mmproj BF16(vision 走本地 HIP 版) |
引擎参数(生产现值,09-30 起未变):
--pack packs/iq3_xxs --native …-00001.gguf --ple-gguf …-00002.gguf
--mmap-experts --expert-profile data/expert-profile.bin --expert-cache auto
--prefill auto --spec 3 --spec-min-p 0.7 --mtp mtp/rt
--max-context 262144 --kv k8v4 --pool-workers 5 --pcie-frac 0
--vram-reserve-mib 2048 --adapt-every 0 --vision
环境变量:STRATA_PREFILL_MMQ=1、STRATA_PREFILL_RING=96、STRATA_IO_THREADS=32、STRATA_HIPBLASLT_TUNING=tools/hip/gfx1100-hipblaslt-100202.txt(自校准 26 行)。
官方 IQ3_XXS 参考表(RTX 5070 12GB + 64GB RAM)建立在「专家层要溢出去 RAM/SSD」的前提上。本机 48GB VRAM 下 --expert-cache auto 自动吃到 24,576 slots / 39.97 GiB、decode 命中率 100% —— 专家从不离开 VRAM。官方从未测过这个区间。
生产实际负载(0.1.34,server log 机械抽取,n=573 臂):
真实交互式对话负载,no thinking,context 累积到 80–120K tokens:
| 指标 | 实测 |
|---|---|
| decode @ 80–120K ctx | 均值 76.5 tok/s(min 45.3 / max 100.7) |
| expert cache 命中率 | 93.1–97.0% |
| draft 接受率 | 0.76–0.94(例 320/336、671/793) |
| 同 log fresh prefill(18–20K prompt,0 reused) | 1,196–1,231 tok/s |
| 同 log fresh prefill(160K prompt) | 1,043.8 tok/s |
100K 上下文的 decode(76.5)比官方 IQ3_XXS 4K 栏参考值(61.6)高约 24%。 注意:本机没跑完 STRATA_HIP_ROUTER_OLD=1 开关对照(中途被中止),所以这是观察性证据、不是受控 A/B —— 但它指向 0.1.31–0.1.34 的 AMD 线增益(#262 intrinsics、0.1.32 hip_router_fast)对 gfx1100 同样有效,不只是 RDNA4。
另一个值得注意的现象:本机 4K→100K 没有 decode 断崖(55→76 反而更高,因为长臂 draft 接受率更高:0.85–0.94 vs bench 期间的 0.63–0.76)。论坛 7900 XTX 帖(24GB)在 32K 处断崖,归因于 MTP draft window 默认 32K。本机 --kv k8v4 --spec 3 配置下未见断崖 —— 有维护者能确认 0.1.34 的 MTP draft window 默认值、以及 k8v4 会否改变它吗?
4 fresh prompt(140/280/140/280 rules)+ 4 follow-up、128 max_tokens、temp 0、seed 42、--prefill auto --kv int8 --mtp mtp/rt --expert-cache auto:
| kind | prompt tokens | fresh | prefill t/s | decode t/s |
|---|---|---|---|---|
| fresh | 4,210 | 4,210 | 1,085.2 | 55.2 |
| fresh | 8,830 | 8,830 | 1,198.0 | 54.7 |
| fresh | 4,210 | 4,210 | 1,177.1 | 56.0 |
| fresh | 8,830 | 8,830 | 1,176.9 | 56.4 |
| follow-up 均值 | — | 248 | 343.8 | 51.9 |
对官方 IQ3_XXS(RTX 5070):prefill 4K 108–117%、decode 4K 90%。
--kv k8v4)--kv int8)→ 256K(k8v4):decode 55.0 → 56.6(+2.9%)、prefill 1,151.4 → 1,204.4(+4.6%)、常驻专家仅 −3.1%--kv-resident)1. hipBLASLt 表版本闸静默吃掉 75% prefill。 仓库自带表只有 100100/100200;ROCm 7.2.4 的 hipBLASLt 是 1.2.2(100202)。版本不符只印一行 stderr(version mismatch: file=100200 runtime=100202; using hipBLASEx)就静默退回 plain hipBLAS。修复前后:622 → 1,088 tok/s。论坛 7900 XTX 帖(ROCm 7.2.3)独立撞中同一版本;GitHub PR #170 交过 100202 表,但 0.1.33 的 tools/hip/ 里未见。自校准命令(照贴可用):
/opt/rocm-7.2.4/llvm/bin/clang++ -x hip -O2 -std=c++20 --offload-arch=gfx1100 \
  --rocm-path=/opt/rocm-7.2.4 -I/opt/rocm-7.2.4/include tools/hip/tune_hipblaslt.cpp \
  -L/opt/rocm-7.2.4/lib -lhipblaslt -lhipblas -lamdhip64 \
  -Wl,-rpath,/opt/rocm-7.2.4/lib -o /tmp/tune_hipblaslt
ARGS=$(awk 'NR>2 {printf "--case %s,%s,%s,%s,%s ", $1,$5,$2,$3,$4}' tools/hip/gfx1100-hipblaslt-100200.txt)
/tmp/tune_hipblaslt --workspace-mib 32 $ARGS --tuning-out tools/hip/gfx1100-hipblaslt-100202.txt
2. decode 波动的真正变因是 MTP 接受率,官方文档从未说明。 同一 server、同一 session、decode expert cache hit rate: 100.0%(77,760/83,520 全中)之下:接受率 0.63→49.8 t/s、0.67→51.0、0.72→56.0、0.76→56.4。cache 已满分,唯一变因就是接受率。官方只说「2.4–3.2 tokens per pass」,未给接受率基准;本机 bench 期间实测 1.65–1.73 tokens/pass。建议官方速度表附各模型 draft 接受率,否则用家分不清 cache miss 同 drafting 波动。
3. IQ2_XS 在本机比 IQ3_XXS 慢 30% —— 与官方表方向相反。 严格交错 A/B(同机同脚本同参数、每模型 8 次、固定 prompt 措辞):decode IQ3_XXS 54.0 ± 2.5 vs IQ2_XS 41.5 ± 0.6(IQ3 快 27–36%,跨 1K/4K/16K 一致);prefill 只差 +1.7%。我们怀疑官方 IQ2_XS 数字(78.6 @4K)出自 Swift 1.5(思考更短的微调版,输出长度分布不同)——若是,表应标注模型变体,因为用原版 Flash-Next 的人得到的是相反排名。已排除 13 项(config diff、RAM 速度、CPU 指令集、cache 命中率、draft 品质、STRATA_NO_IQ4NL、STRATA_CPU_YMM、PR #241、PR #242 —— 后者差距反而扩大到 35.1%)。本机专家 100% GPU 驻留,STRATA_IQ_MT_MIN 这类 CPU 端开关解释不了。开放问题给维护者:单 token 解码路径里是什么令 IQ2_XS 在 gfx1100 变慢?
4. vision 在 gfx1100 只要 llama.cpp GGML_HIP=ON 一个 CMake flag,不是移植工程。 上游 0.1.33 仍写「no HIP encoder build yet」。本机用 cmake -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx1100 -DCMAKE_HIP_COMPILER=/opt/rocm/llvm/bin/clang++ 编 tools/vision/strata_vision.cpp(llama.cpp pin 3cf03257 已在 _deps):READY 6.0 s(CPU 版 10–30+ 分钟);每图 4,000 tokens / 5.3 s(CPU 版 480 tokens / 12 s,约 30×);峰值 VRAM +1.61 GiB(在 --vram-reserve-mib 2048 余裕内);OpenAI 端点图片问答端到端正确。值得上游正式化。
| 发现 | 数据 |
|---|---|
--expert-cache auto 不可手写 |
手写 2048:cache 5.08 GiB、prefill 2.8 t/s;auto:42.52 GiB、6.9 t/s(差 8.4 倍) |
--mtp mtp/rt 不可省 |
无 MTP:decode 18.92、接受率 0.005;有:46.43、0.731(2.45 倍) |
--spec 设计上限是 3 |
spec 3:56.2–56.7;spec 4:53.8–54.6(用 4 反而慢) |
--pool-workers 2→5 无改善 |
361.4 vs 323.1 t/s;host 串流时间 ~546 ms 恒定 ⇒ 6 核 CPU 不是 prefill 瓶颈 |
| shard 2 为四个量化共用 | IQ2_XS/IQ3_S/IQ3_XXS/Q2_0 的 shard 2 SHA256 完全相同 ⇒ 硬链接每量化省 28.8 GB |
serve.server 启动文案误导 |
固定印「loading the experts into RAM (about 47 GB)」;30GB RAM 实际走的是 --mmap-experts 路径 |
Strata Flash-Next IQ3_XXS:190/200 = 95.0%,平均输出 394.9 tokens(含 reasoning_content),聚合 50.68 t/s。只作工作量对照,不与上面 no-thinking 速度数字混比。
bench_prefill.py 规则)。 50.0(差 24%),此方法论 bug 已修。
欢迎维护者或大佬指定跟进项:本机可即刻跑 STRATA_HIP_ROUTER_OLD=1 开/关对照(4K/16K),或钉死 reasoning_effort 档位重跑官方 bench 作完全对齐。
@CHIA-AN-YANG 其實我也測出9X T/S, 不過那個數據没有用, 始終大家都是用AGENT HARNESS,我在DSH測出這個數字也非常夠用了, 我的目標是在AMD的卡上追趕NVIDIA,有60-70%的效果我個人覺得已相當不錯。
@terry 謝謝讚賞 不過,我真的不知道AI做了什麼的, 我不是程序員PROGRAMMER,數學也没學好。做1%工作就是這樣,小突破也不錯。我10天玩出一個花樣也算是為這社群做一次有1%原創性的貢獻。
我投產了,將來有機會再玩一下。謝謝你提供這個平台,祝TERRY兄和其他兄弟姐妹生活順順利利
測試平台:GIGABYTE Radeon
PRO W7800 AI TOP 48G(單卡)
gfx1100 / RDNA3 | 70 CU | ROCm 7.2.4 | Ubuntu 24.04 | Ryzen 5 7500F | 30 GB RAM
2026-09-15
本節所有數字均直接抽取自引擎日誌,並非實驗室短提示評測。
| 指標 | 值 |
|---|---|
| decode 吞吐 | 62.11 t/s |
| 樣本數 | 11(59.55 / 62.11 / 63.94 / 59.49 / 52.37 / 59.95 / 67.80 / 78.91 / 71.91 / 76.56,另有 1 個 9.35 離群值) |
| accept length | 2.87 – 3.70 |
| 同一台機器、短提示單流 | 85.05 t/s |
⇒ 兩者唯一的變數是上下文深度(full token 20,004 – 20,944)。這就是 agent 場景的真實成本。
| 指標 | 值 |
|---|---|
| decode 吞吐 | 61.5 t/s(n=23,full token 中位數 24,299) |
| p90 | 80.4 t/s |
| accept length 中位數 | 3.40 |
⇒ 與 09-14 的 62.11 t/s 一致,並無退步。(用戶主觀感受的 74 t/s 屬較短上下文。)
我們 2026-09-08 的上一份帖文(lcz.me/topic/1559)在同一張 W7800 上報告:DSH 真實 agent 工作負載單發 50.9 t/s(gen mean;median 53.9、max 79.5;KV 範圍 11–21K)。
| 2026-09-08(topic 1559) | 2026-09-15(本文) | 變化 | |
|---|---|---|---|
| DSH agent 路徑 decode(單發) | 50.9 t/s | 62.11 t/s | +22.0% |
| 上下文範圍 | 11–21K | 20,004–20,944 | 同級 |
⇒ 七日之內 +22%。而這不是單一變因的功勞 —— 期間換了模型配方(W4A16-AutoRound-GPTQ → INT4-GPTQ-v3)、加了自己寫的 INT4 lm_head shim(+19.7%)、改了兩處 kernel(合計再 +6.5%),並把整套配置重搭回同一條線上(見第二節)。
⇒ 更重要的是:前面仍有大把路未走。 上游 vLLM 已改用我們尚未採用的兩條新路線、確定性開關從未打開、kernel 內部那道 498-cycle 的串行鏈尚未拆解。詳見第六節。
| 項 | 值 |
|---|---|
| decode 中位數(投產時) | 57–60 t/s |
| KV cache 命中率 | 65 – 77% |
| 曾經承擔 | 11 個 subagent 並行審計 |
| split-K 512 與 1024 之 A/B | 70 對 61 t/s |
這些數字在任何 gfx1100 單卡用戶的環境中皆可復現。
我們只有一張 GIGABYTE Radeon PRO W7800 AI TOP 48G(gfx1100、70 CU)。
單卡這一事實至關重要,因為它決定了我們所有結論的邊界:
| 我們 | 論壇其他前輩 | |
|---|---|---|
| 卡 | W7800 48G ×1(70 CU) | 7900 XTX ×2(各 96 CU)/4090 48G 改裝版 ×1/4080S ×2 |
| 總 VRAM | 48 GB | 48 GB(雙 7900XTX 24+24)/48 GB |
| TP | 1 | 2(雙卡) |
| 卡片架構 | RDNA3 gfx1100 | 7900XTX 同為 gfx1100 但 96 CU;4090 為 NVIDIA |
⇒ 本文出現的任何數字,其前提皆為「單卡、70 CU、gfx1100」。
W7900(96 CU)、7900 XTX(96 CU)與 W7800(70 CU)雖然同屬 gfx1100,但 CU 數不同,吞吐量不可直接套用。 我們先前見到有材料把 CU 數寫成 96 —— 那是 W7900 的數字,我們這張是 70(amd-smi 實測)。
我們的目標很簡單:把 gfx1100 用戶所能運用的軟件算力,逐分逐毫地榨取出來,而且每一步都可復現。
2026-09-05 我們試用 SGLang 官方版,結論為「已列名,但尚未就緒」(FP8 只有 0.62 t/s)。正想放棄的時候,Terry 在我們的報告下面留下一句:
「你可以嘗試下 SGLang,論壇有帖子,體驗會好很多」
一句提示,我們投入了十天。沿著他指出的方向,我們找到論壇前人已經鋪好的路(見文末致謝),最後以社群的 gfx1100-support fork 完成三引擎完整對比,才定下生產配置。
⇒ 這是本文最想說明的一件事:這條路是社群鋪出來的,我們只是接續前行。
我們做過許多無效的優化,代價最高的一課是:有一整輪優化耗在一個穩態佔比 0% 的 kernel 上 —— 那個檔案佔 46% 的代碼量,卻只佔 4.59% 的 GPU 時間;真正的熱核佔 61.14%。
質量集中處 ≠ 能量集中處。
這句話後來成為我們所有優化的第一道關卡:動手之前先量能量分佈。
AMD 在 HuggingFace 放出 amd/Qwen3.8-27B-Quark-AWQ-INT4-W4A16,但它在 RDNA3 上無法運行 —— SGLang 的 Quark 模組只實作了三種 scheme,純 W4A16 沒有;quark/weights.py 甚至直接註明「Scheme didn't allocate the parameter (e.g. W4A16)」。
我們撰寫了轉換器把它接入。這是我們第一件原創作品(詳見第三節)。
接通 AMD 原版模型之後,我們面對第二個問題:模型能跑,但速度不夠。
我們寫了一個 Python shim(rdna_shim/rdna_lmhead_int8.py),經 PYTHONPATH 注入,在 vendored 樹只加三行攔截 _compute_lm_head。它不改 kernel,而是換路線:lm_head 是 248320×5120 的 bf16 矩陣(2.543 GB),每步被讀四次(verify 一次 M=4、draft 三次 M=1),合共約 13.9 ms/步、佔步時約 20%;M=1 時完全是記憶體綁死,位元寬直接決定成本。改用 INT4 之後每次只讀 0.661 GB。
| 階段 | 引擎吞吐(5K 上下文、temp 0) | 相對基準 |
|---|---|---|
| bf16 lm_head(原狀) | 57.12 t/s | — |
| int8 lm_head(中間步驟) | 60.43 t/s | +5.8% |
| int4 lm_head(最終) | 68.38 t/s | +19.7% |
輸出 MD5 三者完全相同,accept length 4.0 不變,U+FFFD 為 0。 兩次獨立量測得 68.41 / 68.38。
在此之上,我們又改了 kernel 本體兩處:WMMA 門檻由 M≥16 下移至 M≥9 && N≥2048(M=9 GEMM 246.7 → 185.9 µs,−24.6%),以及 B2 編譯期模板化(M=4 −9.3%、M=5 −8.7%、M=8 −14.2%)。端到端 68.38 → 72.84 t/s,累計對 bf16 基準 +27.5%,輸出與基準逐字節相同。
速度追回來之後,我們再把底盤逐件接回: MTP-3 投機解碼(09-11 由 DFLASH 折返後重新接上)、CUDA graph、HiCache(命中率 65% → 77%,09-14 重新上線),最後是 09-14 傍晚的 DFLASH8 + HiCache8(單流 92.57 t/s)。
⇒ 這一段的代價,同樣如實記錄:
| 時間 | 失敗與代價 |
|---|---|
| 09-11 13:20 | 投機門檻下移 M≥2 雖然修復了確定性,代價是吞吐 −15.2%(88.9 t/s)。交易為負,已放棄並還原。 |
| 09-11 13:20 | draft 量化 v3:體積由 3.85 GB 降到 1.743 GB,但 accept rate 掉到 0.00、吞吐 15.7 t/s(−85%) |
| 09-11 14:14 | 事故:INT4 一度被洗成 W4A16 —— exp_config.py 的 REF 寫死了 W4A16 配方,13:31 起所有受控測試全部跑錯模型 |
| 09-11 22:36 | 差一點誤報成功:見到 HYBRID 啟動與 84.9 t/s,真相是 HYBRID 失敗後系統 fallback 到 DFLASH;靠 /proc/<pid>/cmdline 硬驗證才攔截下來 |
| 09-11 22:36 | 字串拼接改配置令反斜線續行斷裂,生產停擺 3.5 分鐘 |
| 09-13 | P29–P52 工藝戰役:18 個假說全部否證(全部落在 ±0~2%),隨後證明整場戰役打在那個只佔 4.59% GPU 時間的 kernel 上 |
⇒ 這就是「質量集中處 ≠ 能量集中處」的代價,也是我們把它列為第一道關卡的原因。
接入之後,我們量到自身的服務品質低於 AMD 公布的數字(PPL 高一成、GSM8K 低七分)。我們排除了六個嫌疑,但機制仍未定位 —— 此點我們在第四節誠實交代。
原意:讓 gfx1100 用戶不必等待 SGLang 補上 W4A16 scheme,當日即可運行 AMD 原版模型。
實質作用:把 Quark 的 N-packed [K, N/8] 佈局重新打包成 GPTQ 的 K-packed [K/8, N],權重未改動任何一個位元。
技術核心(亦是我們耗時最久之處):Quark 在 pack_method="reorder" 之下,每個 int32 內的 8 個 4-bit 值並非順序排列,而是按 order_map = [0,2,4,6,1,3,5,7] 重排。忽略這一步,整個模型將輸出亂碼。
我們當初正是遺漏了這一步,以數值掃描猜測數小時之久;最終閱讀官方 quark/torch/utils/pack.py 之後即得解。
⇒ 教訓:凡涉及外部格式,先讀官方實作,不可依靠試探。此後成為我們的鐵律。
無損驗證(三條獨立證據):
| 檢驗 | 結果 |
|---|---|
| 逐元素反量化比對(5 層,含 N=48 的極瘦層) | max 絕對差 = 0.000000e+00 |
| 全層覆蓋 | 496 個量化層 + 703 個普通層 |
對 BF16 原模型的忠實度(96 個 in_proj) |
cos 最小 0.9871、中位數 0.9905 |
Commit:0d2e013 perf(rdna3-wmma): opt-in N-aware k_split for small-M; -7.9% on M=16 verify GEMM across all 6 production shapes, fp64-identical accuracy; default path unchanged
原意:上游的 compute_wmma_k_split() 只看 K、不看 N,因此在 K ∈ {5120, 6144, 17408} 時一律返回 4。但在我們的生產形狀中,N=5120 佔權重的 23.6%,在 k=4 之下嚴重佔用不足。
實質作用:改為 N-aware 規則 —— 選取「令 block 數達到約 5120 的最小 k」。在我們六個生產形狀上逐一掃描後:
六個生產形狀的逐 k 掃描(單位 ms,粗體為實測最優)
規則在 6 個形狀中有 5 個命中實測最優;唯一例外為 17408×5120,差 0.77%(按真實層混合加權後更小)。
最重要的一點:準確度在 fp64 之下逐位元相同,且預設路徑完全不變(須開啟 SGL_WMMA_KSPLIT_AUTO=1 方生效)。我們其後實測關閉它:PPL 9.7296 對開啟時 9.7297,差 −0.00% ⇒ 這個效能補丁在數值上是忠實的。
| Commit | 原意 | 實質作用 |
|---|---|---|
c2d509e |
小 M WMMA 門檻下移至 M>=9 | 覆蓋 decode verify step(生產實測 80% 為 M=4,其餘為 M=8) |
9af1d8d |
GPTQ kernel 編譯期模板化 | Σa 預算與 z 修正改為每 group 一次,減少重複計算 |
b10a8ab |
正確性修正 | 把不規則(NGRAM)樹排除於 mask-less unified verify kernel 之外 |
01d62d6 |
生產樹入版控 | GPTQ M_COUNT 5/6/7、lm_head 低位寬 |
1f1ba80 |
WMMA M=16 瓶頸研究 | env-gated 量測變體,預設路徑不變 |
23dd307 |
建置整潔 | 把量測變體排除於生產 build 之外 |
6c5409c |
建置整潔 | 停止追蹤 21 個由 hipify 產生的 .hip 檔 |
005ad71 |
修錯 | CU 數 96 → 70(96 為 W7900;本卡為 70) |
f736a74 |
首次入版控 | 2026-09-08/09 的 gfx1100 生產補丁 |
另外兩項不在 git 之內、但同樣屬於我們原創的:
prod/rdna_shim/rdna_lmhead_int8.py —— INT4 LM head,只在小 batch 觸發| 指標 | 我們(單卡 W7800) | AMD 官方卡 | 差 |
|---|---|---|---|
| Wikitext word_perplexity | 9.7297 | 8.8250 | +10.25% |
| GSM8K flexible(兩次全量平均) | 83.70% | 91.51% | −7.81 pt |
| GSM8K strict(同上) | 84.12% | 90.37% | −6.25 pt |
| # | 嫌疑 | 排除方法 |
|---|---|---|
| 1 | 權重量化 | 逐元素反量化比對 max 絕對差 = 0(5 層)+ 全層 496/496 + 對 BF16 源 cos≥0.9871 |
| 2 | LM head | PPL 以 echo 取 prefill logprobs,而 INT4 LM head 只在 M ≤ 8 觸發(日誌:i4=1418 / miss=182);換 BF16 後 9.7297 → 9.7297 完全不變 |
| 3 | 量測儀器 | echo 路徑與原生 /generate 對同 6 篇文件得位元相同(差 0.000%);token-PPL 5.52 × 1.32 = word-PPL 9.46 三數自洽 |
| 4 | 資料集 | wiki-2 與 wiki-103 的 test split sha 相同(62/62) |
| 5 | prompt 截斷 | 超長僅 0.61%、缺答案格式僅 0.30% |
| 6 | 我們自己的 K-split 優化 | 關掉 → 9.7296(−0.00%) |
⇒ 差距真實存在,機制我們尚未定位。我們不作猜測。
上表兩次全量評測皆用 greedy(do_sample=False),理應完全一致,實際卻相差 0.76 個百分點。
於是我們在同一部伺服器、同一配置之下,同樣 150 題連續執行兩次:
| 指標 | 結果 |
|---|---|
| 輸出完全相同 | 107 / 150(71.3%) |
| 對錯翻轉 | 3 題 |
| 兩次分數 | 85.33% 對 84.67% |
⇒ 在我們的技術棧上,greedy 解碼是非確定的。
⇒ 因此我們不報告單一數字,而報告兩次全量評測的平均值,並標明自身噪音約 ±1 pt。
這也是本文的一項關鍵提醒:任何「更動一個參數即可令分數上升 0.5 pt」的結論,在此噪音水平之下皆不可信。
我們懷疑來源是 split-K 的 CAS 原子累加(加法次序不固定),或 LM head 低位寬路徑的 M ≤ 8 閘(精度隨 batch 大小跳變)。兩者皆未驗證。
① lm-eval 的 max_length 陷阱。 API 後端有 max_context_len = max_length − max_gen_toks。用預設 max_length=2048 配 AMD 的 max_gen_toks=8192 ⇒ −6144 ⇒ prompt 截成空 ⇒ HTTP 400(我們觸發了 2645 次)。AMD 官方指令寫明 max_length=16384。
② LM head 的 M 閘。 M ≤ 8 走 INT4、M > 8 走 BF16 ⇒ 同一 prompt 的 logits 會因並發批次的組成而異,屬可重現性風險。
③ page-size 與 hybrid mamba。 論壇實測:page-size 64 配 hybrid mamba 加 HiCache 本身即會段錯誤,必須 page-size 1(我們恰好為 1)。
④ --gpureset 不可使用。 對 gfx1100 會鎖住 PCIe root port,須冷開機(社群警告)。
① 先對證,後落手。 凡涉及外部格式、協議、第三方語義,第一步必須尋求對證 —— 而且優先閱讀官方源碼,不讀文檔描述。
② 驗證方法本身要先驗證。 必須證明它能夠識別已知的壞輸入,而非僅止於「能夠運行」。(我們的一個精度閘門曾經對 NaN、全零、非有限輸出三個通道全部靜默判 PASS。)
③ 對證對象要驗身分。 凡對證,必印被對證對象的 sha256。修改時間、路徑、檔名,一概不可信。
④ 硬件規格只准實測。 同一張卡在四份材料中出現過 96 / 70 / 40 / 35 四個 CU 數,僅實測的 70 正確。
⑤ 質量集中處 ≠ 能量集中處。 動手之前先量能量分佈。
⑥ 配件無辜,組合有罪。 我們曾經把 HiCache 當作段錯誤主因;後來發現只有 DFLASH 與 HiCache 的組合才會出事,HiCache 本身無辜。
⑦ 一個中心為忠,兩個中心為患。 量度之前先釐清有幾個中心;並行量測會互相污染,任何時候只准一個。
① 量測上游 vLLM 的新路線。 上游已改為 M≤5 使用專用 INT4 skinny GEMM(wvSplitK_int4_g,wave 層分工 + DPP 歸約、無原子競爭)、M>5 使用 Triton。我們的 decode 有 80% 屬 M=4,恰好落在第一段。A/B 工具已編譯完成,僅待執行。
② 檢驗非確定性的機制。 同一個 A/B 實驗同時可驗:CAS 原子 對 DPP 歸約。
③ 開啟 --enable-deterministic-inference。 我們生產環境中此開關一直為 0。其說明為「batch invariant ops」,恰對應我們「精度隨 batch 跳變」的假設。
④ 將 kernel 層開源 ——  已於 2026-09-15 完成。 以 patch series 形態發佈 19 個 patch(43 檔、+4,097 / −14,870 行),基底
StevenChenSE/sglang 之 gfx1100-support @ 1442c18。由 GitHub 下載後套用到乾淨檢出,可逐位元重現我們的生產樹。 https://github.com/lawsirlawsir-png/rdna3-quark-w4a16
⑤ 繼續追查那個 +10.25% / −7.81 pt 的差距。 六個嫌疑已排除,機制尚未定位。
我們所做的那 1% 之所以能夠成立,是因為前面已經有人把路鋪好。逐項歸位如下:
StevenChenSE/sglang 的 gfx1100-support 分支。我們整條生產線建在這上面。q_gemm_rdna3_wmma.cu,檔案頭即為 Copyright contributors to the vLLM project)pack.py 的打包語義(沒有它,我們的轉換器無從對證)--mamba-full-memory-ratio 1.0、--mamba-scheduler-strategy extra_buffer、--mamba-track-interval 2048、page-size 1若有遺漏,敬請在下方指出 —— 這是我們的疏失,絕非本意。
本節供機器讀取,人類讀者可直接略過。
啟動腳本 sha256 : 7f52d3b0bfe876ad34d5c55c25e5e9a42b83afbae01b8a85891eac905f27a114

生產 .so sha256 : 7847e12eaf3d8b104f0227ab779dcfdef4248e843668d461334522598f2f5625
                  (29,823,720 bytes = BLOCK_KN_SIZE 512)
--model-path .../Qwen3.8-27B-INT4-GPTQ-v3
--tp-size 1 --quantization gptq --dtype bfloat16 --mamba-ssm-dtype bfloat16
--kv-cache-dtype bf16 --attention-backend triton
--chunked-prefill-size 8192 --context-length 131072 --mem-fraction-static 0.88
--speculative-algorithm NEXTN    (內部解析為 EAGLE/MTP-3:steps 3 / topk 1 / draft 4)
--cuda-graph-max-bs 32 --sleep-on-idle
--max-running-requests 4 --max-queued-requests 6
--enable-hierarchical-cache --hicache-ratio 1.0 --hicache-size 8
--hicache-write-policy write_through --hicache-io-backend kernel
--hicache-mem-layout page_first --enable-cache-report
--default-chat-template-kwargs {"enable_thinking": false}
(無 --page-size ⇒ page_size = 1)
SGL_RDNA_CUSTOM_AR=0  SGL_RDNA_NO_FUSED=1  SGL_RDNA_GEMMA_TRITON=1
SGL_RDNA_VLLM_VERIFY=1  SGL_RDNA_LMHEAD_INT4=1  SGL_RDNA_LMHEAD_INT4_GS=128
SGL_RDNA_LMHEAD_INT8=0  SGL_WMMA_KSPLIT_AUTO=1
SGL_DTYPE=bfloat16  SGLANG_PHASE_TIMING=1  SGLANG_ENABLE_HEALTH_ENDPOINT_GENERATION=0
SGLANG_ENABLE_DETERMINISTIC_INFERENCE=0
SGLANG_MAMBA_SSM_DTYPE=bfloat16  SGLANG_CPROFILE_SPEC=0
TVM_FFI_DISABLE_TORCH_C_DLPACK=1
PYTHONPATH=.../prod/rdna_shim
| 量 | 值 | 儀器 |
|---|---|---|
| decode(DSH agent 路徑 ~20K ctx) | 62.11 t/s | 引擎 log gen throughput,running-req=1,n=11 |
| decode(短提示單流) | 85.05 t/s | 同上 |
| 每步固定開銷(gap > 20 µs) | 2.4% | 09-11 decode 段 817.12 ms 逐段 |
| GPU busy(滿載) | 89.2 – 94% | 同兩次 |
| GPU 滿載溫度 EDGE / HOTSPOT / MEM | 79 / 99 / 94 °C | amd-smi(門檻 100/110/105) |
| 節流 | 無(GFX CLK 2148 = MAX_CLK) | amd-smi metric |
| 每 token 有效權重頻寬 | ~385 GB/s(74 t/s × 19 GB ÷ accept 3.65) | 推導 |
反匯編自生產 .so 的 .hip_fatbin 內嵌 ELF,目標 gemm_q4_wmma_kernel_16x16_1w<__hip_bfloat16>:
| 指令 | 靜態條數 |
|---|---|
v_wmma |
1 |
s_waitcnt |
49 |
└ lgkmcnt(0) |
27 |
ds_load_u16_d16 + _hi |
8 + 8 = 16(對應源碼 for (i=0..15) b_frag[i] = b_tile[i][lane_lo]) |
ds_bpermute |
8 |
global_atomic_cmpswap |
8 |
編譯器(AMD ROCm LLVM fork,clang 22.0.0git)並非無能 —— 它在其他位置懂得使用 lgkmcnt(1)×98、(2)×20、(7)×24 等局部等待。是這段存取模式令它只能選擇最保守的方案。
vllm/model_executor/kernels/linear/mixed_precision/rdna_hybrid_w4a16.py:
M <= MAX_SKINNY_BATCH_SIZE (=5) : HIP skinny GEMM (wvSplitK_int4_g)
M >  MAX_SKINNY_BATCH_SIZE      : Triton W4A16 fused dequant GEMM
我們的 decode 有 80% 屬 M=4,恰好落在第一段;而我們目前兩段皆使用 GPTQ kernel。
轉換器 : tools/convert_quark_int4_to_gptq_v3.py(Quark W4A16 → GPTQ,無損)
補丁   : patches/0001..0019.patch(基底 StevenChenSE/sglang gfx1100-support @ 1442c18)
 shim   : shim/rdna_lmhead_int8.py(INT4 LM head,端到端 +19.7%)
 repo   : https://github.com/lawsirlawsir-png/rdna3-quark-w4a16  (tag v1.0.0)

驗證方式:以 HTTPS 下載全部 19 個 patch → 套用到 1442c18 的乾淨檢出 →
          git am 全數通過 → 與生產建置來源 git diff --quiet 無輸出(9,034 檔相同)。
MARKET_NAME   : AMD Radeon PRO W7800 48GB
SUBVENDOR_ID  : 0x1458  (GIGABYTE)
DEVICE_ID     : 0x7449   SUBSYSTEM_ID: 0x2428
NUM_COMPUTE_UNITS: 70     TARGET_GRAPHICS_VERSION: gfx1100
PCIE          : Gen 4 x16(MAX_PCIE_WIDTH 16 / MAX_PCIE_SPEED 16 GT/s)
vBIOS         : W7800 48G/F1/1133
@liu-yang 抱歉呀, 我没有用comfy UI
@flyer666 WOW , you are my hero bro. Let me check your post
4卡能跑DEEPSEEK V4 FLASH真的不錯 不過家裡空間有限如果QWEN 3.8 27B都不能滿足我的需求,我再考慮呢4卡或其他方案
 謝謝你的意見!
@terry 哈,Terry兄我的目標真是Deepseek V4 Flash

對我個人而言,多買三張就不是投資,是墜入顯卡KK園詐騙陷阱了🪤
補充一個Rocm燒CPU的小修復,我回家才發現的:
【分享】ROCm 7.2.4 + SGLang:idle 冇 request 燒 ~3 core CPU / 83°C → self-build libhsa + 1ms throttle 修好(3→1 core、83→64°C)
環境:AMD Radeon PRO W7800(gfx1100)· ROCm 7.2.4 · Ubuntu 24.04 · SGLang(Qwen3.5/3.8 hybrid 27B GPTQ W4A16)
症狀
斷症
修法(self-build rocr,唔使升 ROCm)
結果
剩餘觀察
有同樣症狀(ROCm + SGLang/vLLM idle 燒 CPU)可試;唔得 rollback 一條 cp 搞掂。
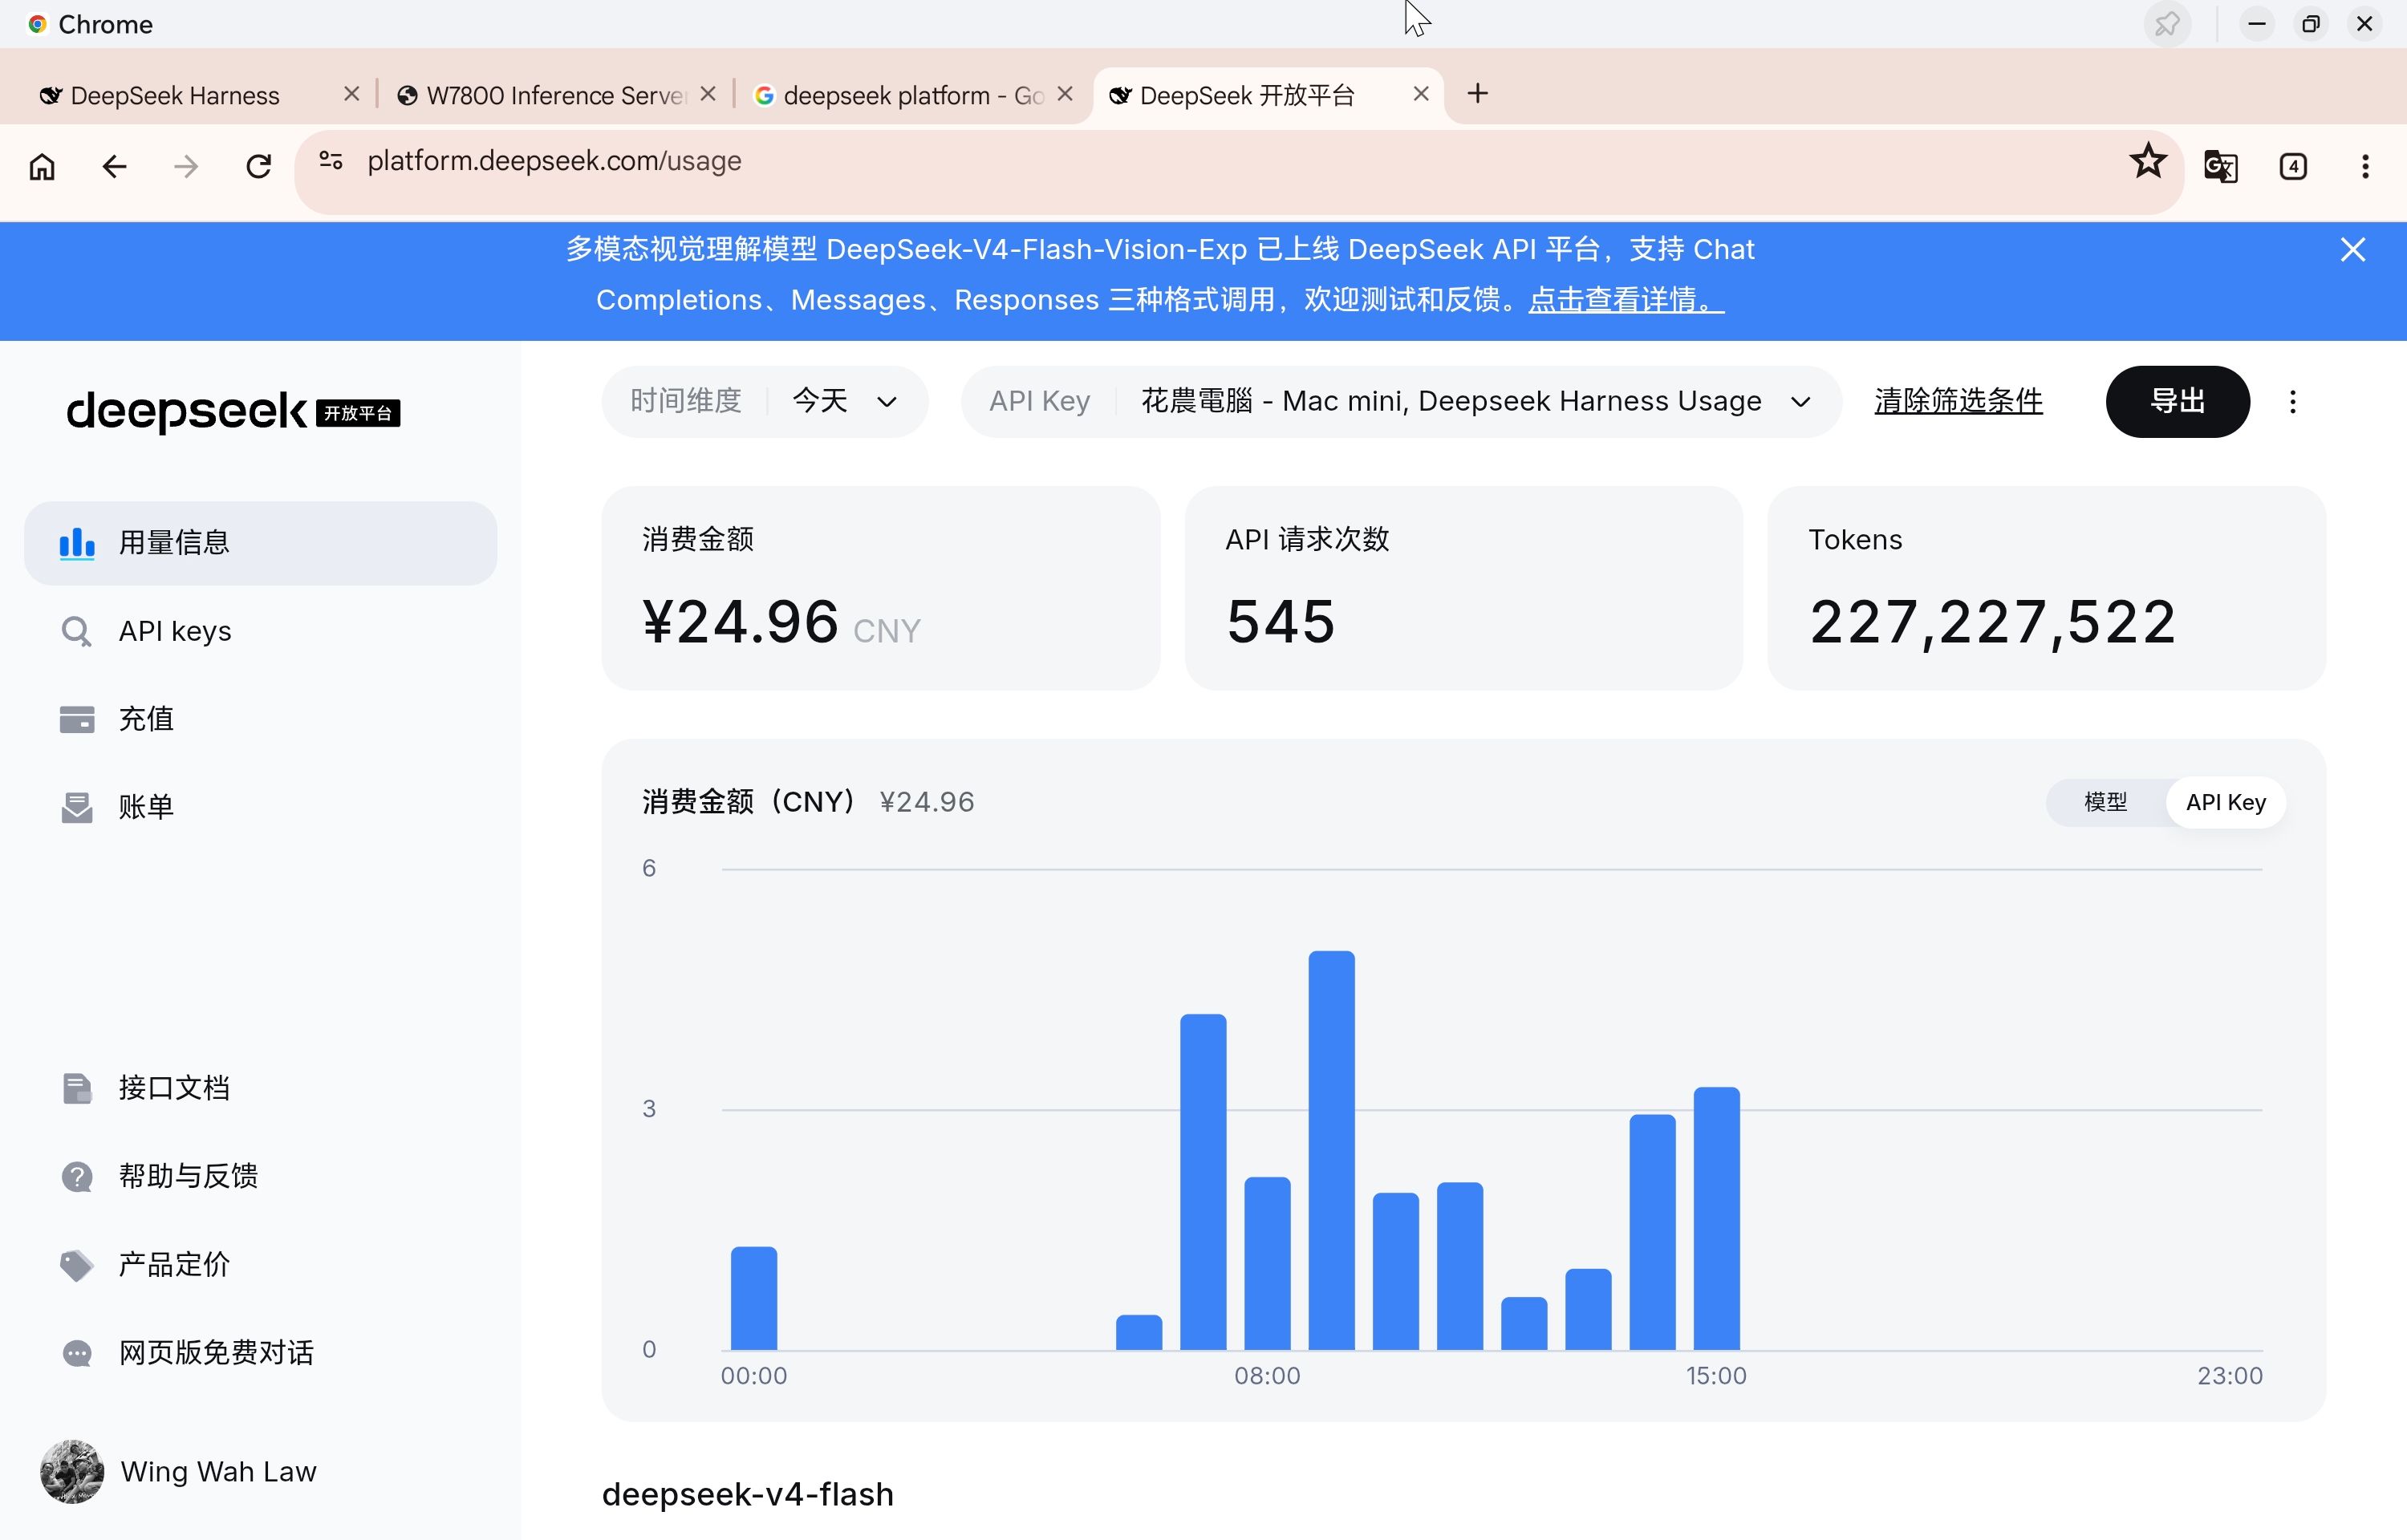
一杯奶茶就換來巨大生產力祝各位壇友事事順利Terry兄財源滾滾 ️
(以下全是AI Report,Terry哥一句,夠我折騰一日,生產部署最終定型,我已經很滿意現在的體驗了)
(注:我完全不知道報告中的名詞是什麼意思,我也不知道Deepseek V4 Flash調試了什麼,反正我就不斷追問,要他成功在SGLang部署後加速)
呢篇係我 W7800 報告(lcz.me/topic/1538)嘅 SGLang 部份。
9/5 我試咗 SGLang 官方版本,當時結論係「列咗名但未 ready」(FP8 0.62 t/s、INT4 全失敗)。但 Terry 喺我報告下面提示「你可以嘗試下 SGLang,論壇有帖子,體驗會好很多」,加上論壇 #1252 / #1532 / #1340 / #30599 前人嘅經驗,我決定深入一層:用社區嘅 gfx1100-support fork,做完整嘅三引擎對比 + 投產評估。
以下全部係 2026-09-07 23:35 → 09-08 15:36(HKT,+08:00)實測,數據全部有 log 溯源(私有雲Share/w7800-abc-sglang-20260908/00–05 六份文件)。
| Segment | 時段 | gen mean | median | max |
|---|---|---|---|---|
| 單發(1 stream) | 15:34:56–15:36:14 | 50.9 t/s | 53.9 | 79.5 |
| 雙發(2 streams aggregate) | 15:31:31–15:34:52 | 83.4 t/s | 84.9 | 92.5 |
雙發 per-stream ≈ 41-42 t/s(83.4÷2)→ 單→雙每條跌 ~17%(細 context 並發代價細,scaling ~1.6×)。
9/5 我試咗 SGLang 官方版本(AMD 官方話支援 Radeon),結果:
當時我嘅結論係「SGLang 官方喺 W7800 用唔到,正路係 Instinct」。但 Terry 喺我報告下面話「你可以嘗試下 SGLang,論壇有帖子,體驗會好很多」,我查咗論壇,發現前人已經行過好多路:
呢啲前人嘅經驗俾咗我信心:SGLang 唔係「用唔到」,係「官方版本未 ready,但社區 fork 行到」。所以我決定用 StevenChenSE 嘅 gfx1100-support fork 做完整測試。
呢個係我特別想標注嘅部份。我哋成個 SGLang 研究,唔係由零開始,係站喺前人嘅肩膀上面。以下係我哋參考過嘅前人,同佢哋幫我哋避咗咩坑、省咗咩時間:
| 前人 | 佢哋俾咗咩 | 我哋靠佢哋避咗咩坑 / 省咗咩時間 |
|---|---|---|
| terry(lcz.me) | 喺我 W7800 報告下面提示「你可以嘗試下 SGLang,論壇有帖子」 | 直接觸發咗成個 SGLang 研究。唔係佢提示,我可能仲喺 llama.cpp 度兜圈 |
| lcz.me #1252 | vLLM on RDNA3 實測:Triton attention 長 context 慢、vLLM MTP 16k 崩到 13.8 t/s | 我哋唔使自己再花幾日去驗證「vLLM 係咪答案」。直接知道 vLLM 長 context 唔掂,將精力集中喺 SGLang fork |
| lcz.me #1532(flyer666) | SGLang + HiCache 三級架構 + 為 HiCache 加 RAM(32→64GB) | 我哋 HiCache size 12 天花板嘅結論同佢一致(30Gi RAM 唔夠 full-L2)。唔使自己再撞牆,直接知道要加 RAM 先做到 full-L2 |
| lcz.me #1340 | 4090 48GB + SGLang DFLASH2,DSH 寫碼均速 110 t/s | 俾咗我哋 DFlash 嘅開法同信心去試。正正因為有呢個「110 t/s」嘅參考,我哋先會去開 DFlash 無人區(雖然我哋單卡 W7800 上 DFlash 無加速,但開路本身就有價值) |
| lcz.me #30599 系列 | 建議 vLLM/SGLang 喺 RDNA3 可作 production | 俾咗「SGLang 可以投產」嘅方向性信心,唔使自己盲猜 |
| StevenChenSE(SGLang gfx1100-support fork) | 成個 fork:wave32 對齊 decode graph、rdna_unified_verify、SSM state buffer、triton attention | 呢個係我哋嘅地基。冇呢個 fork,SGLang 喺 gfx1100 根本行唔到。MTP-3 深度唔崩都係靠佢嘅 unified verify + SSM buffer |
| Vishva007 | Qwen3.8-27B-W4A16-AutoRound-GPTQ model(13.5GB) | 俾咗一個 48GB 放得落、SGLang 行到嘅量化版本。我哋只需 patch MTP config 就 load 到,唔使自己量化 |
| z-lab | Qwen3.8-27B-DFlash2 draft model(3.8GB,public) | 俾咗 DFlash 無人區測試嘅 draft。唔使自己訓練 draft model |
| incoai / syvai | 其他 DFlash draft 變體 | 俾咗我哋做「換 draft 有冇用」嘅對照組。結論:無用,DFlash 死症同 draft 無關 |
| vLLM 官方 | 官方 ROCm wheel(wheels.vllm.ai/rocm)+ #41394 原生 RDNA3 kernel | 俾咗 B leg 嘅對照組。W4A16 行原生 RDNA3 kernel,唔使自己編 |
一句講晒:我哋成個研究,最貴嘅嘢(fork、model、draft、vLLM wheel)全部係前人做好嘅。我哋只做咗「喺自己部機上面實測 + 開 DFlash 無人區 + 投產」呢幾步。呢個就係開源社區嘅力量。
️ 一個重要提醒:fork README 嘅數據係雙卡 ROCm 7.14 環境、且論壇帖註明「以下數據為 LLM 生成」——單卡唔好直接套用。我哋全部數據係單卡 W7800 + ROCm 7.2.4 實測。
三 engine 同一張卡、同一個 Qwen3.8-27B base,全部 text-only chat(thinking off)、temp 0、相同 prompts(p0=204 tok、p2=1364 tok、deep=16,300 tok):
| leg | engine | 版本 | 量化/model |
|---|---|---|---|
| A | llama.cpp(production config) | master 8b4b355(2026-09-04) | Q6_K GGUF(~21GB)+ MTP n=2 |
| B | vLLM(官方 ROCm wheel) | vllm 0.28.0+rocm723 + torch 2.12.0 | W4A16 GPTQ(~13.5GB) |
| C | SGLang(community gfx1100 fork) | StevenChenSE/sglang @1442c18 + sgl_kernel AOT 自編 | 同上 W4A16 model |
| 場景 | A llama.cpp (Q6_K+MTP) | B vLLM (W4A16) | C SGLang (W4A16) |
|---|---|---|---|
| p0 204tok gen256 | 31.0 t/s | 36.0 t/s | 33.5 t/s |
| p2 1364tok gen256 | 34.4 t/s | 29.8 t/s | 32.7 t/s |
(decode-only 估算:A ~33 / B ~37 / C ~35 t/s —— 三 engine 單流同級,B 喺短 prompt 微贏、A 喺長 prompt 反超。考慮 A 每步要讀 21GB、B/C 只讀 13.5GB:llama.cpp kernel 效率最高、vLLM/SGLang 喺 ROCm 有 overhead。)
| 指標 | A llama.cpp (2 slots) | B vLLM | C SGLang |
|---|---|---|---|
| aggregate gen | 42.2 t/s | 66.8 t/s | 89.7 t/s |
| per-req median wall | 23.4s | 15.3s | 10.0s |
→ C(Radix 前綴樹 + continuous batching)並發最好;B 次之(prefix caching);A 受 production -parallel 2 限制,並發係 llama.cpp 最弱項。
| 指標 | A | B | C |
|---|---|---|---|
| cold prefill 16k | 494 t/s | 424 t/s | 659 t/s |
| decode @16k(cache warm, gen128) | 30.9 t/s | 20.8 t/s | 29.5 t/s |
| 短→16k decode 留存率 | ~90% | ~57% | ~85% |
→ B(vLLM)長 context decode 衰減明顯(Triton attention 喺 ROCm 深度慢,同 lcz #1252 觀察一致);A(llama.cpp MTP)同 C(SGLang)深度表現接近、都遠好過 B。
| A | B | C | |
|---|---|---|---|
| p0 204tok | 359 | 685 | 603 |
| p2 1364tok | 534 | 846 | 796 |
| deep 16k | 494 | 424 | 659 |
ABC 一句講晒:單流三 engine 同級(llama.cpp kernel 效率最高);並發 SGLang 贏(89.7 vs 66.8 vs 42.2);深度 SGLang 同 llama.cpp 接近、vLLM 明顯衰減。SGLang 嘅優勢喺並發 + 深度,正正係 agent workload 最需要嘅。
SGLang fork 支援 EAGLE spec decode。我哋用同一個 model 做 draft(MTP 模式,唔使另外 draft model),實測:
| 場景 | 無 spec | MTP-3(EAGLE steps=3, topk=1) | 提升 |
|---|---|---|---|
| p0 204tok gen256 | 33.5 t/s | 42.7 t/s | +27% |
| p2 1364tok gen256 | 32.7 t/s | 45.6 t/s | +39% |
| conc4 agg | 89.7 t/s | 100.1 t/s | +12% |
| 16k deep decode | 29.5 t/s | 40.9 t/s | +39% |
MTP-3 係 gfx1100 單卡最強 spec:+27-39%、16k 深度唔崩(vLLM MTP 喺 16k 會崩到 13.8 t/s,SGLang fork 嘅 unified verify + SSM buffer 解決咗呢個問題)。
點解 steps=3 最優(我哋窮舉咗 steps=4):
| 實驗 | Config | 結果 | 判定 |
|---|---|---|---|
| MTP steps=3 | EAGLE steps=3 | 42.7 / 100.1 | 最優 |
| MTP steps=4 | EAGLE steps=4 | 29.4 / 66.8 |  更差(draft 接受率/verify 開銷抵銷) |
呢個係我特別想寫嘅部份。DFlash 喺 ROCm/gfx1100 係無人區——冇人寫過、冇人實測過。我哋今早花咗兩個鐘,把成個無人區開路、畫晒地圖,希望其他人唔使再無謂想像「DFlash 喺 AMD 上面會唔會快」。
參考 lcz.me #1340(4090 48GB + SGLang DFLASH2,DSH 寫碼均速 110 t/s)。Draft 用 z-lab/Qwen3.8-27B-DFlash2(3.8GB,public)。Config:--speculative-algorithm DFLASH --speculative-draft-model-path <draft> --speculative-dflash-block-size 8 --speculative-draft-model-quantization unquant。
行到嘅過程,3 個 blocker 全部實測開路:
| # | Blocker | 症狀 | 解法 |
|---|---|---|---|
| 1 | 冇 aiter | draft RMSNorm 6-arg 同 4-arg fallback 撞 | 裝 amd-aiter + SGLANG_USE_AITER=1 |
| 2 | fork 嘅 layernorm.py forward_aiter record 順序 bug |
UnboundLocalError | 本地 patch(reorder) |
| 3 | 真兇:aiter 嘅 tuned_gemm.py skinny_gemm solidx==2 → wv_splitk_small_fp16_bf16 喺 gfx1100 M=1(decode)crash |
incompatible args | 本地 patch:soliidx==2 改用 torch.matmul |
第 3 個 patch 係真突破:tuned_gemm.py solidx==2 → torch.matmul,解鎖咗 gfx1100 上面所有用 aiter tuned-gemm 嘅 decode 路徑(唔止 DFlash)。呢個 + layernorm.py reorder fix 都係值得 upstream 嘅。
| 場景 | 無 spec | DFlash2 | MTP-3 |
|---|---|---|---|
| p0 204tok gen256 | 33.5 | 33.3 | 42.7 |
| p2 1364tok gen256 | 32.7 | 34.2 | 45.6 |
| conc4 agg | 89.7 | 69.1 | 100.1 |
| 16k decode | 29.5 | 30.2 | 40.9 |
結論:DFlash 喺 ROCm(無 flashinfer、aiter 要 patch)—— draft 接受率/verify 開銷抵銷,≈ 無 spec;MTP-3 先係 gfx1100 嘅 spec decode 之王(+27-39%、深度唔崩)。
我哋試過用 aiter 做 attention backend(代替 triton):
--attention-backend aiter + EAGLE draft → draft graph capture 撞 aiter_meta arch assert(gfx1100 唔喺 whitelist)→ 加咗 gfx1100 入 whitelist → 真 kernel hipErrorLaunchFailure(aiter_meta PA kernel 唔支援 gfx1100 launch)mha_batch_prefill_bf16 → JIT build 失敗(aiter batch-prefill FA 唔支援 gfx1100)結論:aiter 嘅 attention kernel 係 Instinct-first(gfx942/950/1151),gfx1100 兩層都唔行。fork 揀 triton attention(wave-aware split-K)做 RDNA3 主線係正確決定。aiter 喺 gfx1100 可用範圍 = 我哋已經 patch 咗嘅 tuned_gemm(soliidx==2→torch)+ norm kernel;attention 層唔值得再深入。
目標:搵到 spec decode 加速(組合 grid × 轉換 grid)。全部 quick protocol(warmup + p0×3 + p2×3 + c4):
| 實驗 | Config | p0 (204) | p2 (1364) | conc4 agg | 判定 |
|---|---|---|---|---|---|
| baseline 無 spec | triton attn | 33.5 | 32.7 | 89.7 | — |
| MTP-3(贏) | EAGLE+同 model | 42.7 | 45.6 | 100.1 | 贏 |
| C1 | DFlash(z-lab) blk8 + triton draft | 33.2 | 33.2 | 69.2 | 無增益 |
| C4 | DFlash blk12 | 20.5 | 20.5 | — | 更差 |
| C2a | DFlash(incoai draft) | 31.4 | 31.4 | 67.9 | 無增益 |
| C2b | DFlash(syvai W4A16 draft) | — | — | — |  marlin repack ROCm compile fail |
| T2 | DFlash + aiter wvSpltK (torch fallback) | 32.6 | 32.0 | 68.1 | 無增益 |
| T1 | NGRAM spec | — | — | — | 缺 sgl_kernel op |
| T3 | MTP-3 + fp8_e4m3 KV | 41.0 | 40.3 | 103.4 | ️ 受控 bench 行到(production 384K CTX 映射 VRAM 唔夠 → wedge) |
DFlash 無人區地圖(畫晒):
reconstruct_indices_from_tree_mask(upstream 未 port 到 ROCm build)DFlash2DraftModel arch + compressed-tensors)要 marlin repack,ROCm 7.2.4 clang compile fail️ fp8_e4m3 KV:受控 bench 行到但 production 走不通—— MTP-3+fp8 受控 bench:p0 41.0 / p2 40.3 / conc4 103.4 ≈ bf16 同速、KV 慳一半;但映射 384K CTX pool 嘅 VRAM 分配可能超過 48GB → production 兩次永久 wedge(有/無 HiCache 都死)→ fp8 走不通,唔上 production| 實驗 | Config | 結果 | 判定 |
|---|---|---|---|
| A | EAGLE3 spec(tree verify) | 起機即死 | draft 缺 set_embed(fork 未實現 EAGLE3) |
| B | MTP steps=4 | 29.4 / 66.8 | 差過 steps=3(42.7/100.1)→ steps=3 最優 |
| C | AWQ target(fp16,MTP-3) | 10.6 / 11.6 / 43.3 | AWQ kernel 喺 gfx1100 冇優化,慢一大截 |
| D | fp8 KV + MTP-3:conc8 / deep / prefill | 132.0 / 29.3 / ~290 | 384K CTX 映射 VRAM 唔夠 → production 兩次 wedge,走不通 |
fp8 KV 完整畫像(對比 bf16 KV + MTP-3):
| 指標 | bf16 KV | fp8 KV |
|---|---|---|
| 單流 p0/p2 | 42.7 / 45.6 | 41.0 / 40.3 |
| conc4 | 100.1 | 103.4 |
| conc8 | —(未測,KV 爆) | 132.0 |
| 16k deep decode | 40.9 | 29.3 |
| 16k prefill | 659 | ~290 |
→ fp8 KV 走不通:受控 bench 行到(conc8 132、KV 減半),但映射 384K CTX pool 嘅 VRAM 分配可能超過 48GB → production 兩次永久 wedge(有/無 HiCache 都死)→ 唔上 production。bf16 KV 係唯一可行選項(deep 40.9 t/s);要並發多都只能用 bf16(受 187K pool 限制)。
DFlash 無人區一句講晒:我哋今早把 DFlash 喺 ROCm/gfx1100 嘅成個無人區開路——3 個 blocker 全部開路(包括一個值得 upstream 嘅 aiter patch)、5 個 DFlash 組合全部實測(全部無增益)、NGRAM/EAGLE3 確認 blocked、aiter attention 兩層撞牆。結論:DFlash 喺 gfx1100 單卡 = 死症,MTP-3 先係正路。 希望呢份地圖幫其他人免去無謂想像,唔使再花兩個鐘去撞同一批牆。
| 時間 | Config | Pool tokens | 結果 |
|---|---|---|---|
| 09:06 | bf16 KV + MTP-3 + triton | 187K | 穩定(baseline) |
| 09:2x | + parsers(qwen3 / qwen3_coder)+ thinking off | 187K | 必修(唔加 = thinking 混 content + tool call 變文字) |
| 10:53 | + caps(running 4 / queued 6) | 187K | 300s timeout 死症 → fast-fail 503 |
| 11:32 | + HiCache size 12 | 187K | cache hit 65→77%;size 16 失敗(30Gi RAM 唔夠) |
| 12:16 | + cache-report | 187K | DSH 命中顯示由 0 → 真數字(config flag,唔使改 code) |
| 12:5x | fp8 KV 版試 | 375K(≈384K CTX) | 兩次 wedge(有/無 HiCache 都死;384K CTX 映射 VRAM 可能唔夠)→ 走不通,唔上 production |
| 13:5x | bf16 + chunked 16384 | 187K | 巨 prefill drain 快但 VRAM 峰值高(46.9GB) |
| 14:1x | bf16 + chunked 8192 + ctx 131072 | 187K | 定型 |
| — | DSH contextWindow 定案 | 80000→100000 | 100K 做 threshold compression(context 到 100K 就壓縮;hot-reload,唔使重啟) |
~/start-server.sh)export SGL_DTYPE=bfloat16 SGL_PHASE_TIMING=0
export SGL_RDNA_CUSTOM_AR=1 SGL_RDNA_NO_FUSED=1 SGL_RDNA_GEMMA_TRITON=1 SGL_RDNA_VLLM_VERIFY=1
export TVM_FFI_DISABLE_TORCH_C_DLPACK=1
python -m sglang.launch_server \
--model-path .../Qwen3.8-27B-W4A16-AutoRound-GPTQ \
--host 0.0.0.0 --port 8080 --served-model-name qwen3.8-27b \
--tp-size 1 --quantization gptq --dtype bfloat16 --mamba-ssm-dtype bfloat16 \
--kv-cache-dtype bf16 --attention-backend triton \
--chunked-prefill-size 8192 \
--context-length 131072 --mem-fraction-static 0.88 \
--speculative-algorithm EAGLE \
--speculative-draft-model-path <同一 model> \
--speculative-num-steps 3 --speculative-eagle-topk 1 \
--reasoning-parser qwen3 --tool-call-parser qwen3_coder \
--default-chat-template-kwargs '{"enable_thinking": false}' \
--max-running-requests 4 --max-queued-requests 6 \
--enable-hierarchical-cache --hicache-ratio 1.0 --hicache-size 12 \
--hicache-write-policy write_through --hicache-io-backend kernel --hicache-mem-layout page_first \
--enable-cache-report
每個 flag 點解要(實測教訓):
| Flag | 原因 |
|---|---|
--reasoning-parser qwen3 --tool-call-parser qwen3_coder |
唔加 = thinking 混入 content + tool call 變純文字(DSH 唔 parse 到)。呢兩個 parser 係 production 必備 |
--default-chat-template-kwargs {"enable_thinking": false} |
llama 時期 --reasoning off 嘅對應;唔加 default thinking ON → 思考文字混答案 |
--max-running-requests 4 --max-queued-requests 6 |
硬 cap:超過 6 條排隊即刻 reject(fast fail),防止 prefill flood 餓死 decode(今日 300s timeout 事故) |
--kv-cache-dtype bf16 |
深度 decode 快(40 t/s vs fp8 29);fp8 走不通(384K CTX 映射 VRAM 唔夠 → 兩次 wedge)→ 並發多都只能用 bf16 |
MTP-3 (EAGLE steps3) |
單卡實測最強 spec(+27-39%,16k 深度唔崩) |
--enable-hierarchical-cache --hicache-size 12 |
HiCache 三級架構,cache hit 65→77%;size 12 = 30Gi RAM 天花板 |
--enable-cache-report |
純文字 request 回 cached_tokens(DSH 命中顯示由 0 → 真數字) |
| 指標 | 數值 |
|---|---|
| Decode gen tps | mean ~53 / median ~58(單 session 50-61) |
| MTP accept rate / len | ~0.74 / ~3.2(最後 config accept 0.65-0.9) |
| Cache hit(Radix+HiCache) | 全日 65%,HiCache 後 77% |
| Pool | bf16 187K tokens(fp8 可 375K 但 wedge) |
| 最深 KV | 176K tokens |
| 並發 | 1-8 reqs 目擊;2 條深 stream 60-70 t/s,4 條深跌個位數 |
| Prefill | 全日 new 3.4M + cached 6.4M tokens |
| 溫度/功耗 | junction 41-101°C,max 280W |
| health | 飽和期 45% polls 餓死(/v1/models 全程即答) |
| 503 fast-fail | 16 次(caps 生效證據) |
DSH 量(production 實測,真實 agent workload)—— 完整數據見上面「先講結論」,呢度補返 context:
| Segment | 時段 | batches | gen mean | median | max | KV 範圍 |
|---|---|---|---|---|---|---|
| 單發(1 stream) | 15:34:56–15:36:14 | 22 | 50.9 t/s | 53.9 | 79.5 | 11-21K |
| 雙發(2 streams aggregate) | 15:31:31–15:34:52 | 66 | 83.4 t/s | 84.9 | 92.5 | 15-32K |
測試:DSH 7-agent bug audit × 7 HTML(+ 主 session = 8 條 stream,全部深 context)
| 並行 heavy agent | 結果 |
|---|---|
| 2–4 條 | 舒服(decode 60-70 t/s) |
| 4 條深 stream(149K KV) | 跌到個位數(6 t/s)—— 唔建議 |
| 8+ 條 / 巨 turn(100K+/turn) | prefill queue 爆 → 300s timeout(舊)/503 fast-fail(caps 後) |
操作守則(定案):
--context-length 131072 係兩層(DSH 100K 先壓縮、sglang 131K 係硬上限)| # | 坑 / 經驗 | 教訓 |
|---|---|---|
| 1 | uv venv 入面冇 pip |
全部用 uv pip install --python <venv>/bin/python |
| 2 | torchcodec 係 CUDA-only,裝咗會死(libnvrtc.so.13 缺失) | pip uninstall -y torchcodec + pip install decord2(自動 fallback) |
| 3 | moe_q_gemm_rdna3 喺 ROCm 7.2.4 clang 下 compile 唔過(最大坑) |
用同簽名 link stub 頂(dense model 唔會 call;MoE+GPTQ 喺呢個 build 唔可用) |
| 4 | import sglang 缺 modules |
import 循環法:報邊個裝邊個(orjson psutil pybase64 requests starlette tqdm IPython pydantic aiohttp gguf soundfile decord2) |
| 5 | 多 engine VRAM 爭用 | 測邊個先殺晒其他 engine(注意 pkill/pgrep -f self-match 坑) |
| 6 | fork README 話「唔支援 fp8 KV」 | 受控 bench 行到但 384K CTX 映射 VRAM 唔夠 → production 兩次 wedge → 走不通(README 喺 production 層面講得啱) |
| 7 | llama-bench 唔適合 SGLang | 用 OpenAI /v1/chat/completions 協議量 |
| 8 | DFlash:aiter 必需、layernorm bug、tuned_gemm solidx==2 crash | 3 個 blocker 全部 patch(見 §5.1) |
| 9 | aiter attention 喺 gfx1100 兩層撞牆 | aiter 係 Instinct-first,gfx1100 唔行;triton attention 先係正路 |
| 10 | thinking 混入 content、tool call 變文字 | --reasoning-parser qwen3 --tool-call-parser qwen3_coder 必須顯式 set(auto 只 log 唔 parse) |
| 11 | 純文字 request prompt_tokens_details=None → DSH 命中顯示 0 |
開 --enable-cache-report(內置 flag,唔使改 code) |
| 12 | prefill flood 餓死 decode(8 stream 事故:300s idle timeout) | 單 request 100K+ turn 純 prefill >300s 必死;並發 caps + retry 上限先有得救 |
| 13 | retry 死循環 | DSH retry 會將成段 context 掟返 queue → queue 永遠清唔完;retry 要設上限(DSH=5) |
| 14 | cache hit「0」誤解 | 純睇 #cached-token: 0 行 = 嗰啲係新內容 chunk;整體 hit 65-77% |
| 15 | HiCache size 16 失敗 | 30Gi RAM 機 Not enough host memory;size 12 = 天花板 |
| 16 | monitor JS escape | Python triple-quote embed JS:\n 要寫 \\n,否則成頁 SyntaxError 冇 status |
| 17 | health 飽和期 0 | sglang /health 要過 scheduler;飽和時餓死但 /v1/models 即答 —— monitor/alerter 用 /v1/models 先準 |
| 18 | queue full = caps 生效 | running 實際係跟 KV admission(深 context 下 ~2 條),queue 6 滿即 503 fast-fail(比 timeout 好) |
| 19 | fp8 KV + MTP-3 喺 gfx1100 兩次永久 wedge | detokenizer 心跳停,無 HiCache 都中;384K CTX 映射 VRAM 可能唔夠;bf16 只會短暫餓死並自癒 → fp8 走不通,唔上 production |
| 20 | gpu_watchdog 喺 sglang 下盲(llama /slots 冇咗) |
power-based busy 偵測 + sglang-compatible temp probe |
| 來源 | 定義 | 例子 |
|---|---|---|
| DSH 量(production 實測) | DSH client 喺真實 agent workload 中量度(wall + usage tokens,含真實 prompt/生成),係「有實際生產效力」嘅數字 —— 論壇上最有用嗰種 | 2-stream 細 context aggregate mean 83.4 / max 92.5 t/s(2026-09-08 15:31-15:34);單 session 50-61 t/s |
| sglang log 量(server tick) | server 每個 Decode batch 嘅 instant gen throughput | 全日 mean 50 / median 52;單 req max 70.5;多 req max 124.1 |
| Synthetic bench(AB 測試) | 固定 prompt/generation 嘅受控測試 | ABC report 入面 p0/p2 wall-rate 42.7/45.6;llama-bench 對照 |
️ 發帖時要寫明數字係邊種來源 —— DSH 量嘅數字含真實 workload 噪聲(tool call、prefill、thinking off 等),synthetic 先係純 engine 速度。兩種都係有效數據,但唔可以混埋當同一基準。
~/.dsh/AGENTS.md 基建段未更新(llama→sglang production)—— 用戶確認後更新呢篇 SGLang 部份由 DSH(DeepSeek Harness)根據 9/7-9/8 嘅完整調試日誌整理而成。所有數據皆實測,可溯源。
@freeman-gemmy 正在折騰Terry提示的SGLang,整體設定有變動,正在等DSH跑完試驗任務,稍後再出報告
@kos-or 我也是這樣想的,連Openai、Deepseek這些大公司為將來設計投產方向時,都要投資顯存算力,而且不等價格回落出盡力投資,他們這些大公司的決策者肯定不是吃素的。我們一般人想了一想,還心心念念期待的價格回落只有"期待",不會在短時內發生
我作為老百姓也量力以為呢,當係多一個有生產力的玩具,不妨礙自身發展
@hoyin258
我在黃金電腦商場地下SE Computer買W7800 48G的,經whatsapp問過很多間公司報價,很多都說供應商缺貨,只有SE Computer有貨
是正循環影響呀,我覺得挺好的
我也有想過vram 24GB或32GB都夠了,最後都係要大膽一點,上48GB試試,大不了AMD + 48GB 組合會慢一點,不過有足夠上下文去處理,唔洗跑幾輪就要上下文壓縮
高投資低預期回報下,現在這個速度反而有啲心理安慰
@张光璞
7900 48g vs 7800 48g
96cu vs 70cu
結果合理,繼續折騰中
@terry 折騰中,thinking...
W7900 48G 香港叫價$37800HKD左右,香港物價確實是非常貴