

PC1:
本地部署LLM,目前主力模型是27B FP8。
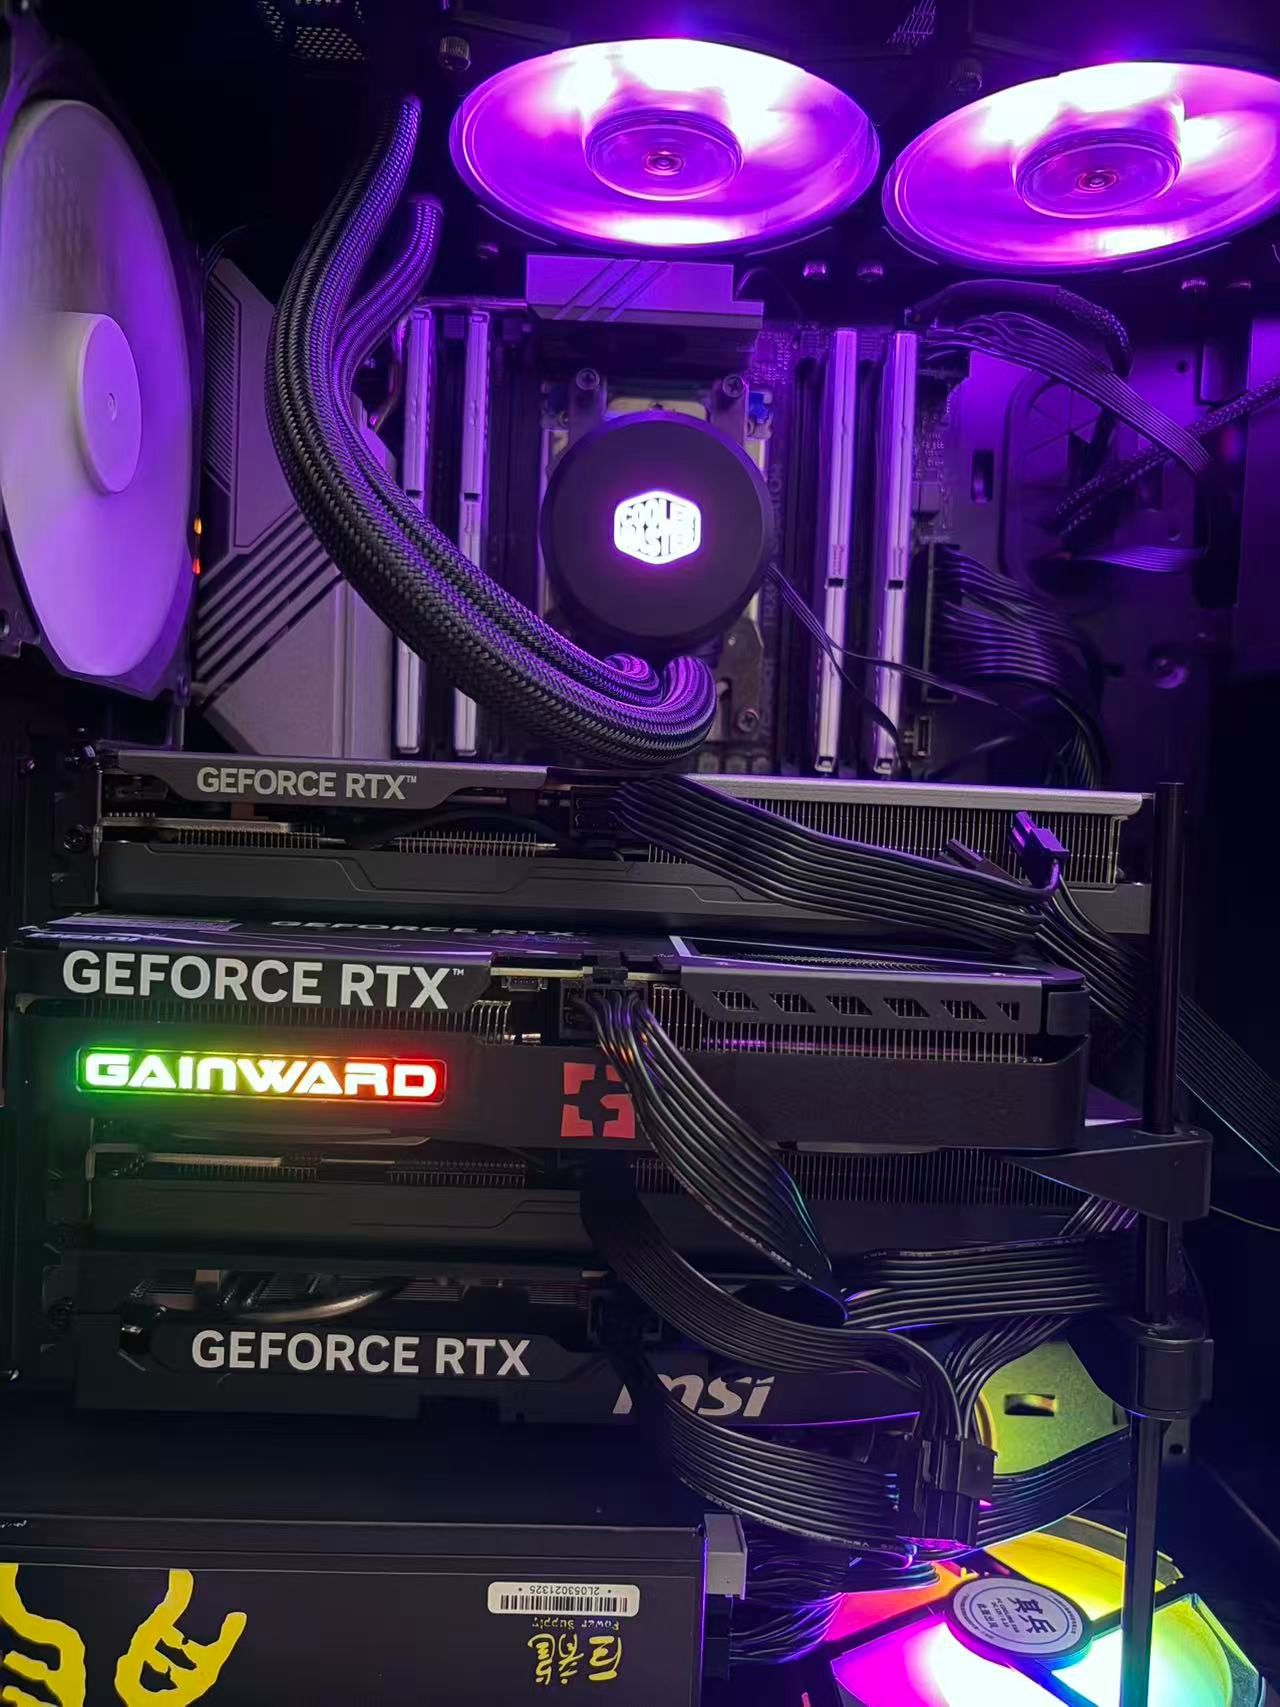
配置:5060ti*4 + trx40 + 3970x线程撕裂者 + DDR4 UDIMM 128g 3200 ,windows + ubuntu ,家属用windows办公,我用window打游戏。
还有128G DDR5 UDIMM 5600,闲置。
装备图,走线稍微乱了点......
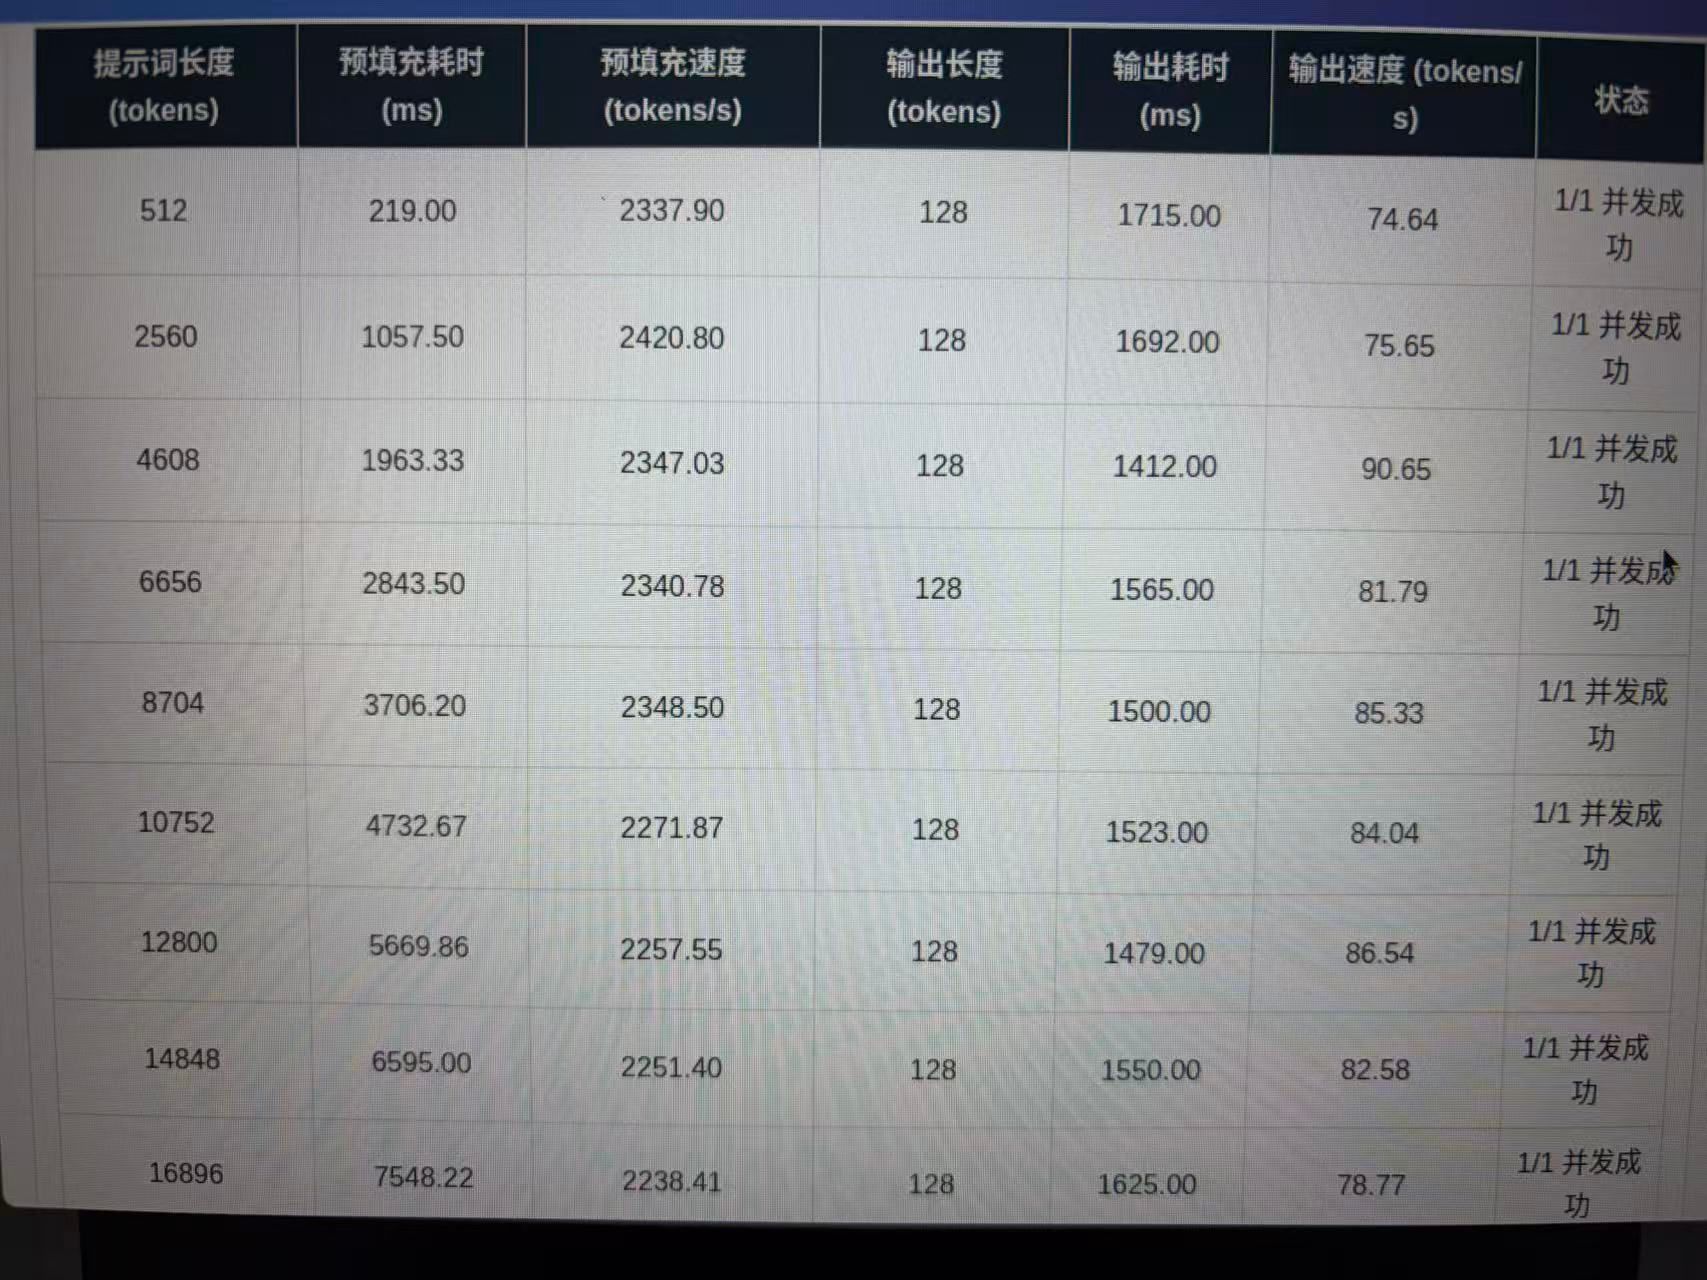
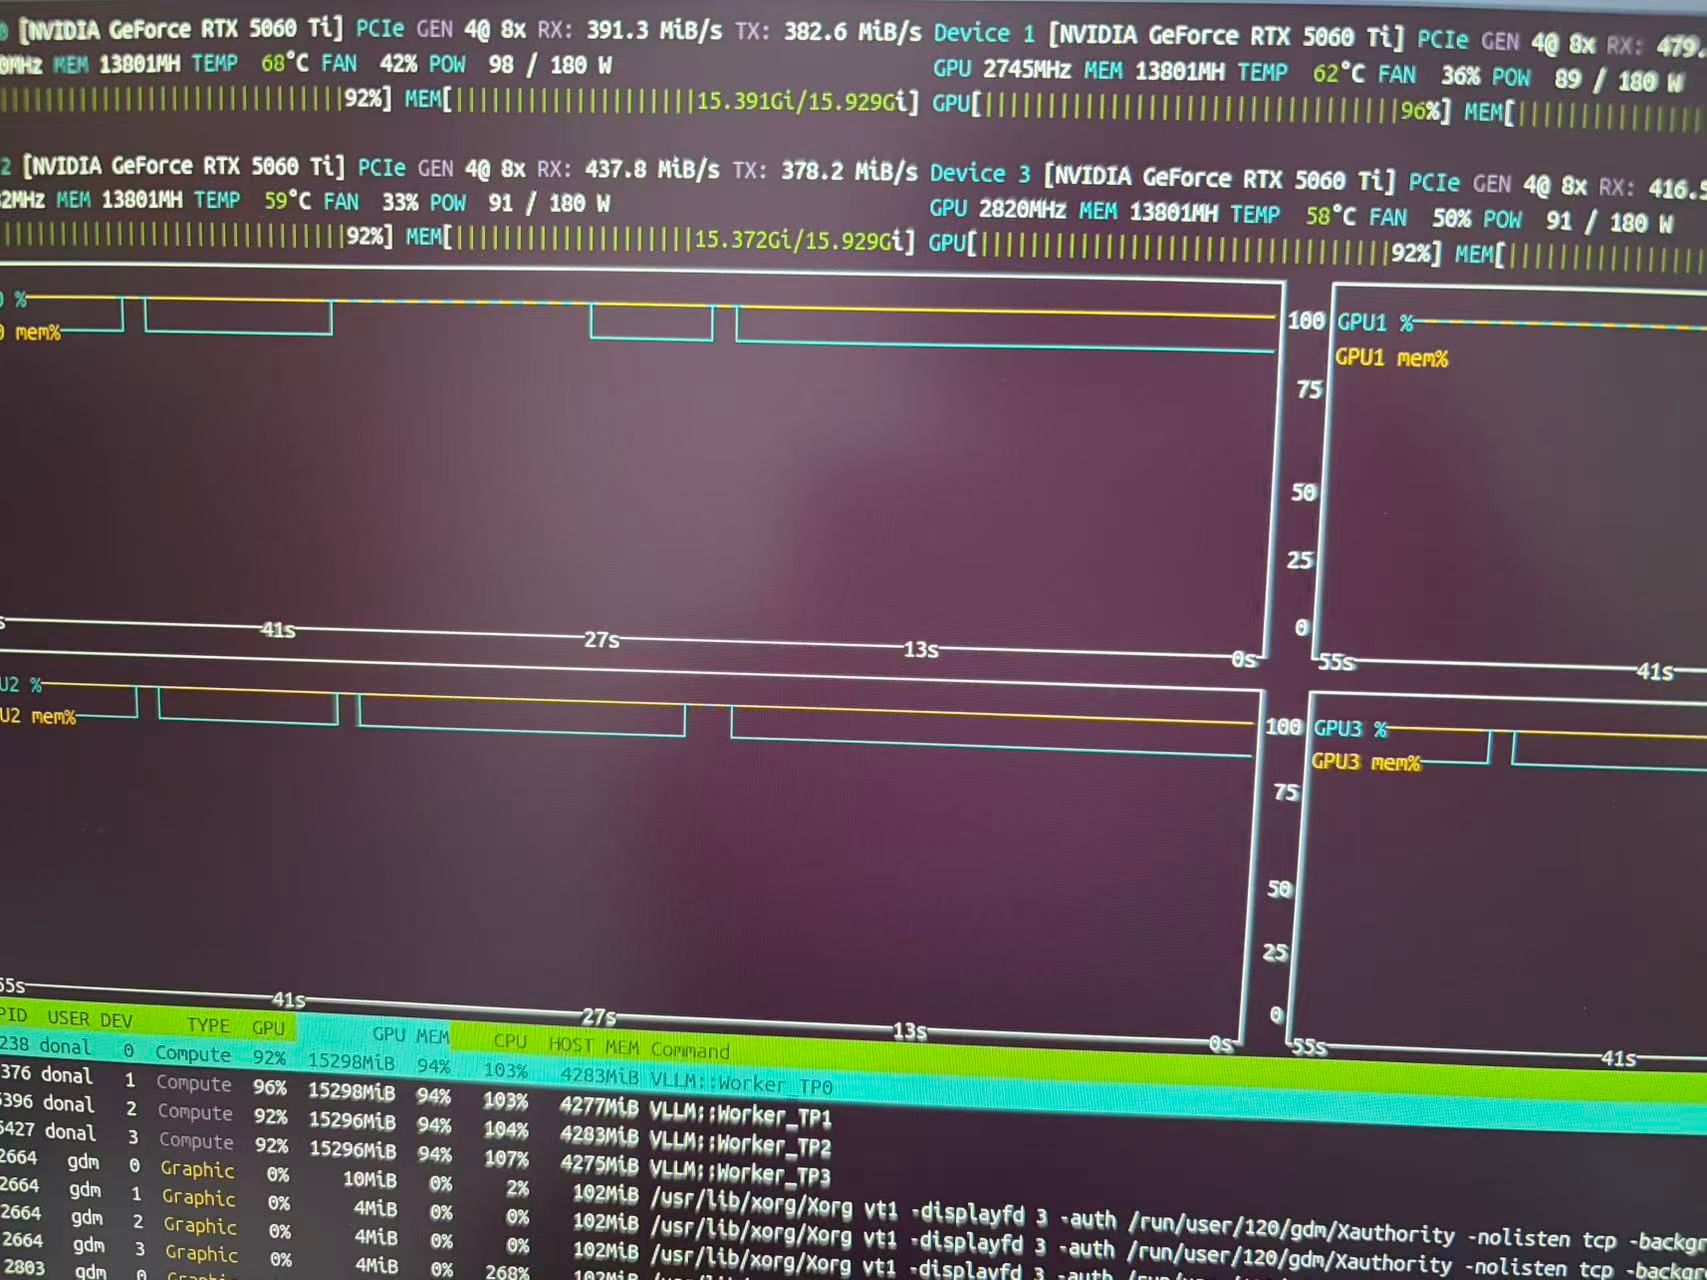
运行27B 推理,测速 和 nvtop
PC2:
AMD H370 迷你主机,32G DDR5 放在另一个房间,低功耗跑agent,ubuntu
PC3:
MBA M3 24g ,写代码用,SSH PC1 or PC2
我的分析:
nvtop看出,GPU和MEM 长期99%。
5060ti tp4 ,cuda核心 = 4500 * 4 = 18000 , prefill阶段,all prompt 可以并行计算QKV,现在2300 tps的prefill基本极限了?除非升级显卡算力?
decode阶段,看内存带宽。tp4总带宽 = 450G4 =1800G, 模型总权重 27B FP8 = 30G ,decode = 1800/30 =60 tps,扣除tp通信损耗0.7 = 40tps,打开MTP or Dflash2,可以提升到50-80 tps,也达到极限了?
虚心请教大佬意见,如果提高LLM性能,还可以升级什么?升级下显卡?主板?CPU?现在这些都很贵了,有没有性价比方案?还是再组个windows办公算了?
装机佬,一天不拧螺丝心里不过瘾,跟以前钓鱼一样的。