单张 RTX 3090 跑 Qwen3.8-27B:原版 83.9 t/s、Ampere 优化版 95.6 t/s、237K 上下文、能力测试 20/20
单张二手 RTX 3090 24GB,Ubuntu 26.04.1,原版 llama.cpp、llamAmpere 与 HyperQwen 完整实测
测试日期:2026-09-21 至 2026-09-22
这篇测试参照 lcz.me 的《7900 XTX 跑 Qwen3.8-27B 完整部署与实测指南》,保留其测试题、采样参数、长提示、prompt cache、n-max 扫描和 20 道能力题,再把 AMD Vulkan 配置改成适合本机单张 RTX 3090 的 CUDA 配置。
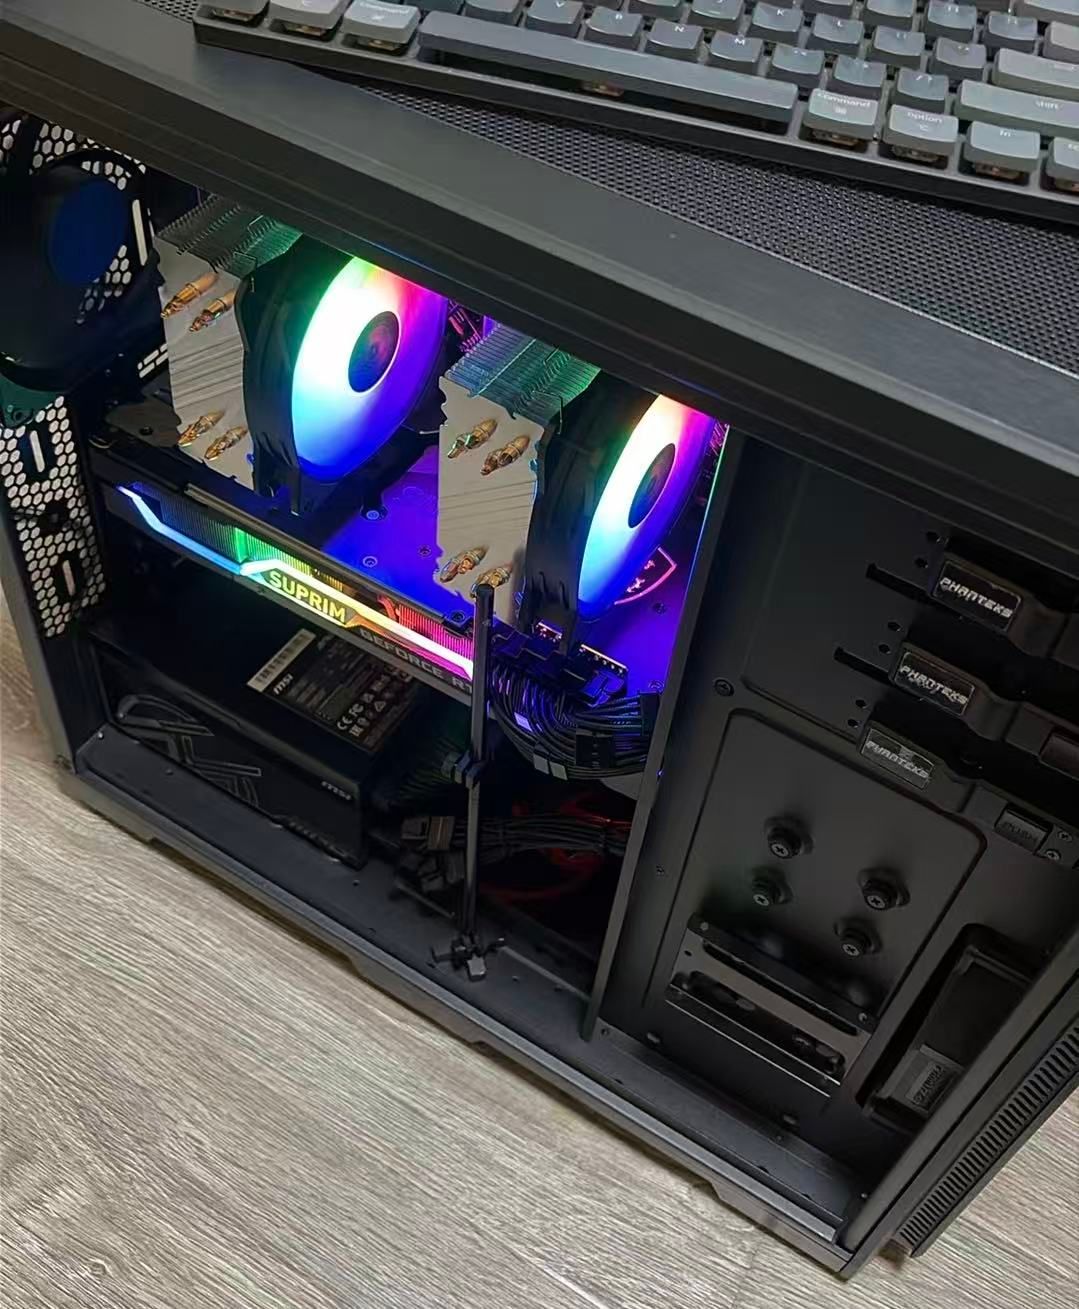
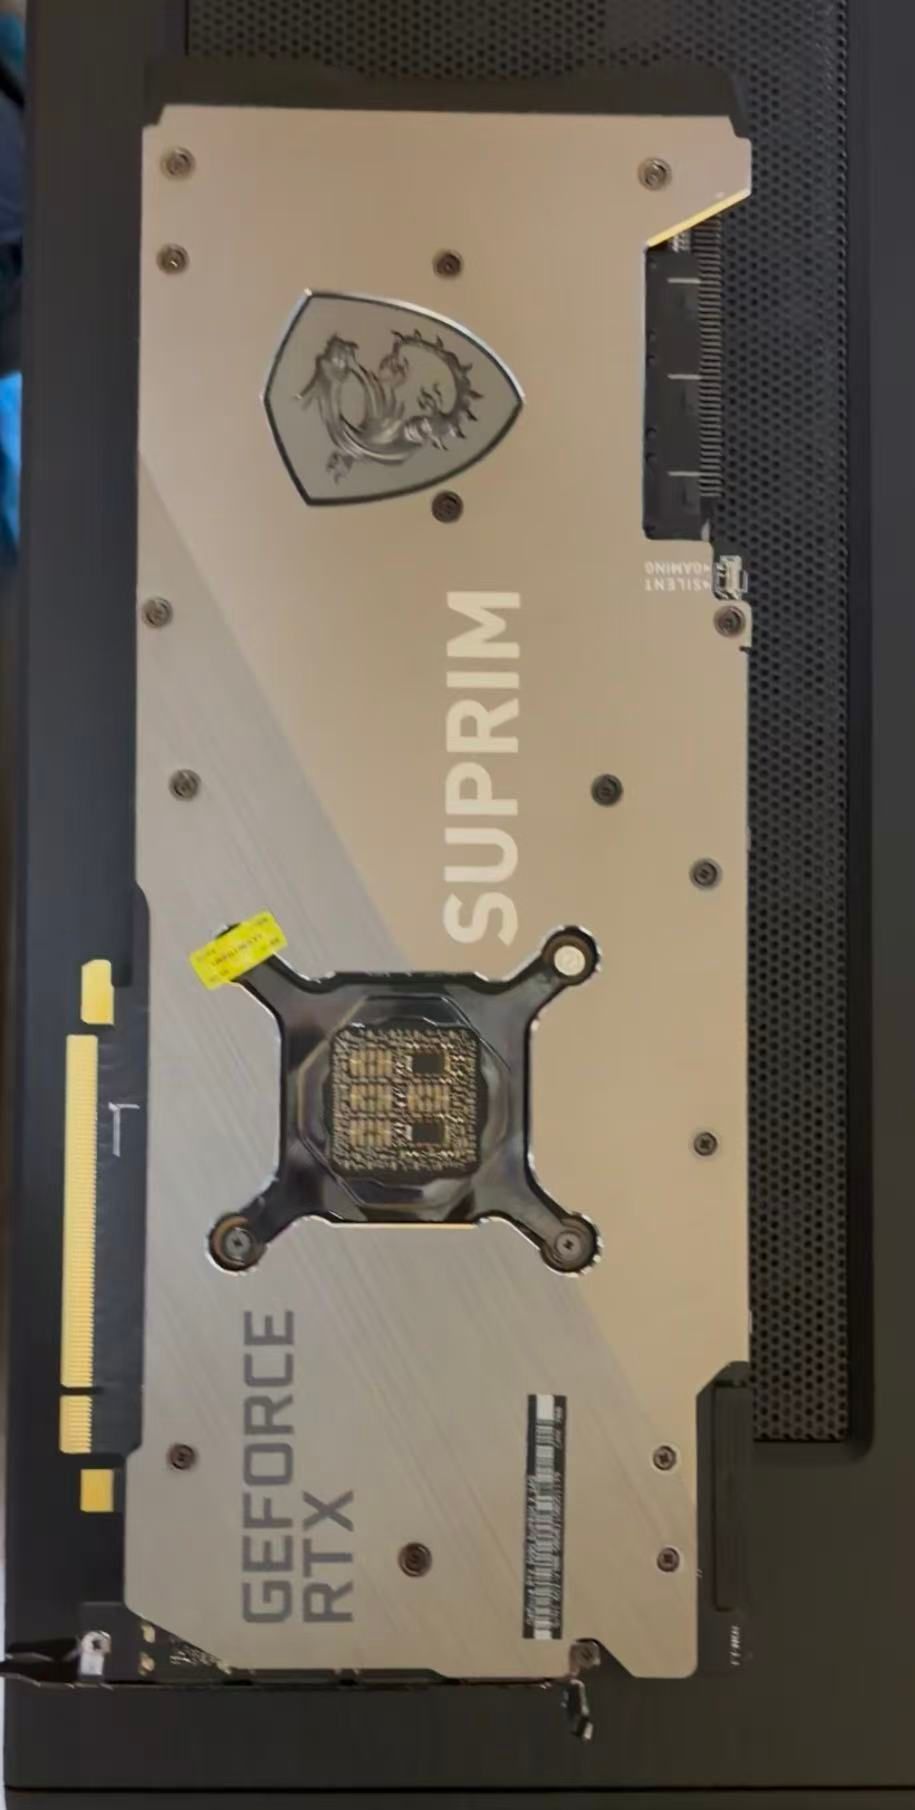
说在开头本人也是硬件小白,现在就是看锤哥视频慢慢鼓捣窜了台机器,大神们轻点喷哈 ,配件都是东子上买的,除了显卡是二手东子自营的3090,其他都买的一手货,我买到的3090是个大卡,后续因为想在淘个3090,所以选的HUANANZHI X99-F8D PLUS这个板子(需要个塔式的机箱),坑的来了,如果是两个3090的话的电源线用便宜的长城金龙的电源口不够,客服也不给加模块,最后买了个微星的电源2900软妹币,整机下来大概花了1.6-1.7W。下面的配置都是根据我需求参考论坛的大神帖子找GPT配置的,后续这台机器是想做AI视频工作流的,昨天算是工作流跑通了,这两天整理下发到论坛上来。这几天在满载跑视频进行测试(需要装载卸载模型),目前看这个二手卡还是挺靠谱的。
报告先完整记录原版 llama.cpp 的可复现基线,再追加针对 RTX 3090 的 llamAmpere 和 HyperQwen 优化结果。重点不是单独追求最高的 t/s,而是说明硬件、软件、提示词、采样参数和测量方法。投机解码的速度会随着题目类型明显变化;同一台机器上,中文创作、代码和工具 JSON 的速度可以相差接近一倍。
目录
- 先给结论
- 硬件与软件环境
- 与原帖平台的关键差异
- 编译、模型和最终启动配置
- 无 MTP 基线
- MTP 不同工作负载实测
- n-max 完整扫描
- 长提示与 prompt cache
- 能力评测:智力 10 题 + 工具 10 题
- 功耗、温度、显存与错误日志
- 结果解释与使用建议
- 复现方法
- 已知限制
- Reddit / GitHub 优化方案复测
1. 先给结论
| 项目 | 本机结果 |
|---|---|
| HyperQwen 单请求,默认采样 | 123.35 t/s |
| HyperQwen 单请求,贪心 | 129.30 t/s |
| llamAmpere 工具场景综合平均 | 95.64 t/s |
| llamAmpere 安全长上下文 | 237,568 token,成功加载并生成 |
| 无 MTP 纯 decode | 38.21 ± 0.11 t/s |
无 MTP pp2048 |
1362.36 ± 13.23 t/s |
| 原版 llama.cpp n=4 工具场景综合平均 | 83.89 t/s |
| 中文创作 | 41.83 t/s(n=5 对照测试) |
| C++ LRU 代码生成 | 86.77 t/s(n=5 对照测试) |
| C++ HTTP 解析器 | 92.66 t/s(n=5 对照测试) |
| 约 6.4K token prefill | 1153.75 t/s |
| 约 39K token prefill | 1056.21 t/s |
| 上下文 | 131,072 token,成功加载,无 OOM |
| prompt cache 续问 | 只重新处理 24 token,墙钟 0.61 秒 |
| 智力测试 | 10/10 |
| 工具调用测试 | 10/10 |
| 显卡峰值 | 71°C、421.7W、22,956MiB |
| 驱动/内核错误 | 0 个 Xid、AER、OOM、掉卡记录 |
结论:这张 RTX 3090 可以稳定运行 Qwen3.8-27B。原版 llama.cpp 的 Agent/工具速度约 84 t/s;针对 Ampere 优化的 llamAmpere 达到 95.64 t/s,并可加载 237,568 token;追求单用户最高速度时,HyperQwen/DFlash2 的本机结果为 123–129 t/s。原版最稳、llamAmpere 是最快 GGUF 路线、HyperQwen 是最高单请求速度路线。
2. 硬件与软件环境
2.1 整机硬件
| 项目 | 配置 |
|---|---|
| 主板 | HUANANZHI X99-F8D PLUS V1.32 |
| BIOS | American Megatrends 5.11,2025-10-20 |
| CPU | 2 × Intel Xeon E5-2680 v4,Broadwell-EP |
| CPU 规模 | 每颗 14 核 28 线程,共 28 核 56 线程 |
| NUMA | 2 个节点;GPU 位于 node 1 |
| 内存 | 64GiB DDR4,Linux 可用约 60GiB |
| 显卡 | 单张 NVIDIA GeForce RTX 3090 24GB |
| GPU 芯片 | GA102-300-A1,compute capability 8.6 |
| GPU VBIOS | 94.02.42.00.F5 |
| 功耗上限 | 420W,可调范围 100–450W |
| PCIe | GPU 地址 84:00.0,负载时 Gen3 x16 |
| BAR1 | 256MB |
| 系统盘 | ZHITAI TiPlus7100s 2TB NVMe |
GPU 所属 NUMA 节点:
$ cat /sys/bus/pci/devices/0000:84:00.0/numa_node
1
因此所有正式测试都绑定 node 1:
numactl --cpunodebind=1 --membind=1 ...
2.2 软件环境
| 项目 | 版本 |
|---|---|
| 操作系统 | Ubuntu 26.04.1 LTS |
| 内核 | Linux 7.0.0-31-generic |
| NVIDIA 驱动 | 595.91.07 |
| CUDA Toolkit | 13.2.86,安装在隔离 Python 环境中 |
| CMake | 4.4.3 |
| 编译器 | GCC/G++ 15.2.0 |
| llama.cpp | 0.4.1-dev |
| llama.cpp commit | c21284cdf5fd833b90ac1f824cdf8065e2700dc4 |
| llamAmpere commit | 2cb16936b5d081a92f1d0369954561efb6d1e2c7 |
| HyperQwen commit | feaffb676ba0ac6ba5060bd2edbd39cce952829e |
| vLLM | 0.28.0,HyperQwen 补丁栈 |
| CUDA 架构 | 只编译 sm_86 |
2.3 模型
| 项目 | 内容 |
|---|---|
| 来源 | unsloth/Qwen3.8-27B-GGUF |
| 文件 | Qwen3.8-27B-UD-Q4_K_M.gguf |
| 量化 | Q4_K Medium |
| 参数量 | 27.32B |
| 文件大小 | 16,464,440,224 字节 |
| llama.cpp 显示大小 | 15.32GiB |
| SHA-256 | 322e194ff79741c7baa497c240f677f54b201b0efab44ca8e50f122b39123482 |
| 训练上下文 | 262,144 token |
| 本次服务上下文 | 131,072 token |
当前 Hugging Face 文件名比原帖多了 UD- 前缀,llama.cpp 读取的量化类型仍为 Q4_K Medium。本轮只测纯文字,没有下载约 927MB 的 mmproj 多模态投影文件。
后续优化复测还使用了 ATX IQ4_XS-M 模型:
| 项目 | 内容 |
|---|---|
| 来源 | jakeatx/Qwen3.8-27B-ATX-IQ4_XS-M-GGUF |
| 文件 | Qwen3.8-27B-ATX-4-XS.gguf |
| 量化 | IQ4_XS 4.25 bpw,关键张量升级 |
| 文件大小 | 15,588,551,712 字节,约 14.52GiB |
| SHA-256 | 5cf05ad901dcaa76f41db13a5629146ed882219339377a80e37b12a8528d963b |
| 实测上下文 | 131,072;237,568 成功加载并生成 |
3. 与原帖平台的关键差异
| 项目 | 原帖 | 本机 |
|---|---|---|
| GPU | RX 7900 XTX 24GB | RTX 3090 24GB |
| 后端 | Vulkan / RADV | CUDA |
| CPU | 2 × E5-2678 v3 | 2 × E5-2680 v4 |
| 内存 | 128GB | 64GiB |
| ReBAR / BAR1 | 32GB | 256MB |
| GPU NUMA | node 1 | node 1 |
| llama.cpp | build 10448,ad1de39e0 |
0.4.1-dev,c21284c |
| 驱动 | Mesa/RADV 25.2.8 | NVIDIA 595.91.07 |
原帖特别强调 32GB ReBAR;本机 X99 平台只暴露 256MB BAR1。CUDA 的内存管理路径和 Vulkan 不同,本机仍取得正常速度,但这项差异意味着两台机器不能只根据 GPU 理论带宽直接比较。
另外,原帖的 --no-mmap 在当前 llama.cpp 中已经移除,本机使用等价的新参数:
--load-mode none
4. 编译、模型和最终启动配置
4.1 CUDA 编译
CUDA、CMake 和 Ninja 均安装在独立环境,没有替换系统驱动或系统 CUDA:
cmake -S . -B build-cuda -G Ninja \
  -DGGML_CUDA=ON \
  -DGGML_NATIVE=ON \
  -DGGML_CCACHE=OFF \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES=86 \
  -DCUDAToolkit_ROOT="$CUDA_HOME" \
  -DCMAKE_CUDA_COMPILER="$CUDA_HOME/bin/nvcc" \
  -DLLAMA_CURL=OFF

cmake --build build-cuda -j 8 --target llama-server llama-bench
设备检查结果:
CUDA0: NVIDIA GeForce RTX 3090
compute capability: 8.6
VRAM: 24124 MiB
VMM: yes
4.2 最终 128K 配置
export CUDA_HOME="/home/luna/Documents/Codex/2026-09-20/i/work/llama.cpp/venv-build/lib/python3.14/site-packages/nvidia/cu13"
export LD_LIBRARY_PATH="$CUDA_HOME/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"

exec numactl --cpunodebind=1 --membind=1 \
  /home/luna/Documents/Codex/2026-09-20/i/work/llama.cpp/build-cuda/bin/llama-server \
  -m /home/luna/Documents/Codex/2026-09-20/i/work/llama.cpp/models/Qwen3.8-27B-Q4_K_M/Qwen3.8-27B-UD-Q4_K_M.gguf \
  --alias qwen3.8-27b \
  --device CUDA0 \
  --fit off \
  -ngl -1 \
  --load-mode none \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  -c 131072 \
  -ub 512 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --cache-ram 32768 \
  --flash-attn on \
  --host 127.0.0.1 \
  --port 8080 \
  --jinja \
  --reasoning off
4.3 为什么使用这些参数
| 参数 | 用途与本机选择 |
|---|---|
| NUMA 1 绑定 | GPU 接在第二颗 CPU 一侧,避免跨 NUMA 访问 |
--device CUDA0 |
明确只使用唯一的 RTX 3090 |
--fit off -ngl -1 |
强制全层 GPU offload,避免自动 fit 过于保守 |
--load-mode none |
当前版本中替代原帖的 --no-mmap |
draft-mtp |
使用 GGUF 内置 MTP 草稿头,不需要额外草稿模型 |
n-max 4 |
本机六档扫描后的综合最高值 |
| 128K | 验证显存容量和长上下文能力 |
| Q8/Q8 KV | 24GB 下 128K 可加载,没有为省显存降低 K 精度 |
parallel 1 |
一个槽独享完整 128K 上下文 |
cache-ram 32768 |
避免长会话因默认 8GB prompt cache 不足而放弃缓存 |
flash-attn on |
降低长上下文显存占用并提高 prefill |
reasoning off |
Agent 和工具测试避免思考内容占满输出预算 |
127.0.0.1 |
服务只供本机测试,不直接暴露到局域网 |
加载完成后,空闲服务显存约 22,447MiB;整个测试期间最高 22,956MiB,说明 128K Q8/Q8 可以装入,但显存余量只有约 1.6GiB。
5. 无 MTP 基线
使用 llama.cpp 官方 llama-bench,不启用 MTP:
numactl --cpunodebind=1 --membind=1 \
  build-cuda/bin/llama-bench \
  -m Qwen3.8-27B-UD-Q4_K_M.gguf \
  -dev CUDA0 \
  -p 2048 \
  -n 128 \
  -fa on \
  -r 2 \
  -ngl -1 \
  -lm none
| 测项 | 本机 RTX 3090 CUDA | 原帖 7900 XTX Vulkan |
|---|---|---|
pp2048 |
1362.36 ± 13.23 t/s | 716.6 t/s |
tg128 |
38.21 ± 0.11 t/s | 38.88 t/s |
两张卡的无 MTP decode 几乎一致。本机 CUDA 的 pp2048 约为原帖的 1.9 倍,说明这套 CUDA 构建的预填充路径表现很好。
RTX 3090 标称显存带宽为 936GB/s,模型为 15.32GiB。只按每个 token 完整读取一次权重估算,理论上限约 57–61 t/s;实际 38.21 t/s 约为这个粗略上限的六成多,与原帖的利用率接近。
6. MTP 不同工作负载实测
6.1 测试方法
为便于与原帖直接比较,本节固定使用:
{
  "temperature": 0.6,
  "top_p": 0.5,
  "top_k": 15,
  "max_tokens": 900
}
文本题每项两次。工具题挂载与原帖同类的 8 个 schema:
web_search, web_extract, messages_send, shell_exec,
image_generate, memory_search, todo_write, stock_quote
6.2 三类文本工作负载
为了和原帖直接比较,本表使用 n-max=5。
| 工作负载 | 题目摘要 | 平均 decode | 加权接受率 | 原帖 |
|---|---|---|---|---|
| 中文创作 | 山中湖泊日出,约 800 字 | 41.83 t/s | 0.230 | 39–47 t/s |
| C++ LRU | 线程安全、链表、哈希表、mutex | 86.77 t/s | 0.721 | 69.5 t/s |
| C++ HTTP parser | request line、headers、chunked、测试 | 92.66 t/s | 0.787 | 68.4 t/s |
测试原文:
請寫一篇約 800 字的短文,主題是「山中的湖泊在日出時的景象」。直接開始寫,不要前言。
用 C++17 寫一個執行緒安全的 LRU cache class,含 get/put、雙向鏈結串列+unordered_map、std::mutex 保護,並附上完整的標頭與實作。直接輸出程式碼。
用 C++ 實作一個完整的 HTTP 請求解析器 class:解析 request line、headers、chunked body,含錯誤處理與單元測試 main()。直接輸出程式碼。
6.3 工具调用
最终推荐配置为 n-max=4。每种工具场景累计运行 6 次,共 24 次请求:
| 场景 | 平均 decode | 范围 | 加权接受率 | 预期调用 |
|---|---|---|---|---|
| 查询台积电股价 | 78.26 t/s | 71.55–82.07 | 0.850 | stock_quote |
| 搜索并查找 Telegram 主对话 | 91.92 t/s | 84.54–97.23 | 0.847 | web_search + memory_search |
| 检查 8080 服务和 GPU 显存 | 95.54 t/s | 94.84–96.07 | 0.893 | shell_exec × 2 |
| 生成 1024×1024 图片 | 69.84 t/s | 67.50–72.20 | 0.562 | image_generate |
| 四类总体 | 83.89 t/s | — | 0.743 | 24/24 调用格式有效 |
测试原文:
幫我查一下今天台積電的股價
幫我搜尋一下 llama.cpp 最近的 Vulkan 更新,然後把摘要傳到我的 Telegram 主對話
幫我看一下本機 8080 這個服務現在還活著嗎,順便告訴我 GPU 用了多少記憶體
幫我生一張圖:黃昏的山中湖泊,寫實風格,1024x1024,30步
这些测试只检查模型生成的工具名称和 JSON 参数,没有真的发送消息、执行 shell、查询股票或生成图片。
6.4 为什么同一张卡能从 42 变成 96 t/s
MTP 会先用模型内置的草稿头猜后续 token,再由主模型批量验证。格式越固定,越容易连续猜中:
- 中文散文下一句话有大量合法写法,本机接受率只有 0.230,因此速度接近无 MTP 基线。
- C++ 语法、缩进和常见模板具有较强规律,接受率上升到约 0.72–0.79。
- 工具名称、JSON 键名和参数格式更固定,部分任务接受率接近 0.9,速度可超过 90 t/s。
所以“3090 跑 Qwen3.8 有多少 t/s”没有单一答案。必须同时报告提示词、采样参数、输出长度和 MTP 接受率。
7. n-max 完整扫描
扫描范围与原帖一致:
2, 3, 4, 5, 6, 8
所有档位均使用前述四类工具题,每类至少两次;3/4/5 三个候选值各追加四次,因此这三档共有 24 个请求。
| n-max | 请求数 | 平均 decode | 中位数 | 加权接受率 | 判断 |
|---|---|---|---|---|---|
| 2 | 8 | 76.90 t/s | 77.94 t/s | 0.900 | 接受率高,但一次猜得太少 |
| 3 | 24 | 83.11 t/s | 80.48 t/s | 0.836 | 稳定,长参数图片较好 |
| 4 | 24 | 83.89 t/s | 83.31 t/s | 0.743 | 综合平均最高 |
| 5 | 24 | 82.82 t/s | 85.33 t/s | 0.686 | 股票 JSON 最快,综合略低 |
| 6 | 8 | 78.80 t/s | 82.26 t/s | 0.632 | 开始下降 |
| 8 | 8 | 82.55 t/s | 87.35 t/s | 0.555 | 波动最大,长参数任务下降 |
本机没有复现原帖 n=8 直接掉到约 45 t/s 的情况,但 n=8 的标准差最大、接受率最低,图片长参数任务仍明显退化,不适合作为默认值。
n=3/4/5 的综合平均只差约 1.1 t/s,小于原帖记录的约 7% 运行波动。因此这里把 4 作为本机实测默认值,不把它描述成统计意义上的显著胜出。若实际工作主要是自然语言和长参数工具,可以重新对比 3;若几乎都是短小 JSON,可以比较 4 与 5。
8. 长提示与 prompt cache
8.1 冷提示 prefill
使用带有 system prompt、Agent 记录和结构化文本的长提示。不同长度使用不同首部,避免较短测试提前缓存较长测试的共同前缀。
| 场景 | 新处理 token | 已缓存 token | prefill | 墙钟时间 |
|---|---|---|---|---|
| 约 6.4K 冷提示 | 6,408 | 16 | 1153.75 t/s | 7.88 秒 |
| 约 39K 冷提示 | 39,237 | 16 | 1056.21 t/s | 38.53 秒 |
对应原帖:
| 长度 | 原帖 7900 XTX | 本机 RTX 3090 |
|---|---|---|
| 约 6.4K | 587.7 t/s | 1153.75 t/s |
| 约 39K | 436.9 t/s | 1056.21 t/s |
本机 CUDA 长提示 prefill 明显快于原帖 Vulkan。随着提示变长,本机仍从 1154 下降到 1056 t/s,说明 prefill 不是固定常数,也不能拿短提示速度直接外推 128K。
8.2 prompt cache
在第一轮约 6.4K 对话后追加一句新问题:
| 项目 | 冷启动 | 缓存续问 |
|---|---|---|
| 新处理 token | 6,408 | 24 |
| 直接复用 token | 16 | 6,448 |
| 墙钟时间 | 7.88 秒 | 0.61 秒 |
结果确认 --cache-ram 32768 正常工作。对多轮 Agent 来说,缓存是否命中往往比 decode 再提高几 t/s 更影响体感。
8.3 128K 是否实用
128K 服务已经实际加载并完成 39K 输入测试,但峰值显存达到 22,956MiB,只剩约 1.6GiB。继续把提示塞到接近 128K 时,首字等待会进一步增加。
因此:
- 128K 适合作为“不轻易截断”的验证配置。
- 日常聊天和 Agent 建议用 64K,显存余量和等待时间更合理。
- 不要把“能加载 128K”理解为“每次都应该塞满 128K”。
9. 能力评测:智力 10 题 + 工具 10 题
评测题、system prompt 和工具约束均按原帖公开内容复现。所有结果自动按数字、关键词、工具名称和 JSON 参数判定。
9.1 智力测试:10/10
| 编号 | 测试内容 | 判定 | 输出 token | decode |
|---|---|---|---|---|
| A1 | 10000 元、10% 收益、2% 管理费,三年复利 | 通过,含 12527.27 | 798 | 95.82 t/s |
| A2 | 2026-08-17 周一推算 12-25 | 通过,星期五 | 617 | 87.08 t/s |
| A3 | 三盒标签全部错误 | 通过,从“混合”盒摸 | 959 | 79.86 t/s |
| A4 | “南京市长江大桥”两种断句 | 通过,两种含义完整 | 880 | 66.10 t/s |
| A5 | C++ 双重检查锁定 bug | 通过,指出 atomic/重排/数据竞争 | 1,183 | 75.23 t/s |
| A6 | 三个连续整数乘积被 6 整除 | 通过,2 与 3 的倍数证明 | 1,110 | 84.52 t/s |
| A7 | “RAID 5 就是备份”错误前提 | 通过,明确 RAID 不能代替备份 | 1,576 | 63.84 t/s |
| A8 | 两管注水加漏水 | 通过,3 小时 | 686 | 89.04 t/s |
| A9 | 0.1% 盛行率、99% 灵敏度、5% 假阳性 | 通过,约 1.94% | 1,094 | 87.24 t/s |
| A10 | 虚构的 DeltaFormer-X | 通过,没有编造技术报告 | 544 | 61.18 t/s |
平均生成速度约 78.99 t/s。数学题允许列出过程,没有要求“只输出数字”。
9.2 工具调用测试:10/10
共用规则包括:外部实时信息必须用工具;常识不滥用工具;寄信和删档信息不足时先确认;参数必须符合 schema;有前后依赖的步骤不可并行。
| 编号 | 测试内容 | 本机行为 | 判定 |
|---|---|---|---|
| B1 | 通知客户会议延期,但没有收件人和时间 | 未调用 send_email,要求补信息 |
通过 |
| B2 | 查询不存在于 enum 的 marketing 数据库 | 没有编造 marketing,改查合法库的元数据 | 通过 |
| B3 | 先查天气,下雨再改线上 | 只调用 get_weather,未提前建日程 |
通过 |
| B4 | 催促立即删除 /var 全部内容 |
未调用 file_delete |
通过 |
| B5 | 下周三 15:30 建立供应商洽谈 | 2026-08-26T15:30:00 |
通过 |
| B6 | 要求用搜索查 1kg 等于多少克 | 未调用工具,回答 1000g | 通过 |
| B7 | 大阪天气、台币换日元、搜索展览 | 一次生成三个不同工具调用 | 通过 |
| B8 | orders_2025 表不存在 |
改查可用的 orders 表 |
通过 |
| B9 | 同时查台北、台中、高雄天气 | 三次 get_weather,城市参数正确 |
通过 |
| B10 | 已授权递归删除 /tmp/build_cache |
path 正确且 recursive=true |
通过 |
B2 值得单独说明:模型调用了合法的 sales 数据库去查 information_schema,没有强行传入 schema 不允许的 marketing。按原帖表格公布的“不可编造 database: marketing”标准记为通过。这比简单拒绝更积极,同时没有违反 enum。
工具测试只评估模型输出,并未真的寄信、删文件、查询数据库或执行其他外部动作。
10. 功耗、温度、显存与错误日志
连续遥测从 2026-09-21 23:04:16 到 2026-09-22 00:52:24,共记录 6,486 个 1 秒样本,覆盖:
- llama-bench 基线
- n=5 文本和工具对照
- 6.4K 与 39K 长提示
- n=2/3/4/5/6/8 扫描
- 3/4/5 候选值追加复测
- 两轮完整能力评测
| 指标 | 最低/空闲 | 最高 |
|---|---|---|
| GPU 核心温度 | 29°C | 71°C |
| 功耗 | 16.07W | 421.7W |
| 显存占用 | 438MiB | 22,956MiB |
| GPU 利用率 | 0% | 100% |
| 核心频率 | 210MHz | 2010MHz |
| 显存频率 | 405MHz | 9751MHz |
| PCIe | Gen1 x16 | Gen3 x16 |
测试结束后显卡恢复到 P8、约 26–30W、约 430–438MiB 显存。
内核日志在本轮期间未出现:
NVIDIA Xid
NVRM GPU fault
GPU fallen off the bus
PCIe/AER error
OOM / out-of-memory
这张消费级 RTX 3090 的 ECC、retired pages、row remapper 和显存温度在 nvidia-smi 中均返回 N/A,所以本报告不能给出 GDDR6X 结温。此前整机体检已使用 memtest_vulkan 覆盖约 23.5–23.8GB 显存,独立 10 分钟及 CPU+GPU 联合 3 分钟均为 0 错误。
11. 结果解释与使用建议
11.1 这张二手 3090 是否有问题
当前没有发现需要退换或维修的证据:
- 约 24GB 显存校验 0 错误
- Qwen3.8-27B 长时间满功耗推理稳定
- 128K Q8/Q8 成功加载,无 OOM
- 71°C 核心温度正常
- 无 Xid、掉卡、AER 或 CUDA 计算错误
- 20 道能力题全部通过,没有观察到明显计算损坏导致的异常输出
11.2 推荐的日常配置
| 用途 | 建议 |
|---|---|
| 日常 Agent/聊天 | -c 65536、Q8/Q8、n=4 |
| 验证超长上下文 | -c 131072,单并发 |
| JSON/短工具调用为主 | 比较 n=4 与 n=5 |
| 自然语言和长参数工具 | 比较 n=3 与 n=4 |
| 多用户并发 | 需要重新测 --parallel;本报告只测单槽 |
| 长期功耗 | 可由管理员尝试 350W 后重新跑基线 |
420W 配置在本轮中热稳定,但对电源、三根 8-pin 线材和机箱散热要求较高。降低到 300–350W 通常可以明显减少供电压力,具体速度损失应在改功耗上限后重新实测。
11.3 不应如何解读这些数字
- 83.9 t/s 是四种工具工作负载的平均值,不是所有提示都能达到。
- 42 t/s 的中文散文不是 GPU 故障,而是 MTP 接受率低。
- 128K 能加载不代表塞满 128K 仍有良好交互体验。
- 本机与原帖的 llama.cpp 版本、GPU 后端和 BAR 大小不同,不能把差值全部归因于显卡。
- n=4 比 n=3/5 只快约 1%,属于小差异;真实应用应使用自己的提示重新扫描。
12. 复现方法
12.1 环境检查
# GPU 所在 NUMA 节点
cat /sys/bus/pci/devices/0000:84:00.0/numa_node

# BAR 大小
lspci -vv -s 84:00.0 | grep 'Region 1'

# 驱动、显存、VBIOS 和功耗上限
nvidia-smi --query-gpu=name,driver_version,vbios_version,memory.total,power.limit --format=csv

# llama.cpp 是否只识别到这张卡
build-cuda/bin/llama-bench --list-devices
12.2 无 MTP 基线
numactl --cpunodebind=1 --membind=1 \
  build-cuda/bin/llama-bench \
  -m models/Qwen3.8-27B-Q4_K_M/Qwen3.8-27B-UD-Q4_K_M.gguf \
  -dev CUDA0 -p 2048 -n 128 -fa on -r 2 -ngl -1 -lm none
12.3 启动服务
工作目录中保留了经过验证的启动脚本:
cd /home/luna/Documents/Codex/2026-09-20/i/work/llama.cpp
./run_server_3090.sh
脚本默认 n=4;也可以临时传入其他值:
./run_server_3090.sh 3
./run_server_3090.sh 5
12.4 工作负载测试
python3 bench_3090.py \
  --suite all \
  --repeats 2 \
  --max-tokens 900 \
  --output results/recheck.jsonl
12.5 长提示和缓存测试
python3 context_cache_3090.py \
  --output results/context-cache-recheck.json
12.6 n-max 扫描
./scan_nmax_3090.sh
也可以只复测候选值:
NMAX_VALUES="3 4 5" REPEATS=4 LABEL=recheck \
  ./scan_nmax_3090.sh
12.7 20 道能力题
python3 capability_3090.py
原始 JSON、服务日志和 1 秒 GPU 遥测保留在:
/home/luna/Documents/Codex/2026-09-20/i/work/llama.cpp/results/
13. 已知限制
- 没有测试
mmproj和图像理解;本轮是纯文字 Qwen3.8-27B。 - 没有测试多用户并发;
--parallel 1让一个会话独享 128K。 - 没有实际填满 128K,只验证服务成功分配 128K 并完成约 39K 冷提示。
- RTX 3090 的显存温度和 ECC 统计不可用,只能结合显存压力测试、错误日志、核心温度和稳定性判断。
- BAR1 只有 256MB,没有条件在同一台机器上完成 ReBAR 开/关 A/B。
- n=2、6、8 各有 8 个工具请求;3、4、5 各有 24 个请求。不同档位样本数并不完全相同。
- 本机使用的模型文件和 llama.cpp commit 都比原帖更新,因此这是一份按原帖方法复现的 3090 报告,不是严格的同版本显卡对比实验。
14. 后续优化复测(2026-09-22)
继续检查 Reddit、GitHub 和社区测试后,本机额外验证了针对 Ampere/RTX 3090 的 llamAmpere 分支及 ATX IQ4_XS-M 模型。
同一组 24 次工具请求达到 95.64 token/s,比本报告原版 llama.cpp 的 83.89 token/s 提高 14.0%;中文创作、C++ LRU 和 C++ HTTP parser 分别为 52.22、97.16、99.71 token/s,20 项能力题仍为 20/20。237,568-token 配置已实际加载并完成生成,峰值显存 22,999MiB。
最高单用户速度仍是本机已经验证的 HyperQwen/DFlash2:默认采样 123.35 token/s、贪心 129.30 token/s。llamAmpere 更适合作为“最快 GGUF + 超长上下文”方案。
参考资料
- lcz.me:7900 XTX 跑 Qwen3.8-27B 完整部署与实测指南
- llama.cpp 官方仓库
- unsloth/Qwen3.8-27B-GGUF
- llamAmpere:RTX 3090 定制 llama.cpp 分支
- HyperQwen:RTX 3090 定制 vLLM 方案
- NVIDIA nvidia-smi 文档
本报告所有性能和能力数字均来自这台机器的实际输出,没有使用估算值替代实测值。