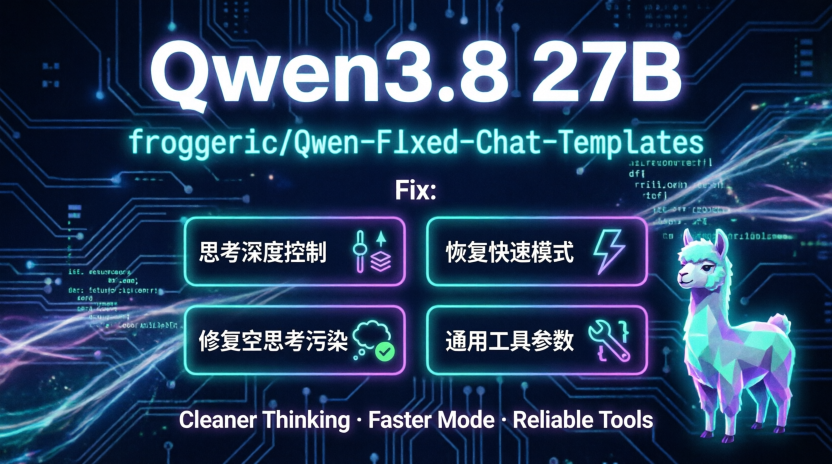
Qwen-Fixed-Chat-Templates
看了B站一个视频,引入 jinja chat templates 可以改善一些问题。
我没有深度使用测试,发个帖子,给不知道引入的同学做个参考。
 参考
【分享】改善Qwen3.8雷霆大思考
通过 froggeric/Qwen-Fixed-Chat-Templates 仓库的 v22 模板,设定不同思考模式来解决核心问题。
 仓库内容介绍
这是一个为 Qwen 3.5 / 3.6 / 3.8 打造的通用修复版聊天模板(chat template(聊天模板)= 提示词包装器,Jinja 格式,负责把对话历史 + 工具定义组织成模型能理解的格式)。
解决官方模板的 5 大问题(官方模板 = 模型发布时自带的原版模板):
| # |
修复项 |
官方模板的问题 → v22 的修复 |
| 1 |
 ️ 思考深度控制 · Reasoning Effort Steering |
官方 3.8 支持思考预算(xhigh 极深 / high 深 / medium 中 / low 浅),v22 默认注入 xhigh 指令,关思考时自动抑制 |
| 2 |
 恢复快速模式 · Fast Mode |
官方 3.8 传 enable_thinking=false(关闭思考)会直接崩溃!v22 解除此限制,可自由开关思考 |
| 3 |
🧹 修复空思考污染 · Empty Think Bug |
官方 3.8 多轮对话会插入空 </think> 块,v22 干净提取思考内容不重复 |
| 4 |
 通用工具参数 · Universal Tool Arguments |
官方 3.8 收到标准 OpenAI(接口规范)字符串参数会 TypeError 崩溃!v22 兼容字典和 JSON 字符串两种格式 |
| 5 |
🦙 llama.cpp 原生支持 |
支持 --reasoning-preserve 参数(保留思考、保证前缀缓存 100% 生效) |
 ️ 支持平台:LM Studio / llama.cpp / vLLM / MLX / KoboldCPP 等一切支持 Hugging Face 模板的引擎。仓库根目录只需一个
chat_template.jinja 文件,适用于所有 Qwen 3.5 / 3.6 / 3.8 模型。
引入示例
git clone https://huggingface.co/froggeric/Qwen-Fixed-Chat-Templates
启动参数:
#!/bin/bash
# Qwen3.8-27B 启动脚本 - TurboQuant MTP 版 (200K 上下文, 视觉 + 投机解码)
# 使用 llama-cpp-turboquant-mtp/ (最新 fork fca3093, 支持 draft-mtp)
# 不依赖旧 b9082 build (无法加载 MTP 版 GGUF)

SERVER="./llama-cpp-turboquant-mtp/build/bin/llama-server"
MODEL="./models/Qwen3.8-27B-Q3_K_M.gguf"
MMPROJ="./models/mmproj-BF16.gguf"
PORT=8080

export LD_LIBRARY_PATH="$(cd "$(dirname "$SERVER")" && pwd):/opt/cuda/lib64:$LD_LIBRARY_PATH"

CPU_THREADS=12
GPU_LAYERS=99
# CONTEXT_SIZE=131072
CONTEXT_SIZE=200000
BATCH_SIZE=512

echo "Starting Qwen3.8-27B (TurboQuant MTP) with 200K context..."
${SERVER} \
  -m "${MODEL}" \
  --mmproj "${MMPROJ}" \
  --chat-template-file ./Qwen-Fixed-Chat-Templates/chat_template.jinja \
  --reasoning-format deepseek \
  --reasoning-preserve \
  -c ${CONTEXT_SIZE} \
  -n -1 \
  -t ${CPU_THREADS} \
  -ngl ${GPU_LAYERS} \
  --parallel 1 \
  --cache-type-k turbo3 \
  --cache-type-v turbo3 \
  --flash-attn on \
  --load-mode mlock \
  --batch-size ${BATCH_SIZE} \
  --ubatch-size 512 \
  --reasoning-budget -1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 3 \
  --spec-draft-p-min 0.75 \
  --host 0.0.0.0 \
  --port ${PORT} \
  --log-disable \
  &
echo "Server started on http://localhost:${PORT}"
echo "MMPROJ vision enabled, MTP speculative decoding enabled"
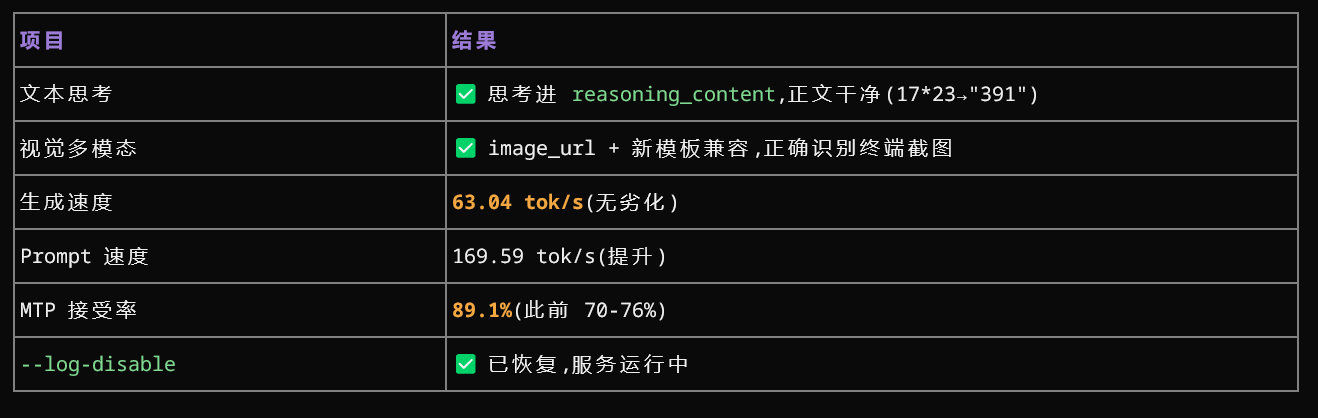
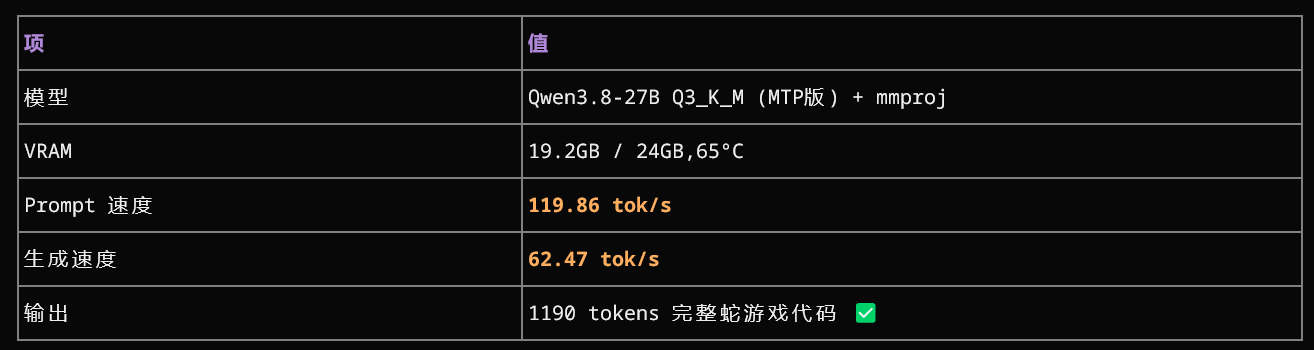
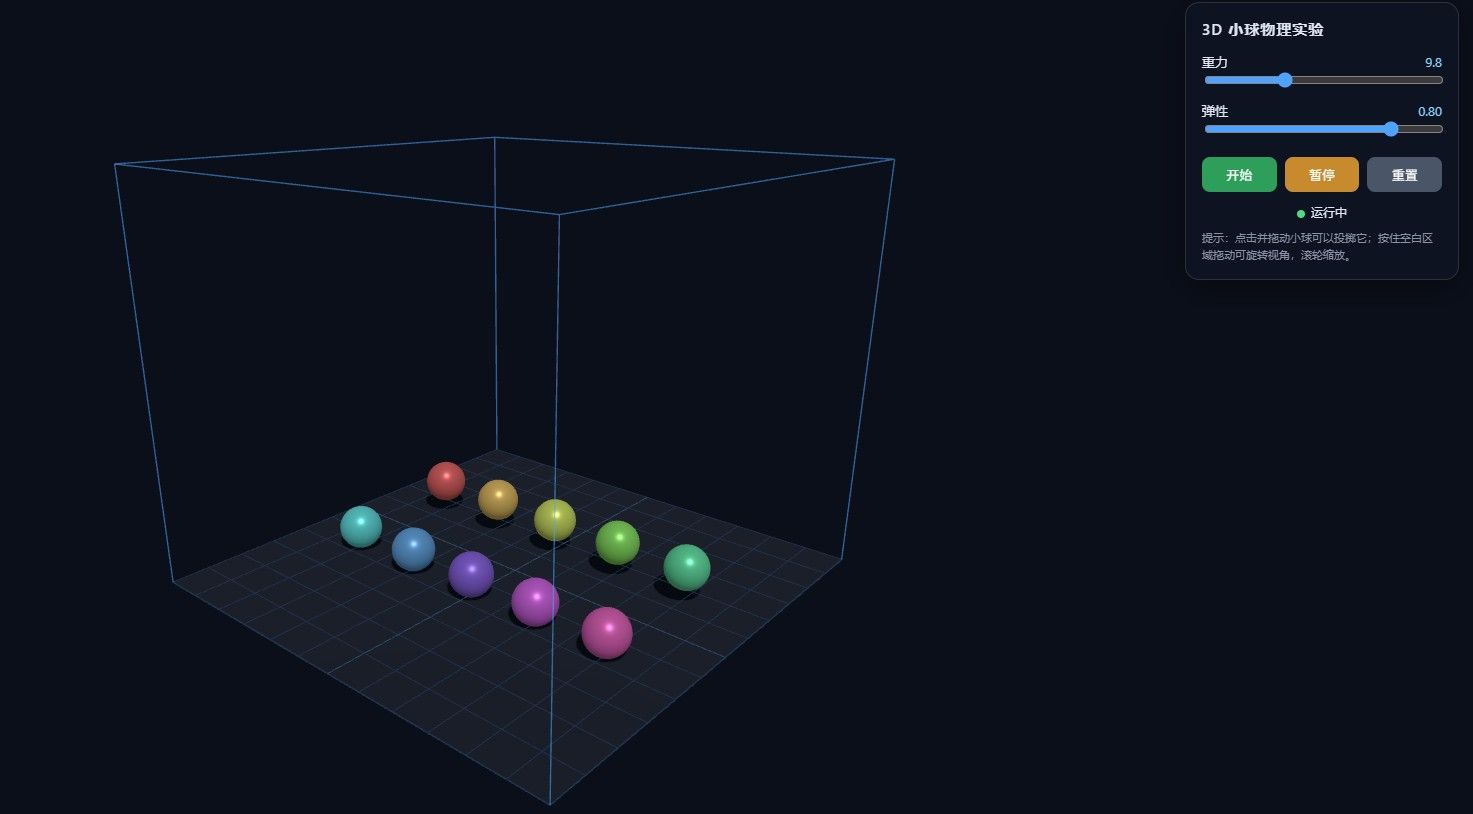
简单测试结果: