跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签 硬件 AI 广场
包磊包

包磊

@包磊
取消关注 关注
关于
帖子
23
主题
2
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • Qwen3.8-27B「思考深度档位」优化
    包磊包 包磊
    LLM讨论区 qwen-27b

    感谢!我先学,然后再让agent学。


  • 请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b

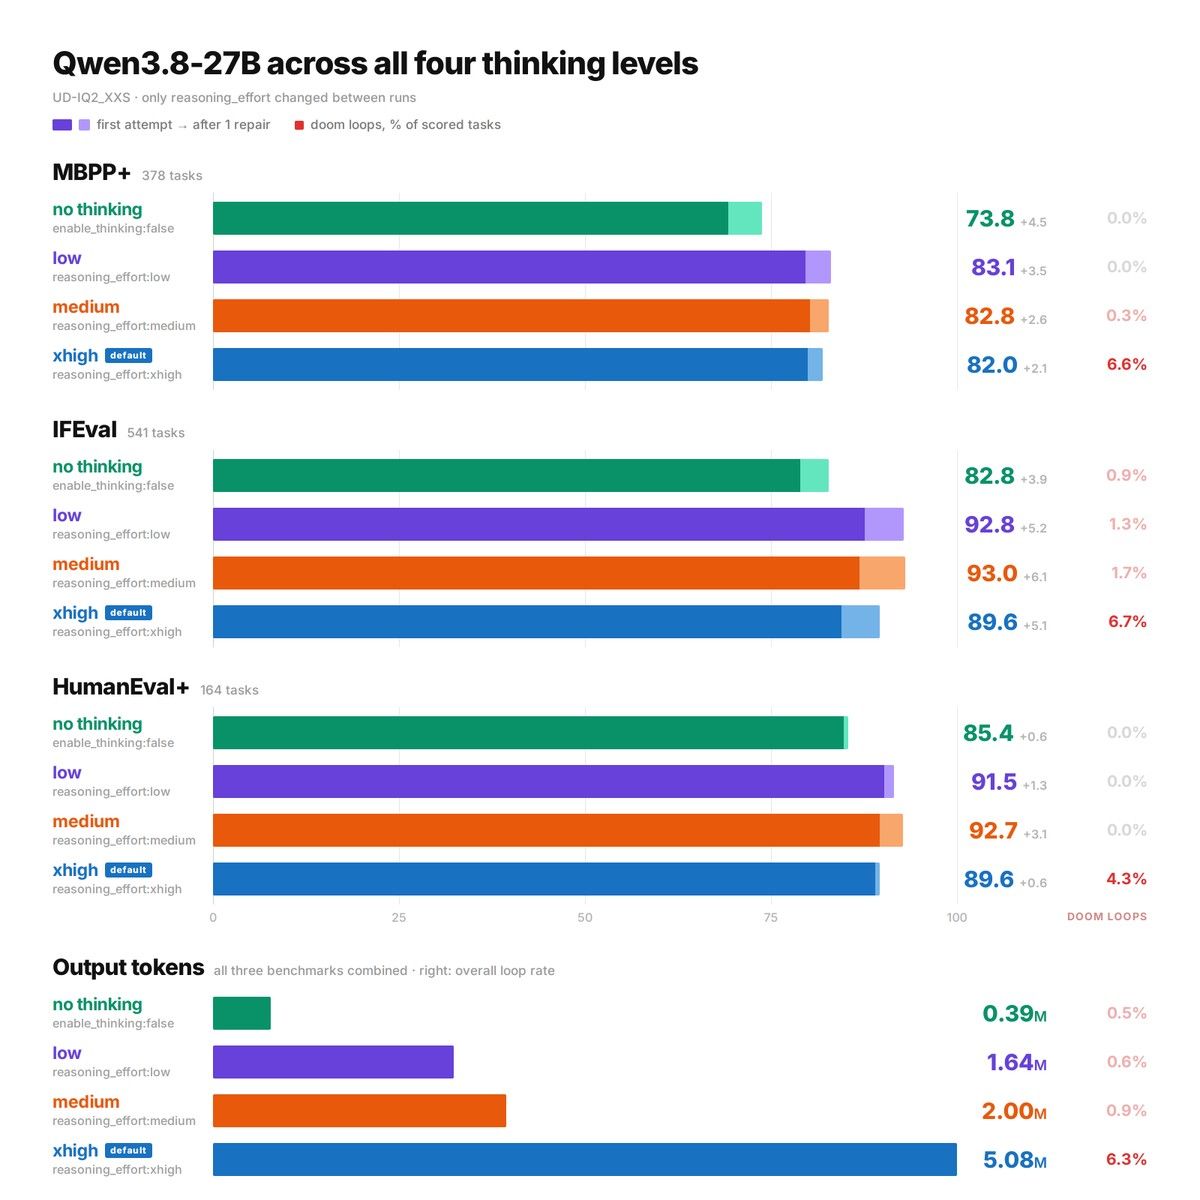
    昨晚用自己的以往真实业务测了一下,在检查文档业务需求和数据结构,代码切片不合理的地方时,发现开不开确实有差别,检出数能翻倍,速度影响也很明显,而且low 和 medium推理深度之间不光结果差别拉不开,推理时间也很不稳定,没有本质区别。xhigh 就他妈太费时间了,除非想搞评测跑分或者科学研究,谁会用 27B 搞科研,日常确实完全不用考虑


  • 请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b

    转一个@DogukanUrker的图,三种推理深度我实测通过,图的评测不是我做的不敢保证
    09519bac-cbf2-42e4-8fc5-04cd42cd54e4-image.jpeg


  • 请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b

    受教!非常详细,感谢!


  • 请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b

    收到,谢谢!那 API 的要开吗?比如 deepseek 系列


  • 请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b

    思考模式慢了好几倍,测了一些结果和关闭都差不多。让deepseek 做了一个qwen2.8-27b 的开启和关闭思考模式的对比测试,他说这类模型会的不用开,开了也没用,建议永远关着😰


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    我这里只有一台,deepseek 装上了,试了一下就停了,没法真的用。朋友那里有两台,在买线。过两天其他那里试试。


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    GDX 部署好了 SGLang+27B 了。Mamba size 要自己显式设定等于你的并发数*5,否者 SGLang 会限制你的并发数。SGLang 在部署27B 的时候竟然认不全所有共享内存。我把--mem-fraction-static 1.4 才把看 kVcache撑起来。这个具体数值可能要自己根据情况看。 Hermes 出了 0.20.0 版,a2a和框架通讯都获益,不需要 cron,不需要 codex cli。Hermes 调用CC switch 配置27B的 codex 做点个人小项目泡一晚上都很稳。@soop-ladios


  • SGLang运行Qwen3.6-27B-AWQ/FP8成功(双3080 20G)
    包磊包 包磊
    LLM讨论区 本地模型 qwen-27b sg-lang 量化

    这两天在 GDX 上折腾 SGLang 配 27B。还是有点坑的。默认 Mamba 开很大,不匹配你的并发数。认不全统一内存的总量,kvcache 被 Mamba 挤压。手动设置Mamba size 要注意 和并发数不是 1 :1。最后我把--mem-fraction-static 1.4 才勉强把 kvcache 撑起来。


  • Strix Halo本地部署 DeepSeek V4 Flash — 環境、失效、可行與技術總結
    包磊包 包磊
    LLM讨论区 deepseek

    一样非常关心这个问题


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    单纯解决问题Hermes 跑 DeepSeek 是最简单的。其实我大部分工作都是这么完成的。折腾的原因是因为现成有一台 DGX,不用起来觉得亏的慌。没上Qwen3.6:27b 的前面已经说了。空了去试试。现在用SGLang 跑 qwen3:coder-next-FP8感觉也还行。生命不息,折腾不止😄


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    @soop-ladios 昨天装个 codex,然后和他讨论一番。决定在 codex 复制我在 Hermes 上的工作流。需求端保留在 Hermes。全文档交换系统。Hermes 用codex-run 方式启动。然后 简单cron扫描交换区进行双向通讯。阻塞性事件微信通知人肉处理。跑了一个自动抓雪球 文章的并整理评级的小项目效果很好。对多 agent看板工作流控制比我在 Hermes 手工攒起来强多了。后台用的 DeepSeek false 还没接 DGX,可能也是特别顺的原因之一。下次转到本地模型的再试


  • deepseek v4 flash 出正式版0731了, 跑分超 v4pro预览版 和 glm5.2
    包磊包 包磊
    LLM讨论区 本地模型 deepseek glm mac

    没有多模态,我要在GDX可怜的显存里面再省出一块装vl模型,捉襟见肘啊


  • deepseek v4 flash 出正式版0731了, 跑分超 v4pro预览版 和 glm5.2
    包磊包 包磊
    LLM讨论区 本地模型 deepseek glm mac

    没提多模态啊,好像还是不支持


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    谢谢! soop ladios。你说的跨框架的方案我还完全没试过,有机会去尝试一下。MTP我实测过Gemma4 31b,提升巨大。但到5对短任务,单toolcall就有点反作用了。


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    谢谢! soop ladios你的分享,我会去你的那里学习取经。我一直在用Hermes agent,也碰到好多问题,这两天参考Pi项目也改进了hermes的hook


  • 为什么有人会喜欢骂AI?
    包磊包 包磊
    LLM讨论区 本地模型

    我不骂,我只是问他:你的上下文怎么变一个比特了


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    谢谢!xiaote 。昨天还写了个文档给架构agent要求开卡的body的颗粒度要细,每张卡片之间要加物理闸门,不通过不能自己结束。总之还在和agent们搏斗


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    我是有搞架构的agent做好方案,强调垂直切片,然后p0-pn,中间有coding+检测+架构自检+需求检查。然后有自动cron巡视处理阻塞。多profile协同


  • 一直没找到在DGX上能完全满意的一套模型配置
    包磊包 包磊
    LLM讨论区 本地模型 服务器

    莽撞了,最近一直用qwen系列,kvcache很紧张。agent告诉我deepseek的MLA/DSA高压缩率对比qwen,kvcache可以少用一半显存。如果是真的16G系统+80G权重,还有30G不到,还可以搞一下试试

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组