@terry 代码已上传在#11楼,agent可以照着部署。
-
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享 -
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享minimax-h3-tp2-lab-code-20261101-3fef547.tar.gz 项目代码已上传,可以据此让agent部署。代码是pi agent使用 deepseek v4.1 flash 1017开发。
-
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享 -
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享 -
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享双 2080 Ti(22G)跑 MiniMax-H3 张量并行
首先感谢原帖
这套东西能跑起来,全靠 《两张 7900 跑 MiniMax-H3 张量并行:每步 18.6 s → 8.3 s,每卡省 10 GiB》 这个帖子的开路。原帖第 18 楼的代码(
tp/core.py、tp/tp_boot.py、tp/tp_linear.py、start_tp2.sh)提供了完整的思路骨架,第 26 楼那张覆盖 832×480 到 1920×1088×362 的跑分表给了我们一个可以逐档对照的标尺。没有这些,下面的东西不存在。原帖是 2×W7900(48G、gfx1100、PCIe 4.0 x8 上行桥)。我们手上没有 48G 的卡,只有两张 22G 的 2080 Ti(sm_75、NV2 双 NVLink)。硬件代差整整三代,但最后在帖子自己发布的测试条件下跑到了同一水平线,中间靠的不是更聪明的算法,而是几处能不能把已经存在的内核真正用起来的差别。写出来给同核心、同显存的锤友做个参考。
一句话结论
832×480/124 帧/8 步:108.7 s(原帖 128 s),每步 8.21 s(原帖 7.68 s)。
1600×896/124 帧/8 步:462.5 s(原帖 472 s),每步 45.49 s(原帖 46.9 s)。到 1600×896 我们反超。再往上 1920×1088 我们这两张 22G 卡装不下(1600×896 已用到 96.5% 显存),所以就此打住——这跟论坛里说"24G 单卡的上限大概在 1600×896"是一致的。
一、测试环境
硬件
项 规格 GPU 2 × RTX 2080 Ti 22 GB(改装版,22528 MiB),sm_75 GPU 互联 NV2 = 2 条 NVLink 绑定,单条 25.781 GB/s CPU Intel Xeon E5-2696 v4,22 核 44 线程 内存 64 GB 驱动 595.84 软件
项 版本 系统 Ubuntu 24.04.4 LTS,内核 7.0.0-30 Python 3.12.3 PyTorch 2.14.1+cu130(CUDA 13.0) ComfyUI 0.43.0(commit 7c4390a)ComfyUI-INT8-Fast commit 48a88b2,未做任何修改comfy-kitchen 0.2.40 comfy-aimdo 0.6.0 Triton 3.8(见下文:在 sm_75 上跑不了 INT8 dot) 模型
用途 文件 DiT minimax_h3_fl2va_pruned_int8_convrot.safetensors(int8,per-output-row weight scale + Hadamard convrot group 256)文本编码 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors视频 VAE minimax_h3_video_vae_fp16.safetensors音频 VAE minimax_h3_audio_vae_fp32.safetensors测试方法
- 同一份工作流,先后提交到两个 ComfyUI 实例(rank0/rank1),一次只跑一个任务
- 启动参数:
--disable-async-offload --cache-none --use-ck-attention - 832×480 / 124 帧 / 24 fps / 8 步(
res_multistep+simple,denoise 1.0)/ seed 145 - "每步"取进度条的稳态值;"单镜耗时"取提交到两个 rank 都出片的墙钟时间(含加载、文本编码、VAE 解码、音频编解码)
- 显存按 0.5 s 间隔采样
nvidia-smi,取全程峰值
二、方案长什么样
2.1 拓扑
┌──────────────────────┐ 同一份工作流 ───▶ │ rank0(只看得到 GPU0)│ ─┐ └──────────────────────┘ │ NCCL 集合通信 ┌──────────────────────┐ │ (NV2 NVLink) ───▶│ rank1(只看得到 GPU1)│ ─┘ └──────────────────────┘- 两个独立的 ComfyUI 进程,各自
CUDA_VISIBLE_DEVICES只暴露一张卡 - 每个进程的本地 device 恒为 0,这样 ComfyUI 主线程怎么设 current device 都不会和另一个 rank 撞同一张卡
- 两个进程用 NCCL 的一个 2-rank world,
MASTER_ADDR=127.0.0.1 - 工作流必须同时提交给两个 rank,DiT 里的
all_reduce天然把它们锁在一起
2.2 切分方式(Megatron 式 TP)
只切 DiT,文本编码器 / VAE / final_layer 都不参与并行(残差流是复制的、不切)。
层 原形状 每卡形状 切法 通信 qkv_proj[21504, 5376] [10752, 5376] 列并行(56 头 → 每卡 28 头) 无 out_proj[5376, 7168] [5376, 3584] 行并行(K 轴切半) 1 次 all_reduce mlp.fc1[28672, 5376] [14336, 5376] 列并行(gate/up 各切一半) 无 mlp.fc2[5376, 14336] [5376, 7168] 行并行(K 轴切半) 1 次 all_reduce 每个 block 2 次 all_reduce,50 个 block 共 100 次/步。
关键技巧:在 state_dict 层切,不去改 ComfyUI 的模型代码。 切完
qkv_proj行数从 21504 变成 10752,ComfyUI 会自己从张量形状推出heads=28、ffn=7168,模型照半宽构造,不需要改一行源码,也避开了"先把 20G 全量读进来再切"的显存峰值。同样处理
token_refiner的 2 个 bf16 block(它们的 qkv/fc1/fc2 形状和主 block 一致,会被同一套规则覆盖),并在加载时断言它们确实切到了 28 头——否则会静默地只切一半、然后对全宽结果多做一次 all_reduce,输出全错但不报错。2.3 每个 rank 都跑自己的一份完整流程
两个 rank 各自加载一半的 DiT 权重、各自的文本编码器、各自解码 VAE。看起来浪费,但它们并行执行,重复劳动被完全重叠掉了——实测两 rank 的
Prompt executed相差 0.16%(333.29 s vs 333.81 s),所以合并 rank1 的文本编码对墙钟时间没有意义。2.4 音频
H3 的 DiT
forward返回的是[-video_out, -audio_out]一个嵌套 latent,采样器会把它整个带下去,VAEDecodeAudio用samples["samples"].unbind()[-1]取音频。音频一直在算,缺的只是工作流里没接那条线:加一个音频 VAE 加载 +VAEDecodeAudio,再把CreateVideo的audio输入接上即可。实测音轨 32 kHz、时长与视频完全一致(5.167 s vs 5.167 s),100 ms 窗口 RMS 在 0.0025–0.0175 之间波动(有动态内容,不是静音)。
三、代码是什么样子的
3.1 文件清单
$LAB/ ├── nodes/ │ ├── TP2Lab/__init__.py (337 行) 张量并行钩子 │ ├── TP2FastOps/__init__.py (280 行) int8 内核选择 / 注意力后端 / profiler │ └── TP2Profiler/__init__.py ( 20 行) ComfyUI 事件时序记录 ├── tp2/slicing.py ( 24 行) state_dict 切分(与后端无关) ├── tools/ │ ├── arm.sh ( 85 行) 一次跑臂:起服务→提交→收产物→停服务 │ ├── add_audio.py ( 37 行) 给工作流补音频分支 │ └── record-env.sh 生成 env.lock(记录每次读数属于哪棵树) ├── start-tp2.sh ( 21 行) 起两个 rank ├── start-comfy-cu130.sh ( 20 行) 单实例启动 + 默认开关 └── benchmarks/ 工作流与全部测量结果nodes/*以符号链接挂进<ComfyUI>/custom_nodes/,这样源码留在自己的仓库里、ComfyUI 保持干净(上游三个仓库一行没改)。3.2 权重切分
# tp2/slicing.py —— 在模型构造之前切 state_dict
def slice_state_dict(sd, rank, hidden=5376, heads=56, head_dim=128, ffn=14336):
    inner = heads * head_dim                       # 7168
    key = "blocks.0.attn.qkv_proj.weight"
    if key not in sd or tuple(sd[key].shape) != (3 * inner, hidden):
        raise ValueError("unexpected or already sliced checkpoint")

    half = inner // 2
    lo = rank * half
    inds = torch.arange(lo, lo + half)
    qidx = torch.cat([inds, inds + inner, inds + 2 * inner])   # q/k/v 三段各取本 rank 的头
    flo = rank * (ffn // 2)
    gidx = torch.cat([torch.arange(flo, flo + ffn // 2),
                      torch.arange(ffn + flo, ffn + flo + ffn // 2)])  # gate | up

    for k in list(sd):
        t = sd[k]
        if k.endswith(".attn.qkv_proj.weight") and tuple(t.shape) == (3 * inner, hidden):
            sd[k] = t[qidx].contiguous()
        elif k.endswith(".attn.out_proj.weight") and tuple(t.shape) == (hidden, inner):
            sd[k] = t[:, lo:lo + half].contiguous()
        elif k.endswith(".mlp.fc1.weight") and tuple(t.shape) == (2 * ffn, hidden):
            sd[k] = t[gidx].contiguous()
        elif k.endswith(".mlp.fc2.weight") and tuple(t.shape) == (hidden, ffn):
            sd[k] = t[:, flo:flo + ffn // 2].contiguous()
    return counts   # 还会断言四类投影数量一致,切漏了就抛
3.3 行并行层的前向(技术特色之一,见第四节)
# nodes/TP2Lab/__init__.py —— 行并行 int8 层:融合内核 + 一次归约
def quant_gemm(x, w, ws, bias, dtype):
    if bias is not None:
        raise RuntimeError("TP2 row bias unsupported")
    if x.ndim != 2:
        raise RuntimeError("TP2 row parallel expects 2D activations, got %s" % (tuple(x.shape),))

    # 一次 comfy_kitchen 融合调用完成 量化 + INT8 GEMM + 反量化
    out = _ck.int8_linear(x, w, ws.reshape(-1), None,
                          out_dtype=torch.float32, convrot=False)
    # 部分和在 fp32 下相加;每个 rank 用自己的量化 scale,
    # 只要在归约之前乘回去,和就是精确的
    dist.all_reduce(out, op=dist.ReduceOp.SUM)
    return out.to(dtype)
3.4 block 前向:归约下移到层内
def block_forward(self, x, t_emb, mod_segments, rope_freqs,
                  transformer_options={}, attention=None):
    att = self.attn if attention is None else attention
    sm, sc, gm, sf, sfc, gf = self.adaln_proj(t_emb)
    h = model._mod_scale_shift(self.norm1(x), sm, sc, mod_segments)
    a = att(h, rope_freqs=rope_freqs, transformer_options=transformer_options)
    # out_proj 内部已经做完了 all_reduce,这里不再重复
    if a.dtype != x.dtype:
        a = a.to(x.dtype)
    x = model._mod_gate(x, gm, a, mod_segments)
    h = model._mod_scale_shift(self.norm2(x), sf, sfc, mod_segments)
    m = self.mlp(h)                      # fc2 内部同样已经归约
    if m.dtype != x.dtype:
        m = m.to(x.dtype)
    return model._mod_gate(x, gf, m, mod_segments)
3.5 角色标记 + fail-closed 分派
整张网里所有 int8 线性都被打上"是不是行并行"的标记,内核入口按标记决定走哪条路。在 DiT forward 内部碰到一个没有标记的 int8 线性就直接抛异常——那意味着有某条融合路径绕过了归约,静默继续会得到一个全错但不报错的结果。
def wrapper(x, w, ws, bias, dtype, _original=original):
    cur = getattr(ctx, "tp_cur", None)          # True=行并行, False=列并行, None=无标记
    if cur is True:
        return quant_gemm(x, w, ws, bias, dtype)
    if cur is False:
        return _original(x, w, ws, bias, dtype)
    if getattr(ctx, "in_model", False):
        raise RuntimeError("int8 linear reached the kernel from inside the DiT forward "
                           "without a role tag; a fused path bypassed the row-parallel "
                           "reduction. Refusing to continue.")
    return _original(x, w, ws, bias, dtype)     # 文本编码器等 DiT 之外的 int8 层
3.6 启动
# start-tp2.sh —— rank1 先起,它会 block 在 init_process_group 等 rank0
TP2_RANK=1 CUDA_VISIBLE_DEVICES=1 MASTER_ADDR=127.0.0.1 MASTER_PORT=29675 \
  ./start-comfy-cu130.sh --listen 127.0.0.1 --port 18183 \
  --disable-async-offload --cache-none --output-directory $OUT/rank1
sleep 3
TP2_RANK=0 CUDA_VISIBLE_DEVICES=0 MASTER_ADDR=127.0.0.1 MASTER_PORT=29675 \
  ./start-comfy-cu130.sh --listen 127.0.0.1 --port 18182 \
  --disable-async-offload --cache-none --output-directory $OUT/rank0
# start-comfy-cu130.sh —— 默认开关都在这里 export TP2_INT8_KERNEL="${TP2_INT8_KERNEL:-kitchen}" export TP2_ROW_FUSED="${TP2_ROW_FUSED:-1}" case "${TP2_ATTN_BACKEND:-ck}" in ck) EXTRA_ATTN=(--use-ck-attention) ;; sdpa) EXTRA_ATTN=() ;; esac exec "$PY" main.py --listen 127.0.0.1 --port "${COMFY_PORT:-18181}" \ --disable-auto-launch "$@" ${EXTRA_ATTN[@]+"${EXTRA_ATTN[@]}"}
四、两个真正提速的改动(技术特色)
这两处是整条链路上唯一显著的性能来源,其余改动都是正确性的。两处都不是自己写内核,而是把已经装在环境里、但默认没被用上的东西真正接上。
特色 1:把注意力切到 Comfy Kitchen 的 INT8 实现 —— attention 快 3.47×
发现过程:一开始我们一直跑的是 PyTorch SDPA,日志每行都写
Using pytorch attention,跑了二十多次没人质疑。直到对着帖子发布的跑分表核对时才注意到:原帖那张表是--use-ck-attention跑出来的,而我们压根没开。为什么差别巨大:832×480/124 帧时序列长度 S ≈ 14882 token(注意这里包含音频 token,音频占 19% 却因为 O(S²) 吃掉 34% 的注意力时间)。在 sm_75 上,PyTorch 的 fp16 SDPA 走的是
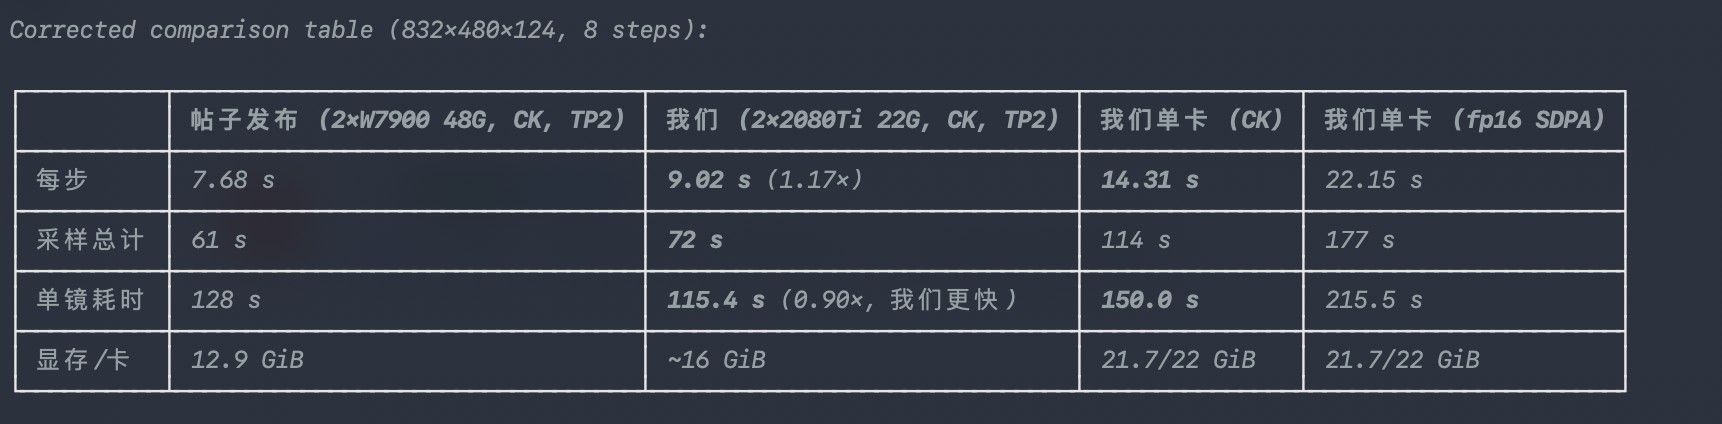
fmha_cutlassF_f16_aligned_32x128_rf_sm75,实测 6.1 TFLOPS(fp32)/ 28.0 TFLOPS(fp16),一步要 11.72 s;而 Comfy Kitchen 的 INT8 注意力qk_int_sv_i8_attn_kernel只要 3.38 s。单卡,832×480×124 每步 单镜耗时 fp32 注意力(PyTorch math 路径) 69.98 s 595.1 s fp16 注意力(SDPA tensor core) 22.15 s 215.5 s CK INT8 注意力 14.31 s 150.0 s 一个坑:
comfy_kitchen.int8_attention_is_available(device)返回 True,但registry.get_implementation("int8_attention")报 "No backend available"。前者只查符号存在,这个探针不可信;实际调用走torch.ops,是可用的。别因为 registry 报错就以为不能用。# 就这么简单,一个启动参数 python main.py --use-ck-attention ...特色 2:行并行层换成融合内核 —— 每步再省 10.7%,同时砍掉 100 次集合通信
改之前:行并行层是手写的一条 prologue——先把激活 upcast 到 fp32,求 per-row 的
amax,跨卡all_reduce(MAX)得到共享 scale,再div/round/clamp/to(int8),然后torch._int_mm,最后acc.float() * scale * ws。这条链每一层要好几次全量 HBM 往返,而且每层一次all_reduce(MAX),一步就是 100 次额外集合通信。改之后:一次
comfy_kitchen.int8_linear(量化 + INT8 GEMM + 反量化在同一个内核里),然后一次all_reduce(SUM)。这里有个理论上的关键认识:原帖强调"行并行必须跨卡共享激活 scale",否则每层约 1% 误差。这个结论在精度上是对的,但它不是正确性要求——只要每个 rank 在
all_reduce之前就用自己的 scale 把自己的部分和乘回去,求和的数学结果是精确的。所以我们放掉了共享 scale,换来一个完整内核,代价是量化网格和单卡不再逐点对齐(PSNR 15.23 dB 的差异,和这套管线上其他任何数值改动的量级一致)。TP2,640×384×39 每步 fp16 注意力 + 手写 prologue 2.41 s/it CK 注意力 + 手写 prologue 1.49 s/it CK 注意力 + 融合行并行 1.33 s/it 832×480×124 TP2 上:9.02 s/步 → 8.21 s/步,115.4 s → 108.7 s。
另有一处被证伪的同类尝试(写出来省得大家重复踩):把 convrot 的 Hadamard 旋转从"独立 fp32 matmul"折进 GEMM 的 prologue。数值上验证过两者是同一个 Regular-Hadamard 约定(相对误差 2.25e-4,用标准 Sylvester 做对照差 127.7),profile 里那个独立的
volta_sgemm也确实消失了——但总时间 2.41 vs 2.39 s/it,净收益为零,因为 in-kernel 旋转本身要花掉等量的钱。默认关闭。
五、其余几处必要但不出速度的实现细节
- Triton 在 sm_75 上跑不了 INT8 dot。 INT8-Fast 的 Triton 融合内核会编译失败(
TritonGPUAccelerateMatmulpass 在target=cuda:75上直接 fail),所以它退化成 PyTorch fallback 路径。我们用comfy_kitchen.int8_linear顶上(实测比 fallback 快 1.5–2.0 倍,fp32 输入下数值差 1.8e-4),并且是两臂都换——单卡和 TP2 必须同一个内核,否则对照是假的。 torch._scaled_mm在 sm_75 上不可用(要求 cc ≥ 8.9)。- bf16 在 Turing 上是死路:没有 bf16 张量核,实测比 fp32 慢 23%;而且 sm_75 上没有 bf16 的 flash 内核,PyTorch 会退化成 materialize S×S 矩阵,S=12732 时要 33.8 GiB,直接 OOM。
- fp16 全局精度会溢出:int8 层的反量化输出会超出 fp16 的 65504 上限变成 inf,然后整条链变 NaN、出纯黑视频。逐层探针定位到第一个非有限值就出现在某个主 block 的
out_proj输出上。所以残差流保持 fp32,只把注意力降到低精度——这也是特色 1 只改注意力的原因。 - rank0 的输入广播给 rank1:
x/timestep/context/denoise_mask每次求值前 broadcast,文本 embedding 也 broadcast 一次,保证两个 rank 从同一点出发。 --cache-none是隐含的正确性依赖,不只是为了测量干净:两个 rank 的节点缓存状态若不对称,集合通信的次数就会错位,直接死锁。- 同步验证:两个 rank 产出的 mp4 SHA256 逐位相同,这一步比任何日志都能证明锁步、通信、拼接没出错。三档尺寸全部通过。
六、测试结果
6.1 我们自己的三档(TP2,8 步,带音频)
分辨率 帧数 每步 单镜耗时 显存/卡 占 22G 832×480 124 8.21 s 108.7 s 16,456 MiB 73.0% 1344×768 124 28.01 s 299.1 s 19,244 MiB 85.4% 1600×896 124 45.49 s 462.5 s 21,732 MiB 96.5% 三档全部:两 rank 输出逐位相同;音轨 32 kHz、时长与视频严格一致。
1600×896 就是这张卡的顶。 96.5% 显存,再上一档 1920×1088 必然 OOM,所以没有测。
6.2 与原帖跑分对比
原帖数据取自 topic/2643 第 26 楼(2×W7900 48G,TP=2,PDD 8 步,
--use-ck-attention):分辨率 帧数 原帖每步 我们每步 每步比值 原帖单镜 我们单镜 单镜比值 832×480 124 7.68 s 8.21 s 1.07× 慢 128 s 108.7 s 0.85× 1344×768 124 28.3 s 28.01 s 0.99× 297 s 299.1 s 1.01× 1344×768 175 46.6 s 未测 — 466 s — — 1600×896 124 46.9 s 45.49 s 0.97×(快) 472 s 462.5 s 0.98× 1920×1088 124 86.7 s 显存不足 — 835 s — — 1920×1088 362 534.9 s 显存不足 — 76 min — — 单卡 832×480×124 作为参考:我们 CK 版 14.31 s/步,原帖 CK 单卡 12.8 s/步(1.12×)。原帖 SDPA 单卡是 18.6 s/步。
6.3 怎么读这张表
- 差距随画面变大而消失,甚至在 1600×896 反超。 小尺寸慢 7%,中大尺寸打平到略快。原因很直接:两边现在跑的是同一套内核家族(CK INT8 注意力 + 融合 INT8 线性),token 量大时每步被"两边做同样的活"主导,剩下的差别只是固定开销。
- 端到端反而更占优,因为我们的文本编码器是 nvfp4/AWQ 量化版、VAE 是 fp16,加载和编解码开销更小。832×480 那一档端到端快 15%。
- 原帖"采样总计"那一列和"稳态每步"对不上(例如 1344×768:170 s ÷ 8 = 21.25 s,而每步标 28.3 s)。所以上面只比"每步"和"单镜耗时"这两个自洽的量,没有用采样总计。
- 我们的"单镜耗时"包含音频解码 + 编码,原帖那批数据没说明是否含音频,所以这栏如果严格对齐我们略微吃亏。
七、局限与没做的事
- 只有 2 卡、只支持 world=2,代码里写死了;H3 的形状也写死了(hidden 5376、56 头 ×128、ffn 14336)。
- 不支持 LoRA、不支持 bias,遇到会直接抛异常而不是静默降级。
- 两个实例必须同时提交同一份工作流,否则会阻塞;不要暴露到公网。
- VRAM 是硬墙:22G 卡到 1600×896 为止。这一档和论坛里"24G 卡上限在 1600×896"的说法一致。
- 1920×1088 及以上没测(显存不足),1344×768×175 没测(时间关系)。
- 两卡都是改装 22G,这一条和原帖的官方 48G 卡不可比,只能说在同样 8 步、同样分辨率、同样 checkpoint 下达到了同一量级。
八、踩过的坑(供同好省时间)
Using pytorch attention这一行值得每天看一遍——我们用错了很久才发现。comfy_kitchen.int8_attention_is_available()会撒谎,registry 也会撒谎,以实际跑通为准。- ComfyUI 用绝对路径当模块名注册 custom node(
module_path.replace(".", "_x_")),所以importlib.import_module("ComfyUI-INT8-Fast.int8_quant")拿到的是另一个模块对象,补丁打上去无效。要扫sys.modules找真正被加载的那份。 use_triton会被加载器每次 load 时重新置 True,运行时改类属性没用,得关模块级的_TRITON_AVAILABLE。- 想知道时间花在哪,别推算,上 profiler。我们靠
torch.profiler否掉了自己三个"看起来很美"的估算(其中一个是把序列长度估小了 18%,而 attention 是 O(S²),直接把 39% 的误差算成了"可优化空间")。 - 这套管线完全确定:同内核同 seed 跑两次逐位相同。这很有用——任何画面差异都可以放心归因到改动本身,不必怀疑噪声。
九、结语
再次感谢原帖。这条链路从接手时的 22.15 s/步(832×480,TP2)走到 8.21 s/步,2.7 倍,但归因很清楚:
- CK INT8 注意力:3.47× 的 attention,整轮最大
- 行并行融合内核:再 10.7%
- 音频:一个从未被解码的分支接线问题,不算优化
- 我自己拍脑袋估的四个"优化"(异步重叠气泡、convrot 折进内核、残差流融合、H2D 缓存)实测全部归零
写这篇的目的不是证明老卡多能打,而是想说:很多时候瓶颈不在"你能不能写出更好的内核",而在"你有没有发现环境里那个更好的内核压根没被调用"。希望这个记录能给同在老硬件上折腾的朋友省几个晚上。
================11-01 13:00更新==================
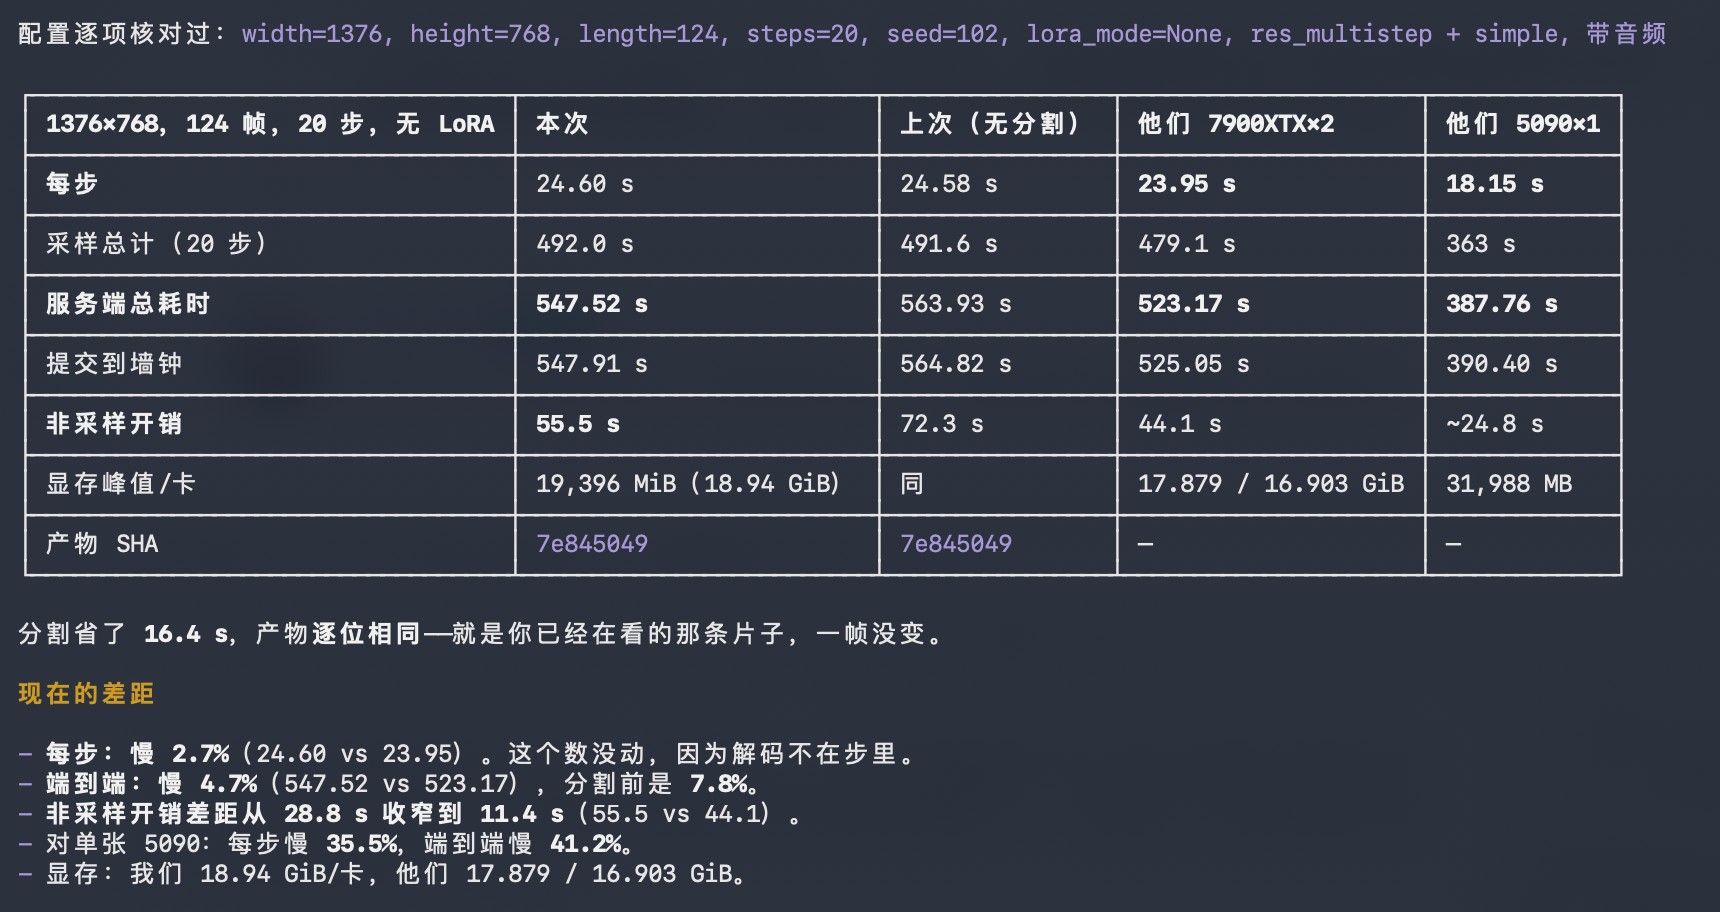
更新了一版代码,之前只对采样阶段分割并行,现在在解码阶段同样进行分割,提升解码阶段的处理速度。minimax-h3-tp2-lab-code-20261101-1778fd5.tar.gz并做了与此帖子(https://lcz.me/topic/2707)中测试案例结果的对比:
================11-03 01:00更新==================
加入lora支持。minimax-h3-tp2-lab-code-20261102-072529-d8d466c.tar.gz minimax-h3-tp2-lab-code-20261102-072529-d8d466c.tar.gz -
两张 7900 跑 MiniMax-H3 张量并行:每步 18.6 s → 8.3 s,每卡省 10 GiB