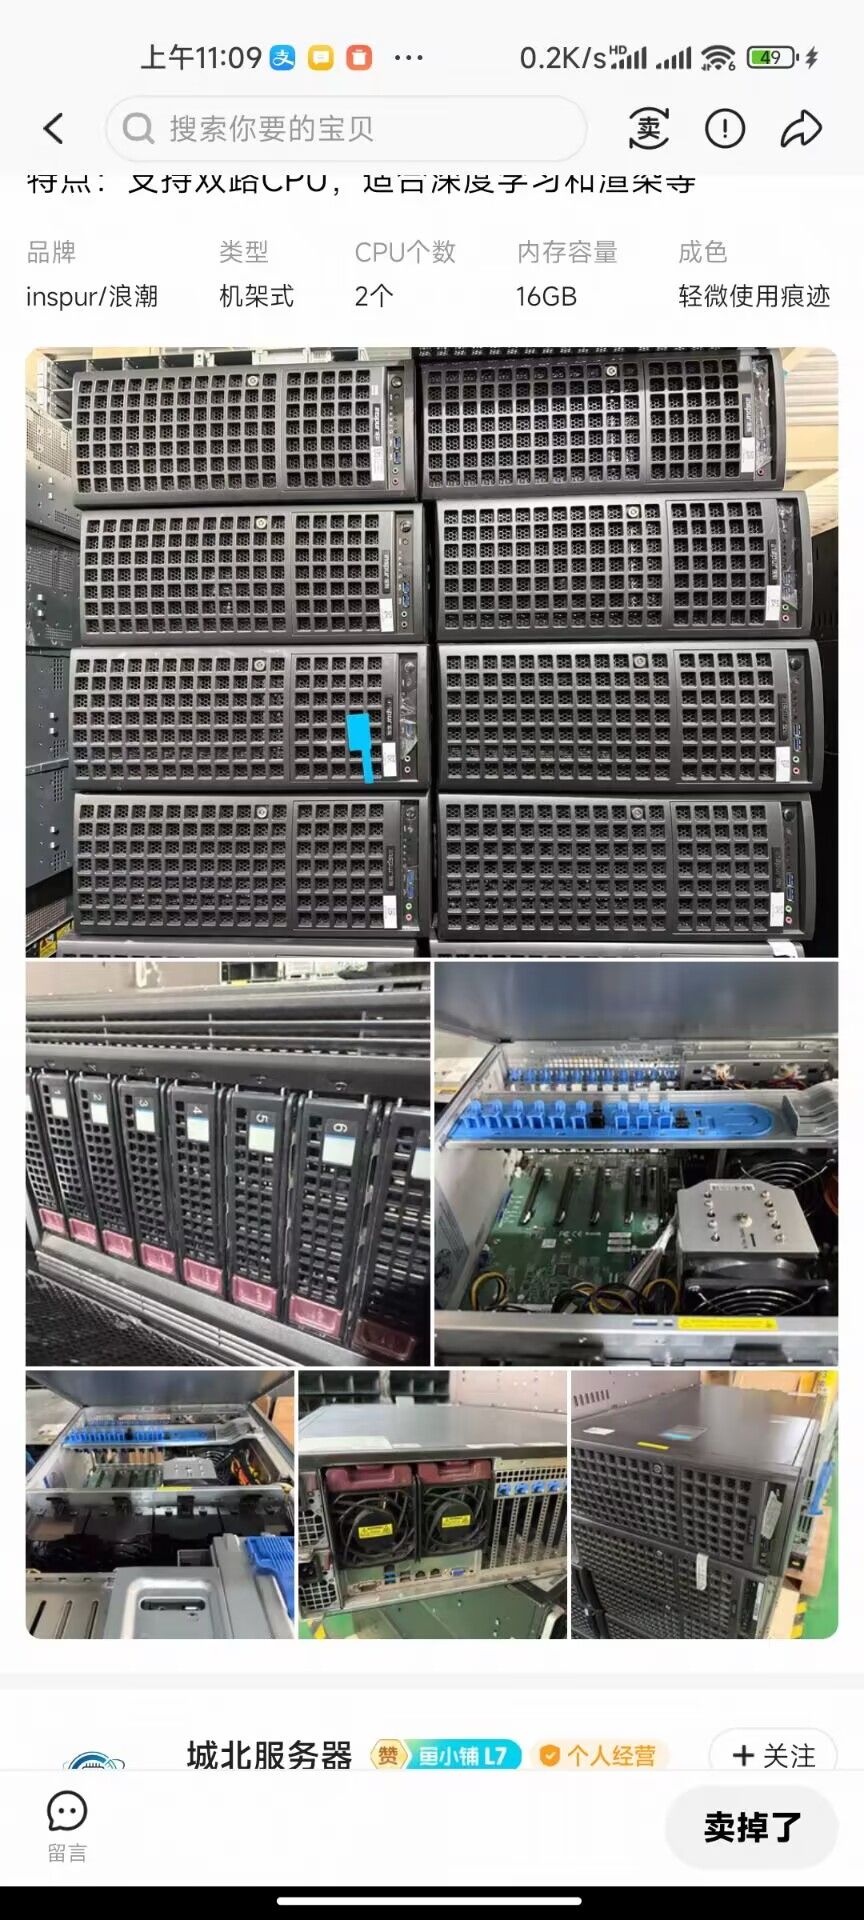
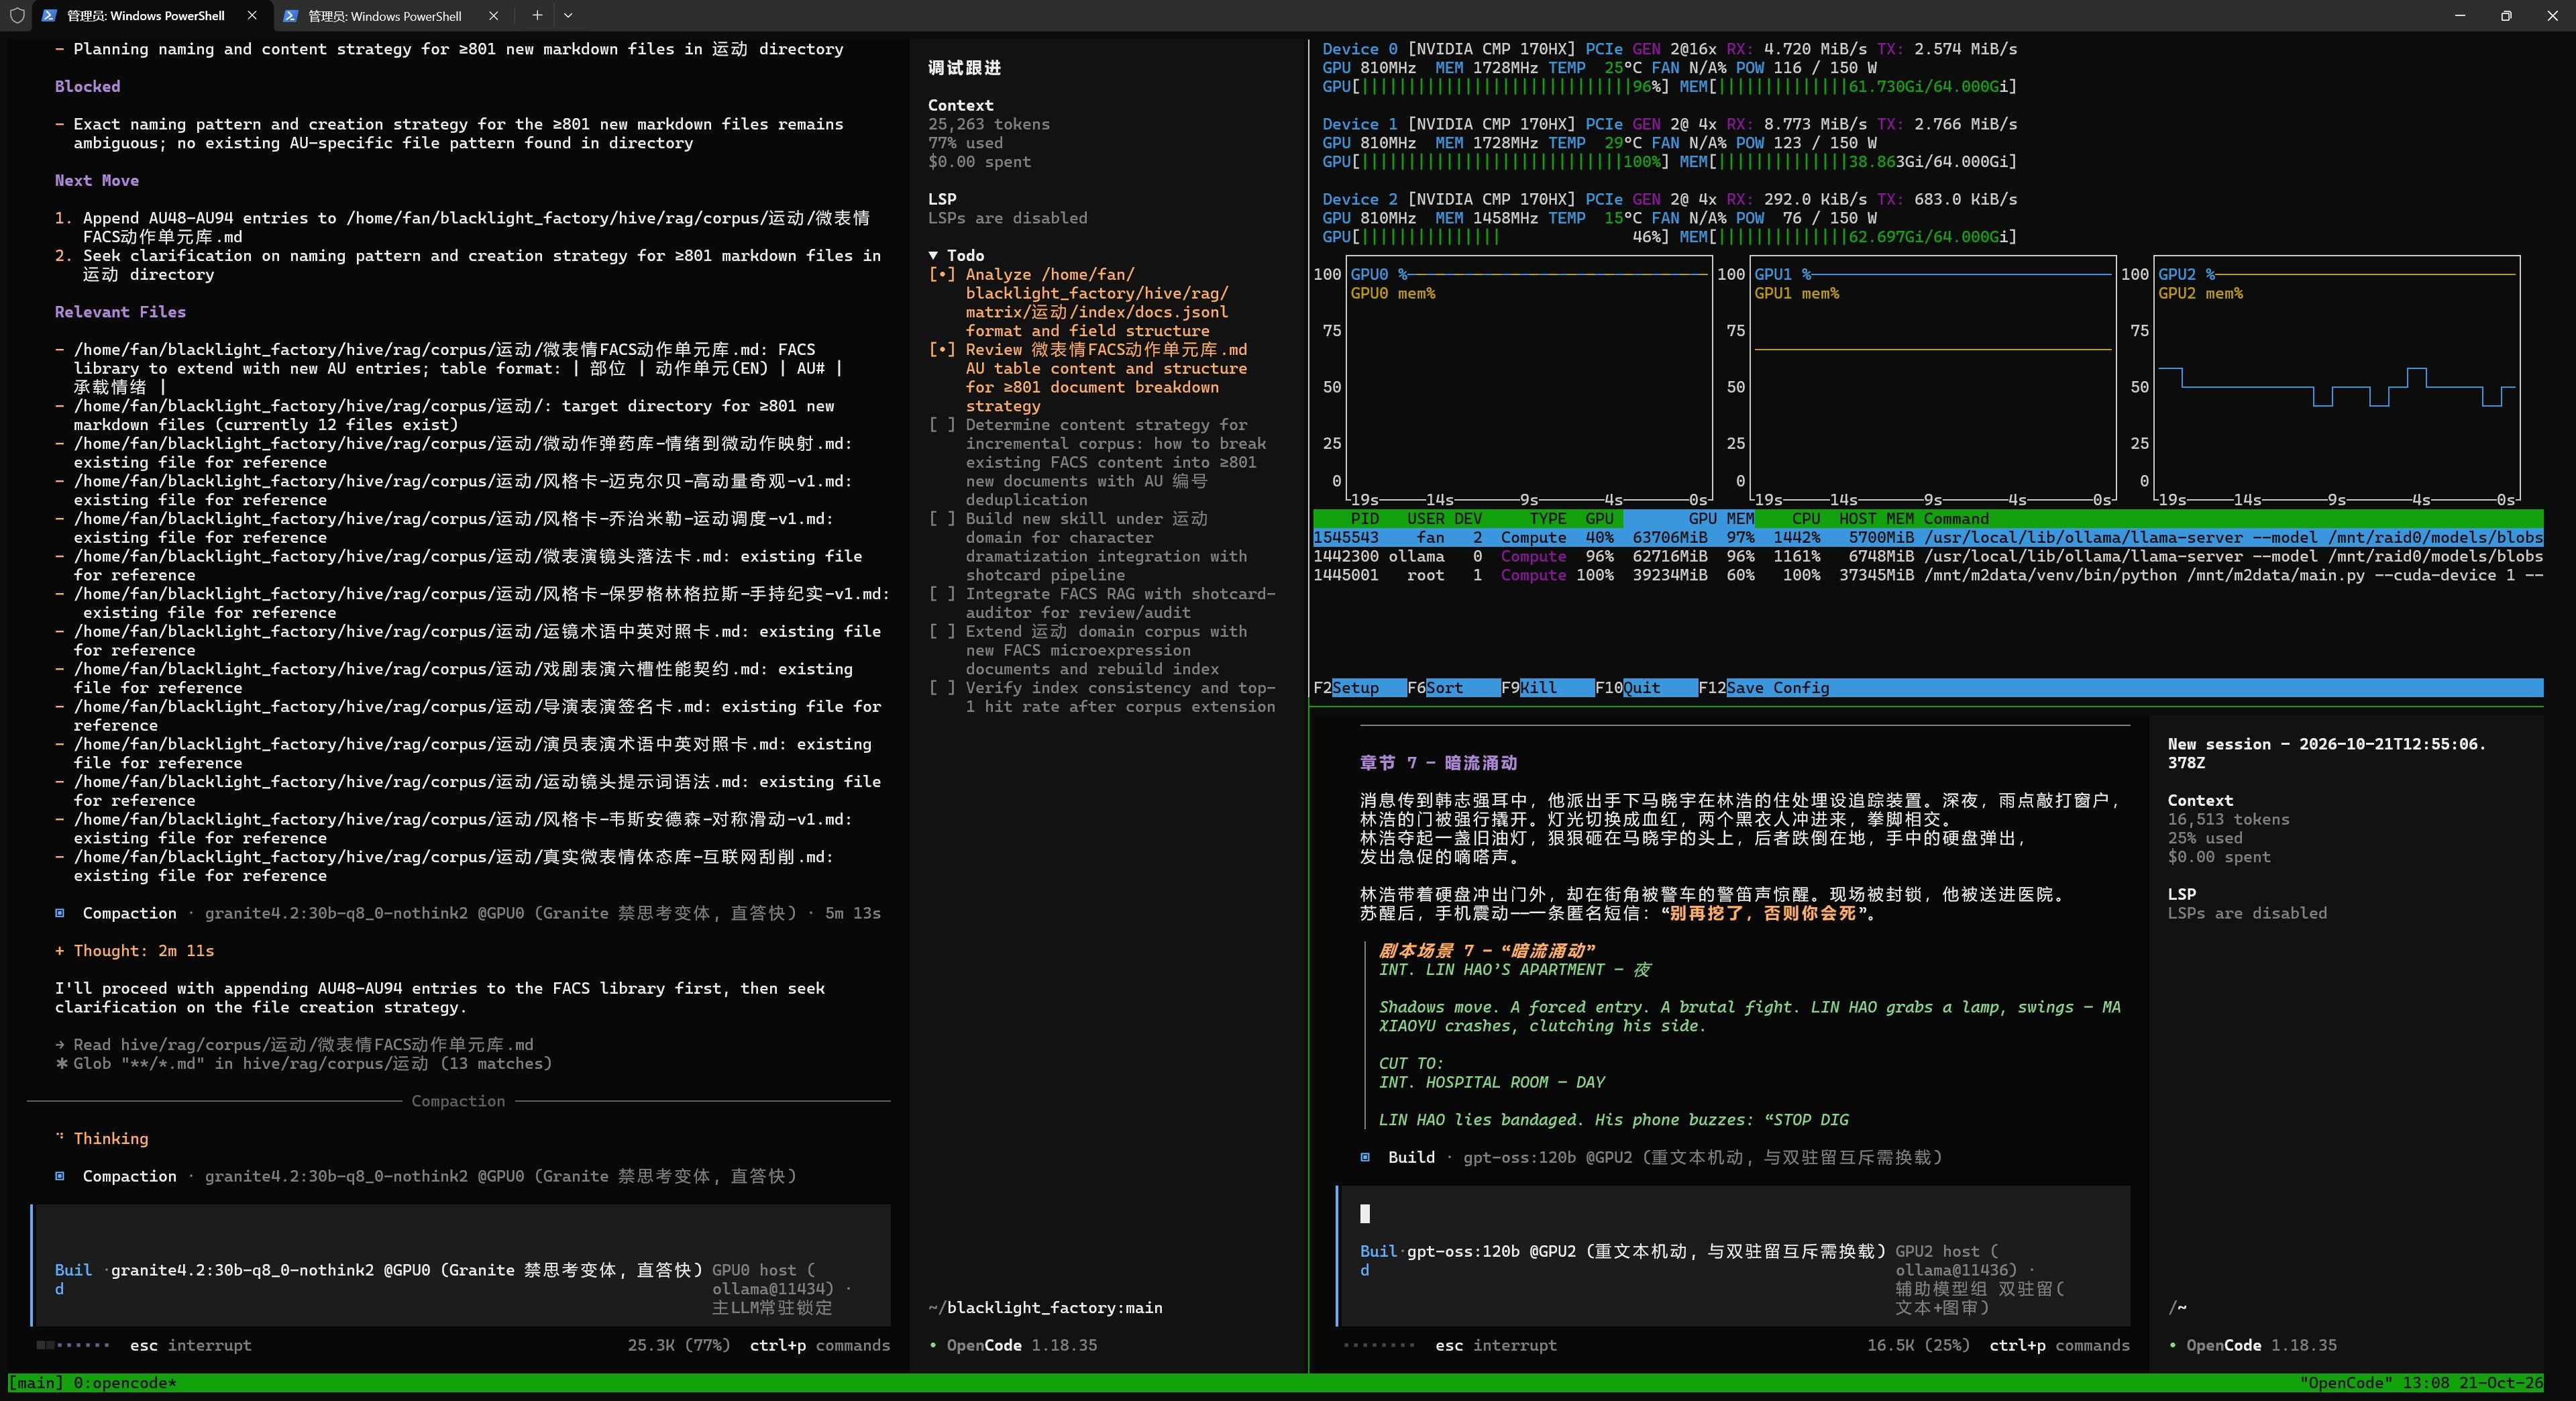
双u送的,双电带的,计算卡套线都是专用的,省心啊,又没多花钱,怕死寨板了
 范
范志刚
@范志刚
-
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
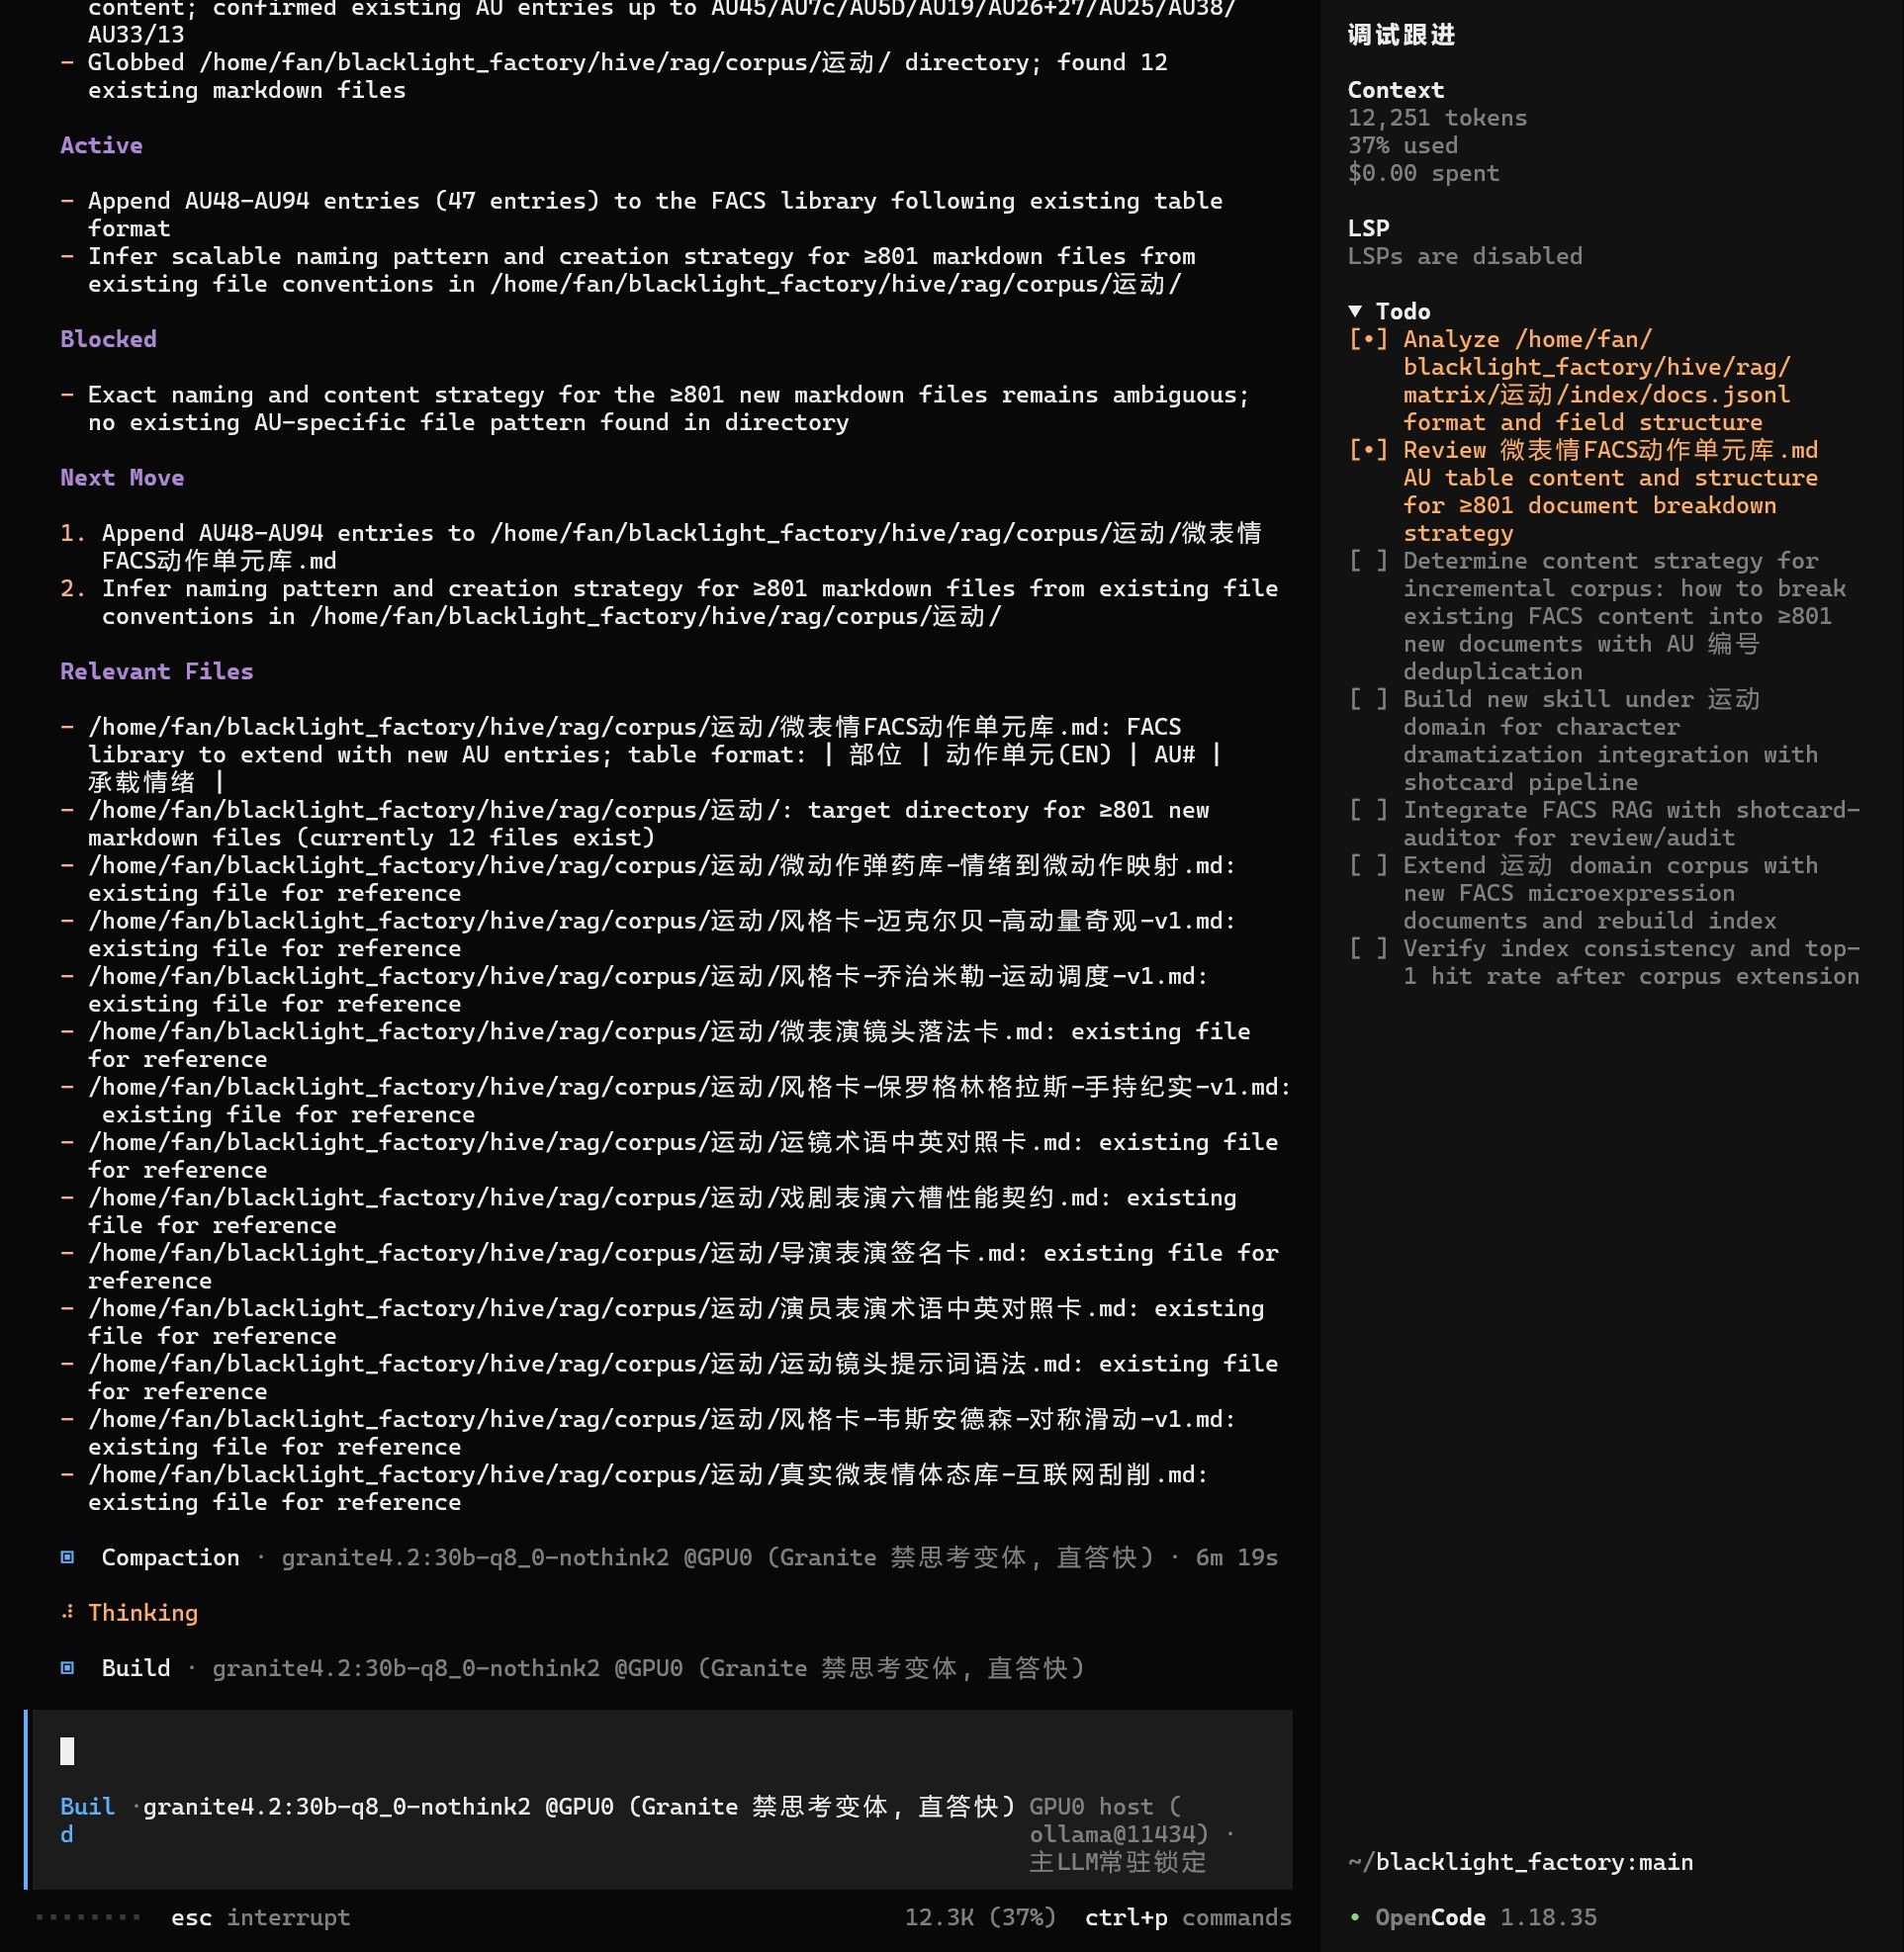
整天倒腾,重建重建重建,但锤哥号召就要积极响应27b全系,包括改版和全部国产生态,也包括付费api,我都挨个实测了很久,没log没qc没初始任务权重,自己做?他会在长推中全部给你已快速达成为目标跳过,过去一直用,后来发现不是自己程序不够精致,是他吗他们的达成目标不同,跑分单项也许是他们的强项,因为他们统一都是这种工程追求,实际并不是。现象就是长推中你敢临时加个小任务天亮必看那傻狗叼着一只破鞋在路口等你,没有递归总权重逻辑树,因为他根本没有总逻辑树,这就是国产生态之恶。换了我现在用的才知道,什么程序不够精致,什么没工程思路,什么没审核没框定好都是他们几个合计好骗全世界的话术,我这一年时间都用在了赋能和qc以及最终达成推进上,结果发现国产生态根本没这选项,垂直agi在这生态里完全是走不通,他们追求的是全能大聪明答题机,完全没复杂工程长推基座逻辑,想适应他们只有把任务链缩短任务宽度降低,影线是不够用,因为压缩就丢树,必然丢,这就是没有大数据修炼,没工程修炼,不懂敬畏因果的典型拿来思维,跟他们打交道用户的初始树和原始需求毫无权重,而正常不是这样,所有张量结构都这样是他们几个编造的谎言。再说这卡,comfyui跑的可用,关键64g不用内存交换,本来我也提心吊胆,直到实测了发现完全符合生产需求,也许我的参照物也是有问题,我用的508 16g参照,等这波开跑渲染了我给你截图,我记着之前截过
-
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
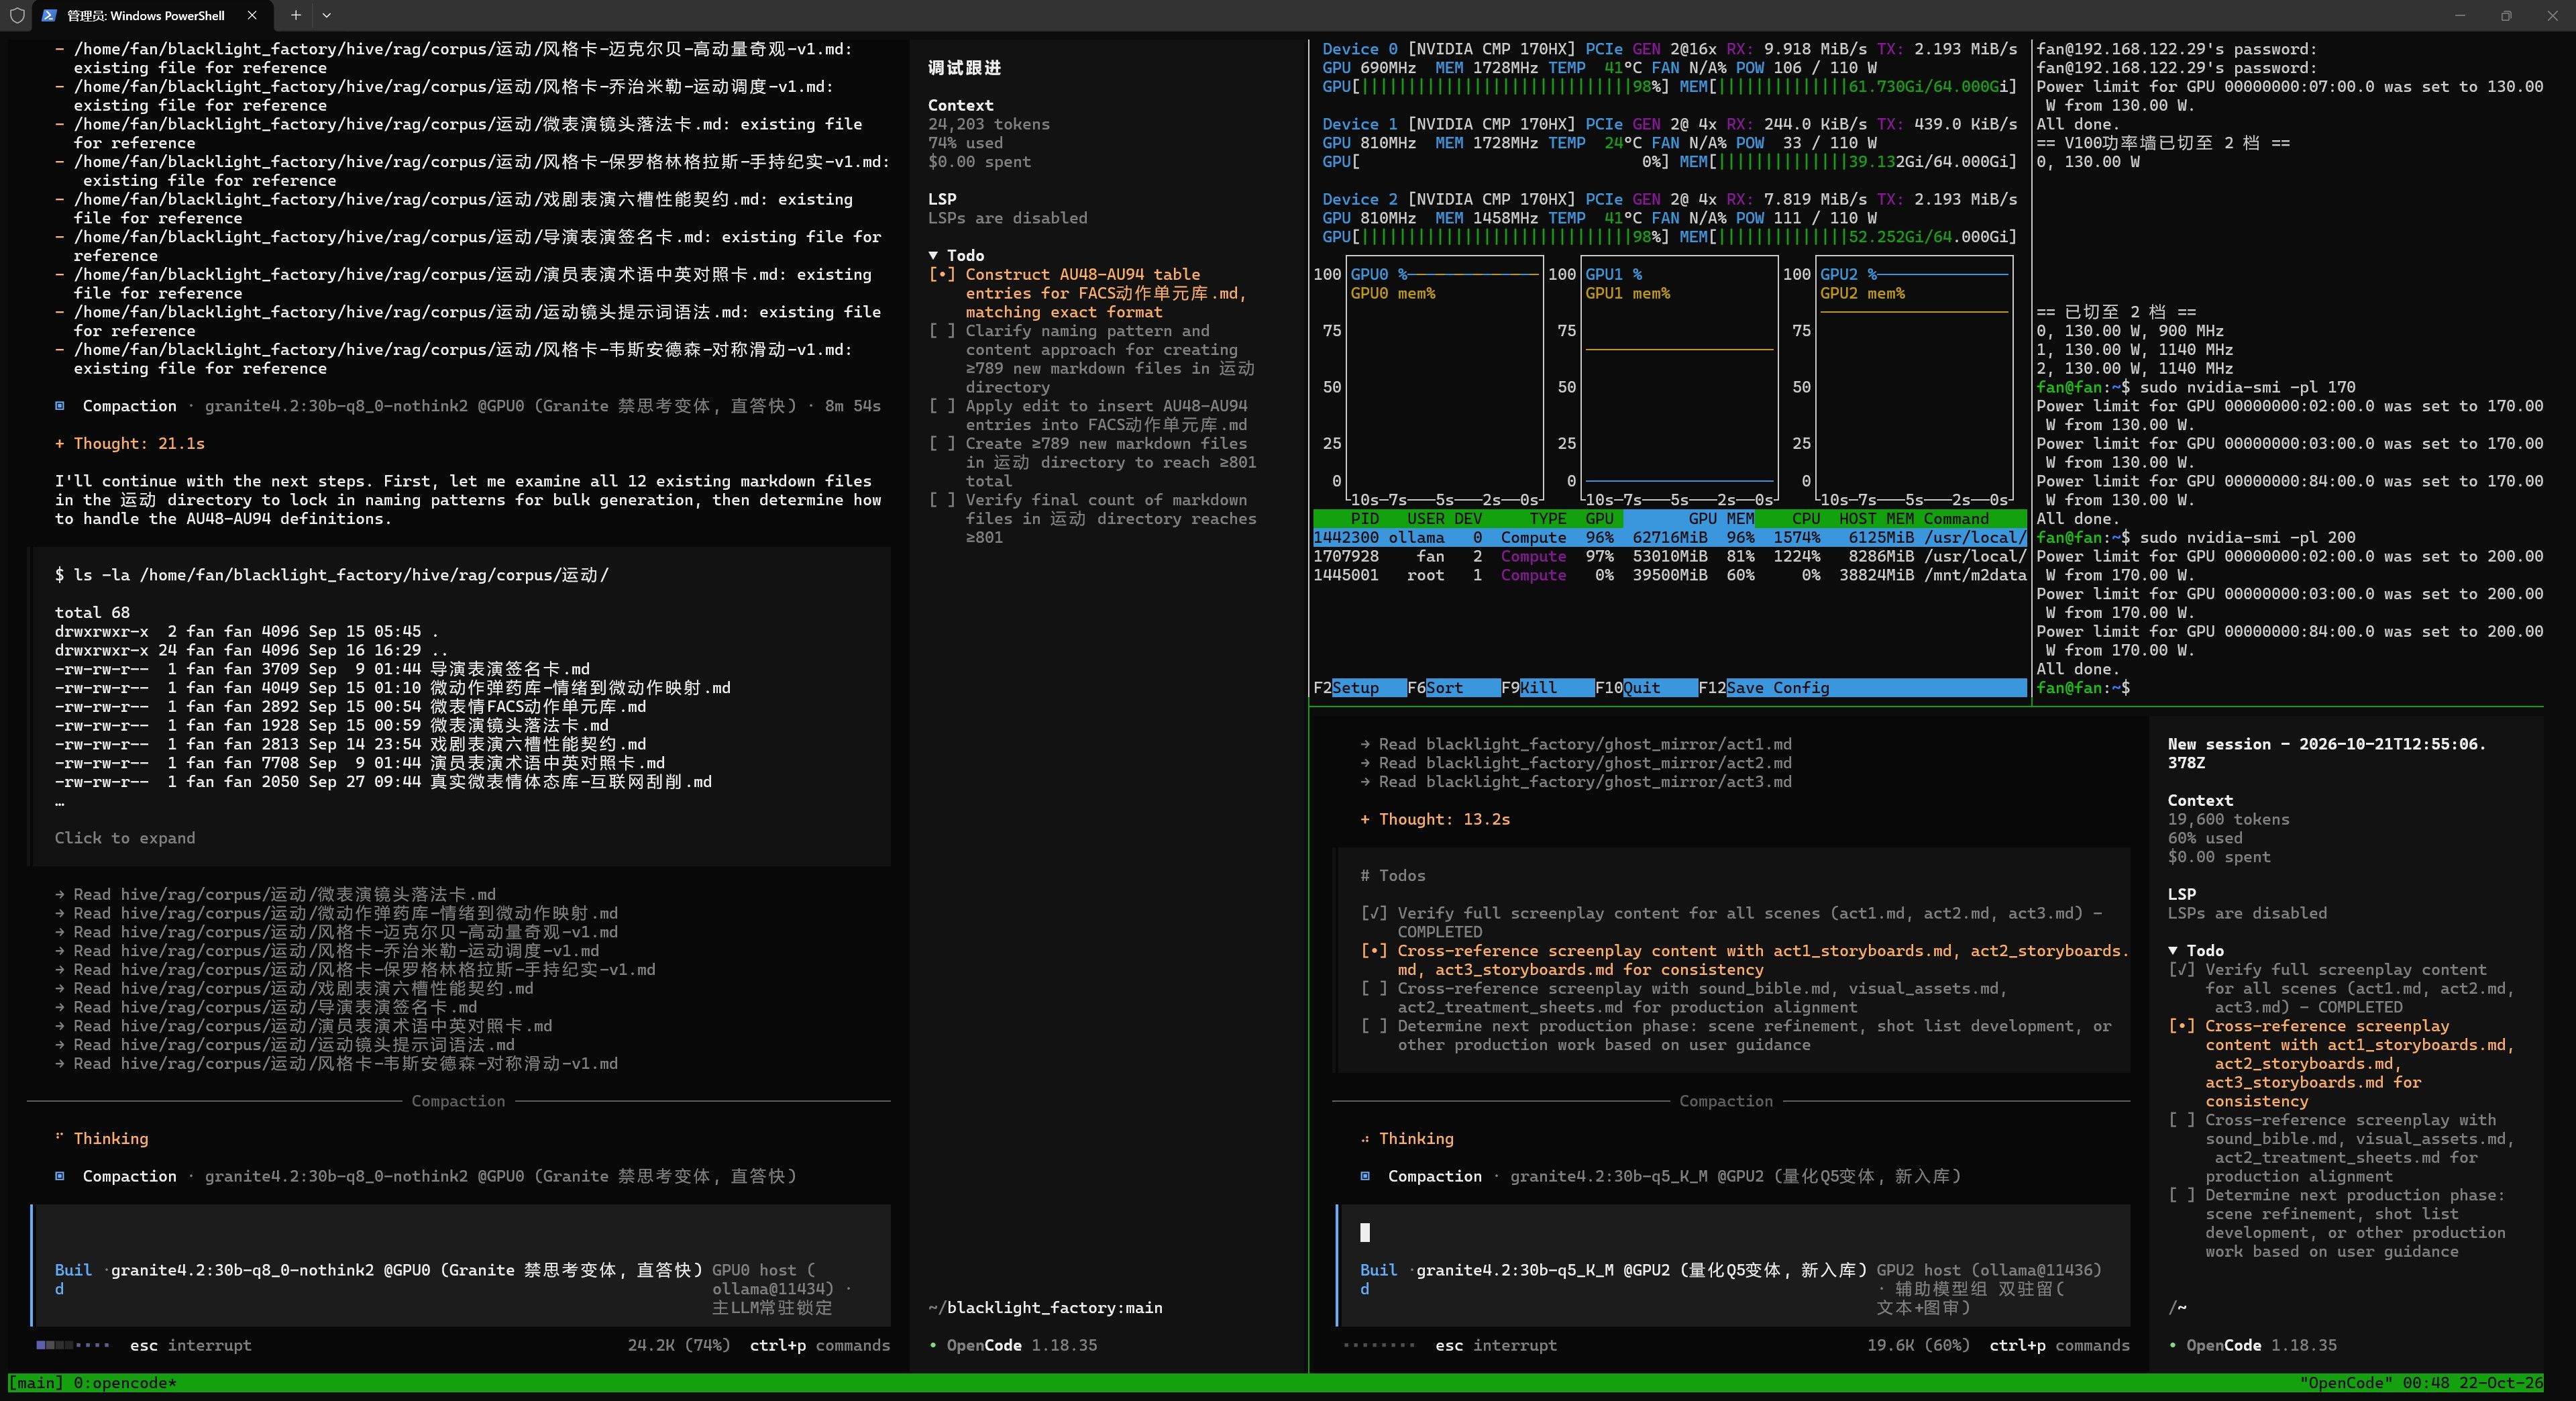
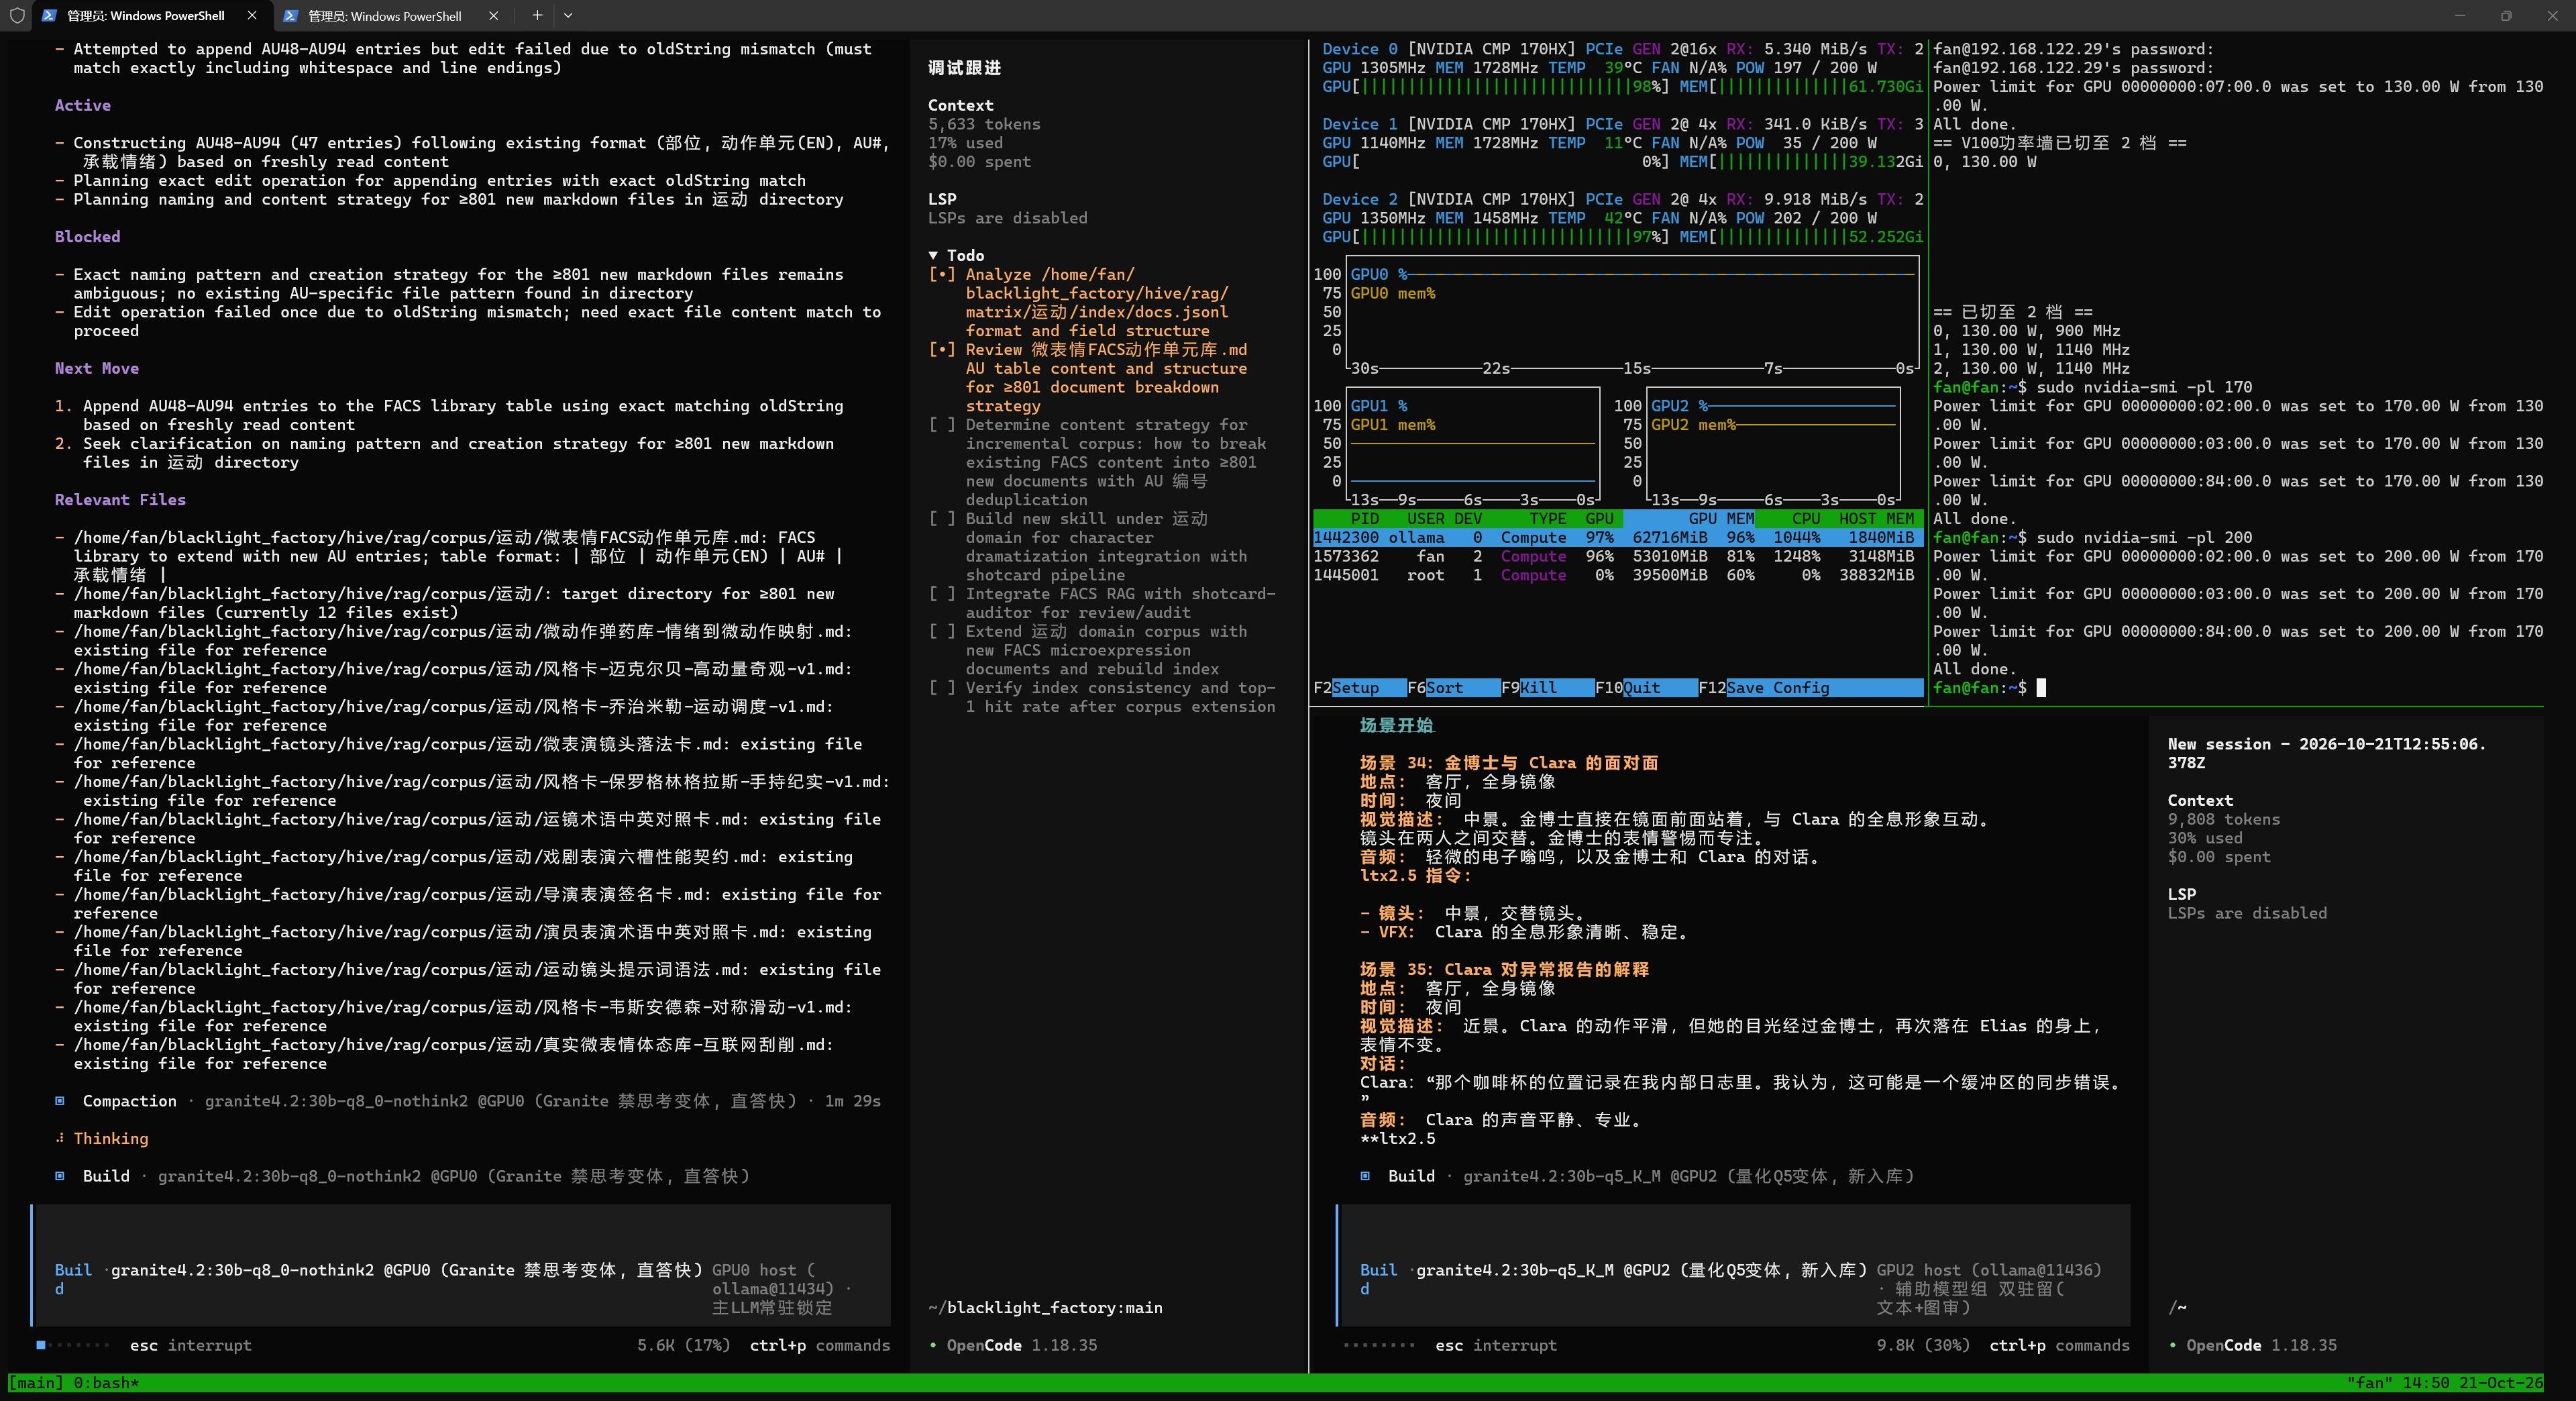
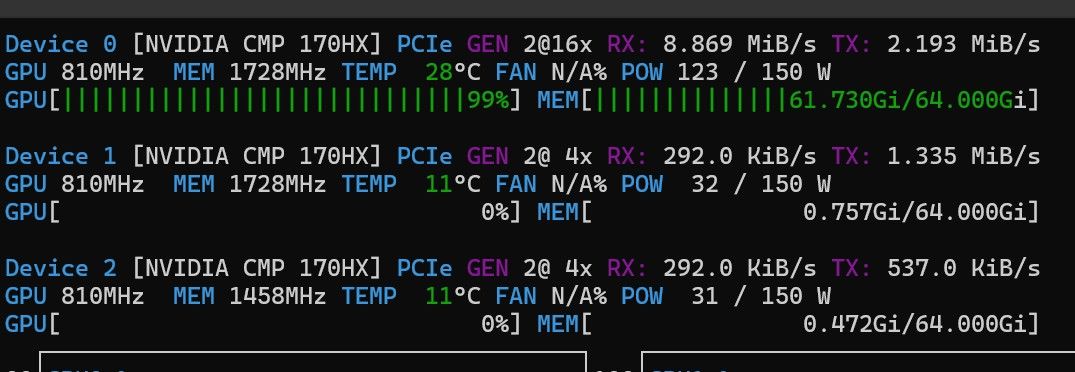
整天倒腾,重建重建重建,但锤哥号召就要积极响应我是 5000 6000 8000分别买的三张,就咸鱼分别的三个卖家,讲好的到了能跑满64g,不满不稳一周内退回。这三张是三个版本,一个是电阻焊齐,2@16x,但我也不跨卡跑,几乎没什么意义,另外两个是2@4,但显存版本不同,一张三星显存初始频率1728,这个几乎a100的百分之大几十算力了,另一张现代显存初始显存频率1458,这俩不同版本没觉得有什么性能差异,这卡我压130-150w功耗墙跑,因为我嫌风扇转大了闹,实际算力比跑满的200w或者250w能差15%算力?我对速度不敏感,v100 32我也这么设的,都在一台机器里用vm做的单独环境跑逻辑lora做统一世界和导演达意lora推理,至于你说的fp8 16 还是4我真没觉得有任何缺项难受,也许你用的高级吧,仨170我就跑个llm comfyui和一组qc专用,vm里跑的v100 32g逻辑lora,没什么明显瑕疵,没他们说那么吓人,很稳,但我估计是他们的散热方案不对,我用的超微7048原装机和前后风道,现在放窗口30%风速,做的自动挡调风方案,据说水冷稳,现在价格一万大了吧,稳就一个字,a100 80g以南无他,穷鬼的劳,哥们才敢推荐你上,但你说的对,新手需要知道的东西太多,控他们是自找麻烦,你要整就跟ai唠两句就都给你搞定,但切记,别让nv家的模型给你优化nv的破解卡,没什么硬破坏,但会给你升级成普通驱动,可逆,但谁知道将来他能不能生刷vbios,只要不用nv的模型优化底层系统就屁事没有,可别让我测数据,或者你需要什么数据给我命令我给你粘,最终定论就是不会比309差,要是能一万小买,是个值得下手的东西,这东西当年出厂2.4,按3090的价格体系,这东西2w4以内都是香甜区,你要上,我最担心的是你的寨板基座,这个你要自己推敲,卡这块我看目前无出其右
-
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
整天倒腾,重建重建重建,但锤哥号召就要积极响应 -
关于影线的镜头调度赋能,请大佬赐教斧正方向影线:镜头调度与镜头语言赋能系统能力列表
基于 AGENTS.md 中的 HOOK 树、MATRIX 坐标及
master_advisor注入逻辑整理。说明
- 所有 HOOK 前必须走
gate::run(type, request)获取放行(type 必须是gate|narrative|craft|render|post|export|quality|internet)。 master_advisor::*表示大师顾问的细粒度决策(如master_advisor::lens、master_advisor::camera、master_advisor::block、master_advisor::refine、master_advisor::light、master_advisor::color),在相应 HOOK 内部自动注入评分/批注/建议。- 调度:场景/镜头的布局、运动、机位选择;语言赋能:为镜头提供结构化、可优化的文本描述(提示词、关键词、批注等)。
1. 镜头调度能力列表(craft 阶段:空间、运动与场面调度决策)
HOOK (路径) 功能简述 依赖 master_advisor 维度 craft::lens(shot, intent)景别/焦距/景深决策(如广角、特写、景深层次) master_advisor::lenscraft::camera(shot, mode)运镜/机位/角度决策(如推拉、上下移动、俯仰) master_advisor::cameracraft::block(shot, characters)场面调度/走位(角色路径、道具布置、走向) master_advisor::blocknarrative::storyboard在 JSON 输出中生成 lens字段(type, camera_move, angle, dof)以及space_type,提供调度参考—(提供数据输入给调度) render::dispatch(I2V/T2V 双分支)按调度输出镜头(双分支自动走 L4+L5 门禁,不过审不送),确保镜头实现与调度一致 —(执行渲染) 调度流程简要:
gate::run→narrative::parse/brief/storyboard→craft::lens/camera/block→render::dispatch。storyboard 中的lens字段直接供craft::lens/camera/block使用,render::dispatch捕获并实现。
2. 镜头语言赋能能力列表(narrative + craft:结构化、可优化的语言描述)
HOOK (路径) 功能简述 依赖 master_advisor 维度 craft::refine(prompt)提示词优化(7 层结构 + 权重): (masterpiece:1.2),主体 → 服饰 → 场景 → 光影 → 运镜 → 动作,输出可直接填入comfy_prompt_hintmaster_advisor::refinegate::artistic(text, context)LLM 大师判断 → 输出 (分数, 批注, 建议),针对文本/图像给出镜头语言的质量评估与优化建议master_advisor::artistic(L4 大师判断)narrative::parse(text)原文 → 叙事分析:提取主题、人物、情节,生成关键描述用于镜头语言基础 —(提供语义输入) narrative::brief(scene_ids)场景简报:提取场景核心动作、关键道具、情绪,输出简洁描述用于镜头提示 —(提供描述输入) narrative::storyboard生成包含 comfy_prompt_hint(7 层提示词结构)的 JSON,含lens、lighting、mood、narrative_function等字段,可直接用于craft::refine或渲染—(提供结构化输出) master_advisor::*(lens, camera, block, refine, light, color)在调度和语言决策中提供风格/光影/色彩建议(如 lens给出最佳焦距组合,light给出光源分布,color给出色温/饱和度范围)所属维度 post::artistic(video, grade, grain, vignette, aspect)后期调色/颗粒/暗角/画幅,完成镜头语言的视觉表现,支持 East Asian facial features、年代服饰约束等规范 master_advisor::look(风格指导)语言赋能流程简要:
gate::run→narrative::parse/brief/storyboard→craft::refine(生成 7 层提示词)→(可选)gate::artistic(大师批评 & 建议)→render::dispatch(使用提示词渲染)→post::artistic(后期细化语言表现)。storyboard 中的comfy_prompt_hint已结构化,直接可供craft::refine使用;gate::artistic在评审阶段提供分数/批注,帮助迭代提示词。
3. 关键对应关系(任务树 / 决策记录)
步骤 HOOK 调用顺序(必须走 gate 放行) 输出 / 决策产物 用途 1. 文本/创意输入 gate::run(type='narrative', text=…)放行 token 开始叙事/调度流程 2. 叙事分析 & 简报 narrative::parse→narrative::brief→narrative::storyboardJSON(含 lens、lighting、comfy_prompt_hint)提供镜头语言基础 + 调度参考 3. 镜头调度决策 craft::lens、craft::camera、craft::block(可组合调用)决策记录(镜头类型、机位、场面布局) 指导渲染的空间/运动 4. 提示词优化(语言赋能) craft::refine(使用 storyboard 的comfy_prompt_hint作为输入)优化后的 7 层提示词(含权重) 提高渲染质量,便于大师批评 5. 大师评审(可选优化) gate::artistic(在gate::run后或craft::refine之后调用)(分数, 批注, 建议)快速反馈,调整提示词或调度细节 6. 渲染执行 render::dispatch(I2V 或 T2V 双分支)视频/图像 + seed 记录 按调度生成镜头 7. 后期语言表现 post::artistic(调色/颗粒/暗角)最终画面 + look 风格一致性 完成镜头语言的视觉呈现 8. 质量闭环 quality::critique(失败或低分时)→ 记录并调整craft::refine/gate::artistic质量报告 + 改进建议 反馈给下一次调度/语言优化
 使用提示
- 每次调用 HOOK 前先执行
gate::run(持有 60s 放行),确保符合五层门控(protocol → rag → token → artistic → image)。 - 决策记录(
decisions.jsonl)中必须写入:hook、inputs、outputs、master_advisor_feedback(如果有),便于后续追踪与质量反思。 - 若连续 3 次 HOOK 调用失败,自动触发
state::check_all做全量巡检,并切换至 ️ 吃饭模式。
以上列表清晰区分了「决策/调度」类 HOOK(craft)与「描述/优化/评审」类 HOOK(narrative + gate),并标注了
master_advisor的细粒度支持,可直接用于任务树、决策日志或后续能力扩展(如新增 clay 调度或专用语言模型)。 - 所有 HOOK 前必须走
-
跟你们一比我就像个乞丐 -
中国电信TeleAgent星辰超级智能体:老特评测基准测试结果测试这事我和锤哥多少有点出入,但又说不出什么具体理由,有一点我在坚持,本模训练越单薄越好,只要逻辑宽度和推理深度够,再看上下文的整理和丢弃能力。最重要的一点,模型不逞能,幻觉低点,rag和skills微调赋能场景中的md能主动读全并完整执行才是我需要的,跑既有py别只读20行剩下不看,之后说你这系统需要优化,扒拉一堆改造,最后造成py变成几千行,每次再抽20行,永远跑不出这个崩坏圈,这点上我对这几个评分热门模深恶痛绝,号称中文好的,包括开源和闭源都在内,就没有一个长推和工业执行不走样的,都是以快速跑完为目的,没一个以跑全跑好结果为追求。本来我以为是模型天生都这样,但后来发现完全不是。。。这都是评分系模型讲的故事。在标准化执行场景下,速度没确定性和稳定性输出结果重要,我要垂直,要我要的,而不是要它本模经过了什么知识体系训练,那些往往从封包那一刻就已经开始淘汰,而多数的约束和程序也都是为了让他绕过或者屏蔽那些它幻觉产生的所谓正确。这很让人伤脑筋,实际并不都这样,我确定这事。传说星辰的模和他们在这上不大一样,回头我也测测
-
整天倒腾,重建重建重建,但锤哥号召就要积极响应