
Qwen3.8 27B Q5_K_M + 7900xtx + DeepSeek Harness实战平均 52 t/s
-
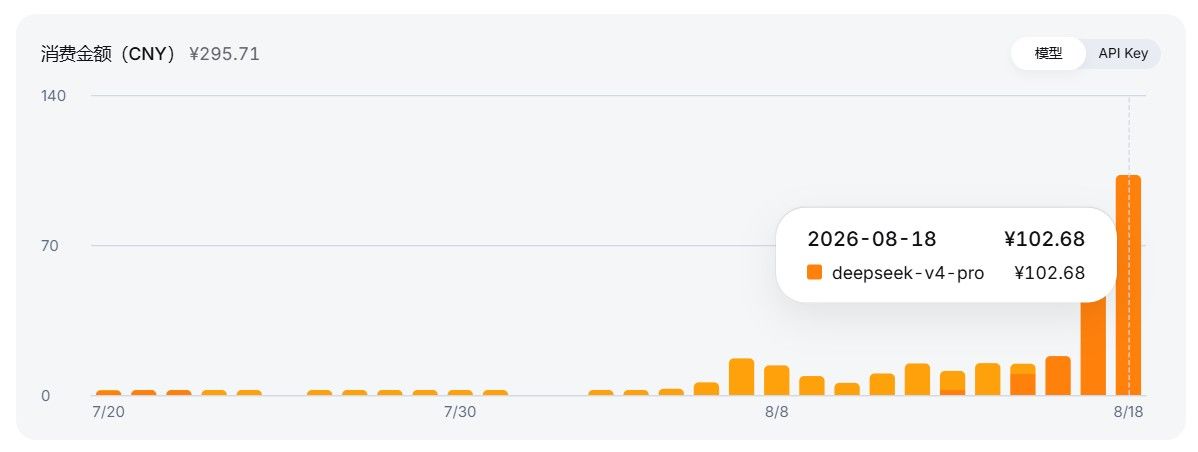
感谢楼主. 7900xtx 能跑,不错. 明天试试dsh. 今天dsh+v4pro花了100多, 肉疼(不过确实强, 长链自主调试FPGA, 综合+ila probe+烧写+测试+uart输出分析一条龙, 我基本可以不用管, 花token就行).
bruin@lmde7 ~ $ ./run-3.8-q5.sh
0.00.035.069 W Setting 'enable_thinking' via --chat-template-kwargs is deprecated. Use --reasoning on / --reasoning off instead.
0.00.035.097 W DEPRECATED: --mmap and --no-mmap are deprecated. use --load-mode mmap instead
0.00.039.005 I cmn  common_param: common_params_print_info: verbosity = 3 (adjust with the `-lv N` CLI arg)
0.00.039.491 W srv  llama_server: -----------------
0.00.039.495 W srv  llama_server: CORS is set to allow all origins ('*') and no API key is set
0.00.039.495 W srv  llama_server: this can be a security risk (cross-origin attacks)
0.00.039.495 W srv  llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
0.00.039.495 W srv  llama_server: -----------------
0.00.040.765 I srv    load_model: loading model '/opt/gguf-models/unsloth/Qwen3.8-27B-GGUF/Qwen3.8-27B-Q5_K_S.gguf'
0.08.836.391 I cmn          init: llama threadpool init, n_threads = 10
0.09.247.607 I common_speculative_init_result: creating MTP draft context against the target model '/opt/gguf-models/unsloth/Qwen3.8-27B-GGUF/Qwen3.8-27B-Q5_K_S.gguf'
0.09.318.357 I srv    load_model: initializing, n_slots = 1, n_ctx_slot = 131072, kv_unified = 'true'
0.09.457.688 I srv          init: chat template supports preserving reasoning, consider enabling it via --reasoning-preserve
0.09.457.746 I srv  llama_server: model loaded
0.09.457.750 I srv  llama_server: listening on http://0.0.0.0:8000
0.31.502.907 I slot get_availabl: id  0 | task -1 | selected slot by LRU, t_last = -1
0.31.503.144 I slot launch_slot_: id  0 | task 0 | processing task, is_child = 0
0.33.674.917 I slot print_timing: id  0 | task 0 | prompt eval time =    1607.08 ms /   333 tokens (    4.83 ms per token,   207.21 tokens per second)
0.33.674.922 I slot print_timing: id  0 | task 0 |        eval time =     564.47 ms /    34 tokens (   17.11 ms per token,    58.46 tokens per second)
0.33.674.923 I slot print_timing: id  0 | task 0 |       total time =    2171.56 ms /   367 tokens
0.33.674.928 I slot print_timing: id  0 | task 0 |    graphs reused =         11
0.33.674.930 I slot print_timing: id  0 | task 0 | draft acceptance = 0.72727 (   24 accepted /    33 generated), mean len =  3.18
0.33.674.999 I slot      release: id  0 | task 0 | stop processing: n_tokens = 368, truncated = 0
0.39.250.971 I slot get_availabl: id  0 | task -1 | selected slot by LCP similarity, f_sim_best = 0.963 (> 0.100 thold), f_keep = 1.000
0.39.251.208 I slot launch_slot_: id  0 | task 16 | processing task, is_child = 0
0.40.592.295 I slot print_timing: id  0 | task 16 | prompt eval time =     368.90 ms /    14 tokens (   26.35 ms per token,    37.95 tokens per second)
0.40.592.303 I slot print_timing: id  0 | task 16 |        eval time =     972.01 ms /    67 tokens (   14.73 ms per token,    67.90 tokens per second)
0.40.592.303 I slot print_timing: id  0 | task 16 |       total time =    1340.91 ms /    81 tokens
0.40.592.305 I slot print_timing: id  0 | task 16 |    graphs reused =         31
0.40.592.307 I slot print_timing: id  0 | task 16 | draft acceptance = 0.71429 (   45 accepted /    63 generated), mean len =  3.14
0.40.592.367 I slot      release: id  0 | task 16 | stop processing: n_tokens = 448, truncated = 0
llama.cpp 我用的最新 b10485; 完全抄作业:
bruin@lmde7 ~ $ cat run-3.8-q5.sh
#!/bin/bash

# ref: https://lcz.me/topic/1157/qwen3.8-27b-q5_k_m-7900xtx-deepseek-harness%E5%AE%9E%E6%88%98%E5%B9%B3%E5%9D%87-52-t-s

LLAMA_SERVER=/home/bruin/llama-server-vulkan-b10485
MAIN_MODEL="/opt/gguf-models/unsloth/Qwen3.8-27B-GGUF/Qwen3.8-27B-Q5_K_S.gguf"
MTMD_MODEL="/opt/gguf-models/unsloth/Qwen3.8-27B-GGUF/mmproj-F16.gguf"
#--mmproj "${MTMD_MODEL}" \

${LLAMA_SERVER} \
--device Vulkan0 \
--model "${MAIN_MODEL}" \
-t 10 \
-b 512 \
-ub 256 \
--spec-draft-n-max 3 \
--fit off \
--no-context-shift \
--metrics \
--kv-unified \
--jinja \
--cache-type-k q8_0 \
--cache-type-v q8_0 \
-fa on \
--spec-type draft-mtp \
--ctx-size 131072 \
--parallel 1 \
-ngl -1 \
--host 0.0.0.0 \
--port 8000 \
--chat-template-kwargs '{"enable_thinking": true, "preserve_think": false, "reasoning_effort": "medium"}' \
--no-mmap \
--temp 0.6 \
--top-p 0.5 \
--top-k 15 \
--repeat-penalty 1.0 \
--override-tensor blk\.\d+\.ffn_.*_exps\.=CPU \
--alias qwen3.8-27b-q5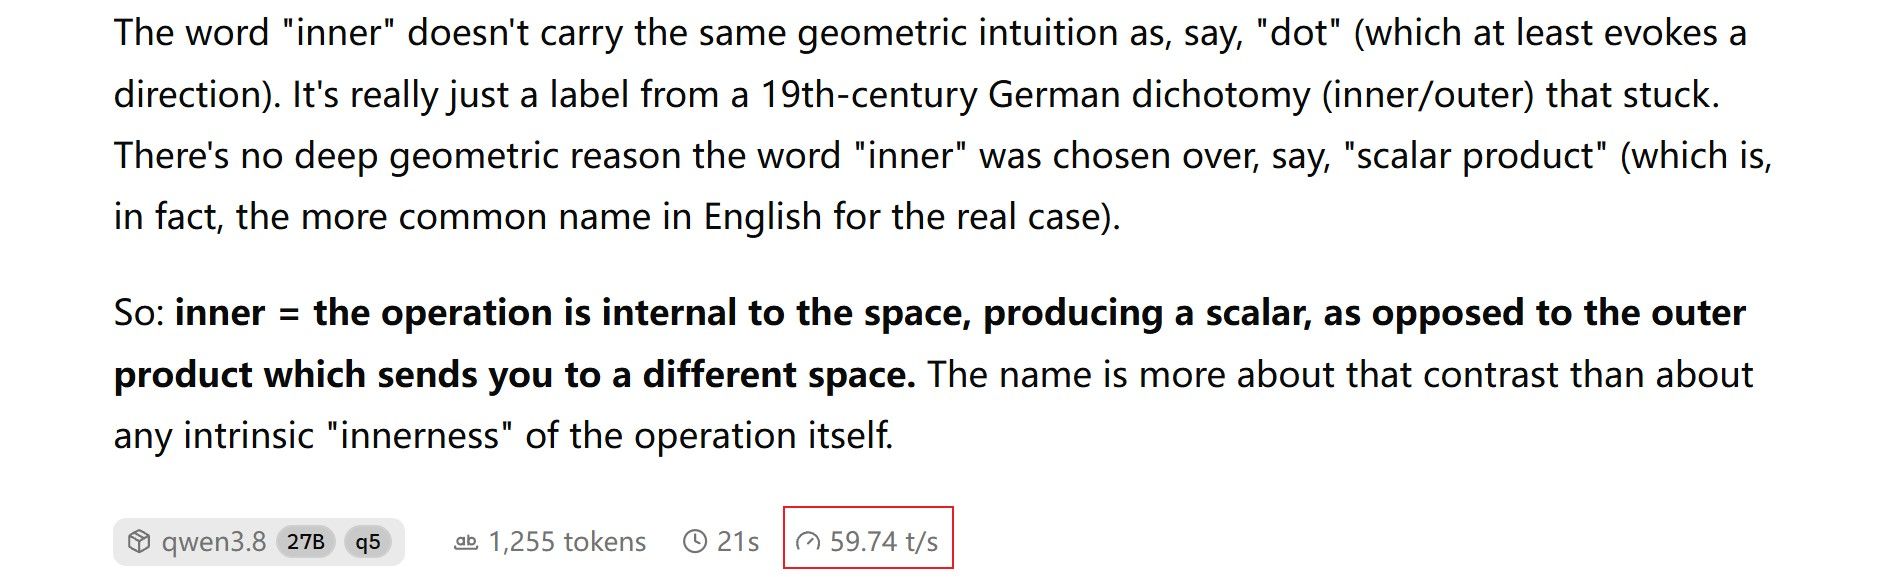
@laobenxiong 确实,用了你这个q5ks的模型,我的速度终于正常了,也不用关thinking,不知道为什么其他人的q5km可以
-
关于--parallel 2 的测试
软硬件环境:
cpu: AMD Ryzen 7 9700X
RAM:DDR5 64GB 6000
GPU:R9700 32G
OS: Ubuntu 24.04
软件 : llama.cpp + vulkan结论:将并行设为1或者2,大部分情况下,性能变化属于正常波动,没有明显差别。
但是,即使有32G显存,有些任务还是会报以下错误:
26.48.401.777 E init_batch: failed to prepare attention ubatches
26.48.401.778 W decode: failed to find a memory slot for batch of size 16
26.48.401.779 W srv decode: failed to find free space in the KV cache, retrying with smaller batch size, off = 190, n_batch = 8, ret = 1
26.48.403.275 E init_batch: failed to prepare attention ubatches
26.48.403.277 W decode: failed to find a memory slot for batch of size 8
26.48.403.277 W srv decode: failed to find free space in the KV cache, retrying with smaller batch size, off = 190, n_batch = 4, ret = 1
虽然使用了 --cache-type-k/v q8_0 做 KV 量化来节省显存,但是 128K 的超长上下文,加上 --parallel 2,对 KV Cache 的要求依然极其恐怖。模型权重稳稳地占了 17GB。但当开启并发,且 Prompt 超长时,给 128K 上下文预留的 KV Cache 空间,在高峰期(特别是并发请求时)瞬间耗尽了,导致没有空位给下一个 Token 的生成。
好消息是,llama.cpp不能为KV Cache分配空间,并不会导致崩溃或任务中断(我没有碰到过),只会导致llama.cpp降级重试,严重的情况下会感觉明显卡顿而已,不用过于担心。
所以,用7900XTX的朋友,把并发设为1可能是更好的选择。 -
系统 于 取消固定此主题
-
-
请问大佬测试过rocm么?我现在使用rocm搭配您的参数基本都是首 token 平均 5.8s · 36 tok/s的数据,想看看是个例还是都这么慢。
-
-
7900xtx 全开模式下功耗多少
@Stone-Wong 西风卖的公版显卡默认上限291w,跑满大概280w
-
-
我不懂, 我的 3090 24G 跑 q4km 的128K 上下文, 平均下来也就23tokens /s , 为啥 xtx可以 50多
哦发现了, 我是跑一晚上, 楼主只跑了几分钟
-
Y yi song 于 引用了 此主题
-
7900xtx 全开模式下功耗多少
-
@Stone-Wong 7500F 32G DDR5 1TB硬盘,7900XTX 满功率在492W。连续测试过3个小时功率就在480-492W


