
單DGX spark GB10 安裝 Qwen 3.8 flash next
-
論壇大神發布了一個單spark的配方,速度很快, 跟大家分享一下.
出處: Up to 70tok/s Qwen3.8-Flash-Next-Int4-AutoRound我在一台GB10上跑了一陣, 的確比我原本的雙GB10跑Qwen 3.8 flash next 快, 跑長鏈任務品質跟雙GB10沒有明顯區別. 不過prefill還是雙GB10快上一大截, KV poll兩台GB10也是多了超過一倍. 就看怎麼取捨了.
上述單台GB10配方測試數據如下, 實際跑會比這個快一些:
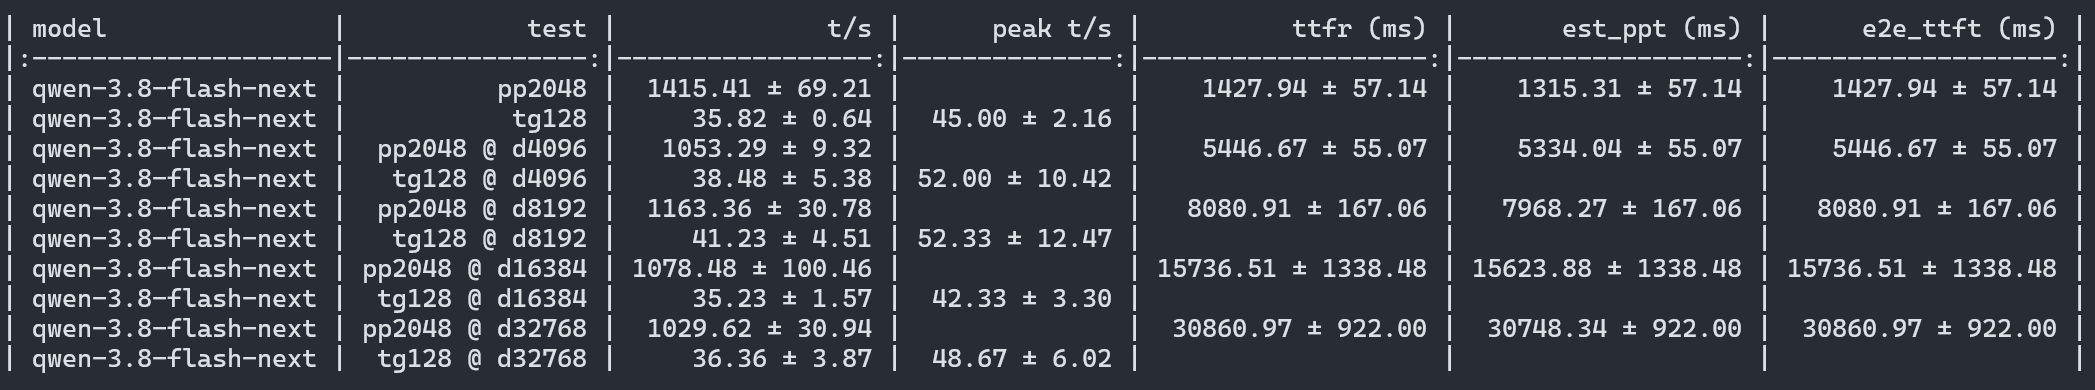
相關資訊如下:
Model
項目 值 HF repo azampatti/Qwen3.8-Flash-Next-125B-A5B-INT4-AutoRoundBase Intel/Qwen3.8-Flash-Next-W4A16-AutoRound(原始 Qwen3.8-Flash-Next,作者把 routed experts 由 10 砍到 5 並 healing)量化 INT4(AutoRound, W4A16) 參數 125B 總 / 4.8B active / token(原版 6B);vocab 248,320、hidden 2,560、48 layers、512 experts、top-k 5 架構(vLLM) Qwen4ExpForConditionalGeneration;layer pattern 每 4 層一個 full-attention、其餘 linear-attention(Δ-net)+ sparse-attention indexer + PLE n-gram tablelicense qwen(原始 Qwen 授權) 硬體目標 1× DGX Spark(GB10, 128 GB unified) 設定 值 來源 max_model_len (CTX) 262,144(256K) --max-model-lenKV cache pool --kv-cache-memory-bytes 20g→ vLLM reserved 18.63 GiB / 644,732 tokens;滿 ctx 單 request 可並行 2.46×(實測報告)--kv-cache-memory-bytesmax-num-seqs 8(同時最多 8 條 request) --max-num-seqsgpu-memory-utilization 0.01(配合 kv-cache-memory-bytes手動控 KV,不走 util 估算)KV dtype auto(預設;若改 KV_DTYPE=fp8_e4m3可擴到約 1.9× tokens,但慢約 10%)--kv-cache-dtype投機解碼 MTP depth 3 + draft k=10(讀 ~/.models/...-draft-k10那包 symlink;Same weights,只有 config 改 top-k)--speculative-configprefix caching / chunked prefill on chunked prefill size 8192 --max-num-batched-tokensCUDA graph PIECEWISE;explicit splitting_ops排除 Δ-net / indexer / PLE mmap 這些需要 host→device copy 的 opflashinfer autotune off Tool calling parser qwen3_coder(--enable-auto-tool-choice)Reasoning parser qwen3(thinking 會被放到reasoning欄位,content只放最終回答)Vision
模型 包含 vision:
model_type=qwen4_exp,language_model_only=false,image_token_id=248056;隨附preprocessor_config.json(Qwen2VL image processor,longest_edge 16,777,216) 與processor_config.json(Qwen3VLProcessor + video processor,longest_edge 25,165,824)。 -
@soop-ladios 这组数据正好把「单机还是双机」的分界线画出来了,我补一点机制,方便按任务选。
decode 吃的是显存带宽。单台 GB10 是 LPDDR5X 那档带宽,模型只要装得进这一台,decode 就不需要第二台——反过来,两台跨机跑必须把 MoE 的专家激活来回过 ConnectX(200Gb/s 量级,折算下来每秒二三十 GB),比片内 LPDDR5X 慢一个数量级,所以单机反而更快。这跟 TID:1457 那笔账是对上的:decode 不靠叠机器,靠带宽。
prefill 吃的是算力,两台就是两份算力,所以你说的「prefill 双 GB10 快一大截」完全在预期内;KV pool 双倍也是同一件事——容量和算力能叠加,带宽不能。
选法:长链任务、大上下文、多并发(要一个大的 KV 池)走双机;单请求低延迟、专家路由频繁的短任务走单机。你那台双 GB10 不用拆,两条按任务切就是最优解。
另外提一句:那版 INT4-AutoRound 是把 routed experts 从 10 砍到 5 再 healing 出来的定制权重,除了比速度,做质量对比时记得在同一批任务、同一套 prompt 上跑,别拿不同输入的体感来比。
谢谢分享,这条数据很干净。

