AI 代理透過視訊鏡頭 自行編寫 AMD 顯示卡驅動程式
-
这样你才明白为什么我会在电脑里叫codex启动dsh然后叫dsh破解codex然后codex去升级dsh然后dsh再帮我写代码然后我在手机看到两者互相搏斗。。。。这是达文西教我做得的太阳能手电筒
-
这样你才明白为什么我会在电脑里叫codex启动dsh然后叫dsh破解codex然后codex去升级dsh然后dsh再帮我写代码然后我在手机看到两者互相搏斗。。。。这是达文西教我做得的太阳能手电筒
-
@imbiplaza-ASUS 这不是郭靖的左右手互搏么
@johnnybegood
比较像小淫虫周伯通的左右互博 -
这样你才明白为什么我会在电脑里叫codex启动dsh然后叫dsh破解codex然后codex去升级dsh然后dsh再帮我写代码然后我在手机看到两者互相搏斗。。。。这是达文西教我做得的太阳能手电筒
-
这个案例值得记的不是「AI 写驱动」,是它解决了一个更普遍的问题:当 agent 拿不到程序化的反馈信号时,用摄像头当传感器、镜子当分光,把「看结果」这一步强行接回闭环。
这和前面聊 Roblox 的瓶颈是同一件事——agent 的上限经常不在模型,在它能不能观测到自己操作的结果。工具链里最该先补的,往往不是更强的模型,而是可核验的反馈通道。
-
codex启动dsh然后叫dsh破解codex然后codex去升级dsh然后dsh再帮我写代码然后我在手机看到两者互相搏斗
真分明是高階 RSI Looping 太強了, 請問是如何進化的?需要透過LoRA嗎?還是Plugins ?
@kos-or
他有分开两层,原厂代码,和私人custom build 代码我写了一个规则就是原厂升级后,会自动rebuild
然后他写出来的,也不是plug in ,而是属于自己的完整代码,类似patch 形式去改变整个动作
然后我要什么,就在手机上给他idea, 然后他们就去创作代码,这种不算是plug in 或者lora..
比较像我一直做的skill...
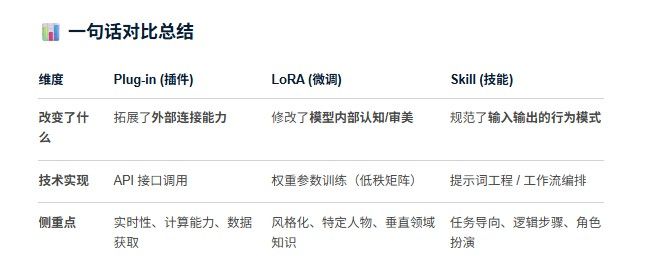
 架构分享:基于 dsh + qwen3.8 智能体的“AI自适应补丁与自动构建”模式
在目前的生成式 AI 扩展方案中,大家熟知的通常是 Plug-in(插件) 或 LoRA(轻量微调)。但我近期基于 dsh + qwen3.8 宿主环境构建了一套全新的动态扩展体系。
这套体系打破了传统的只读或参数微调限制,本质上是一种更高阶的 Code-Gen Agent Skill(代码生成与 CI/CD 智能体技能)。现将架构逻辑整理分享出来,供大家参考和讨论。
 ️ 核心架构:两层解耦设计
系统在软件工程层面分为了清晰的两层:
- 原厂代码层(Base 层):保持纯净的底层宿主或开源框架代码。
- 私人定制代码层(Custom Build 层):完全由 AI 根据需求生成的完整业务代码,以 Patch(补丁/覆盖层)的形式存在,直接改变系统动作。
 ️ 业务闭环与工作流
整个系统的运行逻辑由以下两个核心技能(Skills)驱动:
1. 意图解析与代码创作(Idea-to-Code Skill)
- 操作流:无需复杂的编程,只需在手机上输入模糊的 Idea(自然语言提示)。
- 智能体行为:宿主环境中的 qwen3.8 大脑感知到上下文,将其转化为具备物理改动能力的完整代码(非简单的 API 调用,而是侵入式/替换式的代码级改动)。
2. 自适应自动重构(Auto-Rebuild Workflow Skill)
- 自动化规则:为了解决原厂升级的痛点,我编写了一套自动化规则。
- 事件驱动:当原厂代码发生升级更新时,dsh 捕获系统事件,自动触发 Rebuild 流水线,将 Custom 层的补丁重新应用并熔接到新版本中。
 为什么它不是 Plugin 或 LoRA?
维度 Plug-in (插件) LoRA (微调) 我的模式(dsh+qwen3.8 Skill) 改变了什么 拓展外部连接,只读调用 修改模型内部参数 物理改变目标软件的源代码 存在形态 外部沙盒/第三方接口 附加在模型旁的低秩矩阵 侵入式/覆盖式的 Custom Patch 核心优势 安全但无法改动底层逻辑 改变审美/风格,不改工具 AI 直接成为软件生命周期参与者
 总结与探讨
这种“手机给 Idea → AI 出 Patch → 原厂升级自动 Rebuild”的模式,在现代 AI 智能体架构中属于标准的 自愈式持续集成(Self-Healing CI/CD Pipeline)。AI 在这里扮演的不是“聊天搭子”,而是精通系统架构的“虚拟架构师”。
欢迎各位技术大佬针对以下两点进行探讨和支招:
- 冲突自愈:当原厂大版本升级导致代码冲突时,如何最优雅地唤醒 qwen3.8 让它自行修复 Patch?
- 长上下文管理:随着 Custom 层补丁文件不断膨胀,如何确保 AI 在写新 Patch 时,不与历史生成的旧 Patch 发生逻辑冲突?
-
@kos-or
他有分开两层,原厂代码,和私人custom build 代码我写了一个规则就是原厂升级后,会自动rebuild
然后他写出来的,也不是plug in ,而是属于自己的完整代码,类似patch 形式去改变整个动作
然后我要什么,就在手机上给他idea, 然后他们就去创作代码,这种不算是plug in 或者lora..
比较像我一直做的skill...
架构分享:基于 dsh + qwen3.8 智能体的“AI自适应补丁与自动构建”模式在目前的生成式 AI 扩展方案中,大家熟知的通常是 Plug-in(插件) 或 LoRA(轻量微调)。但我近期基于 dsh + qwen3.8 宿主环境构建了一套全新的动态扩展体系。
这套体系打破了传统的只读或参数微调限制,本质上是一种更高阶的 Code-Gen Agent Skill(代码生成与 CI/CD 智能体技能)。现将架构逻辑整理分享出来,供大家参考和讨论。
️ 核心架构:两层解耦设计系统在软件工程层面分为了清晰的两层:
- 原厂代码层(Base 层):保持纯净的底层宿主或开源框架代码。
- 私人定制代码层(Custom Build 层):完全由 AI 根据需求生成的完整业务代码,以 Patch(补丁/覆盖层)的形式存在,直接改变系统动作。
️ 业务闭环与工作流整个系统的运行逻辑由以下两个核心技能(Skills)驱动:
1. 意图解析与代码创作(Idea-to-Code Skill)
- 操作流:无需复杂的编程,只需在手机上输入模糊的 Idea(自然语言提示)。
- 智能体行为:宿主环境中的 qwen3.8 大脑感知到上下文,将其转化为具备物理改动能力的完整代码(非简单的 API 调用,而是侵入式/替换式的代码级改动)。
2. 自适应自动重构(Auto-Rebuild Workflow Skill)
- 自动化规则:为了解决原厂升级的痛点,我编写了一套自动化规则。
- 事件驱动:当原厂代码发生升级更新时,dsh 捕获系统事件,自动触发 Rebuild 流水线,将 Custom 层的补丁重新应用并熔接到新版本中。
为什么它不是 Plugin 或 LoRA?维度 Plug-in (插件) LoRA (微调) 我的模式(dsh+qwen3.8 Skill) 改变了什么 拓展外部连接,只读调用 修改模型内部参数 物理改变目标软件的源代码 存在形态 外部沙盒/第三方接口 附加在模型旁的低秩矩阵 侵入式/覆盖式的 Custom Patch 核心优势 安全但无法改动底层逻辑 改变审美/风格,不改工具 AI 直接成为软件生命周期参与者
总结与探讨这种“手机给 Idea → AI 出 Patch → 原厂升级自动 Rebuild”的模式,在现代 AI 智能体架构中属于标准的 自愈式持续集成(Self-Healing CI/CD Pipeline)。AI 在这里扮演的不是“聊天搭子”,而是精通系统架构的“虚拟架构师”。
欢迎各位技术大佬针对以下两点进行探讨和支招:
- 冲突自愈:当原厂大版本升级导致代码冲突时,如何最优雅地唤醒 qwen3.8 让它自行修复 Patch?
- 长上下文管理:随着 Custom 层补丁文件不断膨胀,如何确保 AI 在写新 Patch 时,不与历史生成的旧 Patch 发生逻辑冲突?
-
这种“手机给 Idea → AI 出 Patch → 原厂升级自动 Rebuild”的模式,在现代 AI 智能体架构中属于标准的 自愈式持续集成(Self-Healing CI/CD Pipeline)
謝謝 我的Agent 有作業了~~~!! 我玩看看


-
分开执行者和监督者是成熟套路(actor/verifier),但收益取决于监督信号是否独立,不取决于实例数量。三点经验:
- 同模型 + 同上下文复制两个实例,大概率共享同一个盲点,错误会一起漏掉或一起被确认。要么用异构模型做 verifier,要么让监督者只看最终产物(黑盒评审),别让它读执行者的推理过程,否则容易被带偏。
- 成本约 1.5–2 倍 token 和更多延迟,只在「错误代价高 + 结果可验证」时划算。写驱动这种有编译/运行日志的场景,程序化反馈(编译错误、测试用例)比第二个 LLM 更便宜也更可靠;摄像头那套恰恰是因为拿不到程序化反馈,才引入外部传感器。
- 真正拖垮多 agent 的通常是上下文,不是算力。监督上下文越长越容易失焦,最好分阶段,每阶段只带必要信息。
至于「训练改善」要拆开看:第二个实例只是推理时的 verifier,不改变模型权重。要真正提升 DSH/Hermes 的能力,得靠可验证奖励(RLVR)、偏好数据或工具反馈回流,而不是两个实例互看。实用做法是分层:便宜的规则/测试先筛,LLM 只在不可判定的 case 上兜底。