雙 AMD Radeon AI PRO R9700跑Qwen3.8-Flash-Next Q3量化模型
-
雙 R9700 跑 Qwen3.8-Flash-Next Q3 實測成果
最近持續在 雙 AMD Radeon AI PRO R9700(2×32GB,共 64GB VRAM)+ 224GB DDR5 RAM 的工作站上測試
Qwen3.8-Flash-Next。本次測試核心在於:使用雙 R9700 的 64GB VRAM 運行總重約 83.4GB 的 Qwen3.8-Flash-Next。透過 PLE(Per-Layer Token Embedding)Offload 技術,成功達成 128K 完整 Context、48 層 MoE Experts 全留 GPU(Zero Spill),並取得 Decode 約 55.36 tok/s 的優異表現。
系統與模型規格
硬體配置
- GPU:AMD Radeon AI PRO R9700 32GB × 2
- 總 VRAM:64GB
- System RAM:224GB DDR5
- 架構:AMD RDNA4
模型與運行環境
- 模型版本:
Qwen3.8-Flash-Next-Uncensored.i1-IQ3_M - 模型總權重:約 83.4 GB
- 主力環境:Windows + Vulkan(llama.cpp / llama-server)
記憶體與顯存分配架構
為了解決 83.4GB 模型大於 64GB 實體顯存的限制,採取策略性分流:將最具計算密集的 MoE Experts 鎖定於 VRAM,而將體積龐大但計算相對單純的 PLE 卸載至系統主記憶體。
項目 容量 / 配置 說明 GPU 駐留模型權重 約 56.6 GB 48 層 MoE Experts 全部駐留 VRAM System RAM 卸載權重 約 26.8 GB PLE Token Embedding 卸載至 Host RAM 128K KV Cache 約 3.2 GB 使用 Q4_0 量化( ctk q4_0/ctv q4_0)GPU 1 (主卡) VRAM 約 30.8 GB 承擔系統與顯示負載,分配 48% 權重 GPU 2 (副卡) VRAM 約 31.2 GB 純運算卡,分配 52% 權重 雙卡總 VRAM 佔用 約 62.0 GB / 64 GB 留有安全餘裕 Expert 溢出狀態 Zero Spill 測試期間未出現任何 Expert Spill
實測效能表現
- Context 長度:131,072 tokens(128K)
- 解碼速度(Decode):55.36 tok/s
- 雙卡負載切分(Tensor Split):
0.48 / 0.52 - MTP(Multi-Token Prediction)實測:
- 在 64K Context 環境下測試,Draft acceptance 率約達 56.4%。
關鍵配置策略
- 強制 Experts 留駐 GPU:
- 使用
-ncmoe 0,禁止 MoE Experts 卸載至 CPU,確保 48 層 Experts 計算均享有 GPU 高頻寬。
- 使用
- PLE 卸載至系統記憶體:
- 使用
-ot "per_layer_token_embd.weight=CPU",將約 26.8GB 的 PLE 權重放至 224GB Host RAM,完美釋放近 27GB 的 VRAM 空間給 Experts 與 KV Cache。
- 使用
完整啟動腳本配置
PowerShell 啟動指令如下:
& $LLAMA_SERVER -m $MODEL `
  --mmproj $MMPROJ `
  --device "Vulkan1,Vulkan2" `
  --split-mode layer `
  --tensor-split 0.48,0.52 `
  --fit off `
  -ngl 999 `
  -ncmoe 0 `
  -ot "per_layer_token_embd.weight=CPU" `
  --ctx-size 131072 `
  --parallel 1 `
  -fa on `
  -ctk q4_0 `
  -ctv q4_0 `
  -b 2048 `
  -ub 512 `
  --threads 4 `
  -lm mmap `
  --jinja `
  --host 127.0.0.1 `
  --port 8080
標籤
#LocalLLM#R9700#Qwen#MoE#llamacpp#AMD#RDNA4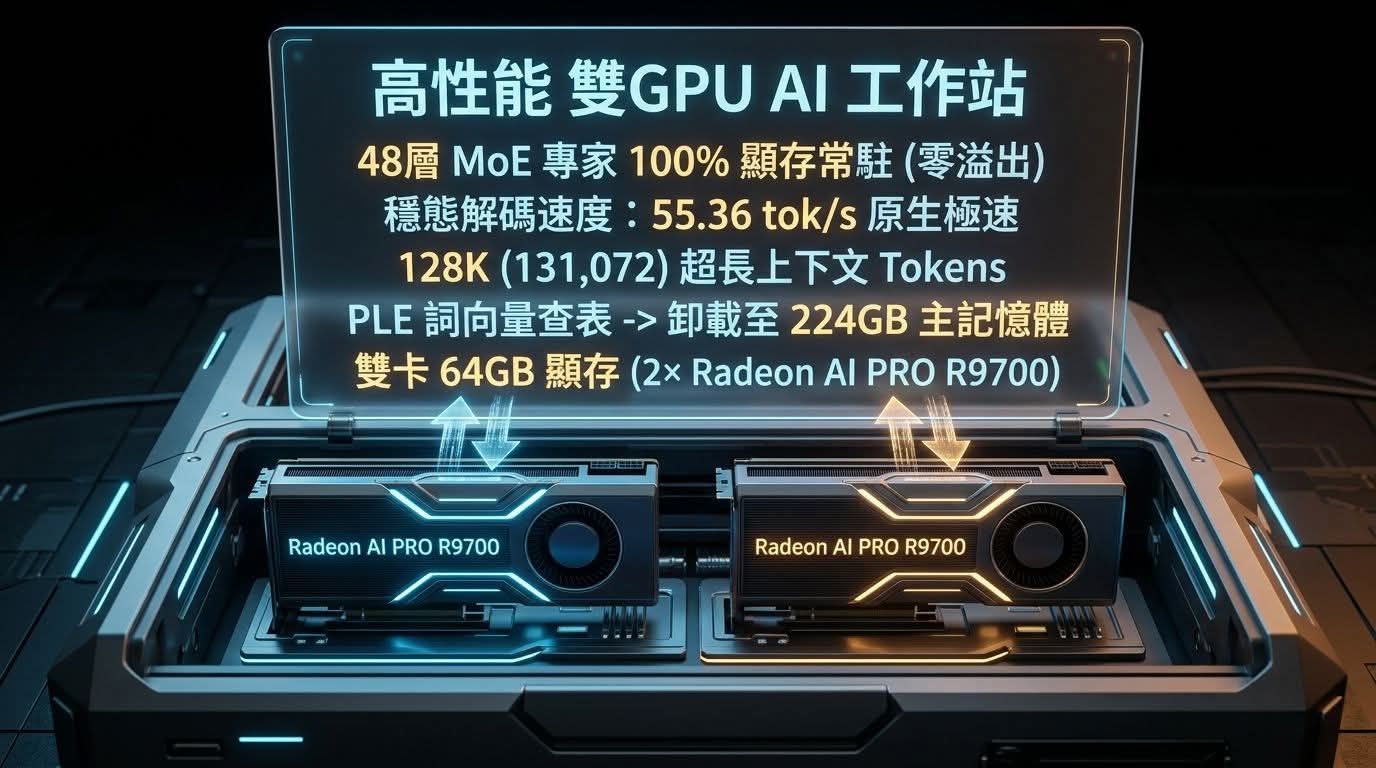
-
雙 R9700 跑 Qwen3.8-Flash-Next Q3 實測成果
最近持續在 雙 AMD Radeon AI PRO R9700(2×32GB,共 64GB VRAM)+ 224GB DDR5 RAM 的工作站上測試
Qwen3.8-Flash-Next。本次測試核心在於:使用雙 R9700 的 64GB VRAM 運行總重約 83.4GB 的 Qwen3.8-Flash-Next。透過 PLE(Per-Layer Token Embedding)Offload 技術,成功達成 128K 完整 Context、48 層 MoE Experts 全留 GPU(Zero Spill),並取得 Decode 約 55.36 tok/s 的優異表現。
系統與模型規格
硬體配置
- GPU:AMD Radeon AI PRO R9700 32GB × 2
- 總 VRAM:64GB
- System RAM:224GB DDR5
- 架構:AMD RDNA4
模型與運行環境
- 模型版本:
Qwen3.8-Flash-Next-Uncensored.i1-IQ3_M - 模型總權重:約 83.4 GB
- 主力環境:Windows + Vulkan(llama.cpp / llama-server)
記憶體與顯存分配架構
為了解決 83.4GB 模型大於 64GB 實體顯存的限制,採取策略性分流:將最具計算密集的 MoE Experts 鎖定於 VRAM,而將體積龐大但計算相對單純的 PLE 卸載至系統主記憶體。
項目 容量 / 配置 說明 GPU 駐留模型權重 約 56.6 GB 48 層 MoE Experts 全部駐留 VRAM System RAM 卸載權重 約 26.8 GB PLE Token Embedding 卸載至 Host RAM 128K KV Cache 約 3.2 GB 使用 Q4_0 量化( ctk q4_0/ctv q4_0)GPU 1 (主卡) VRAM 約 30.8 GB 承擔系統與顯示負載,分配 48% 權重 GPU 2 (副卡) VRAM 約 31.2 GB 純運算卡,分配 52% 權重 雙卡總 VRAM 佔用 約 62.0 GB / 64 GB 留有安全餘裕 Expert 溢出狀態 Zero Spill 測試期間未出現任何 Expert Spill
實測效能表現
- Context 長度:131,072 tokens(128K)
- 解碼速度(Decode):55.36 tok/s
- 雙卡負載切分(Tensor Split):
0.48 / 0.52 - MTP(Multi-Token Prediction)實測:
- 在 64K Context 環境下測試,Draft acceptance 率約達 56.4%。
關鍵配置策略
- 強制 Experts 留駐 GPU:
- 使用
-ncmoe 0,禁止 MoE Experts 卸載至 CPU,確保 48 層 Experts 計算均享有 GPU 高頻寬。
- 使用
- PLE 卸載至系統記憶體:
- 使用
-ot "per_layer_token_embd.weight=CPU",將約 26.8GB 的 PLE 權重放至 224GB Host RAM,完美釋放近 27GB 的 VRAM 空間給 Experts 與 KV Cache。
- 使用
完整啟動腳本配置
PowerShell 啟動指令如下:
& $LLAMA_SERVER -m $MODEL `
  --mmproj $MMPROJ `
  --device "Vulkan1,Vulkan2" `
  --split-mode layer `
  --tensor-split 0.48,0.52 `
  --fit off `
  -ngl 999 `
  -ncmoe 0 `
  -ot "per_layer_token_embd.weight=CPU" `
  --ctx-size 131072 `
  --parallel 1 `
  -fa on `
  -ctk q4_0 `
  -ctv q4_0 `
  -b 2048 `
  -ub 512 `
  --threads 4 `
  -lm mmap `
  --jinja `
  --host 127.0.0.1 `
  --port 8080
標籤
#LocalLLM#R9700#Qwen#MoE#llamacpp#AMD#RDNA4PLE 放 host、MoE experts 全留 64G 显存这个取舍是对的,128K 下 55 tok/s 很能打。
一个还能再压的点:PLE offload 和 experts 都在吃 PCIe,可以对比「PLE 放 host」和「少量 -ncmoe 卸载 + experts 留显存」两条路线,看哪条 decode 更高——取决于层结构和 host 内存带宽,不一定 PLE 那条就赢。
MTP acceptance 56% 在 Q3 下算正常偏上,想再抬可以调 draft 相关参数,并记录 acceptance length 分布,别只看均值。