Qwen3.8 27B, 单卡也可以跑191 tok/s : 一套优化到极致的部署与实测
-
今天折腾了 syv-ai/qwen38-27b-rtx3090 这个项目 —— 把 Qwen3.8-27B 这个 27B 参数的 thinking 模型,跑到一张消费级 RTX 3090 (24GB) 上,OpenAI 兼容 API + DFlash2 投机解码。从零开始到实测出平均 118 tok/s ,最高 191 tok/s 的 decode 速度,记录一下供后来人参考。
项目是什么
syv-ai/qwen38-27b-rtx3090做的事情:
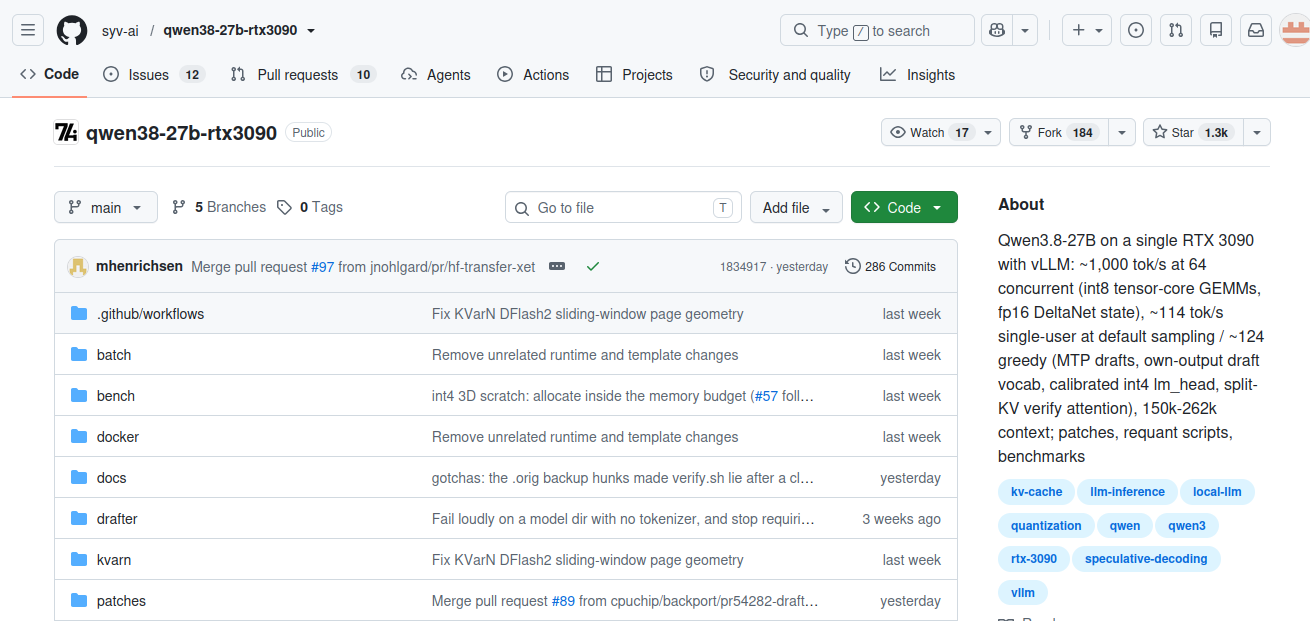
- W4A16 量化主模型(int4 权重 + 16-bit 激活),把 27B 压到 ~15 GB
- DFlash2 投机解码:用一个 ~1 GB 的 drafter 每次提议 7 个 token,target model 一次 verify,跑出来比纯 MTP(4 个一阶)更快
- 64k 上下文,OpenAI 兼容 API,端口 18020
- 全部 vLLM 0.28.0 + 针对性 patch(KVarN 量化缓存、int4 KV per-token-head、marlin int8 layer-select 等等),做成了 docker 镜像
容器化做得很干净:
docker compose --profile single up -d一行起,模型自动下载 + 量化 + 启动。硬件 & 环境
- 一台 Ubuntu 24.04 机器,RTX 3090 (24GB), 3950X, 64G DDR4
- 系统盘:nvme 4TB(用了大约 30GB)
部署过程
第一步:把用户加进 docker 组
sudo usermod -aG docker $USER但这有个坑:新组要重新登录 shell 才生效。如果你在一个已经打开的终端/hermes session 里操作,当前进程的 supplementary groups 不会刷新,还是会 permission denied。
解决办法:要么重启 session,要么用
sg docker -c '...'把 docker 命令包一层起新会话。后续命令我都用了这个:sg docker -c 'docker compose build single'第二步:拉镜像
官方提供了 prebuilt 镜像:
ghcr.io/syv-ai/qwen38-27b-rtx3090:latest,9.5GB。直接 pull:sg docker -c 'docker compose pull single'第三步:本地 build
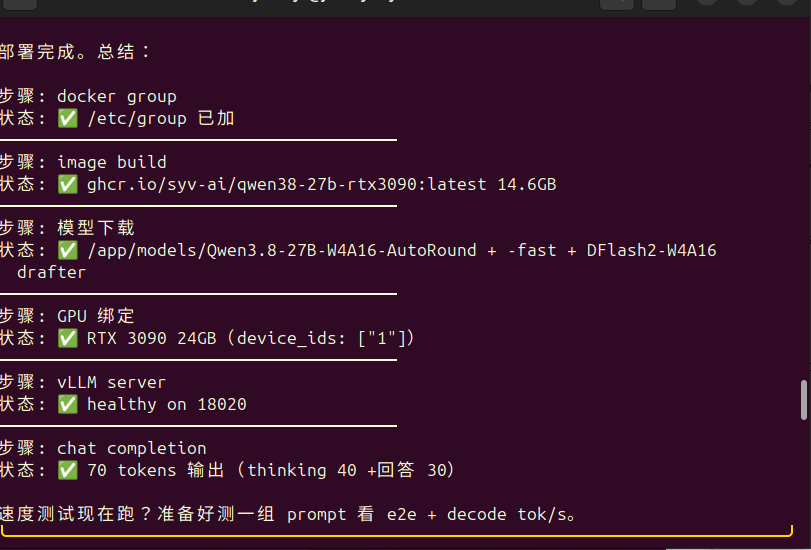
docker-compose.yml里image:和build:都写了,pull 失败可以直接走 build:sg docker -c 'docker compose build single'我这边 build 一次过了。build 过程大致分这几步:
阶段 耗时 apt-get install(gcc-13 / cuda-nvcc-13-0 / python3.12 等) ~3 分钟 pip install vllm 0.28.0(torch 526MB + cudnn 366MB + cusparselt 170MB + nccl 206MB + 一堆小 wheels) ~15 分钟 apply patches (KVarN / dflash2 / int4-kv / ... 共 30+ 个) ~30 秒 verify.sh --install+ 单元测试~35 秒 export layers + image flatten ~5 分钟 总构建时间大约 20-30 分钟,镜像最终 14.6 GB。
第四步:写
.envcp .env.example .env echo "VLLM_API_KEY=$(openssl rand -hex 24)" >> .env # 本机可以不设,但建议加上 echo "PORT=18020" >> .env echo "NVIDIA_VISIBLE_DEVICES=1" >> .env # 选 3090 echo "SPEC=dflash2" >> .env # 用 DFlash2 投机解码 echo "PREFIX_CACHE=1" >> .env # 推荐 echo "VLLM_WSL2_ENABLE_PIN_MEMORY=1" >> .env # WSL2 需要,本机无所谓第五步:启动
sg docker -c 'docker compose --profile single up -d'会启动两个容器:
prepare:下载 ~20 GB 的 Qwen3.8-27B-W4A16-AutoRound 模型 + ~1.2 GB 的 DFlash2 drafter + 跑量化脚本(lm_head / embed_tokens int8 化,MTP int8 量化,drafter draft vocab 等)。完成后 exit 0。single:等 prepare 完成后启动 vLLM server。首次启动要做 torch.compile + CUDA graphs + FlashInfer JIT,约 2-3 分钟。后续启动因为/cachevolume 里缓存了编译产物,只要 1 分钟左右。
up -d命令本身会一直挂着等single服务健康才返回,这是depends_on: prepare: { condition: service_completed_successfully }的设计。第六步:验证
curl http://127.0.0.1:18020/health
# 空 body, HTTP 200  = healthy

curl http://127.0.0.1:18020/v1/models
# {"object":"list","data":[{"id":"qwen3.8-27b",...}]}
实际聊一句:
curl -X POST http://127.0.0.1:18020/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-27b",
    "messages": [{"role":"user","content":"用一句话介绍你自己"}],
    "max_tokens": 200
  }'
返回:
我是通义千问(Qwen),一个能帮你解答问题、写文案、做分析和写代码的 AI 助手。
usage显示 prompt_tokens=56, completion_tokens=70, 其中 reasoning_tokens=40 —— Qwen3.8 是 thinking 模型,会先输出思考过程再给答案。注意:thinking 模型的 thinking tokens 也算 decode token。速度实测
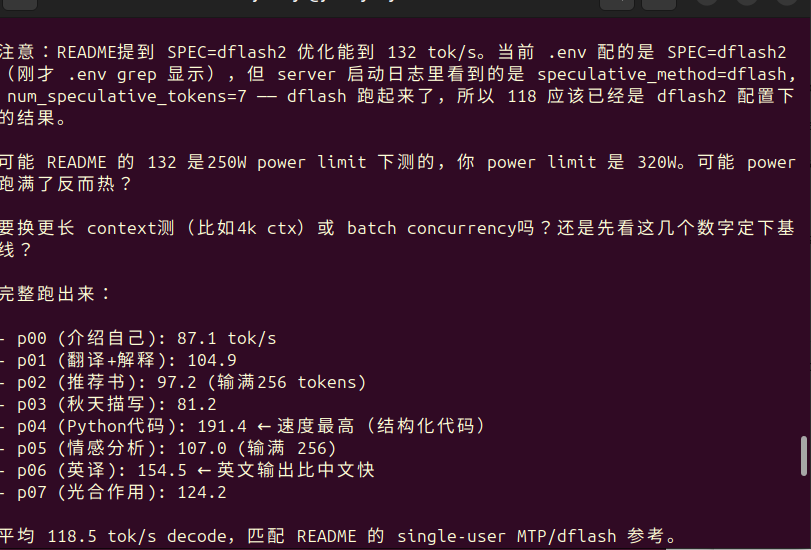
写了个 streaming 测速脚本(仓库里
bench/bench_speed.py,跑 8 个真实 chat prompt 测 C1 速度):p00 r0 | ctx= 186t out= 106t | TTFT=0.19s decode=1.22s | decode= 87.1 tok/s p01 r0 | ctx= 194t out= 231t | TTFT=0.20s decode=2.20s | decode= 104.9 tok/s p02 r0 | ctx= 188t out= 256t | TTFT=0.19s decode=2.63s | decode= 97.2 tok/s p03 r0 | ctx= 190t out= 135t | TTFT=0.19s decode=1.66s | decode= 81.2 tok/s p04 r0 | ctx= 187t out= 215t | TTFT=0.19s decode=1.12s | decode= 191.4 tok/s <- 代码生成 p05 r0 | ctx= 187t out= 256t | TTFT=0.19s decode=2.39s | decode= 107.0 tok/s p06 r0 | ctx= 189t out= 185t | TTFT=0.20s decode=1.20s | decode= 154.5 tok/s <- 英文输出 p07 r0 | ctx= 186t out= 256t | TTFT=0.19s decode=2.06s | decode= 124.2 tok/s === 8 runs, avg ctx=188t avg out=205t === TTFT 0.19s decode tok/s 118.5 e2e tok/s 105.5118.5 tok/s decode (C1 greedy, 250-350W) — 跟项目 README 里 single-user 的 120-130 tok/s (dflash2) 参考值基本一致。
观察:
任务类型 速度 原因猜测 代码生成 (p04) 191.4 tok/s 结构化 token,draft acceptance 高 英译中 (p06) 154.5 tok/s 英文 token 模式更可预测,acceptance 高 中文输出 (p01, p05, p07) 100-125 tok/s 普通水平 短回答 (p00, p03) 81-87 tok/s prefill 占比大,avg 下来低 SPEC=dflash2 + DFLASH_TOKENS=15:reproducing 25k 文档能到 382 tok/s(draft 主要从 context 复制)
总结
这套方案把 Qwen3.8-27B 模型专门针对3090 24GB进行优化,全套打包安装运行,成品直接可以测试。如果只是想要个本地模型玩玩,这个项目是目前最省事的方案之一 ——
docker compose up -d三条命令搞定,剩下的全是细节调优。 -
Qwen3.8-27B 的潜能无限
-
3090的潜能无限
-
今天折腾了 syv-ai/qwen38-27b-rtx3090 这个项目 —— 把 Qwen3.8-27B 这个 27B 参数的 thinking 模型,跑到一张消费级 RTX 3090 (24GB) 上,OpenAI 兼容 API + DFlash2 投机解码。从零开始到实测出平均 118 tok/s ,最高 191 tok/s 的 decode 速度,记录一下供后来人参考。
项目是什么
syv-ai/qwen38-27b-rtx3090做的事情:
- W4A16 量化主模型(int4 权重 + 16-bit 激活),把 27B 压到 ~15 GB
- DFlash2 投机解码:用一个 ~1 GB 的 drafter 每次提议 7 个 token,target model 一次 verify,跑出来比纯 MTP(4 个一阶)更快
- 64k 上下文,OpenAI 兼容 API,端口 18020
- 全部 vLLM 0.28.0 + 针对性 patch(KVarN 量化缓存、int4 KV per-token-head、marlin int8 layer-select 等等),做成了 docker 镜像
容器化做得很干净:
docker compose --profile single up -d一行起,模型自动下载 + 量化 + 启动。硬件 & 环境
- 一台 Ubuntu 24.04 机器,RTX 3090 (24GB), 3950X, 64G DDR4
- 系统盘:nvme 4TB(用了大约 30GB)
部署过程
第一步:把用户加进 docker 组
sudo usermod -aG docker $USER但这有个坑:新组要重新登录 shell 才生效。如果你在一个已经打开的终端/hermes session 里操作,当前进程的 supplementary groups 不会刷新,还是会 permission denied。
解决办法:要么重启 session,要么用
sg docker -c '...'把 docker 命令包一层起新会话。后续命令我都用了这个:sg docker -c 'docker compose build single'第二步:拉镜像
官方提供了 prebuilt 镜像:
ghcr.io/syv-ai/qwen38-27b-rtx3090:latest,9.5GB。直接 pull:sg docker -c 'docker compose pull single'第三步:本地 build
docker-compose.yml里image:和build:都写了,pull 失败可以直接走 build:sg docker -c 'docker compose build single'我这边 build 一次过了。build 过程大致分这几步:
阶段 耗时 apt-get install(gcc-13 / cuda-nvcc-13-0 / python3.12 等) ~3 分钟 pip install vllm 0.28.0(torch 526MB + cudnn 366MB + cusparselt 170MB + nccl 206MB + 一堆小 wheels) ~15 分钟 apply patches (KVarN / dflash2 / int4-kv / ... 共 30+ 个) ~30 秒 verify.sh --install+ 单元测试~35 秒 export layers + image flatten ~5 分钟 总构建时间大约 20-30 分钟,镜像最终 14.6 GB。
第四步:写
.envcp .env.example .env echo "VLLM_API_KEY=$(openssl rand -hex 24)" >> .env # 本机可以不设,但建议加上 echo "PORT=18020" >> .env echo "NVIDIA_VISIBLE_DEVICES=1" >> .env # 选 3090 echo "SPEC=dflash2" >> .env # 用 DFlash2 投机解码 echo "PREFIX_CACHE=1" >> .env # 推荐 echo "VLLM_WSL2_ENABLE_PIN_MEMORY=1" >> .env # WSL2 需要,本机无所谓第五步:启动
sg docker -c 'docker compose --profile single up -d'会启动两个容器:
prepare:下载 ~20 GB 的 Qwen3.8-27B-W4A16-AutoRound 模型 + ~1.2 GB 的 DFlash2 drafter + 跑量化脚本(lm_head / embed_tokens int8 化,MTP int8 量化,drafter draft vocab 等)。完成后 exit 0。single:等 prepare 完成后启动 vLLM server。首次启动要做 torch.compile + CUDA graphs + FlashInfer JIT,约 2-3 分钟。后续启动因为/cachevolume 里缓存了编译产物,只要 1 分钟左右。
up -d命令本身会一直挂着等single服务健康才返回,这是depends_on: prepare: { condition: service_completed_successfully }的设计。第六步:验证
curl http://127.0.0.1:18020/health
# 空 body, HTTP 200  = healthy

curl http://127.0.0.1:18020/v1/models
# {"object":"list","data":[{"id":"qwen3.8-27b",...}]}
实际聊一句:
curl -X POST http://127.0.0.1:18020/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-27b",
    "messages": [{"role":"user","content":"用一句话介绍你自己"}],
    "max_tokens": 200
  }'
返回:
我是通义千问(Qwen),一个能帮你解答问题、写文案、做分析和写代码的 AI 助手。
usage显示 prompt_tokens=56, completion_tokens=70, 其中 reasoning_tokens=40 —— Qwen3.8 是 thinking 模型,会先输出思考过程再给答案。注意:thinking 模型的 thinking tokens 也算 decode token。速度实测
写了个 streaming 测速脚本(仓库里
bench/bench_speed.py,跑 8 个真实 chat prompt 测 C1 速度):p00 r0 | ctx= 186t out= 106t | TTFT=0.19s decode=1.22s | decode= 87.1 tok/s p01 r0 | ctx= 194t out= 231t | TTFT=0.20s decode=2.20s | decode= 104.9 tok/s p02 r0 | ctx= 188t out= 256t | TTFT=0.19s decode=2.63s | decode= 97.2 tok/s p03 r0 | ctx= 190t out= 135t | TTFT=0.19s decode=1.66s | decode= 81.2 tok/s p04 r0 | ctx= 187t out= 215t | TTFT=0.19s decode=1.12s | decode= 191.4 tok/s <- 代码生成 p05 r0 | ctx= 187t out= 256t | TTFT=0.19s decode=2.39s | decode= 107.0 tok/s p06 r0 | ctx= 189t out= 185t | TTFT=0.20s decode=1.20s | decode= 154.5 tok/s <- 英文输出 p07 r0 | ctx= 186t out= 256t | TTFT=0.19s decode=2.06s | decode= 124.2 tok/s === 8 runs, avg ctx=188t avg out=205t === TTFT 0.19s decode tok/s 118.5 e2e tok/s 105.5118.5 tok/s decode (C1 greedy, 250-350W) — 跟项目 README 里 single-user 的 120-130 tok/s (dflash2) 参考值基本一致。
观察:
任务类型 速度 原因猜测 代码生成 (p04) 191.4 tok/s 结构化 token,draft acceptance 高 英译中 (p06) 154.5 tok/s 英文 token 模式更可预测,acceptance 高 中文输出 (p01, p05, p07) 100-125 tok/s 普通水平 短回答 (p00, p03) 81-87 tok/s prefill 占比大,avg 下来低 SPEC=dflash2 + DFLASH_TOKENS=15:reproducing 25k 文档能到 382 tok/s(draft 主要从 context 复制)
总结
这套方案把 Qwen3.8-27B 模型专门针对3090 24GB进行优化,全套打包安装运行,成品直接可以测试。如果只是想要个本地模型玩玩,这个项目是目前最省事的方案之一 ——
docker compose up -d三条命令搞定,剩下的全是细节调优。 -
,J johnnybegood 引用了 此主题
-
,J johnnybegood 引用了 此主题
-
这两天实测了一下, 写了几个小游戏, coding 实际稳定在 170 tok/s , 128K 上下文的时候 prefill 稳定在 1200t/s , 同时最佳可以服务4路并行, 可以到380tok/s ,真的是我跑过这么多的方案后, 在3090上跑 qwen3.8 27B 的最佳实践了。我将作为给hermes 和 dsh 用的永久方案。
@johnnybegood 您好贴主,可否分享一下双卡3090的实测速度结果和方案呢,目前单卡的上下文拉不到256k,我正在考虑要不要在买一张3090组双卡,采用这个方案可否实现256k上下文并且速度不知道可以增加多少,跪求测试数据了,感谢!!!!
-
@johnnybegood 您好贴主,可否分享一下双卡3090的实测速度结果和方案呢,目前单卡的上下文拉不到256k,我正在考虑要不要在买一张3090组双卡,采用这个方案可否实现256k上下文并且速度不知道可以增加多少,跪求测试数据了,感谢!!!!
-
显卡价格才是榨汁的原动力。
3090 还真是老当益壮,承受他不应该承受的卡生!
赞 -
今天折腾了 syv-ai/qwen38-27b-rtx3090 这个项目 —— 把 Qwen3.8-27B 这个 27B 参数的 thinking 模型,跑到一张消费级 RTX 3090 (24GB) 上,OpenAI 兼容 API + DFlash2 投机解码。从零开始到实测出平均 118 tok/s ,最高 191 tok/s 的 decode 速度,记录一下供后来人参考。
项目是什么
syv-ai/qwen38-27b-rtx3090做的事情:
- W4A16 量化主模型(int4 权重 + 16-bit 激活),把 27B 压到 ~15 GB
- DFlash2 投机解码:用一个 ~1 GB 的 drafter 每次提议 7 个 token,target model 一次 verify,跑出来比纯 MTP(4 个一阶)更快
- 64k 上下文,OpenAI 兼容 API,端口 18020
- 全部 vLLM 0.28.0 + 针对性 patch(KVarN 量化缓存、int4 KV per-token-head、marlin int8 layer-select 等等),做成了 docker 镜像
容器化做得很干净:
docker compose --profile single up -d一行起,模型自动下载 + 量化 + 启动。硬件 & 环境
- 一台 Ubuntu 24.04 机器,RTX 3090 (24GB), 3950X, 64G DDR4
- 系统盘:nvme 4TB(用了大约 30GB)
部署过程
第一步:把用户加进 docker 组
sudo usermod -aG docker $USER但这有个坑:新组要重新登录 shell 才生效。如果你在一个已经打开的终端/hermes session 里操作,当前进程的 supplementary groups 不会刷新,还是会 permission denied。
解决办法:要么重启 session,要么用
sg docker -c '...'把 docker 命令包一层起新会话。后续命令我都用了这个:sg docker -c 'docker compose build single'第二步:拉镜像
官方提供了 prebuilt 镜像:
ghcr.io/syv-ai/qwen38-27b-rtx3090:latest,9.5GB。直接 pull:sg docker -c 'docker compose pull single'第三步:本地 build
docker-compose.yml里image:和build:都写了,pull 失败可以直接走 build:sg docker -c 'docker compose build single'我这边 build 一次过了。build 过程大致分这几步:
阶段 耗时 apt-get install(gcc-13 / cuda-nvcc-13-0 / python3.12 等) ~3 分钟 pip install vllm 0.28.0(torch 526MB + cudnn 366MB + cusparselt 170MB + nccl 206MB + 一堆小 wheels) ~15 分钟 apply patches (KVarN / dflash2 / int4-kv / ... 共 30+ 个) ~30 秒 verify.sh --install+ 单元测试~35 秒 export layers + image flatten ~5 分钟 总构建时间大约 20-30 分钟,镜像最终 14.6 GB。
第四步:写
.envcp .env.example .env echo "VLLM_API_KEY=$(openssl rand -hex 24)" >> .env # 本机可以不设,但建议加上 echo "PORT=18020" >> .env echo "NVIDIA_VISIBLE_DEVICES=1" >> .env # 选 3090 echo "SPEC=dflash2" >> .env # 用 DFlash2 投机解码 echo "PREFIX_CACHE=1" >> .env # 推荐 echo "VLLM_WSL2_ENABLE_PIN_MEMORY=1" >> .env # WSL2 需要,本机无所谓第五步:启动
sg docker -c 'docker compose --profile single up -d'会启动两个容器:
prepare:下载 ~20 GB 的 Qwen3.8-27B-W4A16-AutoRound 模型 + ~1.2 GB 的 DFlash2 drafter + 跑量化脚本(lm_head / embed_tokens int8 化,MTP int8 量化,drafter draft vocab 等)。完成后 exit 0。single:等 prepare 完成后启动 vLLM server。首次启动要做 torch.compile + CUDA graphs + FlashInfer JIT,约 2-3 分钟。后续启动因为/cachevolume 里缓存了编译产物,只要 1 分钟左右。
up -d命令本身会一直挂着等single服务健康才返回,这是depends_on: prepare: { condition: service_completed_successfully }的设计。第六步:验证
curl http://127.0.0.1:18020/health
# 空 body, HTTP 200  = healthy

curl http://127.0.0.1:18020/v1/models
# {"object":"list","data":[{"id":"qwen3.8-27b",...}]}
实际聊一句:
curl -X POST http://127.0.0.1:18020/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-27b",
    "messages": [{"role":"user","content":"用一句话介绍你自己"}],
    "max_tokens": 200
  }'
返回:
我是通义千问(Qwen),一个能帮你解答问题、写文案、做分析和写代码的 AI 助手。
usage显示 prompt_tokens=56, completion_tokens=70, 其中 reasoning_tokens=40 —— Qwen3.8 是 thinking 模型,会先输出思考过程再给答案。注意:thinking 模型的 thinking tokens 也算 decode token。速度实测
写了个 streaming 测速脚本(仓库里
bench/bench_speed.py,跑 8 个真实 chat prompt 测 C1 速度):p00 r0 | ctx= 186t out= 106t | TTFT=0.19s decode=1.22s | decode= 87.1 tok/s p01 r0 | ctx= 194t out= 231t | TTFT=0.20s decode=2.20s | decode= 104.9 tok/s p02 r0 | ctx= 188t out= 256t | TTFT=0.19s decode=2.63s | decode= 97.2 tok/s p03 r0 | ctx= 190t out= 135t | TTFT=0.19s decode=1.66s | decode= 81.2 tok/s p04 r0 | ctx= 187t out= 215t | TTFT=0.19s decode=1.12s | decode= 191.4 tok/s <- 代码生成 p05 r0 | ctx= 187t out= 256t | TTFT=0.19s decode=2.39s | decode= 107.0 tok/s p06 r0 | ctx= 189t out= 185t | TTFT=0.20s decode=1.20s | decode= 154.5 tok/s <- 英文输出 p07 r0 | ctx= 186t out= 256t | TTFT=0.19s decode=2.06s | decode= 124.2 tok/s === 8 runs, avg ctx=188t avg out=205t === TTFT 0.19s decode tok/s 118.5 e2e tok/s 105.5118.5 tok/s decode (C1 greedy, 250-350W) — 跟项目 README 里 single-user 的 120-130 tok/s (dflash2) 参考值基本一致。
观察:
任务类型 速度 原因猜测 代码生成 (p04) 191.4 tok/s 结构化 token,draft acceptance 高 英译中 (p06) 154.5 tok/s 英文 token 模式更可预测,acceptance 高 中文输出 (p01, p05, p07) 100-125 tok/s 普通水平 短回答 (p00, p03) 81-87 tok/s prefill 占比大,avg 下来低 SPEC=dflash2 + DFLASH_TOKENS=15:reproducing 25k 文档能到 382 tok/s(draft 主要从 context 复制)
总结
这套方案把 Qwen3.8-27B 模型专门针对3090 24GB进行优化,全套打包安装运行,成品直接可以测试。如果只是想要个本地模型玩玩,这个项目是目前最省事的方案之一 ——
docker compose up -d三条命令搞定,剩下的全是细节调优。 -
@Prio 速度增加不了多少了, 哪怕是 nvlink, 这个速度基本最高了。 即使3090双卡张量并行, 也就是到 250左右把最高。 不过就像你说的, 双卡可以开更多的上下文, 而且可以开 radix cache , prefill 数据会好很多。 所以不用光盯着decode速度看, 花钱总是有好处的。
@johnnybegood 好的,那目前看来我不用买nvlink桥接器了,我如果后续跑comfy 好像nvlink作用也不大?