在 Proxmox VE 虚拟机 上,用AMD 官方 MXFP4 版与社区实测 INT4(AutoRound)版,vLLM 部署 Qwen3.8-27B 量化模型的(优化及局域网测速)。
-
AMD R9700 本地 AI 服务器 — vLLM 部署 Qwen3.8-27B 量化模型的优化。
1. 测试环境
客户端(局域网 Mac)
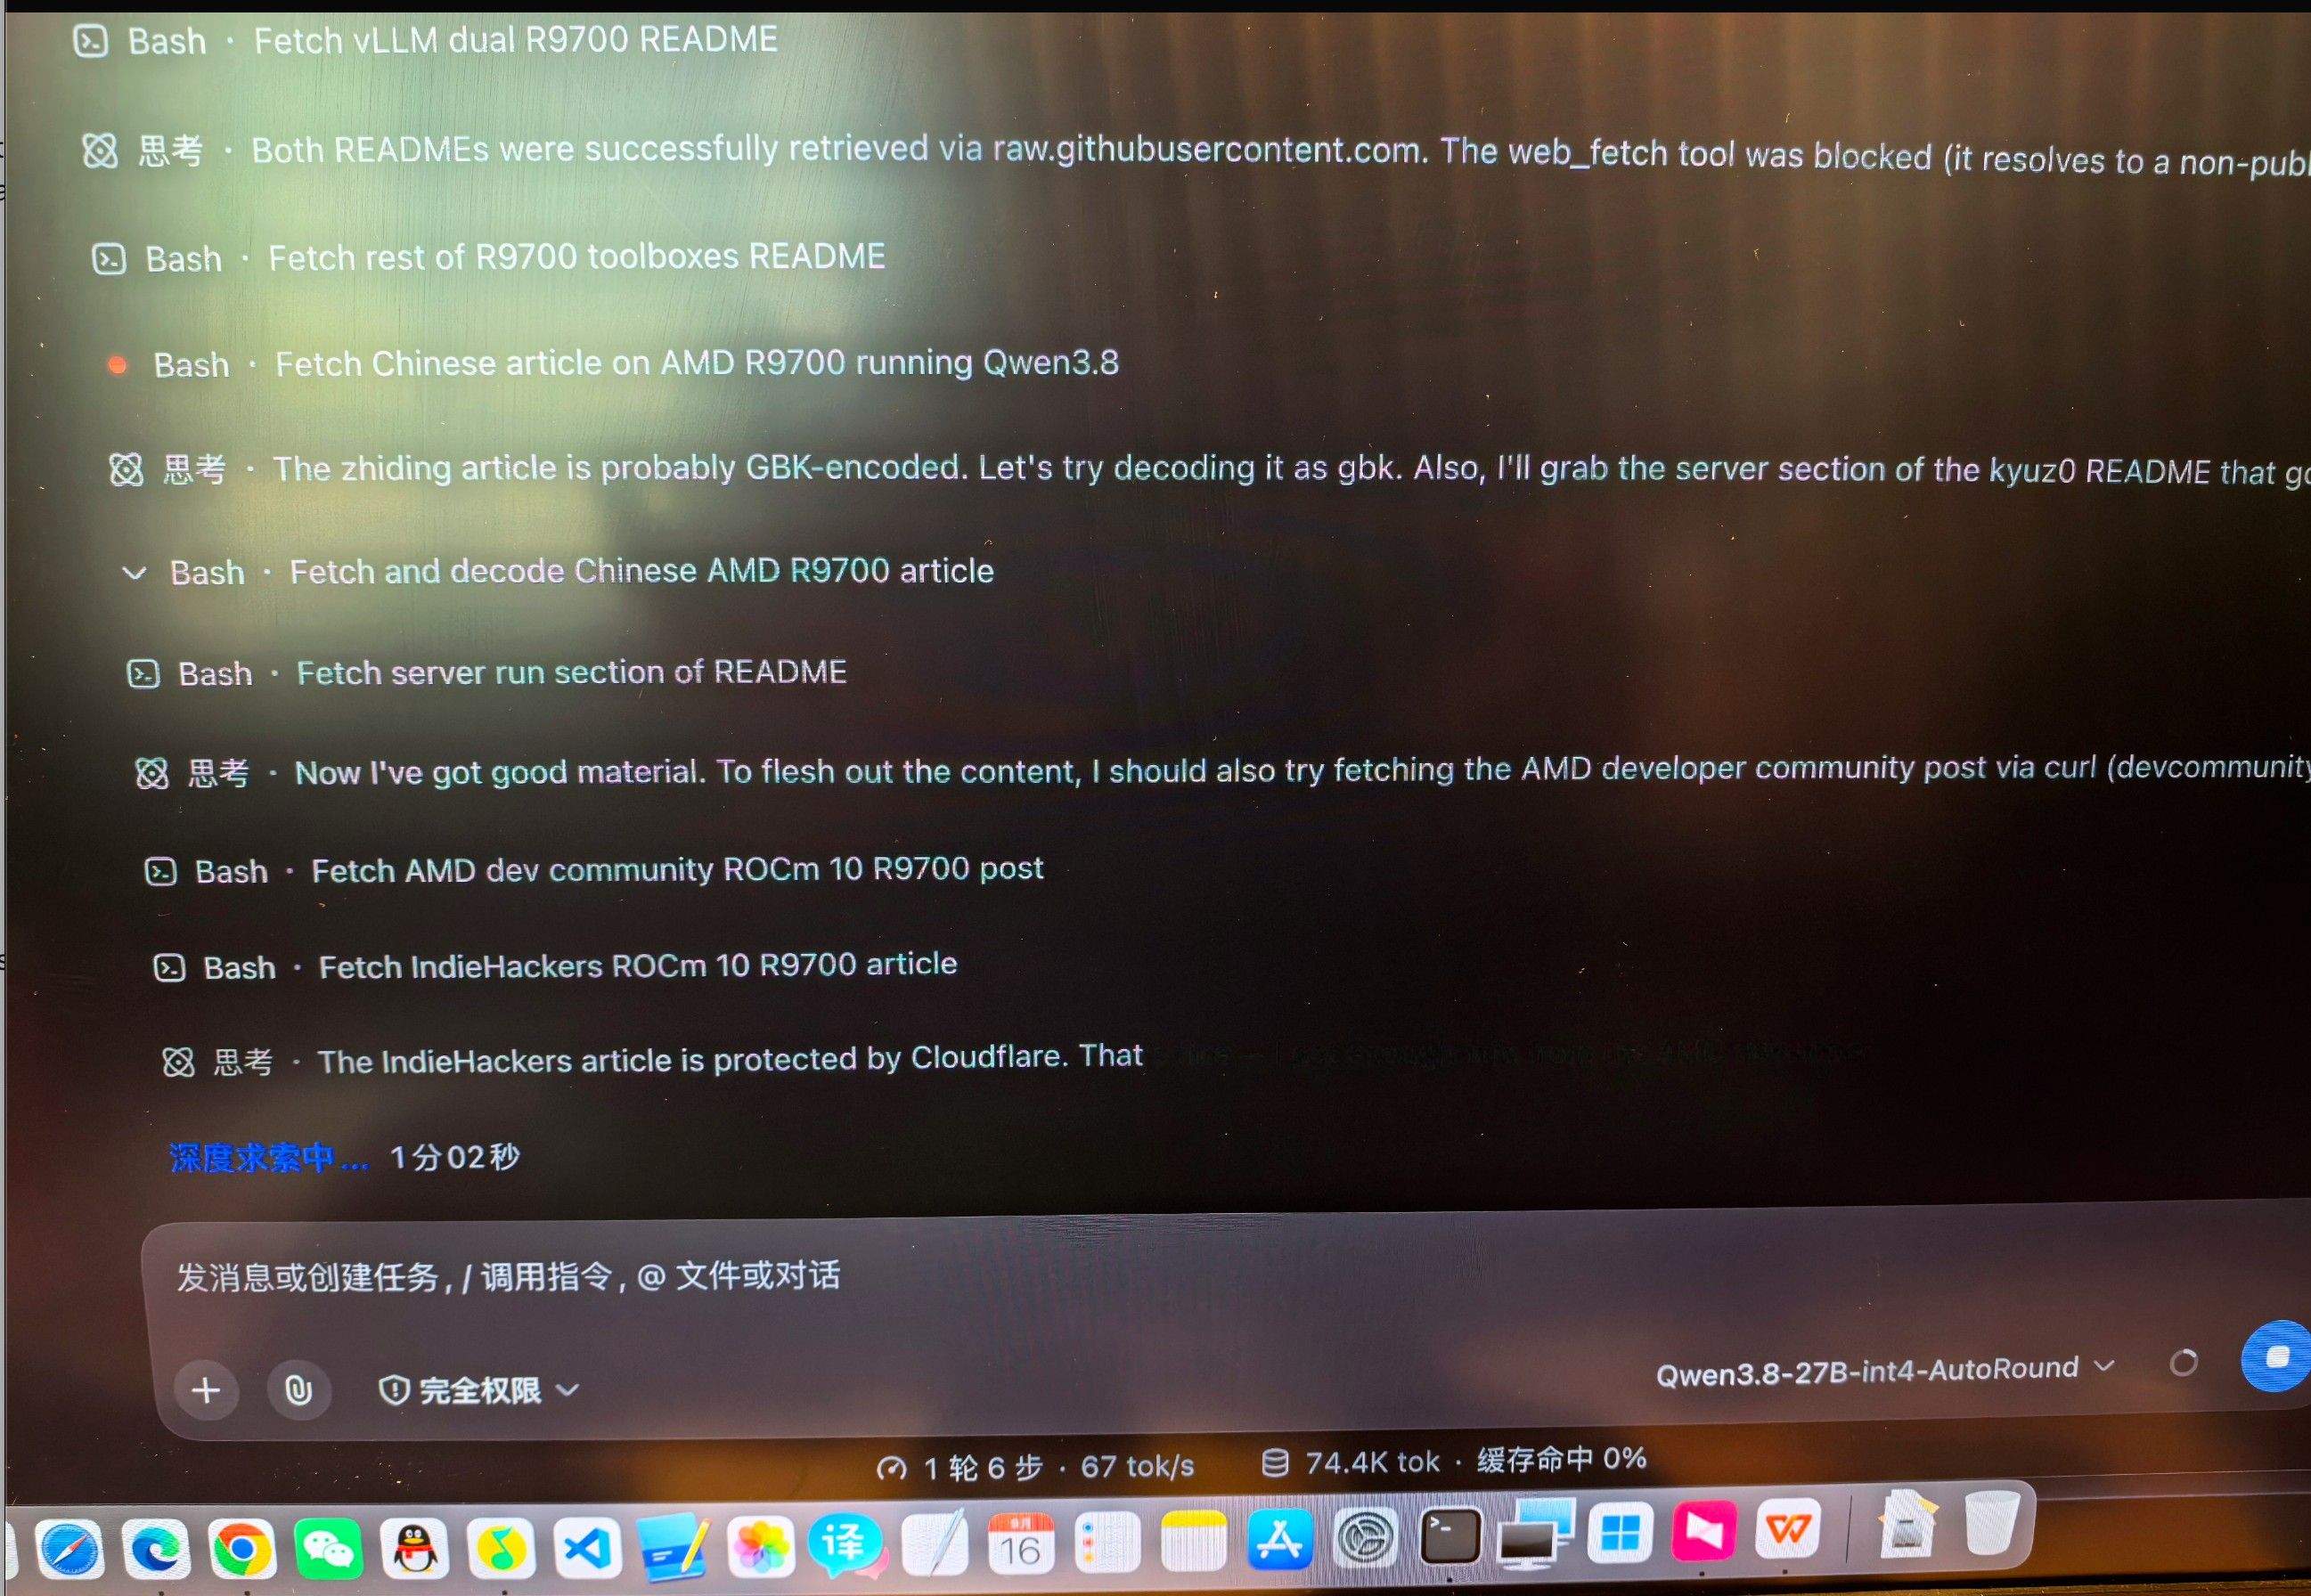
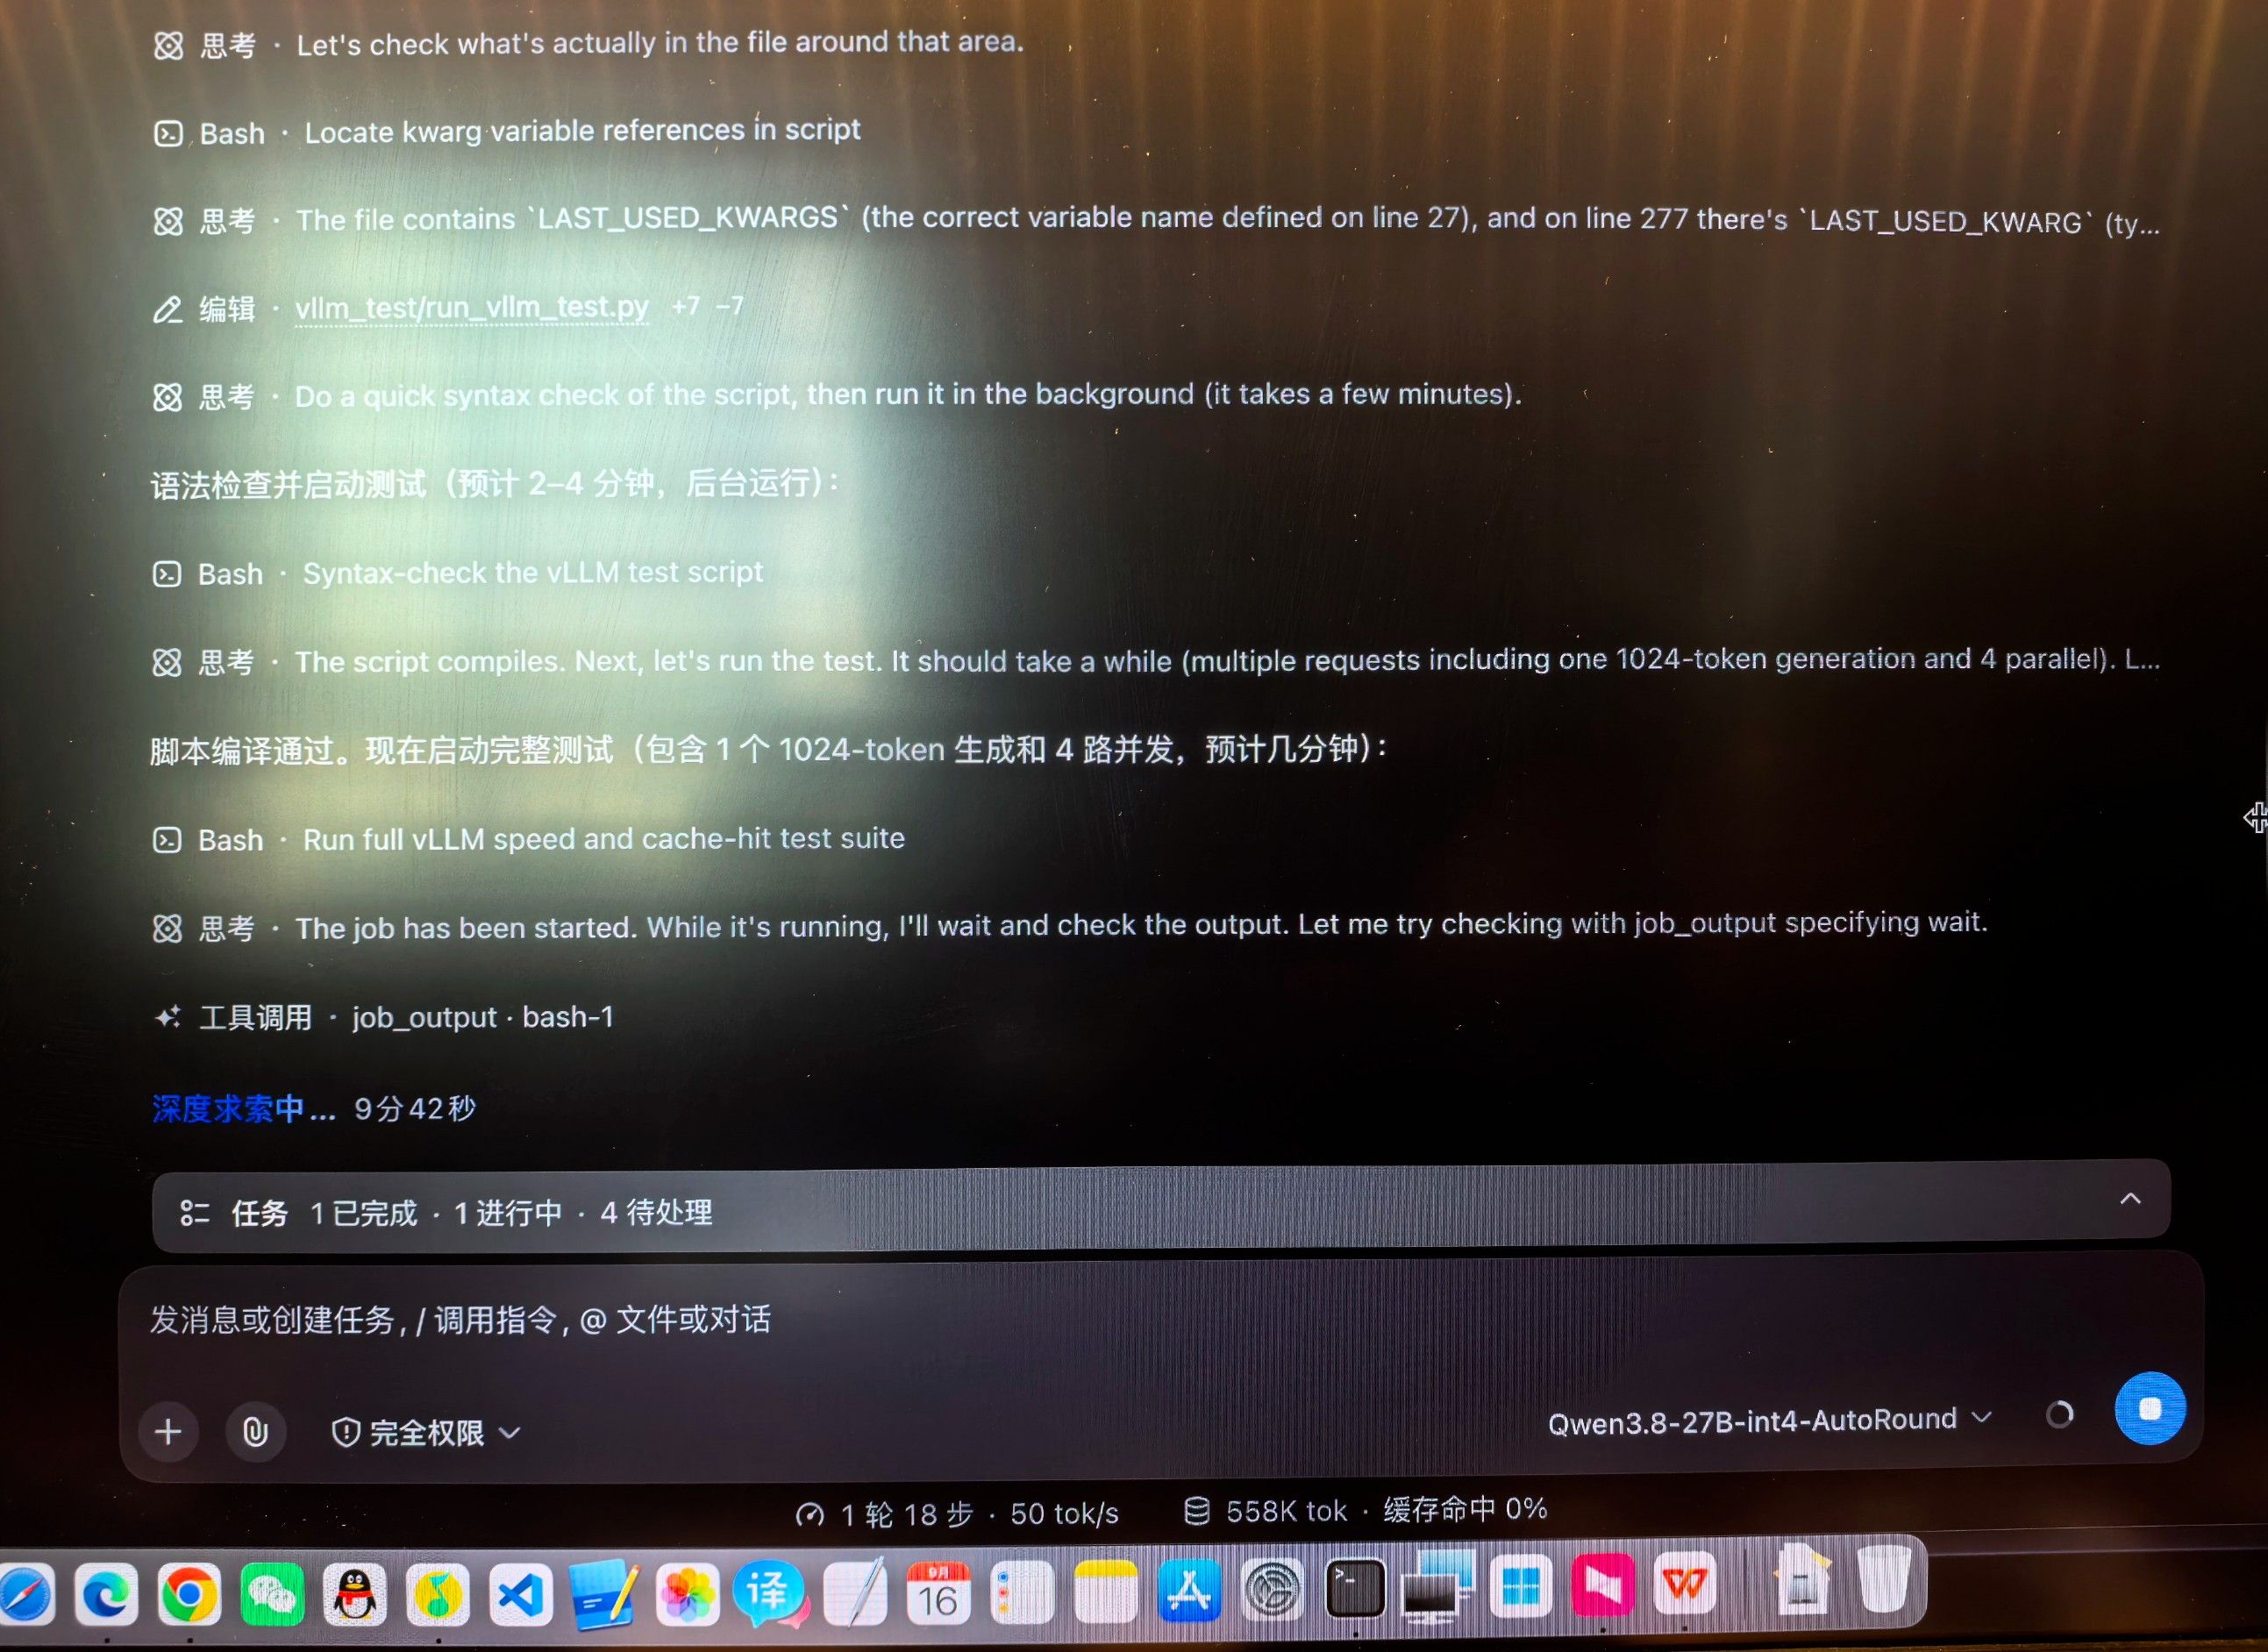
- DeepSeek Harness(DSH)GUI:
http://127.0.0.1:3080 - 通过
llm-pi-aiproviderr9700接入本地模型
2. 宿主机(PVE)参数
项目 值 地址 192.168.67.251版本 pve-manager/9.2.18(内核 7.0.14-16-pve)主机名 R9700CPU Intel Core Ultra 7 265K(20 核) 内存 62GB 网桥 vmbr0iGPU SR-IOV 已开启( i915.max_vfs=4,4 个 VF 空闲)
3. 虚拟机 102 完整配置(示例)
qm config 102输出:agent: 1 bios: ovmf boot: order=scsi0;net0 cores: 12 cpu: host efidisk0: local:102/vm-102-disk-0.qcow2,efitype=4m,ms-cert=2023k,pre-enrolled-keys=1,size=528K hostpci0: 0000:04:00.0,pcie=1 machine: q35 memory: 40960 name: Ubuntu24-desktop net0: virtio=BC:26:11:D3:08:ED,bridge=vmbr0,firewall=1(示例) numa: 0 ostype: l26 scsi0: /dev/disk/by-id/nvme-KINGSTON_SNV2S1000G_50026B74370011C7,size=976762584K scsihw: virtio-scsi-single smbios1: uuid=0x489171-f6d7-492d-a80d-91e193db82a5(示例) sockets: 1 vga: virtio-gl配置项 值 说明 biosovmf UEFI 固件 machineq35 现代机型 cpuhost 直通 CPU,性能最佳 cores/sockets12 / 1 12 核单路 memory40960 40GB 内存 vgavirtio-gl 虚拟显卡,virgl 3D 加速(防闪屏) hostpci00000:04:00.0,pcie=1AMD R9700 直通(纯计算,无 x-vga) scsi01T NVMe by-id 整盘 raw 直通 scsihwvirtio-scsi-single SCSI 控制器 net0virtio + vmbr0 网卡 agent1 qemu-guest-agent 已启用 efidisk0pre-enrolled-keys=1 UEFI + Secure Boot
4. 直通设备清单
设备 宿主地址 用途 AMD Radeon AI PRO R9700 0000:04:00.0(IOMMU group 17)AI 计算(ROCm) 1T NVMe(Kingston SNV2S1000G) /dev/nvme0n1系统盘(raw 直通) Intel 核显 SR-IOV(未直通,空闲)
VF 地址 IOMMU 组 状态 VF1 00:02.1 43 vfio-pci,空闲 VF2 00:02.2 44 vfio-pci,空闲 VF3 00:02.3 45 vfio-pci,空闲 VF4 00:02.4 46 vfio-pci,空闲
5. 客户机系统信息
项目 值 系统 Ubuntu 24.04 LTS 内核 7.0.0-31-generic(HWE)主机名 ubuntu24-ai登录用户 Magic629(组:sudo, render, video)IP 192.168.67.202(DHCP,可改为静态)根分区 200G(LVM,已用 70G,余 118G) 内存 39Gi(余 31Gi) CPU 12 核 磁盘布局
sda                    931.5G  (1T 直通盘)
├─sda1                   1G    /boot/efi(vfat)
├─sda2                   2G    /boot(ext4)
└─sda3               928.5G    LVM PV
  └─ubuntu--vg-ubuntu--lv  200G  /(ext4)
LVM 卷组
ubuntu-vg还有约 728G 空闲,可随时扩容根分区:sudo lvextend -l +100%FREE /dev/ubuntu-vg/ubuntu-lv && sudo resize2fs /dev/ubuntu-vg/ubuntu-lv
6. ROCm 计算环境
项目 值 GPU AMD Radeon AI PRO R9700( gfx1201,RDNA4)显存 32GB(32061259776 B) 计算单元 64 CU ROCm 版本 10.0.0( amdrocm10.0)HIP 编译器 7.15 计算接口 /dev/kfd(group render,GID 992)显示接口 全部 disconnected(amdgpu.modeset=0)ROCm 相关路径
路径 说明 /opt/rocm/bin/ROCm 工具(rocminfo、rocm-smi、hipcc) /dev/kfd计算接口 /dev/dri/renderD*渲染节点 关键内核参数(GRUB)
quiet splash amdgpu.modeset=0 # AMD 卡纯计算模式
7. vLLM 推理服务
7.1 基本信息
项目 值 容器名 vllm102镜像 stilldeadcode/vllm-radiance:0.9.3(vLLM 0.27.1 + ROCm 7.14 + AITER)模型 devan-carlin/Qwen3.8-27B-int4-AutoRound(INT4 多模态)量化 auto_gptq(INT4 W4A16) 显存占用 17.93 GiB 端口 8000(映射0.0.0.0:8000->8000)API OpenAI 兼容: http://192.168.67.202:8000/v1服务名 qwen3.8-27b-int47.2 完整启动脚本(本机)
文件位置:虚拟机
/tmp/run-vllm.sh#!/bin/bash sudo docker run --rm --name vllm102 \ --device /dev/kfd --device /dev/dri \ --group-add 44 --group-add 992 \ --shm-size 4g --cap-add SYS_PTRACE --security-opt seccomp=unconfined \ -v /home/Magic629/models/qwen3.8-27b-autoround:/model:ro \ -v /tmp/launchers/patches/rdna_hybrid_w4a16.py:/opt/vllm/lib/python3.12/site-packages/vllm/model_executor/kernels/linear/mixed_precision/rdna_hybrid_w4a16.py:ro \ -v /home/Magic629/.cache/vllm:/cache \ -p 8000:8000 \ -e HIP_VISIBLE_DEVICES=0 \ -e VLLM_ROCM_USE_AITER=1 -e VLLM_ROCM_USE_AITER_UNIFIED_ATTENTION=1 \ -e VLLM_ROCM_USE_AITER_MHA=0 -e VLLM_ROCM_USE_AITER_MLA=0 -e VLLM_ROCM_USE_AITER_MOE=0 \ -e VLLM_ROCM_USE_AITER_LINEAR=0 -e VLLM_ROCM_USE_AITER_FP8BMM=0 -e VLLM_ROCM_USE_AITER_FP4BMM=0 -e VLLM_ROCM_USE_AITER_RMSNORM=0 \ -e RADIANCE_PRESHUFFLE=1 -e RADIANCE_ATTN_TUNE=1 -e RADIANCE_GDN_WMMA=1 \ -e RADIANCE_VIT_FLASH=1 -e RADIANCE_FUSE_RMS_QUANT=1 -e RADIANCE_DYNAMIC_DRAFT=1 \ -e RADIANCE_SKINNY_GEMM=all \ -e VLLM_CACHE_ROOT=/cache/vllm -e TORCHINDUCTOR_CACHE_DIR=/cache/inductor -e TRITON_CACHE_DIR=/cache/triton -e AITER_ROOT_DIR=/cache/aiter \ -e TRITON_CACHE_AUTOTUNING=1 \ stilldeadcode/vllm-radiance:0.9.3 \ /model \ --served-model-name qwen3.8-27b-int4 \ --quantization auto_gptq \ --kv-cache-dtype fp8 \ --tensor-parallel-size 1 \ --gpu-memory-utilization 0.97 \ --max-model-len 131072 \ --max-num-seqs 2 \ --max-num-batched-tokens 4854 \ --attention-backend R4D \ --enable-prefix-caching --mamba-cache-mode align \ --reasoning-parser qwen3 \ --tool-call-parser qwen3_xml --enable-auto-tool-choice \ --speculative-config '{"method":"mtp","num_speculative_tokens":4,"attention_backend":"R4D","disable_padded_drafter_batch":true}' \ --trust-remote-code \ --host 0.0.0.0 --port 80007.3 启动参数说明
参数 值 说明 --device /dev/kfd /dev/dri— 显卡计算接口 + 渲染节点 --group-add 44 992— video(GID 44)、render(GID 992) 组权限 --served-model-nameqwen3.8-27b-int4 API 中的模型名 --quantizationauto_gptq INT4 量化(需与 config.json 补丁一致) --kv-cache-dtypefp8 KV 缓存用 FP8 --tensor-parallel-size1 单卡 --gpu-memory-utilization0.97 显存利用率 97% --max-model-len131072 上下文 128K --attention-backendR4D RDNA4 专用注意力内核 --enable-prefix-caching— 前缀缓存(实际命中率 84.8%) --mamba-cache-modealign GDN 混合模型状态对齐 --reasoning-parserqwen3 推理(思考)解析 --speculative-configmtp, 4 tokens MTP 投机解码(提速 ~31%) 7.4 模型 config.json 补丁(重要)
模型原始
quantization_config.quant_method是auto-round,必须补丁为auto_gptq,否则静默以未量化方式加载(54GB → OOM)。补丁内容(已应用到
/home/Magic629/models/qwen3.8-27b-autoround/config.json):{ "quantization_config": { "quant_method": "auto_gptq", "desc_act": false, "lm_head": false, "modules_in_block_to_quantize": [ "self_attn.q_proj", "self_attn.k_proj", "self_attn.v_proj", "self_attn.o_proj", "mlp.gate_proj", "mlp.up_proj", "mlp.down_proj", "linear_attn.in_proj_qkv", "linear_attn.in_proj_z", "linear_attn.out_proj" ] } }原文件备份:
config.json.autoround-orig
8. 投机解码配置
项目 值 方法 mtp(复用模型内置 MTP 头)投机 token 数 4 注意后端 R4D 提速效果 26.3 → 34.4 tok/s(+31%,无思考模式)(实测更快) 投机解码的 MTP 头占用了额外显存,因此
--max-model-len从 204800 降到了 131072。
9. 多模态(看图)能力
项目 值 模型类型 原生视觉语言模型( image-text-to-text)支持输入 文本 + 图片(+ 视频理解) 视觉塔 保持 bf16(未量化,约 0.5~1GB) 已实测 能正确识别图片颜色与分布
10. DeepSeek Harness 接入
DSH 配置文件:
/Users/magicz790/.dsh/settings.yamlllm-pi-ai: providers: r9700: displayName: local-qwen apiKeyEnv: R9700_API_KEY # 凭证值 "1234"(vLLM 不校验鉴权,家庭用公用) api: openai-completions baseURL: http://192.168.67.202:8000/v1 defaultInput: [text, image] models: - id: qwen3.8-27b-int4 name: Qwen3.8-27B-int4-AutoRound input: [text, image] contextWindow: 128000 agent-default-model: provider: r9700 model: qwen3.8-27b-int4凭证文件:
/Users/magicz790/.dsh/.credentials.yaml(R9700_API_KEY: "1234")
11. 性能指标
指标 值 推理速度(无思考) 34.4 tok/s 推理速度(含思考链) 52.4 tok/s (反常态) 显存占用 17.93 GiB(VRAM 88%) 前缀缓存命中率 84.8%(内部指标)(实测看不到) 上下文长度 128K 说明:DSH/监控面板显示的「缓存命中 0%」是假象——radiance 版 vLLM 不回报
cached_tokens字段,客户端读不到。实际缓存正常。
12. 维护命令大全
12.1 虚拟机(从 Mac 执行)
# 登录 PVE
ssh [email protected]

# 查看虚拟机状态
qm status 102
qm list

# 启动/关机/重启虚拟机
qm start 102
qm shutdown 102        # 优雅关机
qm stop 102            # 强制关机

# 查看虚拟机配置
qm config 102

# 进入虚拟机(通过 guest-agent 执行命令)
qm guest exec 102 -- <命令>
qm guest cmd 102 network-get-interfaces   # 查 IP
12.2 客户机(Ubuntu,从 Mac 执行)
ssh [email protected]12.3 vLLM 服务管理
# 查看容器状态
sudo docker ps --filter name=vllm102

# 查看日志
tail -f /tmp/vllm-run.log

# 停止服务
sudo docker rm -f vllm102

# 启动/重启服务(脚本已含完整参数)
sudo bash /tmp/run-vllm.sh
# 后台启动(断开 SSH 不中断)
nohup bash -c 'echo "密码" | sudo -S -p "" bash /tmp/run-vllm.sh' > /tmp/vllm-run.log 2>&1 &
12.4 测试 API
# 列出模型
curl http://127.0.0.1:8000/v1/models

# 对话测试(无思考)
python3 - << 'EOF'
import urllib.request, json
data = {"model":"qwen3.8-27b-int4",
        "messages":[{"role":"user","content":"你好"}],
        "max_tokens":100,
        "chat_template_kwargs":{"enable_thinking":False}}
req = urllib.request.Request("http://127.0.0.1:8000/v1/chat/completions",
    data=json.dumps(data).encode(), headers={"Content-Type":"application/json"})
print(json.loads(urllib.request.urlopen(req).read())["choices"][0]["message"]["content"])
EOF
12.5 显卡监控
# 显存/温度/功率/占用
/opt/rocm/bin/rocm-smi
/opt/rocm/bin/rocm-smi --showmeminfo vram

# 架构信息
/opt/rocm/bin/rocminfo | grep -i "marketing name"
12.6 缓存命中率(真实值)
curl -s http://127.0.0.1:8000/metrics | grep -E "prefix_cache_(queries|hits)_total"
# 命中率 = hits_total / queries_total
12.7 磁盘扩容(需要时)
sudo lvextend -l +100%FREE /dev/ubuntu-vg/ubuntu-lv
sudo resize2fs /dev/ubuntu-vg/ubuntu-lv
13. 常见问题
现象 原因 解决 noVNC 桌面闪屏 virtio-gpu 无 3D 加速 已改 vga: virtio-gl(当前正确)重启后 /dev/kfd 消失 Secure Boot 拒载未签名 DKMS 模块 已改用内核自带签名驱动 vLLM 启动 OOM 投机解码占显存,KV 缓存不足 已降 --max-model-len到 131072DSH 提示不支持看图 DSH 缓存旧模型状态 重启 DSH / 新建会话 面板缓存命中 0% vLLM 不回报 cached_tokens 无害,看 /metrics 真实值
13. 局域网实测
- DeepSeek Harness(DSH)GUI:
-
 T terry 于 将此主题固定
-
系统 于 取消固定此主题