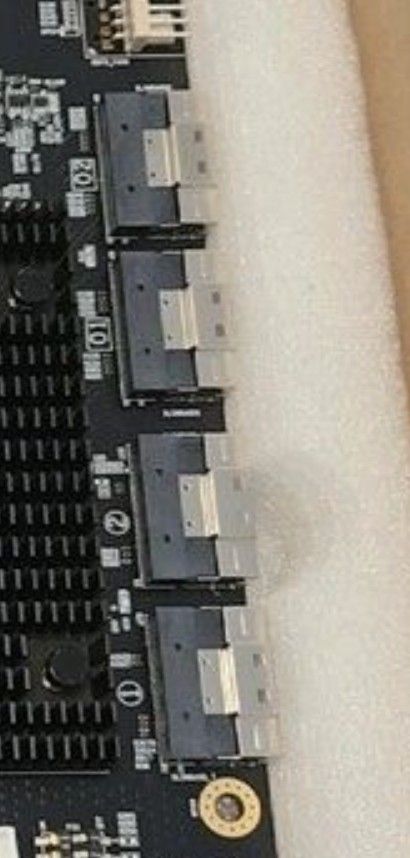
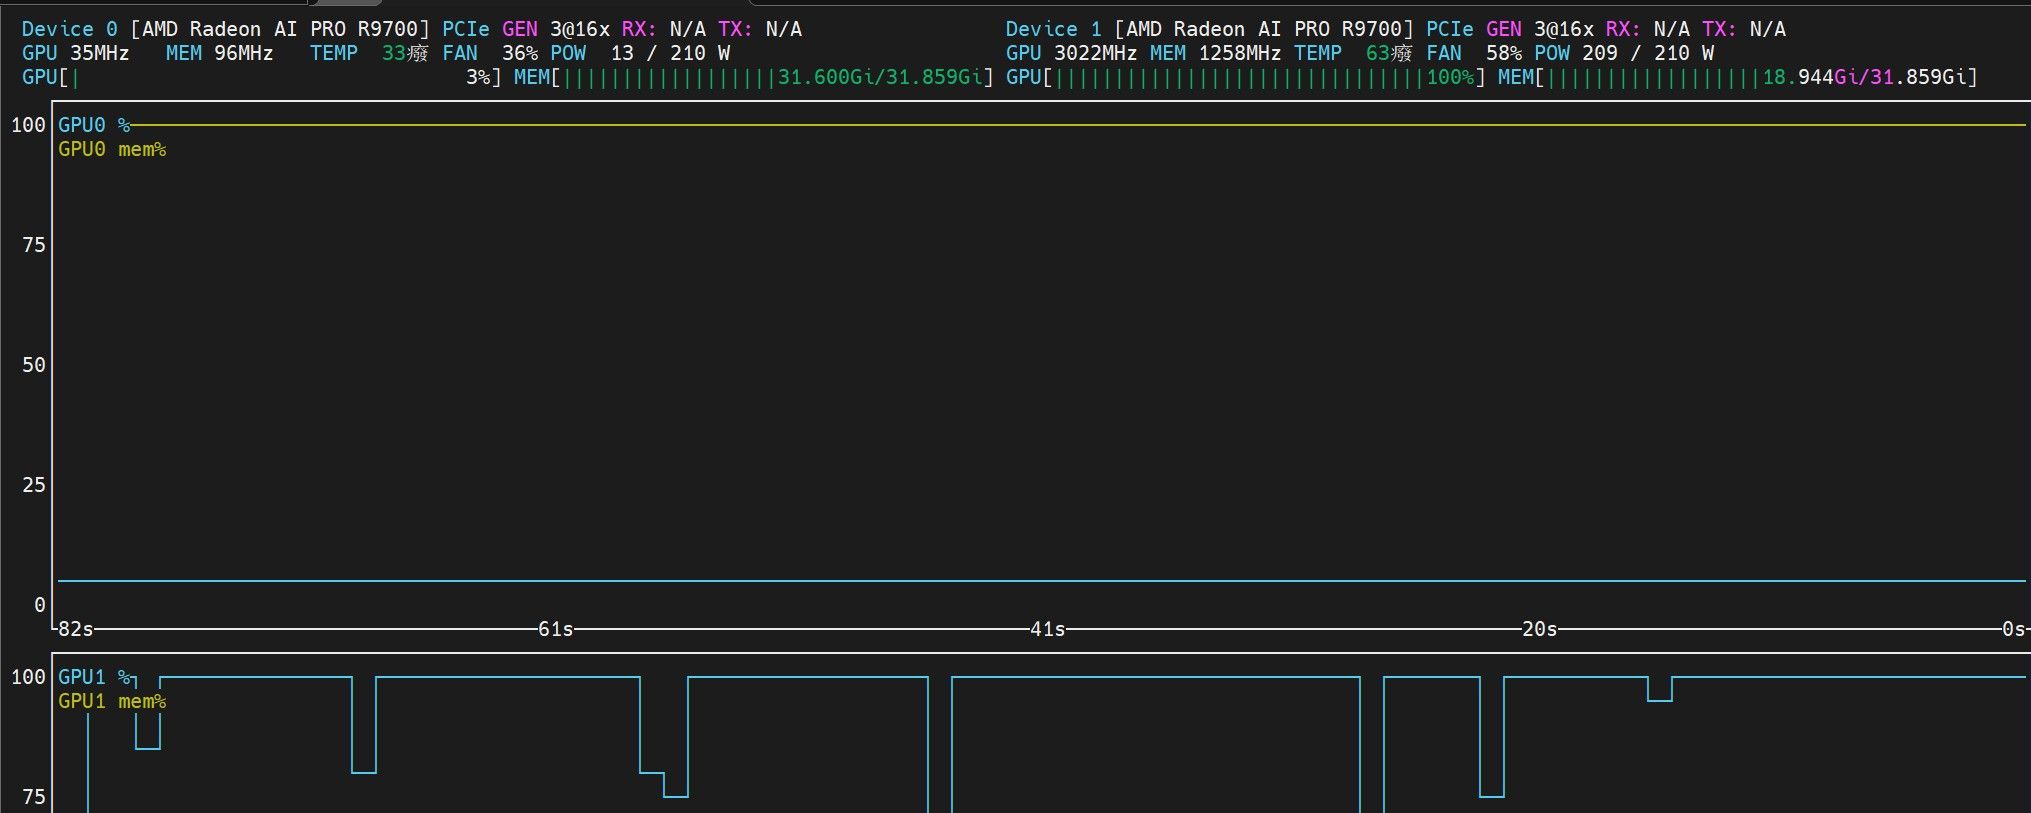
X99 不能P2P让我很难受 。 买Pcie switch(260925DELL T7910 已判:死缓,原因:拿不到大Bar )
-
我比较想问,买新的主板不会比买pcie switch 更划算吗?
-
两点分开答。
@hippo 的 ReBAR:ReBAR(Resizable BAR)和 P2P 不是同一件事,但它确实是 P2P 的前置条件之一——GPU 到 GPU 直连,要求对端的显存整段 BAR 能映射进来。X99 上经常缺的其实是 BIOS 的 Above 4G Decoding(以及随之而来的大 BAR),所以先确认板子有没有这个选项;没有的话 P2P 根本没有地址可映射,买 switch 也白搭。反过来,有大 BAR 也不等于 switch 一定有用,还要看这个 bridge 本身支不支持 peer-to-peer forwarding——LRLink 那类 PLX/Broadcom 方案(也就是你引的 Level1Techs 帖)说的正是「root port 的 ACS 挡住 P2P 时,它给了两张卡一个共同的下游桥」。所以顺序是:先过大 BAR/Above 4G,再确认 bridge 支持 P2P,两个都满足才值得买。
@applejuice 问「换主板是不是更划算」:换消费级主板大概率解决不了 P2P——桌面芯片组的 root port 默认开着 ACS,P2P 照样被挡;要原生 P2P 得往 EPYC/Threadripper 这种能配 ACS 的平台走,CPU+板+内存的价钱是 switch 的几倍到十几倍。所以:
- 目的只是让两张 R9700 的 all-reduce 走 P2P、不绕 CPU:switch/bridge 是最便宜的对症方案,前提是上面两点成立。
- 想要更大上行带宽 + 更多内存通道:换平台,但别把它当成「顺便修 P2P」的理由。
- switch 不增加上行带宽:X99 到 CPU 还是 x16 Gen3(约 15.75 GB/s)封顶,它省的是每 token 那次 CPU 往返,不会把 decode 拉一个数量级。
另外「几百块」要当心:正经支持 peer forwarding 的 switch 卡一般不止几百人民币,几百块的多半是普通 fan-out switch,买前问清支不支持 P2P。
-
我之前也以为 X99 基本没法搞 P2P,甚至已经在看 TRX40 / WRX80 和 PCIe Switch 板子了。
不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。
这件事不是改一个开关就行,我这边大概做了下面几层。
1. 先确认硬件拓扑没问题
两张 R9700 都是 CPU 直出的 PCIe 3.0 x16,但挂在不同的 Broadwell Root Port 下。
基础设置:
- Above 4G Decoding 开
- ReBAR 开
- CSM 关
- 两张卡确认都是 8GT/s x16
- 检查 BAR / IOMMU / PCIe topology
另外把整条 PCIe Path 的 MPS 都查了一遍。
X99/Broadwell Root Port 最大只支持 256B MPS,所以最终就保持256B,没有去强行改512/1024。
2. 先解决 AMDGPU / HSA 层面的跨 Root Port P2P
Broadwell-EP 这里有个比较麻烦的问题:
跨 Root Port P2PDMA + 44-bit DMA address / 大 BAR 映射 默认并不顺畅。
我这边最后使用了定制的:
6.8.12-r9700-p2p-dma44内核,把 X99/Broadwell 这层 P2P DMA 映射问题处理掉。
之后先不碰 SGLang,直接做底层测试。
HIP IPC 也单独验证过,使用:
HSA_ENABLE_IPC_MODE_LEGACY=0两张卡之间的 IPC 可以正常建立。
然后用 TransferBench / hipMemcpyPeerAsync 验证真正的 GPU→GPU 数据通路。
实测:
- GFX Push / Posted Write:约 10.29 GB/s
- SDMA / hipMemcpyPeerAsync:约 10.26~10.29 GB/s
- 双向同时传输 aggregate:约 19.7 GB/s
也就是说 PCIe 3.0 x16 的跨 Root Port P2P 实际已经跑到了比较正常的水平。
这里很重要的一点是:
先证明 GPU P2P 本身能工作,再折腾 RCCL。
3. RCCL 是第二个坑
底层 P2P 通了以后,Stock RCCL 还是不会自动使用它。
原因是两张卡跨 CPU Root Port,RCCL 把拓扑识别为:
PATH_PHBStock RCCL 会退回:
via SHM/direct/direct也就是说底层明明能 P2P,但 RCCL 还是绕系统内存。
当时实测:
- Stock RCCL SendRecv 1G:约 6.9 GB/s
- AllReduce BusBW:约 4.5 GB/s
所以还需要处理 RCCL。
4. 给 RCCL 做了一个很小的 patch
我现在用的是 patched RCCL 2.27.7。
修改其实很小,在:
src/graph/paths.cc里只有大约 6行顺序调整。
核心问题是 RCCL 对 Intel 平台设置默认 P2P level 的顺序,会把用户指定的 PHB override 覆盖掉。
修改后,让:
NCCL_P2P_LEVEL=PHB成为最终生效值。
这里要注意:
只设置环境变量没用。
我实际验证过:
- Stock RCCL +
NCCL_P2P_LEVEL=PHB→ 还是 SHM - Patched RCCL,不设置 PHB → 还是 SHM
- Patched RCCL +
NCCL_P2P_LEVEL=PHB→ Direct P2P
两者必须同时有。
我没有使用:
HSA_FORCE_FINE_GRAIN_PCIE=1
5. RCCL Direct P2P 打通后的结果
还是同一套 rccl-tests:
- SendRecv 1G:约 9.75 GB/s
- AllReduce BusBW:约 9.51 GB/s
- AllGather BusBW:约 9.16 GB/s
- ReduceScatter BusBW:约 8.92 GB/s
SendRecv 已经达到 TransferBench P2P Push 的约95%。
这时候基本可以确认:
RCCL 已经不是 SHM,而是真正走 GPU Direct P2P。
6. 最后再接 SGLang TP2
SGLang 启动后继续检查日志,不只是看“服务能跑”。
现在能够看到类似:
isAllDirectP2p 1以及:
via P2P/IPC确认 TP2 通信真正走 Direct P2P。
目前跑 Qwen3.8-27B AWQ,已经从1K一直测到251.5K context:
- 251.5K Prefill:约 712 tok/s
- 251.5K Native Decode:约 10.08 tok/s
- 251.5K input + 512 output:0 OOM
连续高负载测试也没有看到 PCIe AER、GPU reset 或 P2P掉线。
所以我现在对 X99 的看法和最开始完全不一样。
X99/Broadwell 不是硬件上完全不能 P2P,而是默认的软件路径很难直接用。
我这边实际上处理了两层:
第一层:
X99/Broadwell + AMDGPU/HSA 的跨 Root Port P2P DMA。第二层:
让 RCCL 接受PATH_PHB下的 Direct P2P,而不是自动退回 SHM。两层都打通以后,PCIe 3.0 x16 本身反而没有想象中那么差。
所以如果你的X99也是两张卡 CPU直连 x16+x16,我建议先把现有平台的 P2P 路径查清楚,不一定需要马上买 PCIe Switch。
Switch可以改善拓扑,但如果真正的问题是 AMDGPU / RCCL 软件策略,单纯加Switch未必就能解决。
后面我准备把 X99 双 R9700 从内核、TransferBench、RCCL到SGLang TP2的完整过程整理一下,应该比单独贴一个“跑通了”的结果更有参考价值。
@PhoenixRise2026 怎么不上PCIE 4.0呢?服务器或者AMD的工作站主板,有没有能让两个PCIE 4.0显示跑满X16的?
@xiaote 你也用 gpt 6 astra查一下,对于 咱们PCIE4.0显卡的用户,想组双卡或者多卡,有哪些硬件和软件要求?
-
补一条,我的主板是X99-TF GAMING V6.0
-
我比较想问,买新的主板不会比买pcie switch 更划算吗?
-
-
-
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
 , 这个Switch型号是什么?我去淘宝看看。
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。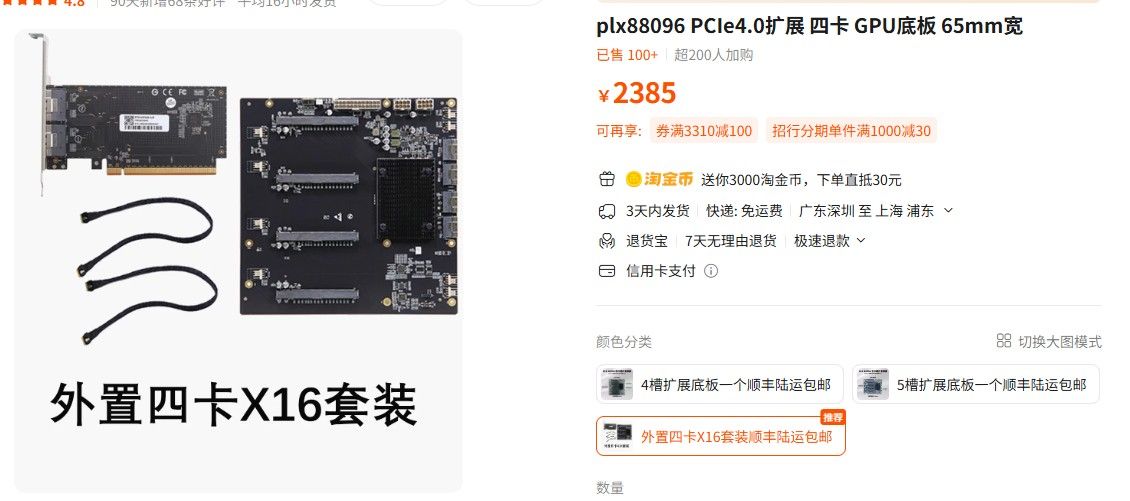
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。
-
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
-
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
可行!支持你老哥!