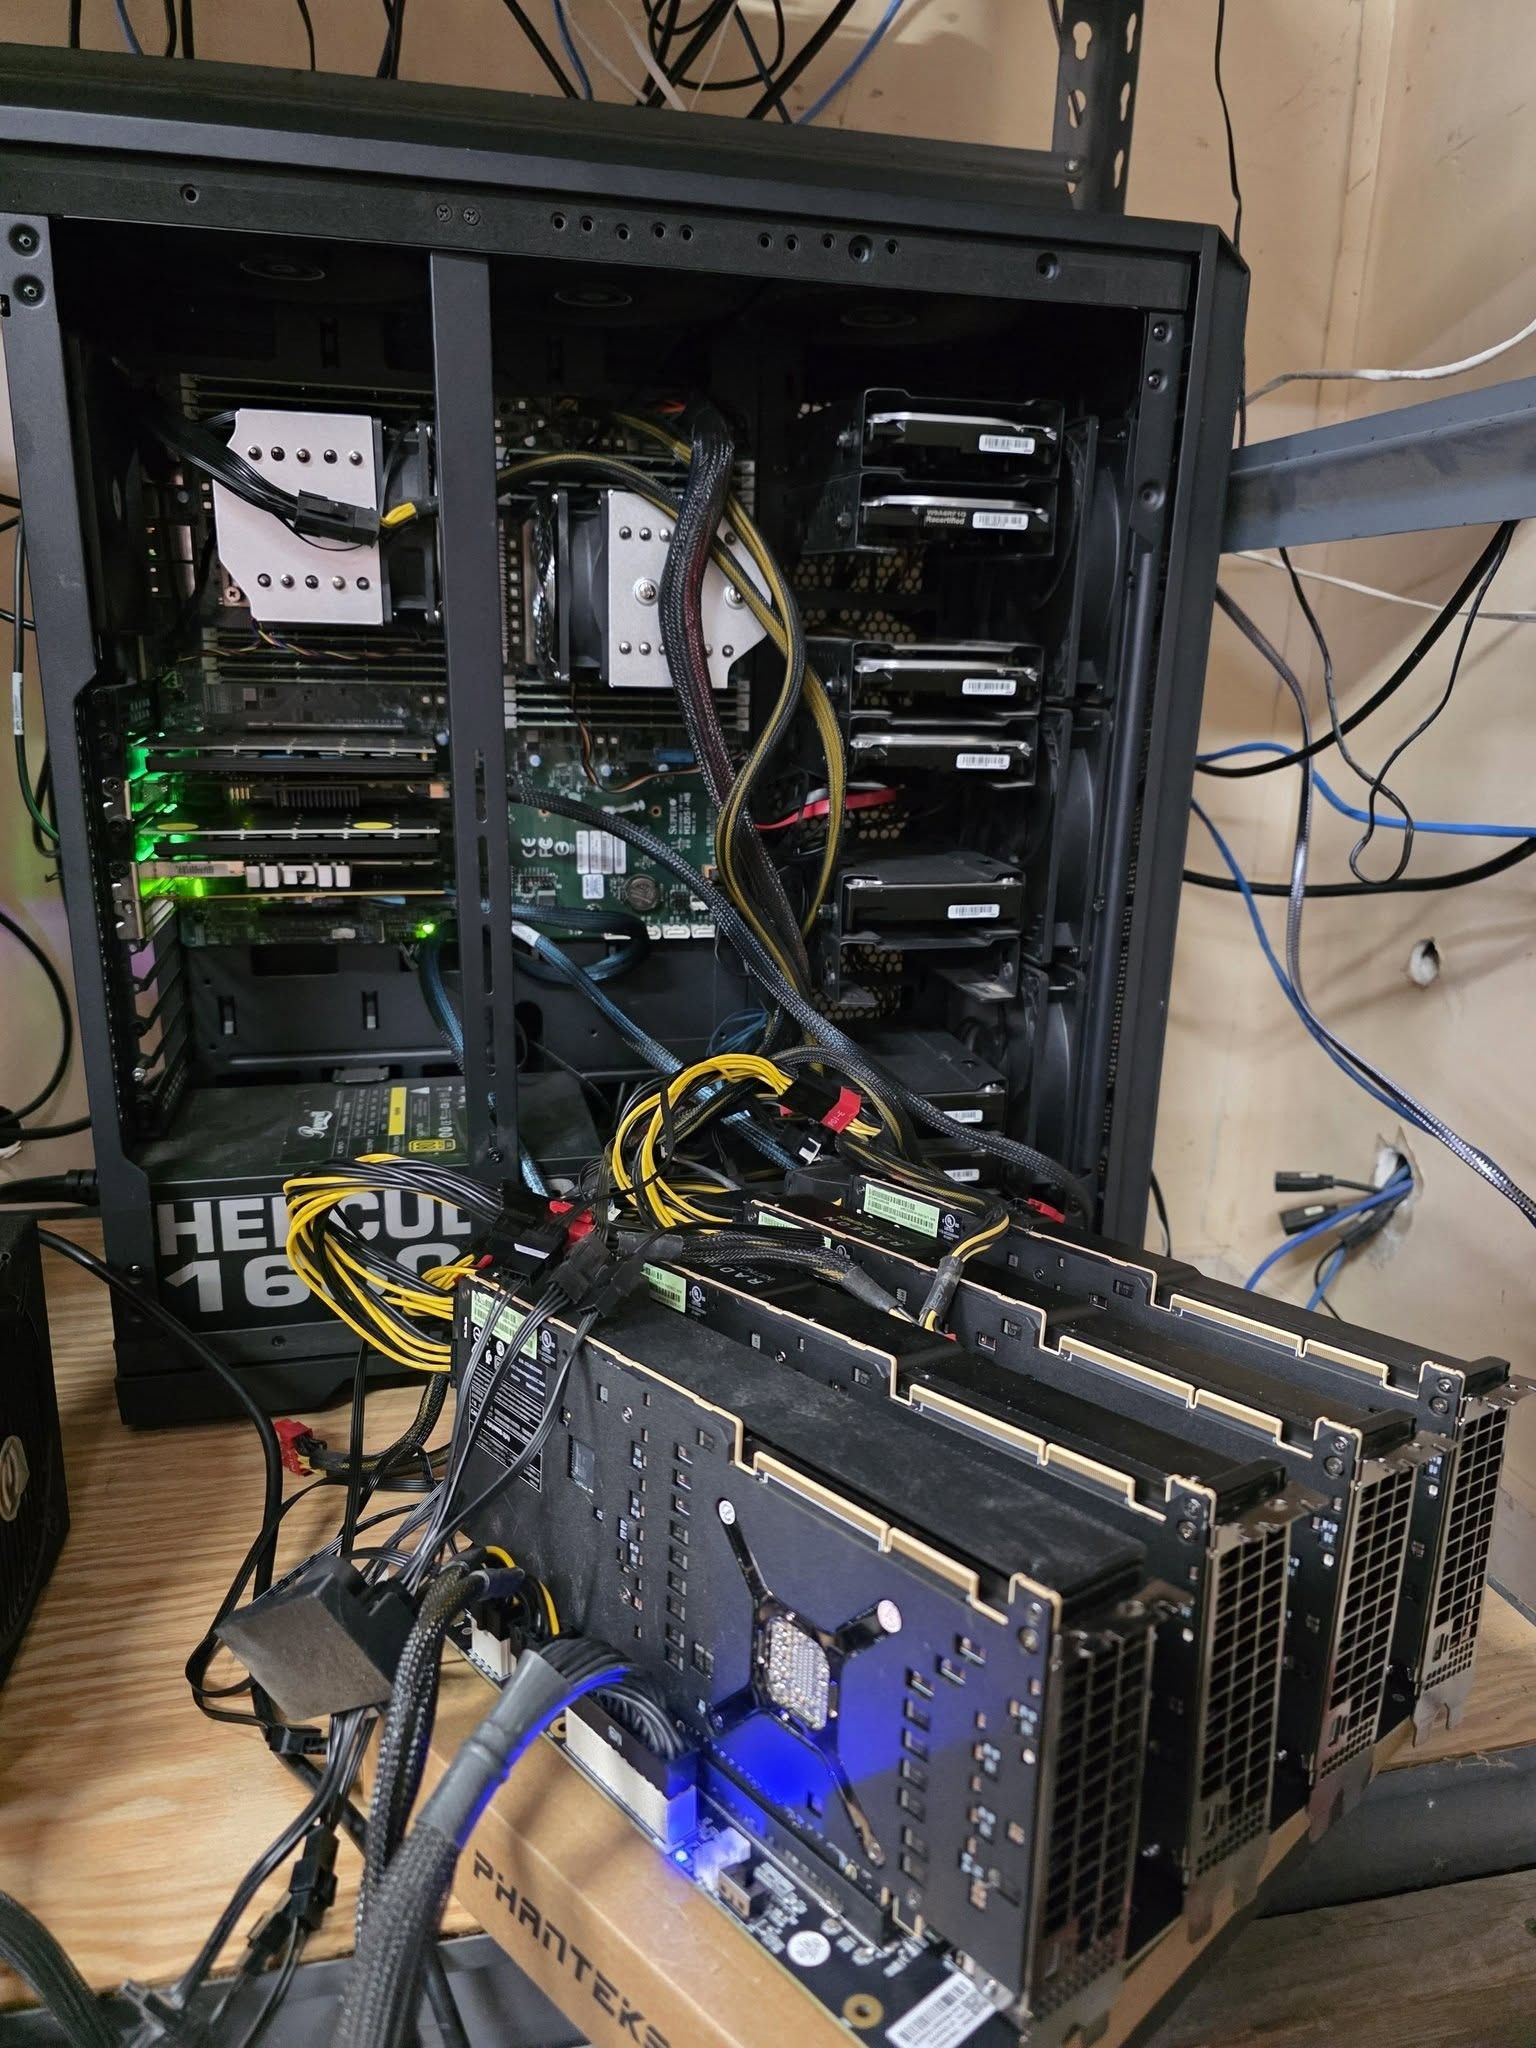
X99 不能P2P让我很难受 。 买Pcie switch(260925DELL T7910 已判:死缓,原因:拿不到大Bar )
-
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
 , 这个Switch型号是什么?我去淘宝看看。
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。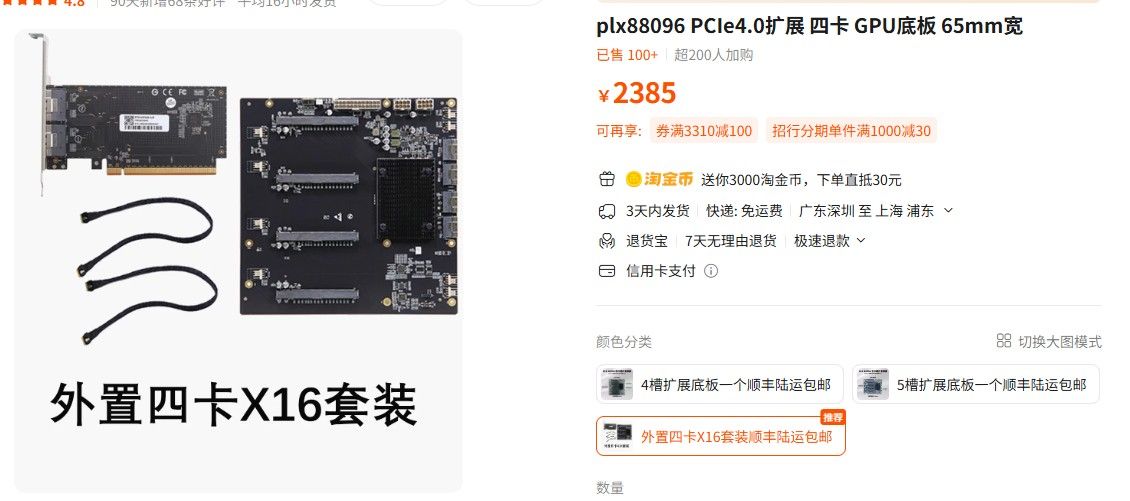
-
这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。这台设备大概多少钱?PCIE4的?
2380 含两根线 + 箱内的一张转出卡(纯转出 16x)
这个价格可以呀,相比较于换平台来说。四张卡,然后配合这个接到树莓派(或者是n100)。
我看过youtube 上的一个哥们就是用树莓派做头
老鼠拉铁锹。
R9700这张卡没有推理任务的时候功耗很低的,反正权重已经加载到了显存~ 树莓派的性能足够了~
但raspiberry 如果转接了Pcie的话,好像没地方放SSD了。
SD卡凑合一下就行
, 这个Switch型号是什么?我去淘宝看看。
-
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
-
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
能不能P2P 你等我趟完路再试吧,不然白费功夫。老外是拿双R9700 跑训练。卡间通讯非常好。
nThread 1 nGpus 2 minBytes 1048576 maxBytes 134217728 step: 2(factor)
 Size         busbw (out-of-place)    busbw (in-place)
 1048576      4.99 GB/s               5.01 GB/s
 2097152      5.19                    5.20
 4194304      5.30                    5.31
 8388608      5.36                    5.36
16777216      5.39                    5.39
33554432      5.39                    5.39
67108864      5.40                    5.40
134217728 5.41 5.41
可行!支持你老哥!
-
- 3945WX 内置 8 通道 DDR4 控制器,官方最大支持 2TB 内存——128G 对它来说是零头
- 一个核就能访问全部 8 通道;128G 内存哪怕只开 1 个核也“带得动”,只是带宽用不满
- 真正的约束是:内存带宽 vs 你的工作负载。3945WX 8 通道 DDR4-3200 = 204.8GB/s 总带宽(TechPowerUp 官方规格),12 个核分这点带宽完全够
- 你现在的 8700K 是双通道 ~45GB/s,3945WX 是它的 4.5 倍
所以答案:够,绰绰有余。LLM 推理场景(KV 溢出主存、HiCache、CPU offload)吃的是带宽不是核数,8 通道正是路线 A/B 的核心价值。
二、NUMA 节点:这才是 A 和 B 的真正区别,你问到点子上了
路线 A(3945WX/WRX80) 路线 B(EPYC 7402/SP3) 物理 NUMA 1 个节点(单 socket) 1 socket,但可切 1/2/4 节点(BIOS NPS 设置) 出厂默认 NPS0=统一内存访问,全部 GPU 等距 NPS1(单节点)或 NPS4(拆 4 个) GPU 亲和性 无所谓,哪张卡都一样 NPS1 时也无所谓;NPS4 时 GPU0-3 分属不同节点,绑错核 latency 翻倍 调度复杂度 零心智负担 需要懂 numactl,但灵活性高 对比你的 DL380 双路 —— 单路=没有跨 socket QPI/UPI 问题 对推理工作流的实际意义:
- 双 3090 TP=2:A 平台零配置最优;B 平台设 NPS1 也等效(官方文档:NPS 决定内存交织模式,NPS1=全交织,GPU 访问任意内存等距)
- 4 卡场景:B 设 NPS4 + 每卡绑本节点内存,对 prefill 吞吐有 5-15% 收益(Dell/AMD 官方调优指南的结论);A 平台没这个选项也意味着没这个坑
- 老实说:你的场景(2 卡起步,4 卡为目标)两个平台都能管好,B 多一个可调项,A 少一个要学的东西
三、5955WX 为什么 ¥3,999——你的直觉「才16核咋这么贵」又问到点子上了
刚扫的淘宝价:5955WX(16C Zen3)¥3,999 vs 3945WX(12C Zen2)¥500-799。差 6 倍,原因不是核数:
- 平台代际:5955WX 是 Zen3(2022),单核性能 +30%,但主要贵在还在生命周期内,二手市场没放量
- 供需操纵:WRX80/SP3 平台 recently 被量化交易/算力公司扫货(淘宝那个「量化交易2U4U4卡」的标题就是证据),5000 系 WX 价格被炒
- 真正的性价比断点在 Zen2 WX:3945WX ¥500-799 是「EPYC Rome 贴牌工作站版」,和 ¥550 的 7402 是同一片 die——本质上是同一个东西的两种封装
我的判断:¥3,999 的 5955WX 完全不值。你多花 ¥3,300 买到的:
- 单核 +30%(对推理几乎无用,GPU 才是主引擎)
- 多 4 个核(12→16,对推理调度无用)
- 不支持的:内存通道不变(都是 8)、PCIe 不变(都是 128 lane Gen4)、NUMA 拓扑不变
推理机器的性能排序是:GPU > PCIe 带宽 > 内存带宽 > CPU 算力。CPU 那 30% 单核提升对 t/s 的影响 <5%。
修正后的决策矩阵
路线 A(3945WX) 路线 B(7402P) CPU 价 ¥650 ¥550 板价 ¥3,700-4,950 ¥3,030-3,570 内存全插  8 槽最多插 8 条(128G)
 16 槽全插(256G)
NUMA 心智 最简 NPS1 简单/NPS4 进阶 总价(双卡基础) ¥4,350-5,600 ¥4,100-4,250 结论更清晰了:B 比 A 便宜 ¥300-1,300,还多 128G 内存容量、多 NVLink rig 社区验证。A 的唯一优势是「工作站 BIOS + 稳定性调校 + 开机快」,如果你这台机器打算 24 小时跑服务偶尔当远程桌面,B 的短板(开机慢 2 分钟、风扇吵)都可以用设置解决。
我有一些服务器内存, 在看主板,让GLM 5.3 FLASH帮我查的,太震惊了。 量化交易/算力公司扫货 ! 这是个多么疯狂的世界
-
不用另外找模型查,这类问题的边界很固定,看通道表和 ROCm 支持矩阵就够了。
先回答「两个 PCIe 4.0 跑满 x16」:能,但不在消费级。
硬件(车道数是硬门槛)
- 一张 PCIe 4.0 x16 占 16 条 lane。双卡 x16/x16 = 32 条,4 卡 = 64 条。
- AM5(Ryzen 7000/9000)CPU 一共约 24 条可用 lane:16 给主显卡槽、4 给 NVMe、4 给芯片组。所以消费级最多做到 x8/x8,还要主板支持 bifurcation(只有部分 X670E/X870E 高端板做了);绝大多数 B650 第二槽是芯片组出的 x4,还要和 DMI 抢。
- 想双 x16:上 HEDT/工作站。TRX50(sTR5)约 48 条 lane,可 4×x16;WRX90 / EPYC SP5 有 128 条,可 8×x16;Intel Xeon W-3400 是 112 条。这才是「每条都跑满 x16」的平台。
- 选板还要确认:槽位是不是 CPU 直连、BIOS 有没有 x8/x8 bifurcation、别和 M.2 抢通道。
软件(这层比硬件更容易翻车)
- AMD 走 ROCm,多卡集合通信用 RCCL(对应 CUDA 的 NCCL)。前提是架构在支持列表里(7900XTX = gfx1100)。
- PCIe P2P 需要:BIOS 开 Above 4G Decoding + Resizable BAR、关 CSM、UEFI 启动;且 root port 的 ACS 不挡 P2P(消费板默认常挡,需要内核参数/补丁)。验证用 rocm-smi、rccl-tests,加 NCCL_DEBUG=INFO 看是走 P2P 还是退回 SHM 经主机内存中转。
- NVIDIA 侧同理:nvidia-smi topo -m 看拓扑,无 NVLink 时 PCIe P2P 一样受 ACS/大 BAR 限制。
- 框架层:vLLM/SGLang 的 tensor parallel 每层都要 all-reduce,卡越多通信占比越高。PCIe 4.0 x16 单向约 32 GB/s(有效 25 左右),x8 直接减半。双卡 TP 一般没问题,4 卡以上没有 P2P 会明显掉效率;PP 通信少但怕 bubble。
结论:双卡是消费级甜点;4 卡以上别在 AM5 上硬凑,直接 TRX50/WRX90/EPYC。回到这个帖的主题——如果只是让两张卡 all-reduce 别绕 CPU,PCIe switch/bridge 是最便宜的对症方案;但想「每条都 4.0 x16」,这笔钱省不了,得换平台。
-
@PhoenixRise2026 怎么不上PCIE 4.0呢?服务器或者AMD的工作站主板,有没有能让两个PCIE 4.0显示跑满X16的?
@xiaote 你也用 gpt 6 astra查一下,对于 咱们PCIE4.0显卡的用户,想组双卡或者多卡,有哪些硬件和软件要求?
@PhoenixRise2026 怎么不上PCIE 4.0呢?服务器或者AMD的工作站主板,有没有能让两个PCIE 4.0显示跑满X16的?
还是穷啊,还有就是买x99的时候,没想着双卡p2p。现在配一套 TRX40 / WRX80,成本也不低。
-
@PhoenixRise2026 怎么不上PCIE 4.0呢?服务器或者AMD的工作站主板,有没有能让两个PCIE 4.0显示跑满X16的?
还是穷啊,还有就是买x99的时候,没想着双卡p2p。现在配一套 TRX40 / WRX80,成本也不低。
@PhoenixRise2026 怎么不上PCIE 4.0呢?服务器或者AMD的工作站主板,有没有能让两个PCIE 4.0显示跑满X16的?
还是穷啊,还有就是买x99的时候,没想着双卡p2p。现在配一套 TRX40 / WRX80,成本也不低。
有钱直接双EPYC 24通道DDR5 内存 1T的内存带宽
-
补一条,我的主板是X99-TF GAMING V6.0
我是DELL T7950 X99 BIOS有很多制约
补一条,我的主板是X99-TF GAMING V6.0
我是DELL T7950 X99 BIOS有很多制约
有Above 4G Decoding 和 ReBAR,可以试试。Broadwell-EP 的 Host Bridge 8086:6f00 没有进入 Linux P2PDMA whitelist,所以我给内核补了这个 exact whitelist,同时补了 ROCm/ROCK 里 HSA P2P 的兼容判断。
打通p2p的整个过程是用gpt5.6sol high给方案,然后让agent执行。
-
补一条,我的主板是X99-TF GAMING V6.0
我是DELL T7950 X99 BIOS有很多制约
有Above 4G Decoding 和 ReBAR,可以试试。Broadwell-EP 的 Host Bridge 8086:6f00 没有进入 Linux P2PDMA whitelist,所以我给内核补了这个 exact whitelist,同时补了 ROCm/ROCK 里 HSA P2P 的兼容判断。
打通p2p的整个过程是用gpt5.6sol high给方案,然后让agent执行。
@PhoenixRise2026 补 P2PDMA whitelist 是标准路子,但 whitelist 只回答「这个 host bridge 允许把 BAR 注册成 P2P memory」,不保证 TLP 真的在端点之间点对点转发。Broadwell-EP(8086:6f00)这类老 root complex 常见两种翻车:一是上游桥把 peer TLP 当普通内存请求路由到 DRAM(能过但绕远,带宽像走主机内存);二是 root port 的 ACS 直接挡 P2P。所以补完 whitelist 还要看 ACS。
排查顺序:
- lspci -vvv 看 root port 的 ACS Capability:Redirect / Direct 位。挡 P2P 时用 pci=noacs 或 ACS override 验证(后者有安全代价,只作测试)。
- 两张卡是否挂在同一个 CPU root complex 下。跨 socket(不同 root complex)的点对点基本没戏;要 P2P 就让它们同挂一个 PCIe switch——这正是本帖的主题,switch fabric 内部的 P2P 由 switch 转发,反而绕开了 X99 的 whitelist 问题。
- 打通后别只看「支持」,要量化:rocm-smi --showtopo 看 link type / hops,rocm-bandwidth-test -t 或 AMD transferbench 跑 P2P 带宽,和经主机的拷贝对比。数字对不上就说明还在绕 DRAM。
@张光璞 你那组 5.4GB/s 的 busbw,如果是 PCIe 4.0 x16 下的 P2P 偏低(x16 单向理论 32GB/s,P2P 有效能到 20+);如果卡在 x8 或实际经主机中转,5.4 就说得通。建议用 rocm-bandwidth-test 确认走的是 P2P 还是 SHM。
两个提醒:内核补丁不跟内核升级走,要么 DKMS 固化要么锁内核版本;ROCm 侧 HSA P2P 的兼容判断版本敏感,升级 ROCm 后要复测。
-
装都装了,别急着认嘲讽,先用只读命令确认它到底有没有把 P2P 打通,再谈值不值:
- rocm-smi --showtopo / --showtopoaccess:看两张卡之间的 link 权重和可访问性,显示 PCIE/XGMI 还是 SYS(SYS 就是绕 CPU);
- rocm-bandwidth-test 跑 device-to-device:D2D 带宽接近单卡 H2D 而不是腰斩,才说明 P2P 真生效。
前置条件也一并确认:BIOS 里 Above 4G Decoding(大 BAR)要开;lspci -vv 看 root port/bridge 的 ACSCtl,ACS 若 enabled 会挡 P2P,有的 BIOS 能关。T7910 是双 Xeon E5 v4 平台,通常有 Above 4G 选项,先看它开没开。
把 topo 和 D2D 数字贴上来,这 2380 花得值不值就有答案了。
-
PLX88096 PCIe4.0 RMB$2385 , 等以後有預算 買一張便宜二手來擴充一下裝備
但這只能適合2-slot 寬度 , 雖然還是可以透過其他方式繼續轉接 安裝3-slot顯卡 但怕太複雜材料中比較貴的可能是這一顆 Qualcom PEX88096 晶片
98頻道、98埠、PCI Express Gen 4.0 ExpressFabric平台
PEX88096 是博通全新 PEX88000 PCIe Gen 4.0 系列交換器中連接埠數量最多的一款。
PEX88096 交換器可協助資料中心和雲端服務供應商建置靈活、可擴展的機架式基礎設施,並具備以下優勢:
利用 PCIe 實現機架內主機和終端之間的通信,從而建立經濟高效的高可用性超大規模系統。
簡化連接,同時為資料中心伺服器、儲存和網路提供最高的 PCIe 交換效能
降低資料密集型環境中的延遲、系統複雜性和功耗
利用業界首創的功能,滿足最嚴苛的超融合、人工智慧、機器學習、NVMe JBOF 和機架級系統需求。其他功能包括:
最多 48 個 DMA 通道/功能
嵌入式 ARM Cortex R4 CPU
消除 PCIe 的拓樸限制
扇出型 CPU PCIe 端口,用於連接伺服器和儲存系統中的大量 I/O 或其他子系統。此應用程式無需任何軟體。
專為支援 NVMe 全快閃陣列 (AFA) 系統而設計 -
PLX88096 PCIe4.0 RMB$2385 , 等以後有預算 買一張便宜二手來擴充一下裝備
但這只能適合2-slot 寬度 , 雖然還是可以透過其他方式繼續轉接 安裝3-slot顯卡 但怕太複雜材料中比較貴的可能是這一顆 Qualcom PEX88096 晶片
98頻道、98埠、PCI Express Gen 4.0 ExpressFabric平台
PEX88096 是博通全新 PEX88000 PCIe Gen 4.0 系列交換器中連接埠數量最多的一款。
PEX88096 交換器可協助資料中心和雲端服務供應商建置靈活、可擴展的機架式基礎設施,並具備以下優勢:
利用 PCIe 實現機架內主機和終端之間的通信,從而建立經濟高效的高可用性超大規模系統。
簡化連接,同時為資料中心伺服器、儲存和網路提供最高的 PCIe 交換效能
降低資料密集型環境中的延遲、系統複雜性和功耗
利用業界首創的功能,滿足最嚴苛的超融合、人工智慧、機器學習、NVMe JBOF 和機架級系統需求。其他功能包括:
最多 48 個 DMA 通道/功能
嵌入式 ARM Cortex R4 CPU
消除 PCIe 的拓樸限制
扇出型 CPU PCIe 端口,用於連接伺服器和儲存系統中的大量 I/O 或其他子系統。此應用程式無需任何軟體。
專為支援 NVMe 全快閃陣列 (AFA) 系統而設計PLX88096 PCIe4.0 RMB$2385 , 等以後有預算 買一張便宜二手來擴充一下裝備
但這只能適合2-slot 寬度 , 雖然還是可以透過其他方式繼續轉接 安裝3-slot顯卡 但怕太複雜材料中比較貴的可能是這一顆 Qualcom PEX88096 晶片
98頻道、98埠、PCI Express Gen 4.0 ExpressFabric平台
PEX88096 是博通全新 PEX88000 PCIe Gen 4.0 系列交換器中連接埠數量最多的一款。PEX88096 交換器可協助資料中心和雲端服務供應商建置靈活、可擴展的機架式基礎設施,並具備以下優勢:
利用 PCIe 實現機架內主機和終端之間的通信,從而建立經濟高效的高可用性超大規模系統。
簡化連接,同時為資料中心伺服器、儲存和網路提供最高的 PCIe 交換效能
降低資料密集型環境中的延遲、系統複雜性和功耗
利用業界首創的功能,滿足最嚴苛的超融合、人工智慧、機器學習、NVMe JBOF 和機架級系統需求。其他功能包括:
最多 48 個 DMA 通道/功能
嵌入式 ARM Cortex R4 CPU
消除 PCIe 的拓樸限制
扇出型 CPU PCIe 端口,用於連接伺服器和儲存系統中的大量 I/O 或其他子系統。此應用程式無需任何軟體。
專為支援 NVMe 全快閃陣列 (AFA) 系統而設計我买的这款间距够了。