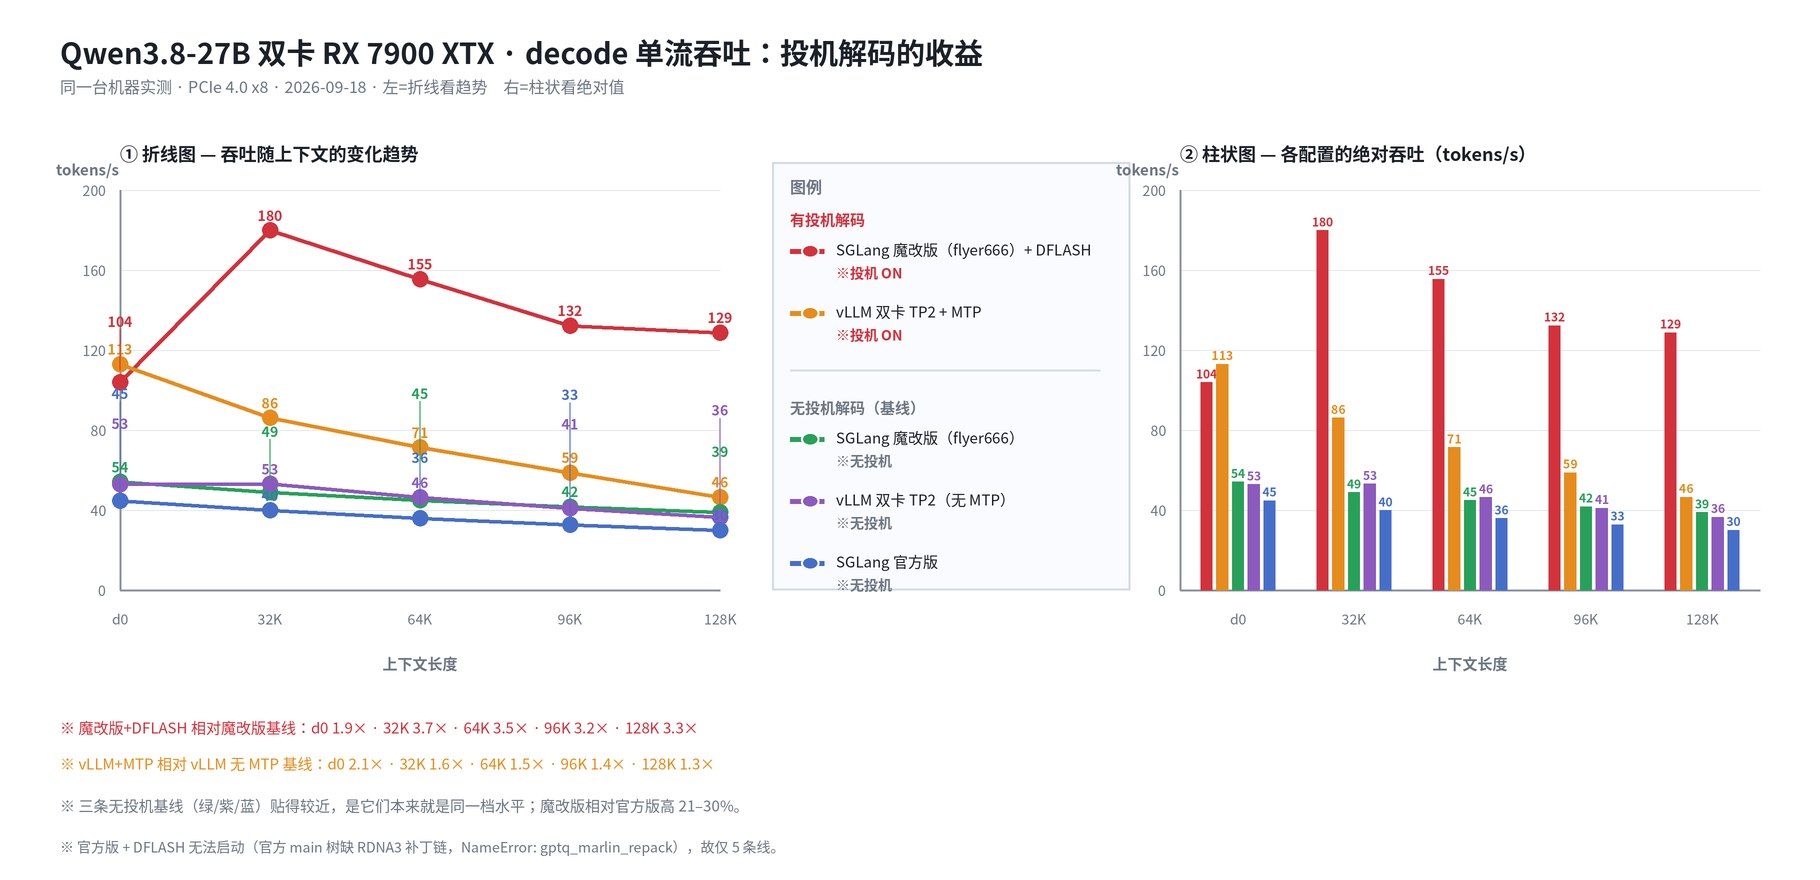
魔改SGLANG支持7900XTX 双卡TP V2 DFLASH2 单流220Token/s
-
我弟的测试非常精髓,这是本站神卡7900XTX的封神之作,最后一块短板倍补齐,还是可以折腾下FP8 KV,社区找找方案,到时候让大家抄作业,还有你不是要测试hicache吗?失败了吗?这玩意和FP8KV必须搞定一个
-
@terry 哈哈哈 这周在搞一个更好玩的project: 把qwen3.8 flash next 从我的这台机器上拉起来,等搞完再看看。
fp8 kv cache估计是不太行,主要是sglang架构问题和7900xtx的硬件支持导致的,我试了几次,就算拉起来16k的prefill就会掉到200几乎不可用,vllm的page attention没这个问题,可以跑fp8 kv (参考我最早的帖子)
-
根据楼主的文章,我也测试了SGLANG和VLLM,发现SGLANG只是纯 Prefill 吞吐、尤其是多并发短 Prompt,vLLM 更高
文章的 PP=2048、并发4 测试里:
vLLM baseline:1891 tok/s
而:
SGLang DFlash2:1275 tok/s
最终还是选择SGLang是嘛 -
根据楼主的文章,我也测试了SGLANG和VLLM,发现SGLANG只是纯 Prefill 吞吐、尤其是多并发短 Prompt,vLLM 更高
文章的 PP=2048、并发4 测试里:
vLLM baseline:1891 tok/s
而:
SGLang DFlash2:1275 tok/s
最终还是选择SGLang是嘛这两个数不是同一口径,别直接下结论:
- vLLM 1891 是 baseline(无投机),SGLang 1275 是 DFlash2 路径。投机解码在 prefill 阶段不省反增——要多跑一个 drafter、还要验证,收益全在 decode。所以多并发短 prompt 的纯 prefill SGLang 输是正常的,不代表引擎本身弱。
- 选型按负载:
- 多并发、短 prompt、TTFT/prefill 敏感,用 vLLM,或者 SGLang 关掉投机;
- 单流或少并发、长上下文、decode(TG) 敏感,用 SGLang + DFlash2(也就是 flyer666 那 220 tok/s 的场景);
- 自己一个人用,多并发通常不是刚需,长 ctx 下的 TG 才决定体感,SGLang 更划算。
- 想公平比,把 SGLang 的投机关掉再跑一遍同样的 PP=2048/c=4,才能把「引擎差距」和「投机开销」分开。
-
@flyer666 我发的数据就是 D4 的数据,已经把补充的信息贴上去了
-
,系统 取消固定了此主题
-
,F franklee006 引用了 此主题