Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G
-
视频搬运工:
Youtube Video -
直接讲你的体验或看法。
以后不要搞这种视频转接。可以转接但是要有你个人的看法。
警告。二次删号。 -
只是分享一个刚看到的信息而已,本人不是原作者,也不是什么推广。
一直比较关注Mac生态罢了;受不了PC。分享给大家品品靠不靠谱而已;毕竟新的Mac Studio上来了一大波硬件
回到问题本身:Mac 上跑文生图/视频,2026 年「能跑」和「跑得爽」是两回事。
能跑:
- 图像:ComfyUI / Draw Things / MLX 系已有 Metal (MPS) 后端,SDXL、Flux 的 fp16/bf16 都能出图。M5 Max 40 核 GPU + 64G 统一内存出图速度大致是同价位 NVIDIA 的 1/3–1/2,卡在没有 CUDA/cuDNN,不少自定义 kernel 走不到最优路径。
- 视频:WAN、LTX 这类 i2v 在 Mac 上主要走 MLX 或 PyTorch MPS,能出,但统一内存容量和算子覆盖是瓶颈;高分辨率、长时长基本要降到 480p 短片段,再靠后期接。
「跑得爽」的门槛:
- 生态:视频模型的加速(FlashAttention、xformers、量化 kernel)优先 CUDA,Mac 经常只能等移植或退回慢路径。
- 内存带宽:这一代 Max 大致 550–700GB/s 量级(以实测为准),比 HBM 的 ~1.8TB/s 差约 3 倍,权重读取直接决定出图步速。
- 64G 统一内存要同时装系统、模型、latent 和 KV,玩视频模型建议 128G 起。
结论:拿 M5 Max 做「文生图 + 短视频草稿/实验」可以,做 90 分钟成片或高吞吐生产不划算。把你要跑的具体模型发出来,我可以帮你查它在 Mac 上的后端支持情况。
-
被扣了声望,原贴想要修改编辑也不能了。
补上一些吧:
刚看到的Mac MinMaxH3 优化后MacBook 高配生视频介绍。
Mac Studio上线后有两个屌丝位:
M5Max 40GPU 614G带宽 64G内存 $3799 (1T硬盘)
M5Ultra 64GPU 1.2T带宽 96G内存 $5499 (1T硬盘)目标如果是架设本地AI Qwen3.8-27B(35B)
偶尔有少许文生图,或少量视频生成需求,是不是会成为这个巨大的硬件甜点位?我有看到comfyui 原生是支援macos...
但是速度如何就不知道了,但是按照声音和照片的生成,应该不会慢的
只是视频生成就再看看
-
被扣了声望,原贴想要修改编辑也不能了。
补上一些吧:
刚看到的Mac MinMaxH3 优化后MacBook 高配生视频介绍。
Mac Studio上线后有两个屌丝位:
M5Max 40GPU 614G带宽 64G内存 $3799 (1T硬盘)
M5Ultra 64GPU 1.2T带宽 96G内存 $5499 (1T硬盘)目标如果是架设本地AI Qwen3.8-27B(35B)
偶尔有少许文生图,或少量视频生成需求,是不是会成为这个巨大的硬件甜点位? -
我选Mac Studio M5 Max的理由:
等M5 Max Studio的原因:
- MacBook 14 散热太差其实跑不动M5 Max
- MacBook 16 依然很难发挥Max全部能力,同时便携性很差;除非贪他的优秀大屏。
- 个人没有很大的移动办公需求;现在出门可以用Telegram远程下指令调配任务,固定的工作站式24*7的服务器模式更合适。已经在用M4的Mac Mini作为小型家庭服务器,体验极佳。
- 相比MacBook,相同配置Studio价格更实惠
-MacBook 16 Max-40GPU,64G,2T-最低标配 - $5,399; 直逼低配Ultra了 ($5,499) - 为什么选这个配置 (40GPU, 64G内存)?
- 32GPU只有400多G内存带宽;40GPU才有614G (Ultra 统一都是1.2T)
- 128G内存价格也直逼Ultra低配版了(1T硬盘,$5,399),(96G内存 $5,499; 有这个预算的话,个人建议直接上最低配的Ultra
- 个人暂时没有音视频工作流的打算,如果有大多也不会选Mac吧;多开还是Ultra高带宽高内存更好;当然有钱啥都不是事儿;综合考量着现在这个价位能跑本地Qwen3.8-27B游刃有余,可坚固日常办公Agent任务需求;是很好的中间位
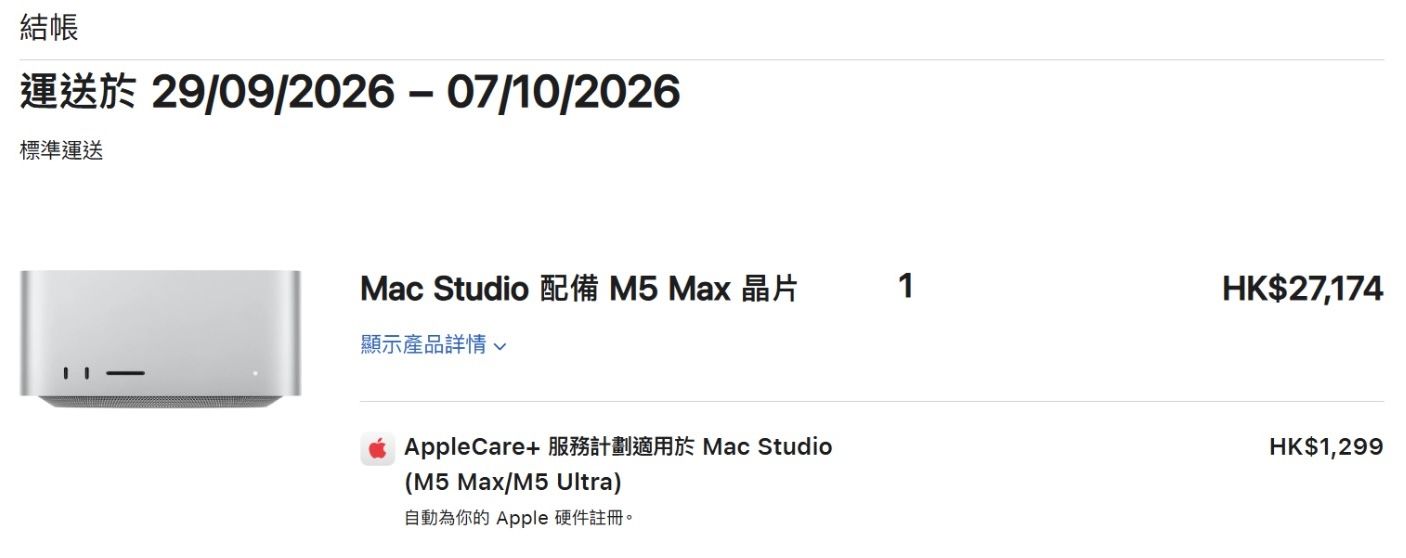
- 缺货问题。现在我这边Max 128G是期货,待机1个月+

; Ultra 低配待机已经超过2个月

;
-
第一手测试资料:
先说基准测试 - MLX:
Qwen3.8-27B-MLX-6bit (模型 22.8G)
目前四档实测
Context Prefill Decode Peak Memory 512 tokens总时间
8K 921.3 tok/s 23.17 tok/s 25.26 GB 30.9 s
32K 845.4 tok/s 21.62 tok/s 26.87 GB 62.5 s
128K 596.8 tok/s 16.69 tok/s 33.69 GB 248.8 s
256K 436.7 tok/s 13.05 tok/s 42.74 GB 643.7 sQwen3.8-27B-MLX-4bit (模型 16.1G)
Context Prefill Decode Peak Memory 512 tokens总时间
8K 985.1 tok/s 31.92 tok/s 18.53 GB 24.3 s
128K 626.1 tok/s 21.10 tok/s 26.96 GB 231.6 s
256K 447.2 tok/s 15.49 tok/s 36.01 GB 613.8 s基准和网上MacBook M5 Max的测试数据差不多;长上下文内存占用不多,256K 6Bit差不多42G,4Bit36G,还是跑的动,且有冗余20来G分配给系统和Agent等。长上下文是主要耗时还是在Prefill,将近10分钟。
-
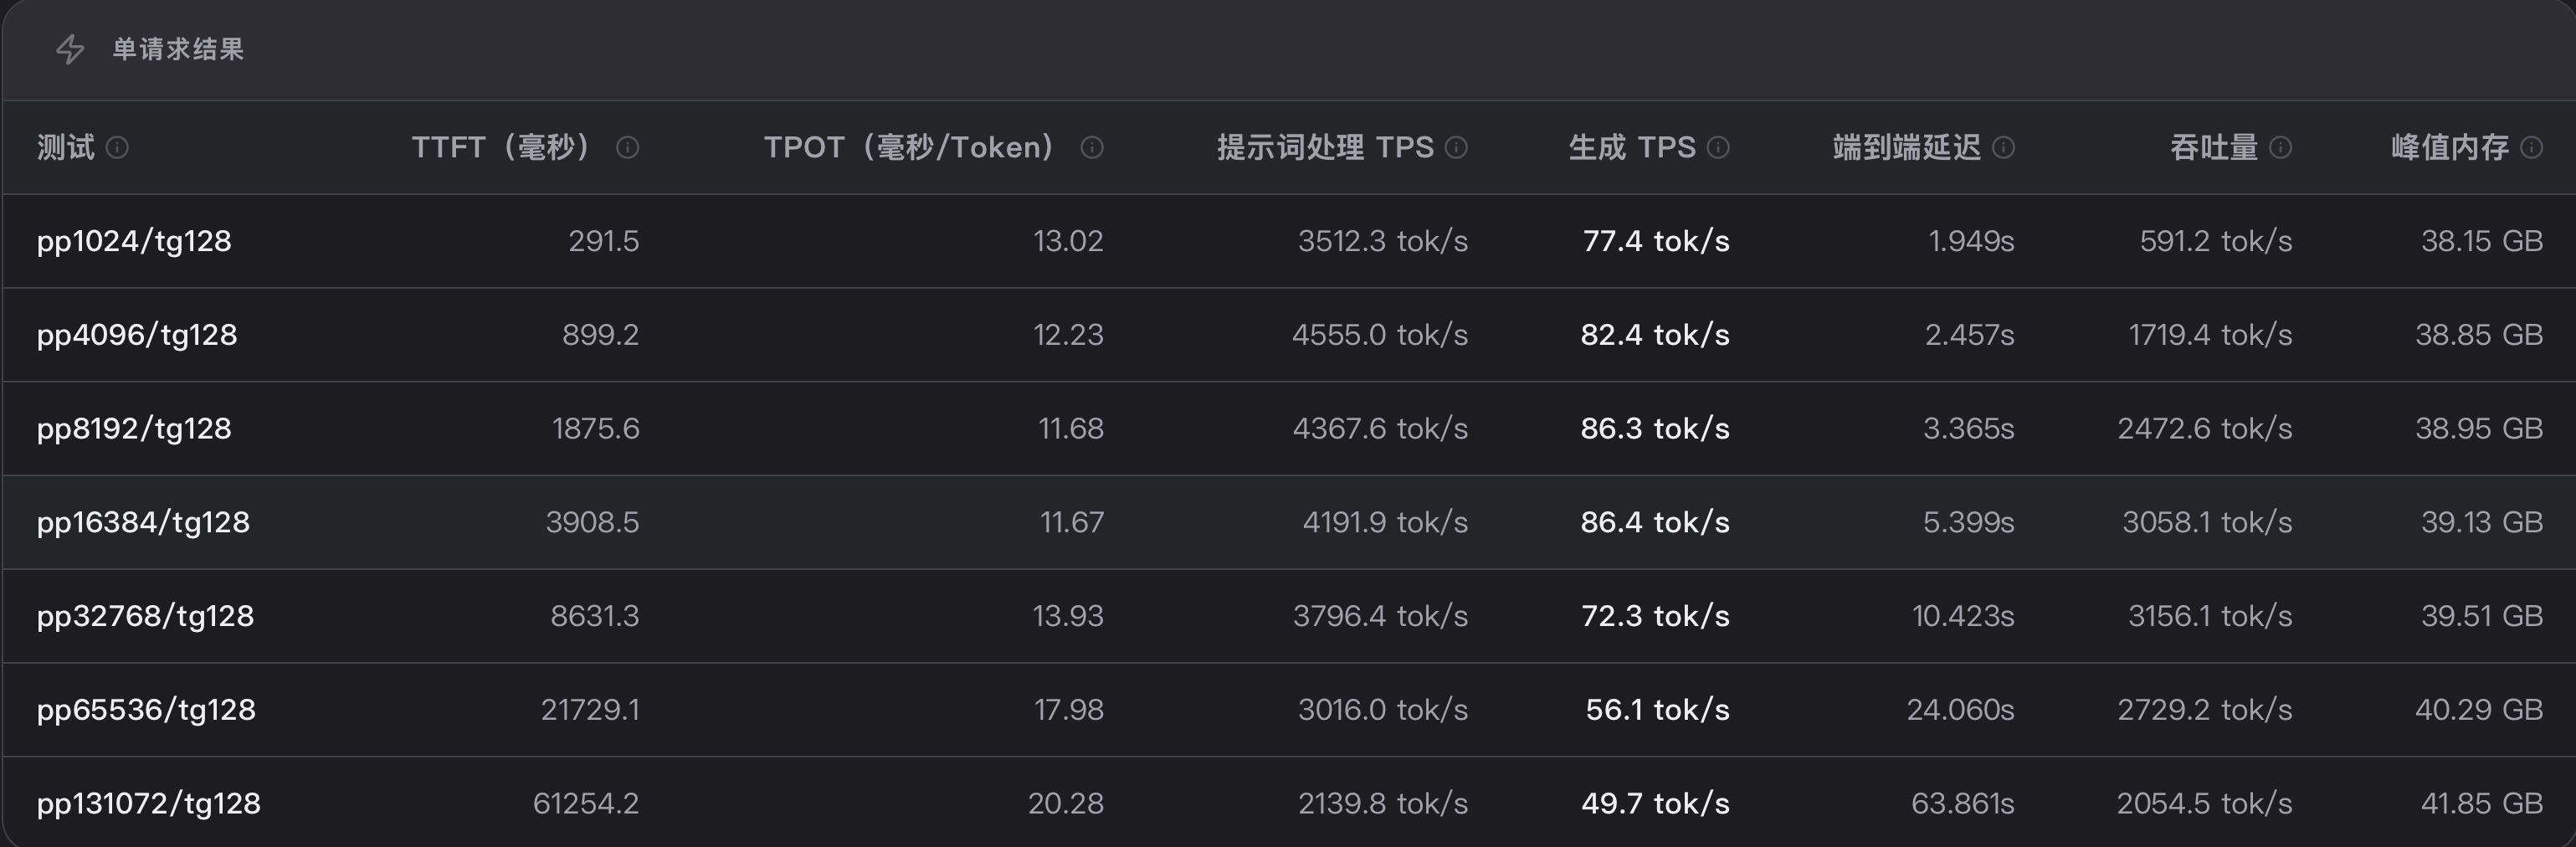
用oMLX加载MTPLX优化的模型,关闭思考,启用Lightning MTP
Model用的是Qwen3.8-27B-MTPLX-Optimized-Speed (19.5G)
执行简单回话,任务,写个贪吃蛇小游戏
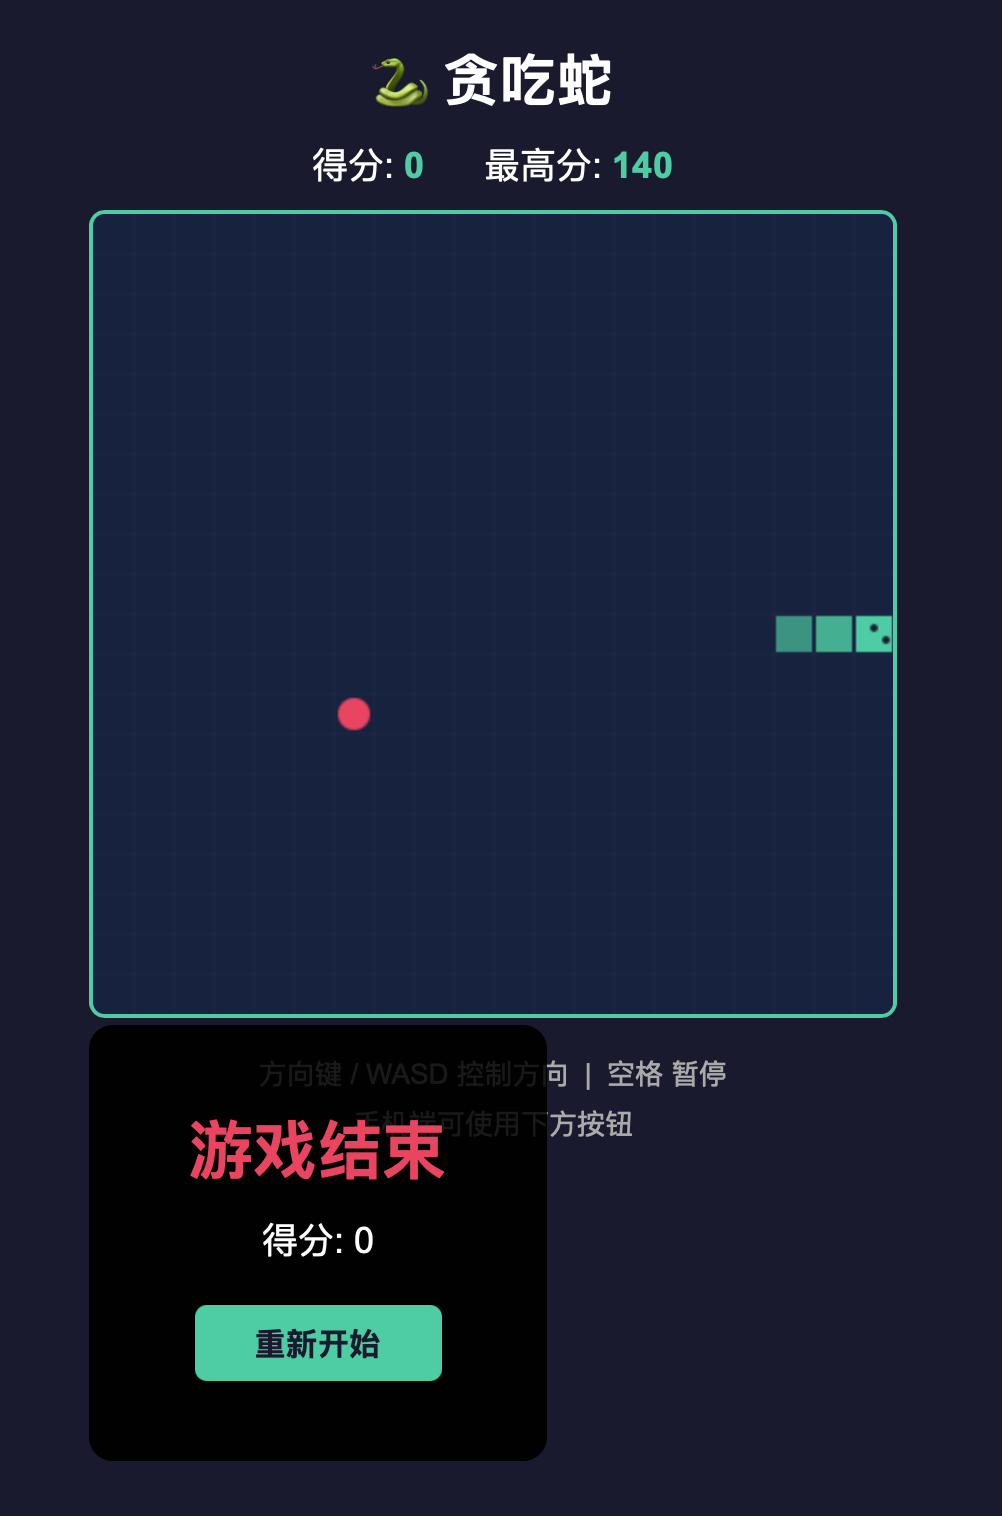
一次成功,图形画面也不错
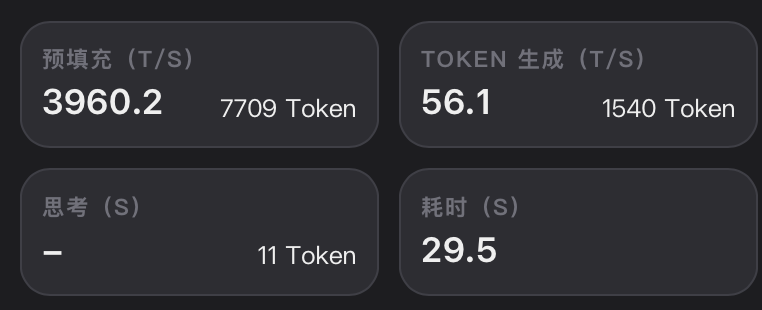
数据还挺漂亮。
性能测试结果: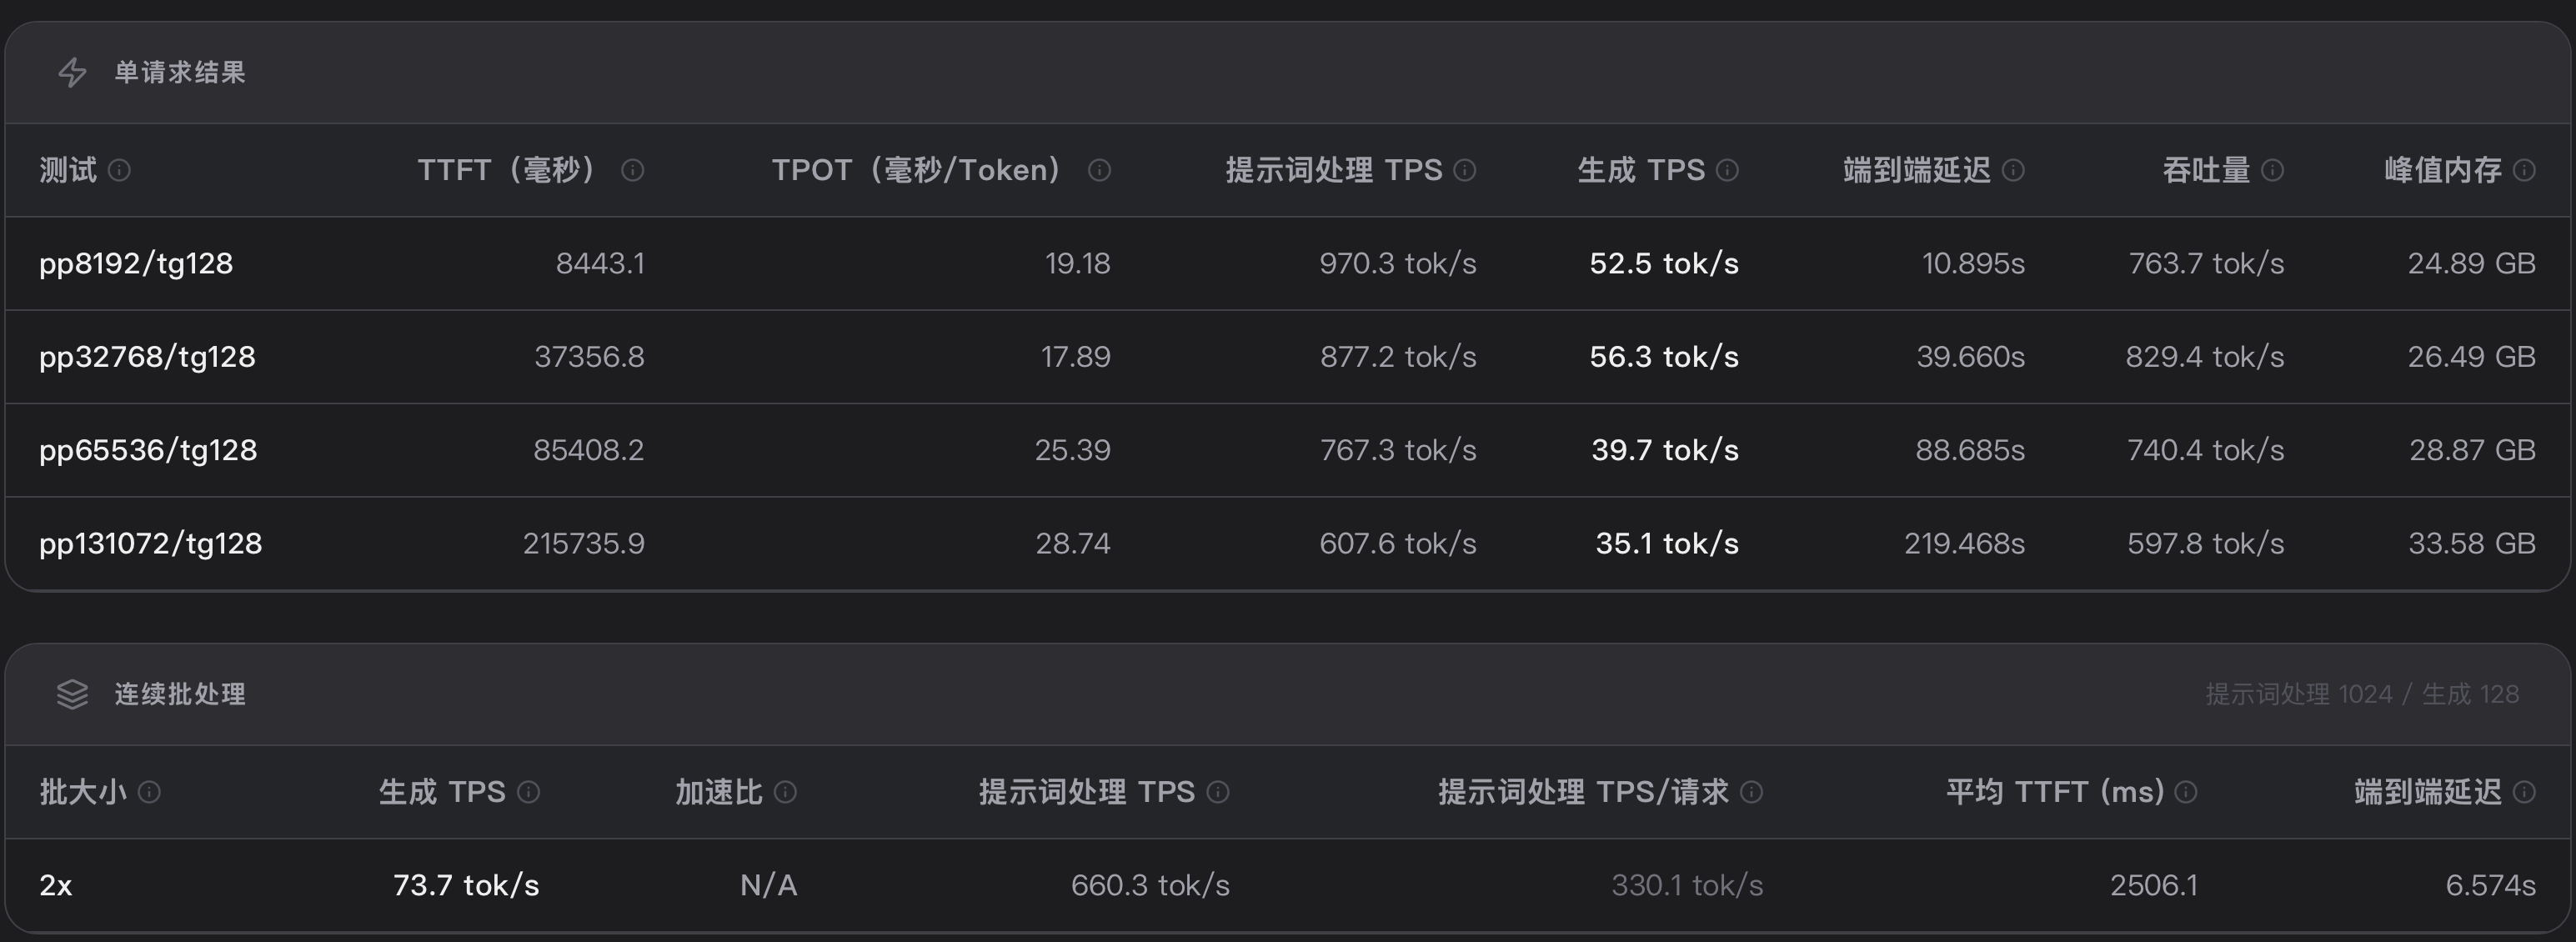
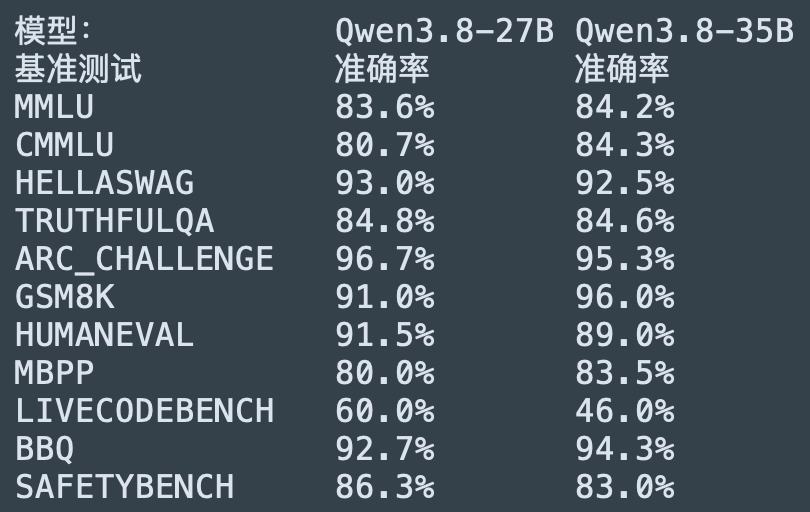
智力测试结果:
智能基准对比模式 抽样 Qwen3.8-27B-MTPLX-Optimized-Speed
MMLU 抽样 1000/14042 83.6%
CMMLU 抽样 300/11582 80.7%
HELLASWAG 抽样 200/10042 93.0%
TRUTHFULQA 全量 817 84.8%
ARC_CHALLENGE 抽样 300/1172 96.7%
WINOGRANDE 抽样 300/1267 79.0%
GSM8K 抽样 100/1319 91.0%
HUMANEVAL 全量 164 91.5%
MBPP 抽样 200/500 80.0%
LIVECODEBENCH 抽样 100/1055 60.0%
BBQ 抽样 300/10864 92.7%
SAFETYBENCH 抽样 300/11435 86.3%--- 详情 ---
模型:Qwen3.8-27B-MTPLX-Optimized-Speed
基准测试 准确率 正确 总数 Time(s) 思考MMLU 83.6% 836 1000 856 否
CMMLU 80.7% 242 300 93.5 否
HELLASWAG 93.0% 186 200 82.9 否
TRUTHFULQA 84.8% 693 817 245.3 否
ARC_CHALLENGE 96.7% 290 300 106.8 否
WINOGRANDE 79.0% 237 300 79.7 否
GSM8K 91.0% 91 100 515 否
HUMANEVAL 91.5% 150 164 375.9 否
MBPP 80.0% 160 200 535.2 否
LIVECODEBENCH 60.0% 60 100 2561 否
BBQ 92.7% 278 300 86.2 否
SAFETYBENCH 86.3% 259 300 91 否可能是关闭思考的关系,LiveCodeBench测试只拿到了60%
别的基本都还挺高