
双AI Pro R9700 VS 4090 48G魔改卡,曾经被吊打,现在却咸鱼翻身?AMD生态大跃进,HaloGen,SGLang,Minimax等畅玩AI!
-
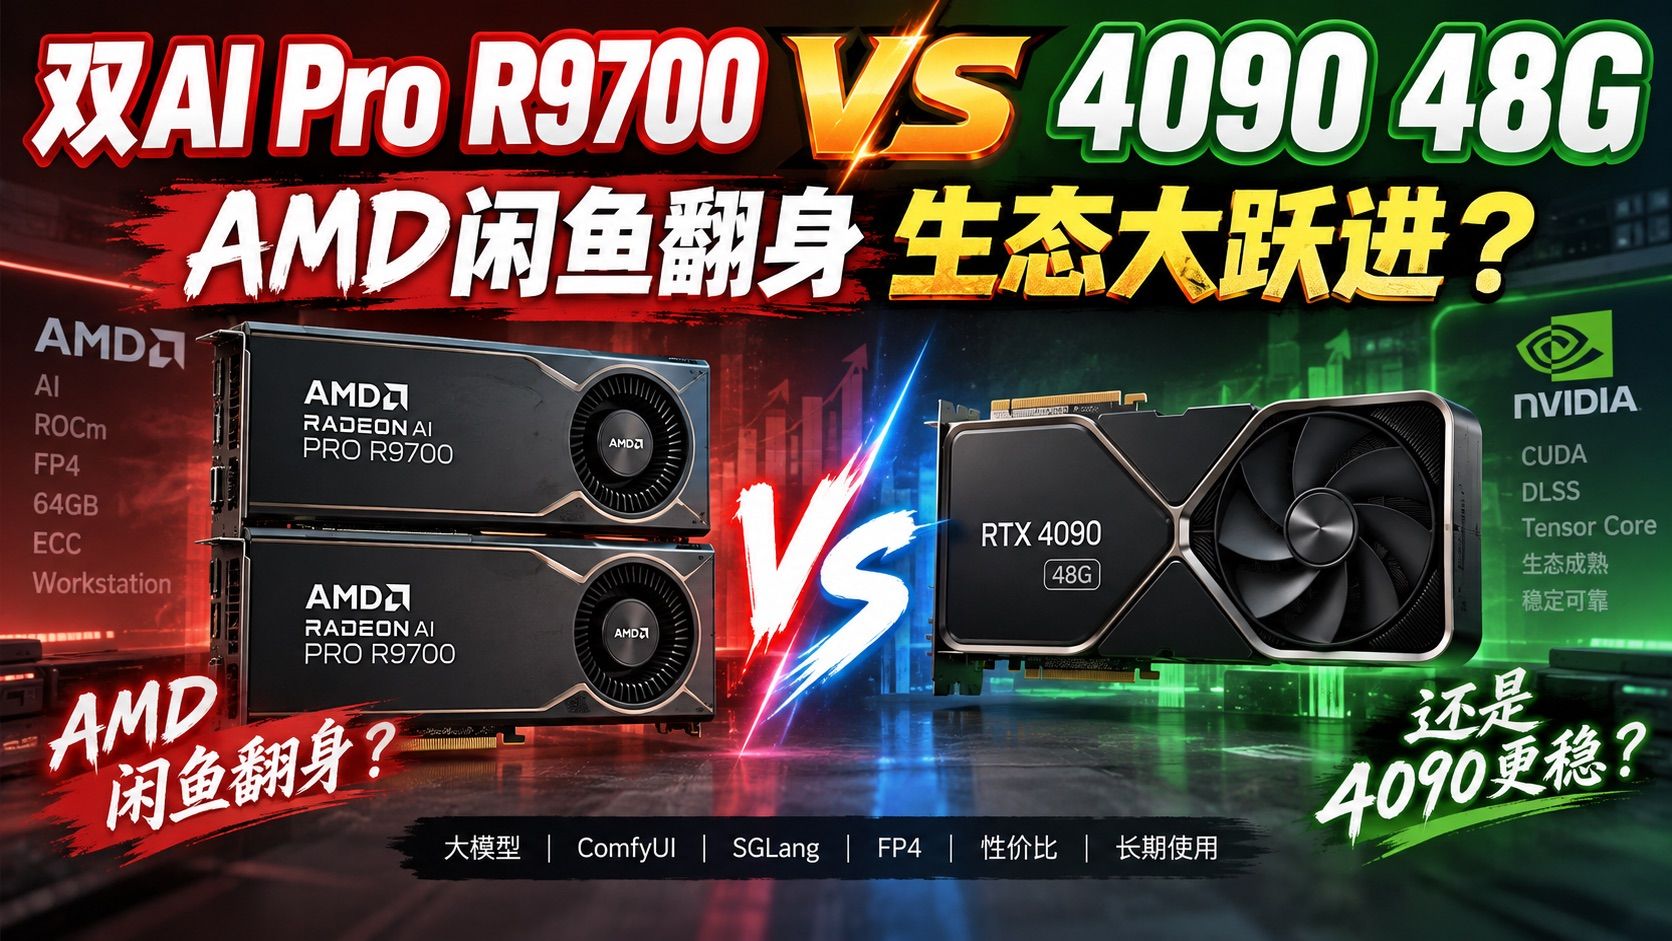
首先回答论坛网友的这个问题,就是双卡 R9700 跟 4090 48G 单卡到底怎么选。
在我这个频道刚刚成立的时候,那个时候我是比较关注 AMD 的显卡,因为性价比特别高。但是当时我是比较推荐大家买 7900 XTX,因为这个 24G 的显存,当时价格 6000 块钱左右,后来一度降到 5000 块钱,还没有到达 8000 块钱这么一个夸张的地步。那么那个时候毫无疑问买 7900 XTX 更好。R9700 由于它的带宽比 7900 XTX 要少一点,大概只有它的 2/3。7900 XTX 的带宽是 960 GB/s,略低于 4090 的 1 TB/s 带宽,然后 R9700 只有 640 GB/s 的带宽。那么在这种情况下,我建议入门的新手,第一为了省钱,第二为了更快的计算速度,买 7900 XTX 可能体验会更好一点。但是当时我也说了,R9700 这张卡是有潜力的,因为它支持 FP4。虽然当时 AMD 的 FP4 还是非常蛮荒,包括它的 FP8,生态还是不好,但是这个东西未来新的架构一定是有它的意义的。
而且当时你要知道,AMD 的生态比英伟达的生态差到什么程度。如果跑大模型的话,英伟达的卡用 SGLang 跑双卡 TP,其实难度是不高的。虽然有这样那样的问题,但是只要你花时间,愿意去钻研,最多一个星期、两个星期,你还搞不定吗?AMD 的显卡当时跑 SGLang 双卡 TP,那简直就是灾难,根本就跑不起来。而且当时跑 ComfyUI 也是,在 Windows 上你买 R9700 去跑 ComfyUI,无论 LTX 还是 Wan,当时是 LTX 2.0,Wan 大概是 2.1、2.2,那么 R9700 的体验可以说被 4090 48G 吊打,可能连它 1/5 的速度都没有,跑起来就很勉强,很多工作流根本就不能跑。在 Linux 上,大概也只是 4090 48G 速度的 1/3 到 1/4 这个水平,就很 low,完全没有 CP 值。
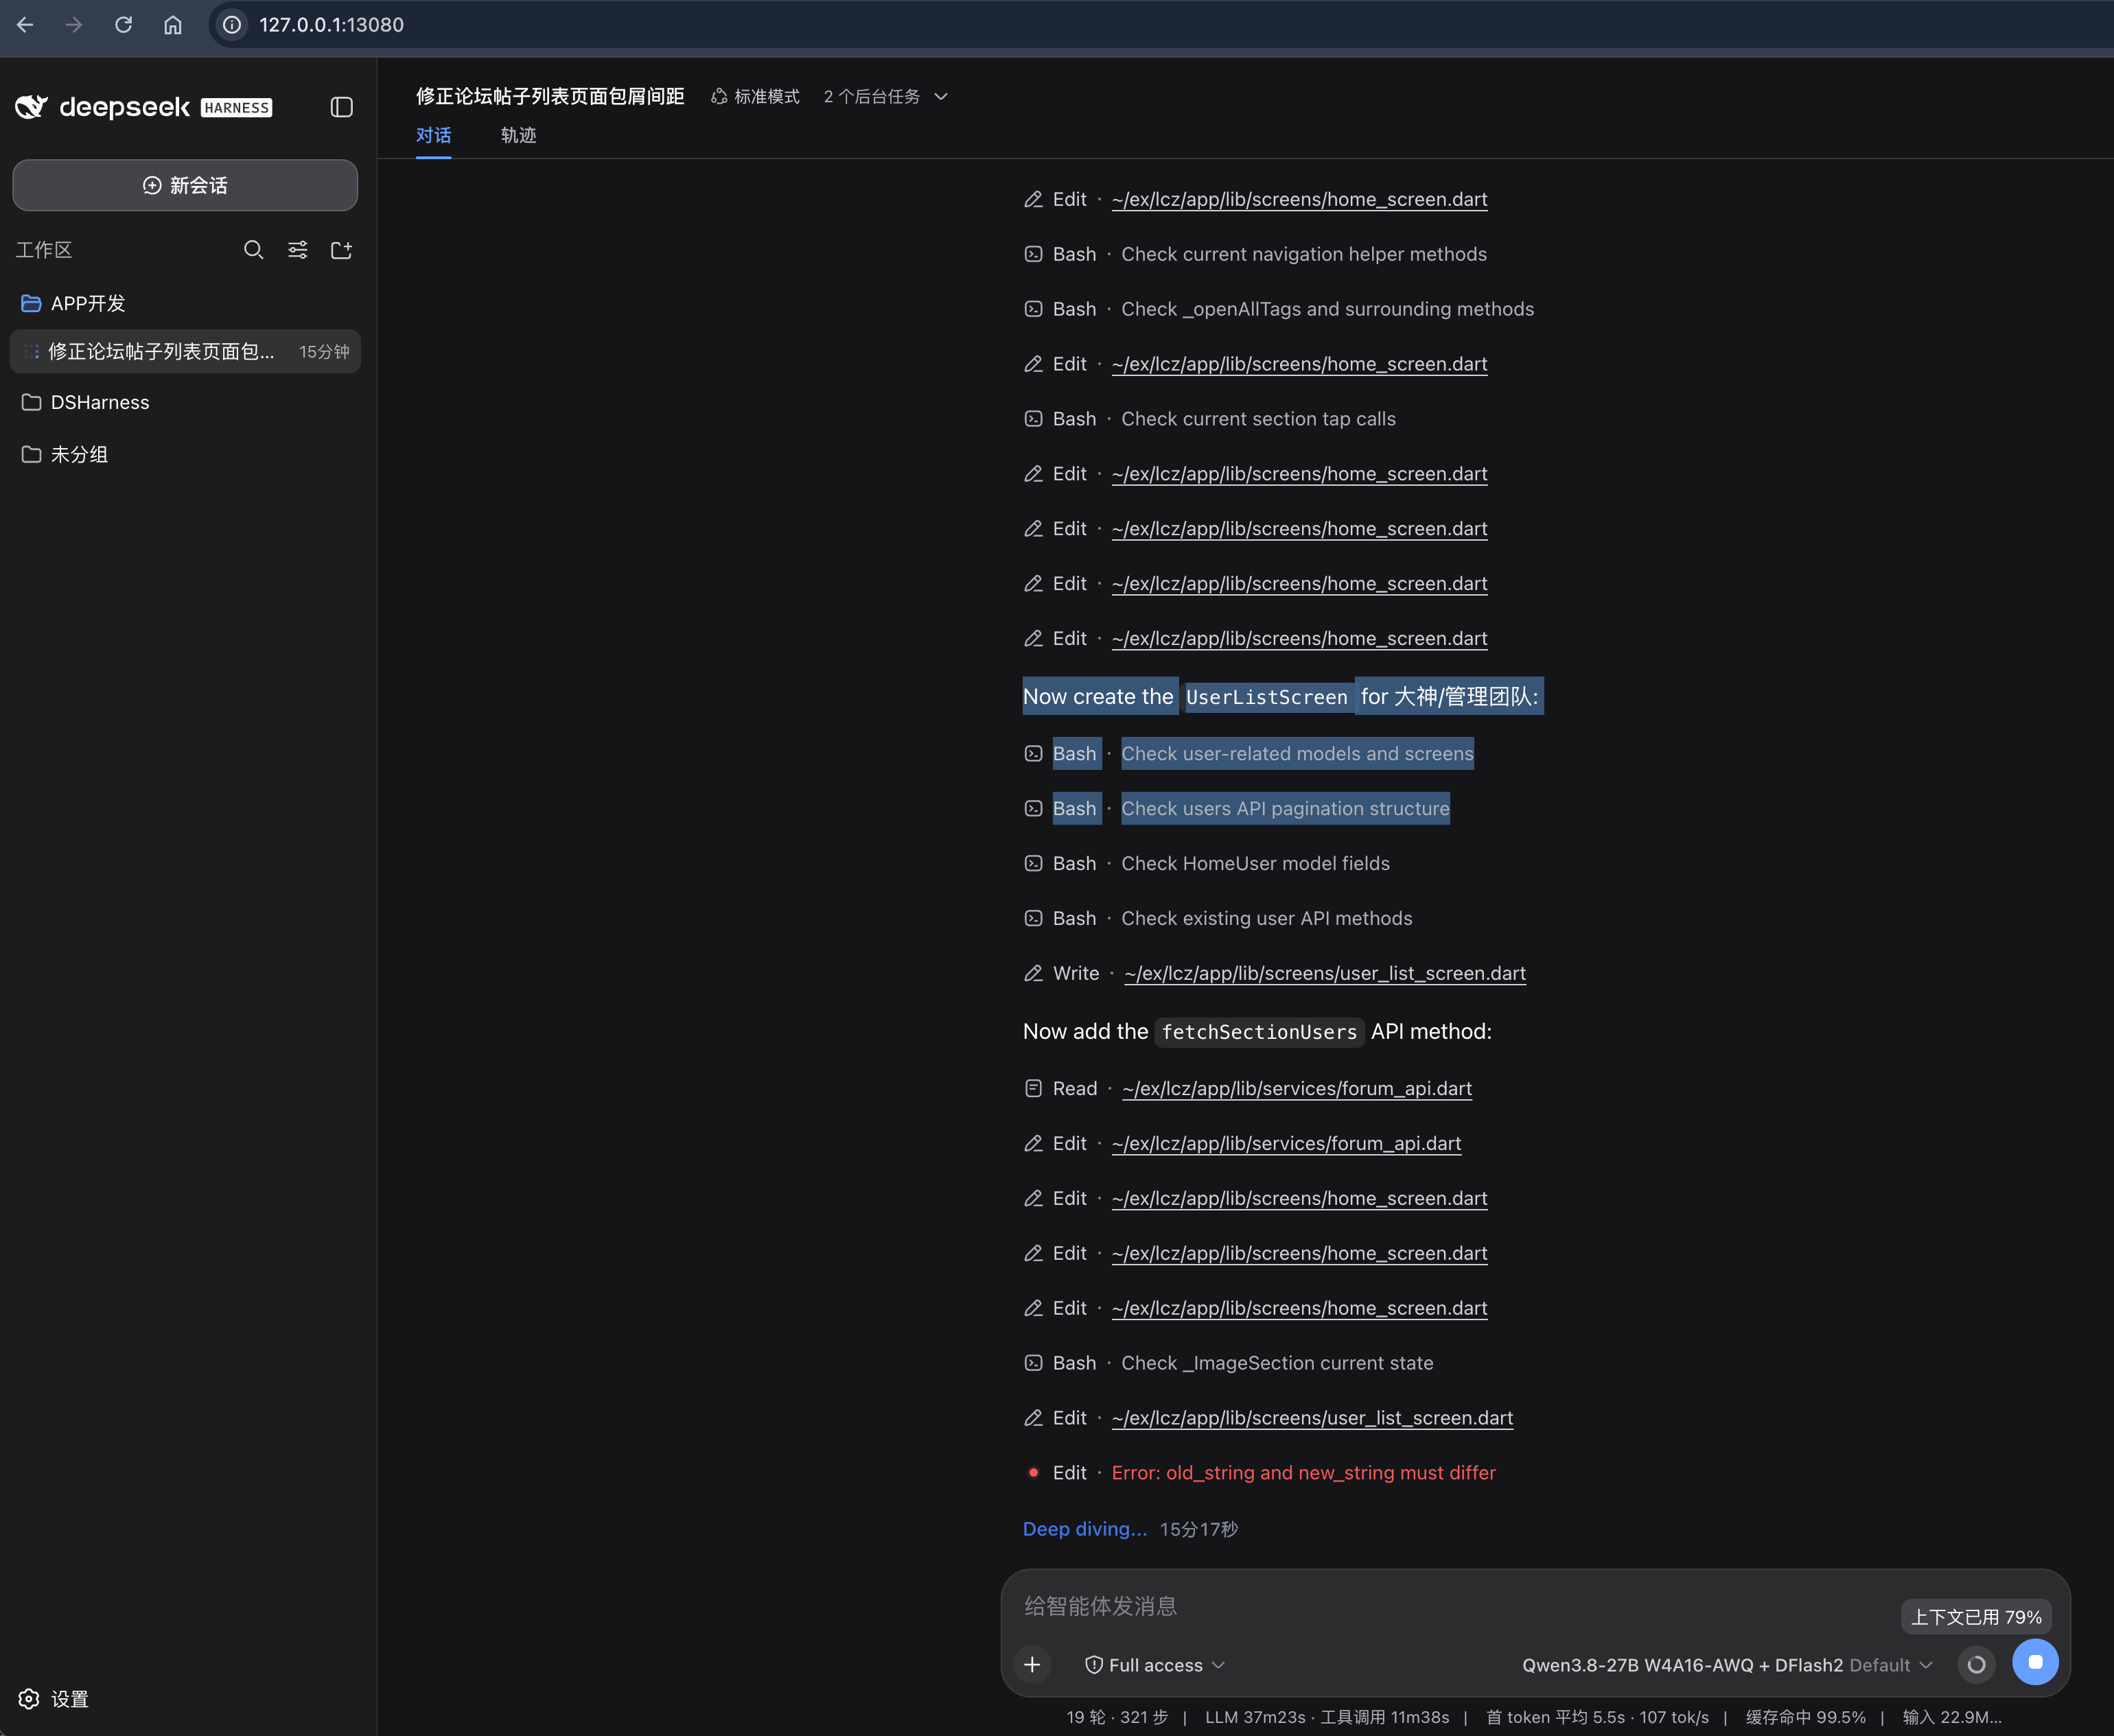
然后由于它的生态劣势,你还要花很多时间去搭建。当时的 AI 还不够聪明、不够智能,不像现在,你把需要搭建的环境告诉 Codex,告诉 Hermes,或者告诉 DeepSeek Harness,它们就能帮你搞定。那个时候我们要配置系统环境,是要手搓的。大家翻看我早期的视频,就那么小半年之前,你想一想这个 AI 的进步有多快。小半年之前,我们都还不敢奢望。到 OpenClaw 出来,OpenClaw 现在都凉了,然后 Hermes 替代 OpenClaw。有一段时间 DeepSeek 突然间,尤其是在 DeepSeek V4 Flash 这个模型发布之后,我们才发现这个东西已经成为现实的生产力了。如今有了 DeepSeek V4.1 Flash,我可以说无论你接入哪个 Agent,你要去配置这些系统环境,那简直是手到擒来。
那么在这几个月还发生了非常重要的事情,就是 AMD 的生态得到了极大的完善。就在 Windows 上,现在有比较炒作的开源项目,像 CUDA for AMD,像机智罗的机智启动器。尤其是机智启动器,大概两个月之前我那个时候就测试它,就发现这个玩意还挺好用的,能够帮助 AMD 的新手用户在 Windows 上快速建立自己的这么一个生产线。而且机智罗还给了默认的一些工作流,它的工作效果还非常不错。现在这个生态已经是越来越完善了。然后在 Linux 上,它现在基本上 N 卡能跑的工作流,A 卡都能跑了,而且效率差距其实并不大,就没有像以前那么夸张了。
然后还有更重要的,就是大家关注的所谓 SGLang 双卡 TP。为什么一定要强调 SGLang?就是说 llama.cpp 也好,还是 vLLM 也好,它们在轻度的会话中,或者比如你的上下文在 32K 以下的时候,没有那么复杂的日常任务中,其实 llama.cpp 的体验是很好的,vLLM 的体验应该是最好的,它比 SGLang 的体验还好。可是如果你要长期做复杂的任务、做长链的任务,比如开发 App 也好,还是长期管理一个论坛也好,或者其他一些复杂的任务,比如开发一个视频生成器、视频剪辑器,在这种情况下它必须叫上 SGLang。因为 SGLang 有它的核心优势,就是 Radix 缓存树。它只需要计算提示词的增量部分,KV 缓存只做增量计算,它的 prefill 压力要大大降低,同时能够支撑的并发量就会更大。它是真正能够支持长上下文,然后体验还不错,能够把本地模型的体验做到跟在线模型差不多的这么一个推理框架。
而以前可能 AMD 对它的支持就是狗屎。虽然英伟达你看起来,人家甚至都不用 Docker 镜像。我有一段时间跑的话,就是让它自己去安装,让 AI 自己去安装,直接安装原生的 SGLang,都不用 Docker 镜像。AMD 不仅是要用 Docker 镜像,而且你找不对镜像的话,基本上跑不起来。最近这段时间,各种适配 7900 XTX、适配 R9700 的 SGLang 框架又爆火起来,很多你都想不到。不仅是镜像多,而且它支持的模型、版本五花八门的,并且它们也都支持 AMD 的 MXFP4。那么在这种情况下,它双卡 TP 之后跑大模型的效果是完全不输给 4090 48G 单卡的,毕竟它双卡是 64G 显存。
然后 ComfyUI 的话,它虽然现在的速度只是 4090 48G 的 1/3 左右,但是毕竟它是两张卡,它可以同时跑两个任务。那么你买到手之后跑 ComfyUI,你的体验是略差于单卡 4090 48G。双卡 TP 的话,你跑大模型的效率是略高于 4090 48G。并且我们不要忘了,最近还有一个叫做 HaloGen 的东西,就是针对 AMD 的 AI Max 395 小盒子做的一个定制推理框架。但是这个玩意有人好像也是模仿它,还是魔改它,就把它也跑在 R9700 的 AMD 显卡上,它的效果还非常不错。那么有了这些东西的加持,AMD 的生态目前确实是不比英伟达差多少了。
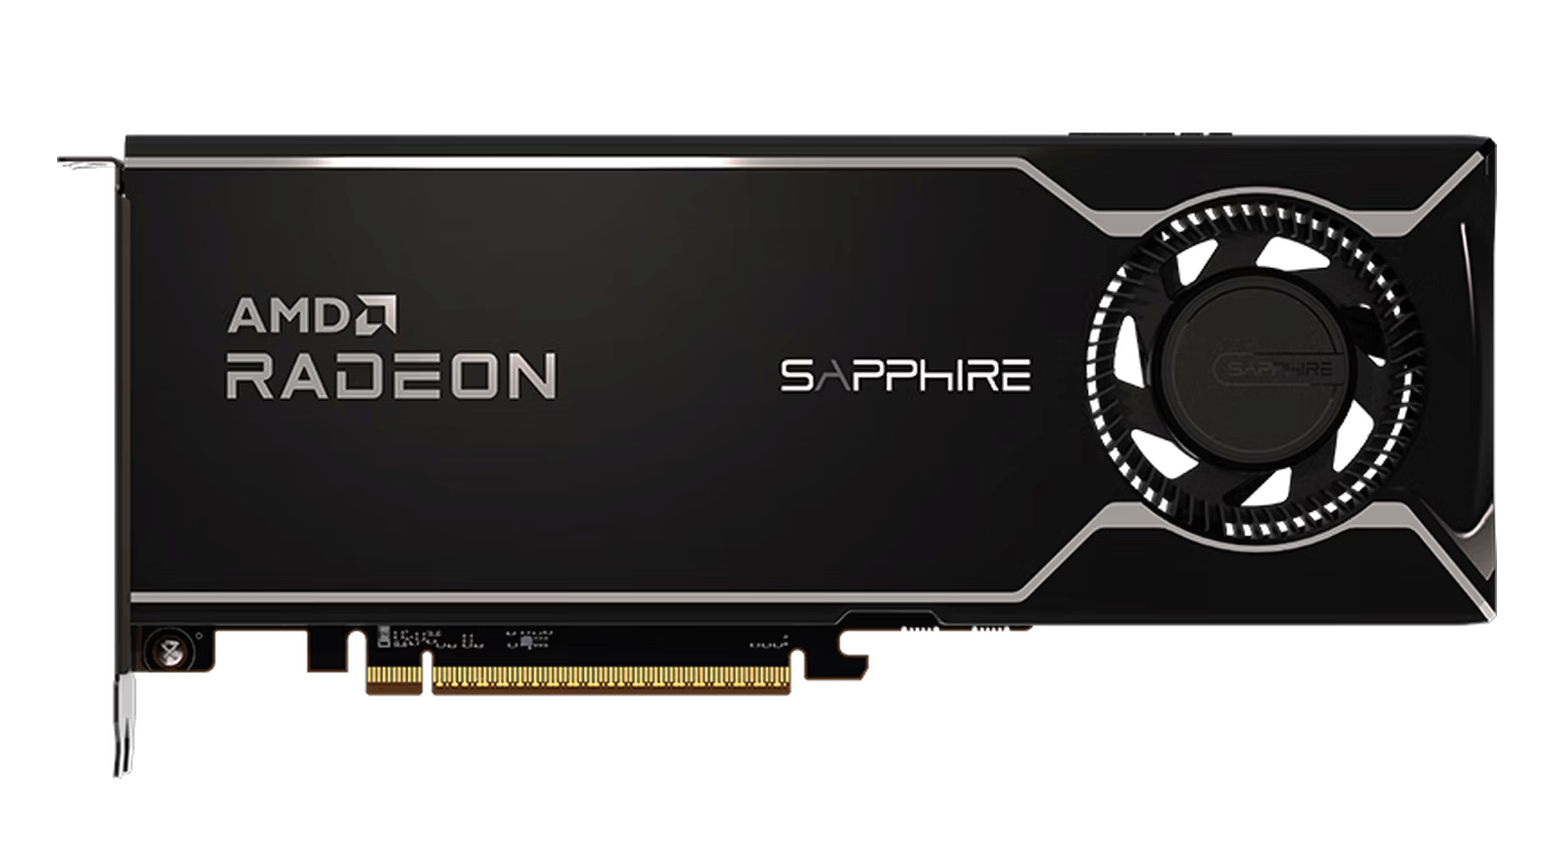
而且现在配置这些东西,我们把它交给 DeepSeek V4.1 Flash,无论你用 Hermes、DSH,还是用 Codex,它都可以非常轻松地搞定,我们自己就不用去操心了。而且我们不要忘了,为什么当初推荐大家买 4090 48G 魔改卡,就是因为京东自营能够买到,它给你保三年。但是你要知道,它毕竟是魔改卡,它的体质跟专业卡出身的 R9700 是不能比的。R9700 现在能够买到新卡,11000 块钱,不到 12000,甚至有便宜的一些第三方,比如瀚铠之类的,能买到 10000 块钱以下的卡,那它的性价比是非常爆棚的。它是有专业的 ECC 显存,而且这个卡是专门为了这种工作站设计的,它的生态也比 7900 XTX 更好。
而且它的做工品质,你能买到撼讯、蓝宝石、讯景这些一线大厂的品牌,那它们的做工,包括它们的质保,是非常不错的。我们以蓝宝石为例,当然你在京东如果买自营的蓝宝石,可能价格就比较贵了。但是如果你从第三方,比如拼夕夕买,你没有京东的质保,体验会差一点,但是蓝宝石支持个人送保。而且讲实话,这种新卡一般是不怎么会坏的。4090 48G 魔改卡我们为什么一定要买京东自营的?就是因为魔改卡本身的做工不行,它都是二线厂,甚至是一些小作坊在做。京东即便是自营的,它采购的也最多是二线厂的这种代工产品,它跟一线大厂的品控是完全不能比的。
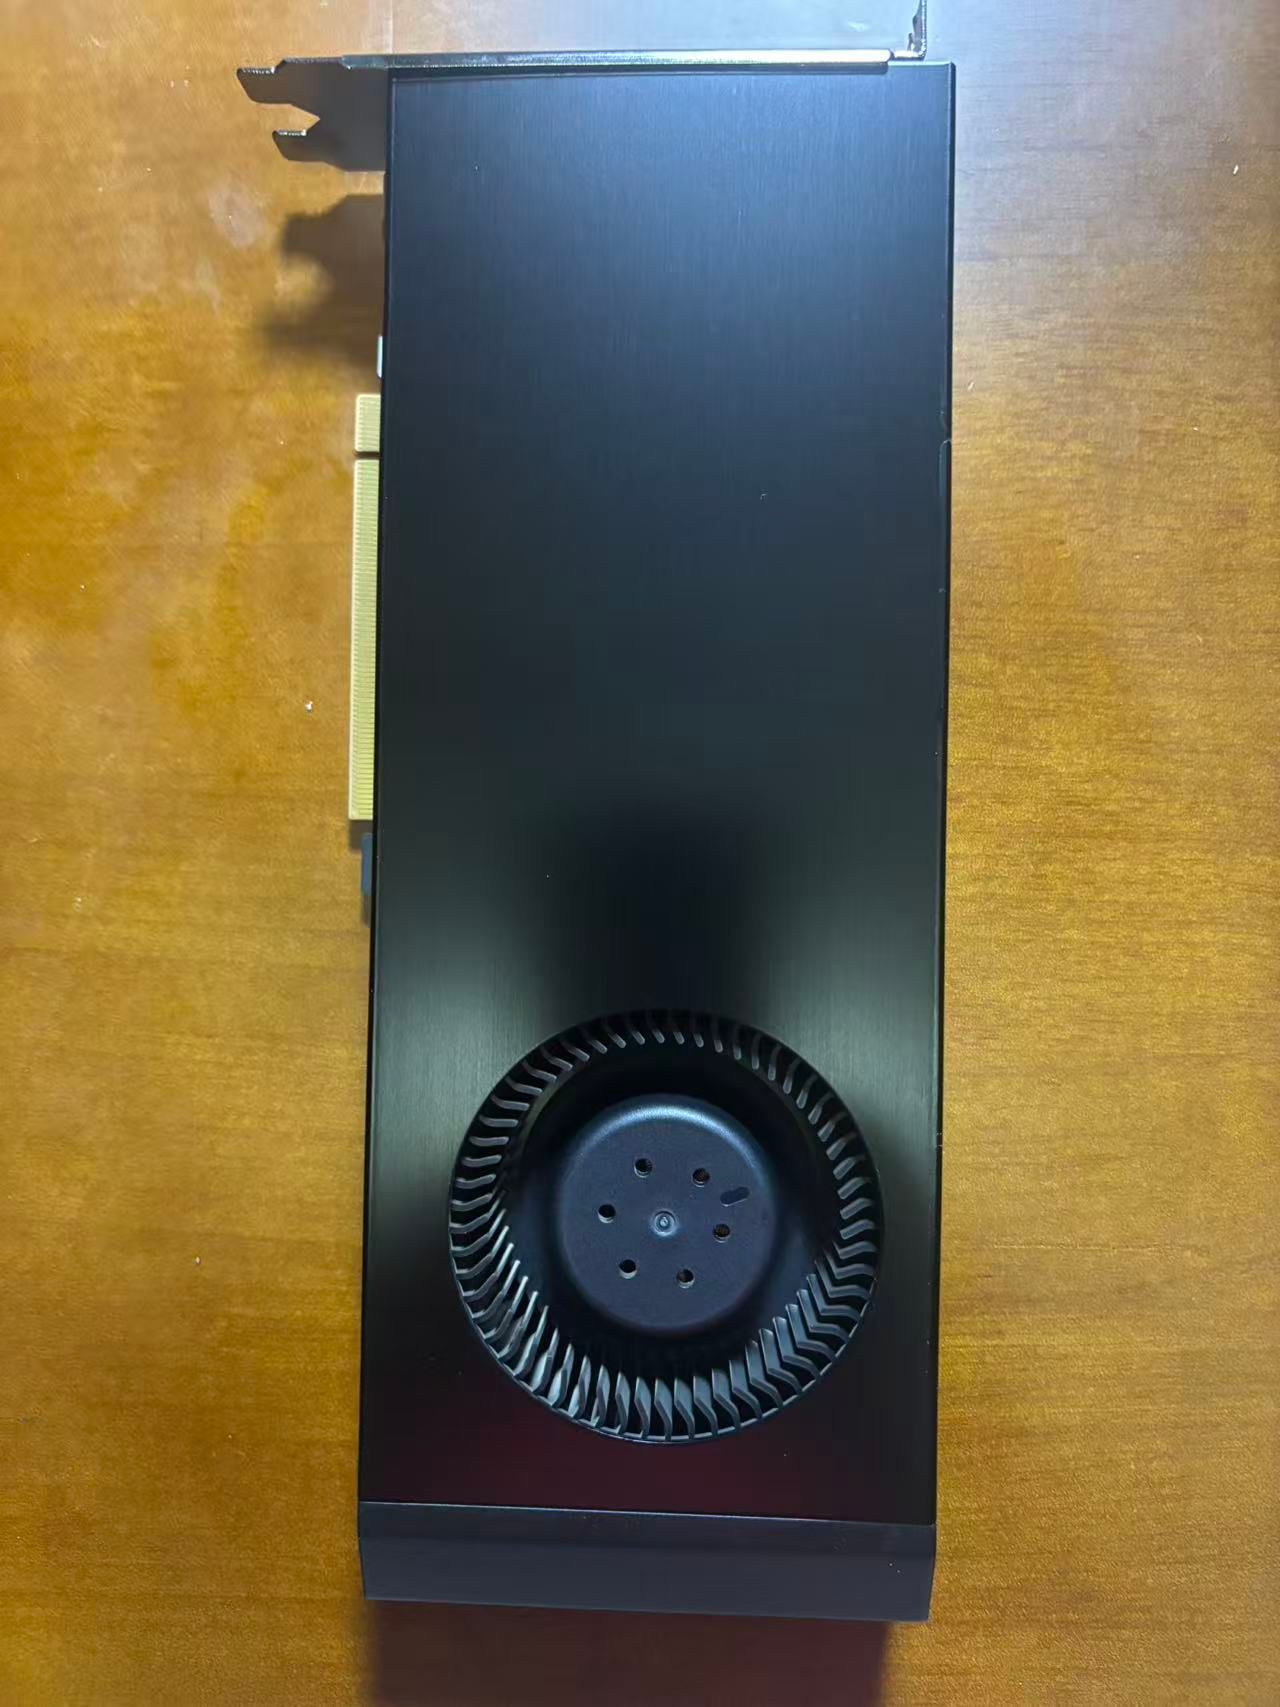
如果你买蓝宝石的、买讯景的、买撼讯的这样的 R9700,你是基本上不用担心它坏掉的。并且魔改卡的生态只有在中国大陆才有,如果你在海外的话,基本上就没有这个生态,那你怎么买嘛?所以在这种情况下,我现在是比较倾向于大家直接去买 R9700。它生态是比英伟达要差一点,是需要你折腾一下,但是毕竟不需要你人去折腾了,让 AI 去折腾。这个就是多花几块钱的配置费用,多浪费一点时间。你该工作工作,该刷剧刷剧,该玩游戏玩游戏,过一会你的 Agent 总归是能帮你配好的。
而且我还不得不说,算力危机我们现在看来,当初我们估计是大概一两年左右能够结束,现在看来可能情况没有这么乐观。市场上所需要的这些芯片也好、存储芯片也好,包括逻辑芯片,它这个产能还是远远跟不上的。那你在这种情况下,如果买的是 4090 48G 的魔改卡,可能坚持三年嘛,三年之内京东给你保,你只能期望它不要频繁地坏掉。因为讲实话,我的卡到手之后很快就坏掉了,坏掉之后我又给它返厂换了个新的。而且论坛可能 10 个买了魔改卡的有 8 个都是换了卡的,有 8 个人都是要返修的。但是我相信你买一张新卡,如果是 R9700 这种新卡,那你的心里会踏实很多,这几年时间它是不会坏掉的,能够帮你度过算力危机的。并且我们知道 4090 是不支持 FP4 的,那么 R9700 的生态比 4090 的生态周期还会再更长一点。
最后还必须要说一下,现在双卡 TP 的门槛是比较低的。你去买 AMD 的 X570 芯片,就是老的 AM4 平台的芯片,这种主板就能够支持大部分。你去问一下 AI,能够找到很多型号支持双卡 TP,这个成本其实构建起来并不特别贵。就是你两张 R9700 双卡 TP,然后比 4090 48G 单卡,成本应该是要更低的。而且毕竟你能够把钱省下来,从 DDR3 升级到 DDR4,你的体验还是会有进一步提升的,有这个综合性的提升。
-
nvidia 好像没有一块真正的专业入门32gb vram 显卡。。。
之前还可以有得选那块rtx 5000 ada 32gb 一万马币,现在都涨价到 1.6万马币
我这块rtxpro 4500 32gb 已经涨价到2.6万马币。。。
逼得r9700pro 涨价到1万马币。。。


