
双7900XTX跑SGLang:HiCache 开不开?128K 长上下文冷/热路径实测
-
首先感谢各位论坛的大神,跟着这大神的帖子进行了配置,以下是本机的测试效果。
先说结论:HiCache 不会让模型第一次阅读长文时变快,但可以记住已经读过的内容。再次使用同一份长文时,模型就不必从头重读。
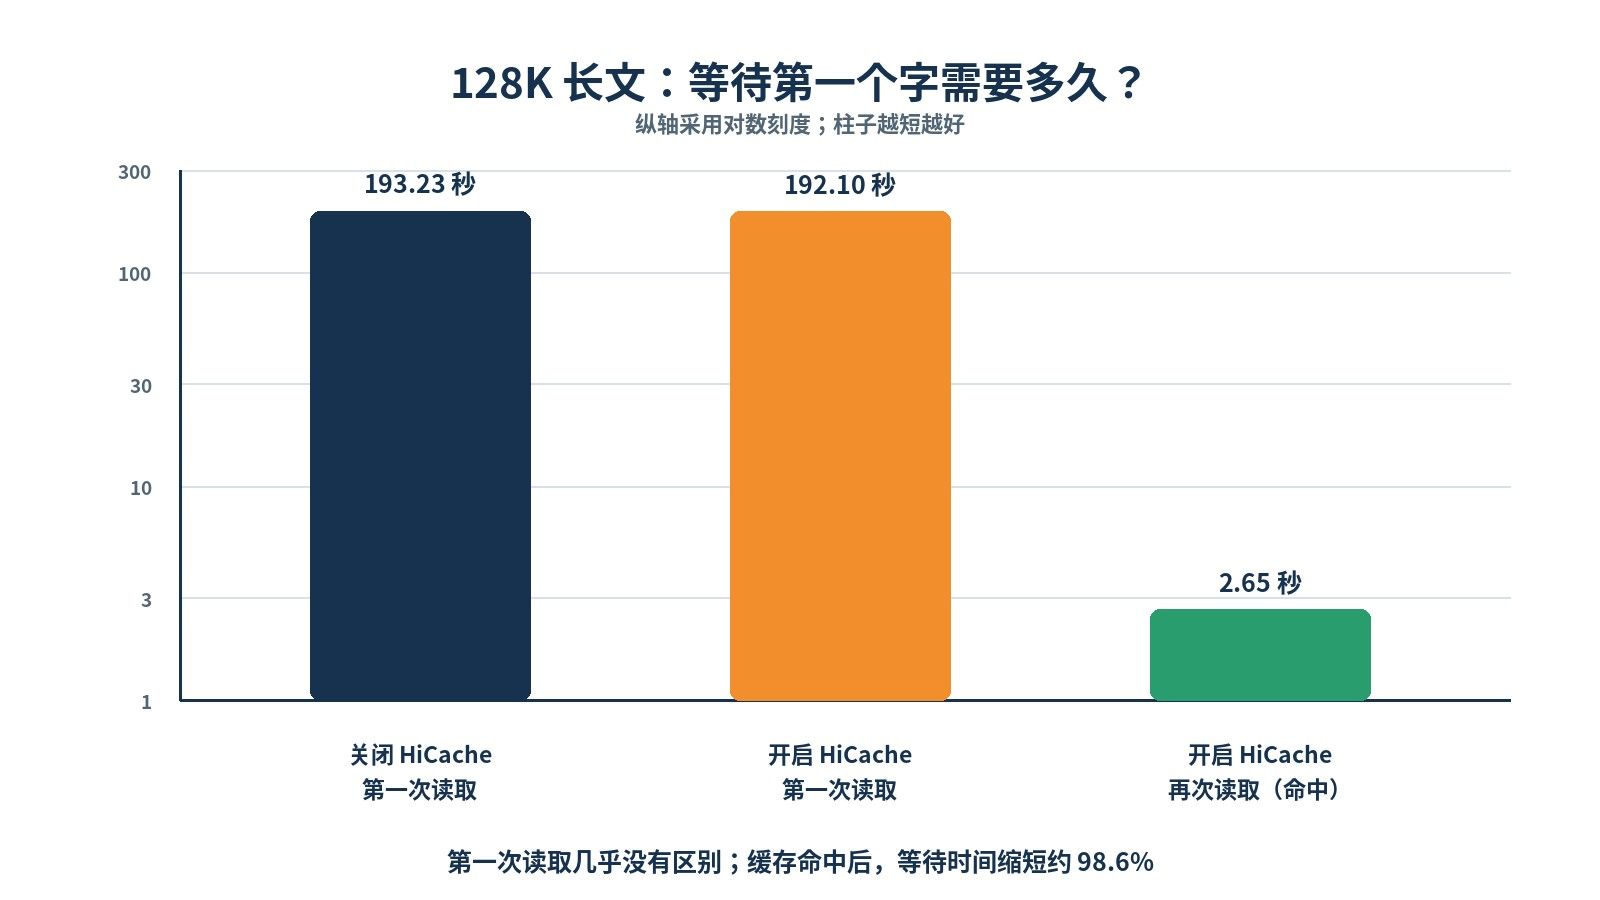
在这台双 7900 XTX 机器上,第一次处理 128K 长文,无论是否开启 HiCache,都要约 192 秒才开始回答;再次使用同一份长文时,只要约 2.65 秒就能开始回答。多轮对话、反复分析同一个代码仓库、重复使用同一批知识库文档时,收益非常明显。
1. 解释 HiCache
可以把 128K 长上下文想象成一本很厚的书。
- 第一次提问:模型需要从头读完整本书,再开始回答。无论是否开启 HiCache,这一步都省不了,所以都要等待约 3 分钟。
- 开启 HiCache 后:模型读书时会把已经计算好的“读书笔记”暂存在电脑内存里。
- 再次针对同一本书提问:模型可以直接加载这些笔记,不必重新读完整本书,因此约 2.65 秒就能开始回答。
- 如果每次提交的内容都完全不同:旧笔记用不上,开启 HiCache 不但没有明显帮助,还会多占内存并产生少量缓存开销。
本次测试最直观的结果如下:
实际场景 开始回答前要等多久 整个请求耗时 通俗解释 关闭 HiCache,第一次提交 128K 长文 193.23 秒 201.74 秒 模型需要完整读一遍。 开启 HiCache,第一次提交 128K 长文 192.10 秒 206.60 秒 仍需完整读一遍,同时保存缓存。 开启 HiCache,再次使用同一份长文 2.65 秒 3.25 秒 直接复用上一次的计算结果。 等待第一个字的时间对比(柱子越短越好):
换句话说:
HiCache 不会让模型第一次阅读长文时变快;它真正加速的是“同一份长内容被再次使用”的场景。
所以,如果你只是偶尔让模型总结一篇长文,没必要专门开启 HiCache;如果你在做多轮 Agent、连续追问同一个代码仓库,或者很多问题共享同一批 RAG 文档,HiCache 就很有价值。
文中几个性能名词是什么意思?
名词 通俗解释 数值怎么看 128K 输入给模型的内容长度,大约 12.8 万个 token 越长,模型第一次阅读通常越慢。 TTFT 从发送问题到看到第一个字的等待时间 越低越好,最影响“响应快不快”的体感。 E2E 从发送问题到整个回答完成的总时间 越低越好。 Prefill 模型阅读并理解输入内容的阶段 长文的大部分等待时间都花在这里。 输入吞吐 模型每秒能处理多少输入 token 越高越好,但缓存命中后的数字属于等效速度。 冷请求 这份内容之前没有缓存,必须重新计算 相当于第一次读书。 热命中 这份内容已经缓存,可以复用计算结果 相当于直接翻阅读书笔记。 2. 测试平台
项目 配置 GPU 2 × AMD Radeon RX 7900 XTX,24 GB/卡,gfx1100 并行 Tensor Parallel = 2 推理框架 SGLang 0.5.6.post3.dev10769+gf84475ccf模型 Qwen3.8-27B-W4A16-AutoRound-GPTQ权重 / KV GPTQ / BF16 KV cache Attention Triton 投机解码 DFLASH,draft= Qwen3.8-27B-DFlash2-W4A16,8 draft tokens,window=2048压测工具 SGLang benchmark.serving,backend=sglang请求 固定随机输入 128,000 token;单并发; temperature=0;同一随机种子HiCache 参数
参数 关闭 开启 enable_hierarchical_cachefalsetruehicache_size0 12 hicache_ratio2.0 2.0 hicache_io_backendkernelkernelhicache_host_memory_modecachecachehicache_write_policywrite_throughwrite_through3. 128K 实测结果
3.1 冷请求:开 HiCache 不会减少 prefill 计算
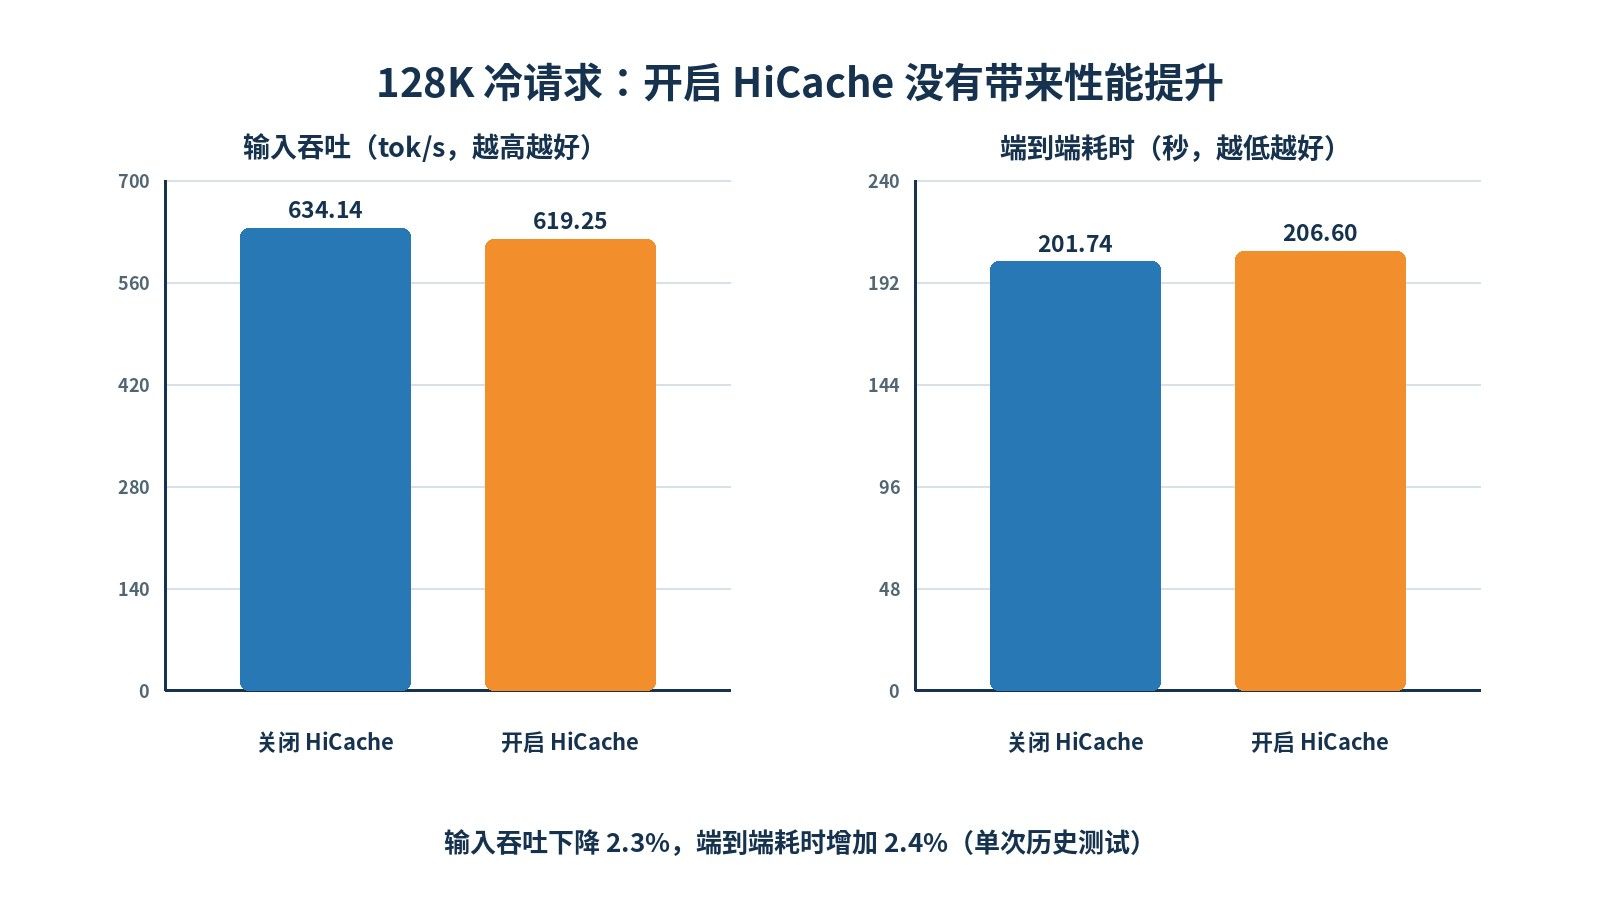
两组均为 128K 输入、512 输出、单并发、无 warmup,且冷测均清缓存。
场景 输入吞吐 TTFT E2E TPOT DFLASH 接受长度 不开 HiCache 634.14 tok/s 193.23 s 201.74 s 16.66 ms 5.79 开 HiCache(冷) 619.25 tok/s 192.10 s 206.60 s 28.37 ms 3.58 开 HiCache 相对变化 -2.3% -0.6% +2.4% +70.3% -38.2% 冷路径的 TTFT 差异不足 1%,可以当作持平;输入吞吐和 E2E 则说明 HiCache 没有为“从未处理过的 128K Prompt”加速,反而带来约 2% 的总时延开销。TPOT 变慢较明显,不过 DFLASH 接受长度也不同,单次数据不能把这部分完全归因于 HiCache。
3.2 热命中:同一个 128K 前缀的复用价值
先用 128K / 512 token 的请求填充 HiCache,然后在不清缓存的情况下再次请求同一随机前缀;热测只生成 16 token,因此只比较 prefill / 首 token / E2E,不拿它的 TPOT 与上表横比。
场景 输入 / 输出 输入吞吐 TTFT E2E 开 HiCache(冷) 128K / 512 619.25 tok/s 192.10 s 206.60 s 开 HiCache(热命中) 128K / 16 38,204.61 tok/s 2.65 s 3.25 s 热命中收益 61.7× TTFT -98.6% E2E -98.4% 这里的“38K tok/s”是压测端以完整 128K 输入长度计算的等效吞吐,不代表模型真的重新做了 38K tok/s 的 prefill;正是因为绝大部分 KV 从 host cache 回载,服务端跳过了原本最重的长前缀计算。
4. 该不该开?
使用模式 建议 原因 单次摘要、一次性超长文档 默认关闭 冷 prefill 不加速,且有小幅性能/显存容量代价。 多轮 Agent 会话 开启 system prompt、历史对话和工具定义经常完全复用。 RAG:多个问题共享长文档 开启 第一个请求填充,后续请求能直接吃到热缓存。 大量彼此无关的短请求 先关闭并实测 命中率低,缓存换不来回报。 还有一个容易忽略的取舍:本次测试中,开启 HiCache 的服务器可用 GPU KV 容量为 159,692 token,关闭时为 233,207 token,减少约 31.5%。它用 GPU KV 空间换取 CPU 内存层级缓存,适合“容量与复用”,而非纯 GPU 性能冲榜。
5. 一键复现:只切换 HiCache 的严谨 A/B
下面脚本刻意让两组启动参数相同,只在
EXTRA_HICACHE_ARGS处切换,避免把上下文长度、并发、显存比例等变量混进结论。5.1 环境变量
export SGLANG_PYTHON=/home/USER/sglang-qwen/.venv/bin/python
export MODEL_PATH=/path/to/Qwen3.8-27B-W4A16-AutoRound-GPTQ
export DRAFT_MODEL_PATH=/path/to/Qwen3.8-27B-DFlash2-W4A16
export PORT=30010
export MODEL_NAME=qwen3-8-27b-w4a16
5.2 启动基线(关闭 HiCache)
EXTRA_HICACHE_ARGS=""

"$SGLANG_PYTHON" -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --served-model-name "$MODEL_NAME" \
  --host 127.0.0.1 --port "$PORT" \
  --tp-size 2 --quantization gptq --dtype bfloat16 \
  --kv-cache-dtype bfloat16 --attention-backend triton \
  --context-length 131072 --mem-fraction-static 0.80 \
  --max-running-requests 1 --chunked-prefill-size 2048 \
  --enable-cache-report \
  --speculative-algorithm DFLASH \
  --speculative-draft-model-path "$DRAFT_MODEL_PATH" \
  --speculative-draft-model-quantization compressed-tensors \
  --speculative-num-draft-tokens 8 \
  --speculative-draft-window-size 2048 \
  $EXTRA_HICACHE_ARGS
5.3 启动 HiCache 组
关闭基线服务后,保留上面的完整命令,只把第一行替换为:
EXTRA_HICACHE_ARGS="--enable-hierarchical-cache \ --hicache-size 12 --hicache-ratio 2.0 \ --hicache-io-backend kernel \ --hicache-host-memory-mode cache \ --hicache-write-policy write_through"hicache-size的单位和适合的取值会受 SGLang 版本、模型 KV 大小与主机内存影响。这里的12是本机已跑通的参数,不是所有机器的通用最优值。5.4 冷 / 热压测命令
# 冷请求:每次压测前清服务端缓存,记录 prefill 性能
"$SGLANG_PYTHON" -m sglang.benchmark.serving \
  --backend sglang --host 127.0.0.1 --port "$PORT" \
  --dataset-name random --random-input-len 128000 --random-output-len 512 \
  --num-prompts 1 --max-concurrency 1 --request-rate inf \
  --seed 42 --temperature 0 --flush-cache --disable-tqdm \
  --output-file cold.jsonl

# 热请求:紧接冷请求执行,不清缓存;必须保持相同 seed / 输入长度
"$SGLANG_PYTHON" -m sglang.benchmark.serving \
  --backend sglang --host 127.0.0.1 --port "$PORT" \
  --dataset-name random --random-input-len 128000 --random-output-len 16 \
  --num-prompts 1 --max-concurrency 1 --request-rate inf \
  --seed 42 --temperature 0 --disable-tqdm \
  --output-file hot.jsonl
建议每个场景至少跑 3 次,取中位数;并保存每个
jsonl和 server 日志。检查热命中时,除了 TTFT,还应确认 cache report 中的host_cached_tokens/ 命中率确实上升。6. 本机开启 HiCache 的最终配置
下面是本机实际测试并成功运行的配置,不是根据文档猜测的参数。硬件为双 7900 XTX,模型使用 TP=2 分布在两张显卡上。
项目 本机实际配置 作用 GPU 2 × RX 7900 XTX 24 GB 两张显卡共同加载模型 SGLang 0.5.6.post3.dev10769+gf84475ccf本次测试版本 模型 Qwen3.8-27B W4A16 GPTQ 主模型 Draft 模型 Qwen3.8-27B DFlash2 W4A16 投机解码模型 tp-size2 模型切分到两张显卡 context-length196,608 服务允许的最大上下文长度 mem-fraction-static0.80 每张显卡约 80% 显存用于模型和 KV cache max-running-requests3 最多同时处理 3 个请求 chunked-prefill-size2,048 长输入分块处理,降低瞬时显存压力 GPU KV 容量 159,692 token 服务启动后实际报告的 KV 容量 单请求最大输入 159,686 token 服务启动后实际报告的输入上限 hicache-size12 分配给 HiCache 的主机内存缓存容量参数 hicache-ratio2.0 HiCache 的缓存比例 hicache-io-backendkernel使用 kernel 后端在 GPU 与主机内存间搬运 KV hicache-host-memory-modecache主机内存作为缓存层使用 hicache-write-policywrite_through新生成的 KV 同步写入主机缓存 DFLASH draft tokens 8 每轮最多草拟 8 个 token DFLASH window 2,048 Draft 模型使用的窗口长度 本机最终使用的完整启动命令如下。其他用户只需要修改主模型和 Draft 模型路径即可照着测试:
/home/didilc/sglang-qwen/.venv/bin/python -m sglang.launch_server \
  --model-path /home/didilc/models/vllm/Qwen3.8-27B-W4A16-AutoRound-GPTQ \
  --served-model-name qwen3.8-27b-w4a16-dflash2-hicache \
  --host 127.0.0.1 \
  --port 30004 \
  --tp-size 2 \
  --quantization gptq \
  --dtype bfloat16 \
  --mamba-ssm-dtype bfloat16 \
  --kv-cache-dtype bfloat16 \
  --attention-backend triton \
  --context-length 196608 \
  --mem-fraction-static 0.80 \
  --max-running-requests 3 \
  --max-mamba-cache-size 20 \
  --chunked-prefill-size 2048 \
  --enable-mixed-chunk \
  --cuda-graph-bs-decode 1 2 4 \
  --triton-attention-num-kv-splits 16 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --enable-cache-report \
  --enable-hierarchical-cache \
  --hicache-size 12 \
  --hicache-ratio 2.0 \
  --hicache-io-backend kernel \
  --hicache-host-memory-mode cache \
  --hicache-write-policy write_through \
  --speculative-algorithm DFLASH \
  --speculative-draft-model-path /home/didilc/models/Qwen3.8-27B-DFlash2-W4A16 \
  --speculative-draft-model-quantization compressed-tensors \
  --speculative-num-draft-tokens 8 \
  --speculative-draft-window-size 2048 \
  --stream-interval 1
其中真正负责开启 HiCache 的是下面六项,缺少第一项就不会启用:
--enable-hierarchical-cache \
--hicache-size 12 \
--hicache-ratio 2.0 \
--hicache-io-backend kernel \
--hicache-host-memory-mode cache \
--hicache-write-policy write_through
这套参数的实际效果是:第一次处理 128K 长文仍需正常计算,但计算结果会保存到主机内存;再次使用相同前缀时,TTFT 可由约 192 秒降到约 2.65 秒。代价是占用更多系统内存,并且 GPU KV 容量会比未开启 HiCache 时更低。
-
数据和结论都对:HiCache 省的是 prefill,不是首读。补三点,方便别人对齐口径:
- 命中条件比看起来严:分层 KV 缓存按前缀逐 token 对齐命中,temperature=0 / 固定种子只保证输出确定,不等于命中。你热启动 2.65s,是因为两次请求的 128k 输入前缀完全一致。真实 Agent/RAG 场景里更常见的是「system prompt + 工具定义一致、只有最后问题不同」——建议补测这一组,那才是它最值钱的形态。
- 显存是 L1、host 内存是 L2:
hicache_size=12(GB)在 128G 内存上够用,但要盯两个数:cache 命中率、host GPU 搬运耗时。命中率低时,搬运 + 占内存确实可能反噬,所以你「每次内容都不同就别开」的判断成立。
- 并发下要单独测:单并发 192s→2.65s 是最理想情况;多并发时 host 内存带宽和 PCIe 会争用,建议再贴一组 2/4 并发的冷/热 TTFT。
一个容易踩的坑:改 max context(比如 128k 切 96k)会让已缓存页对不齐、整段失效,测试时把上下文长度固定住再比。
-
,
 T terry 固定了此主题
-
,系统 取消固定了此主题

