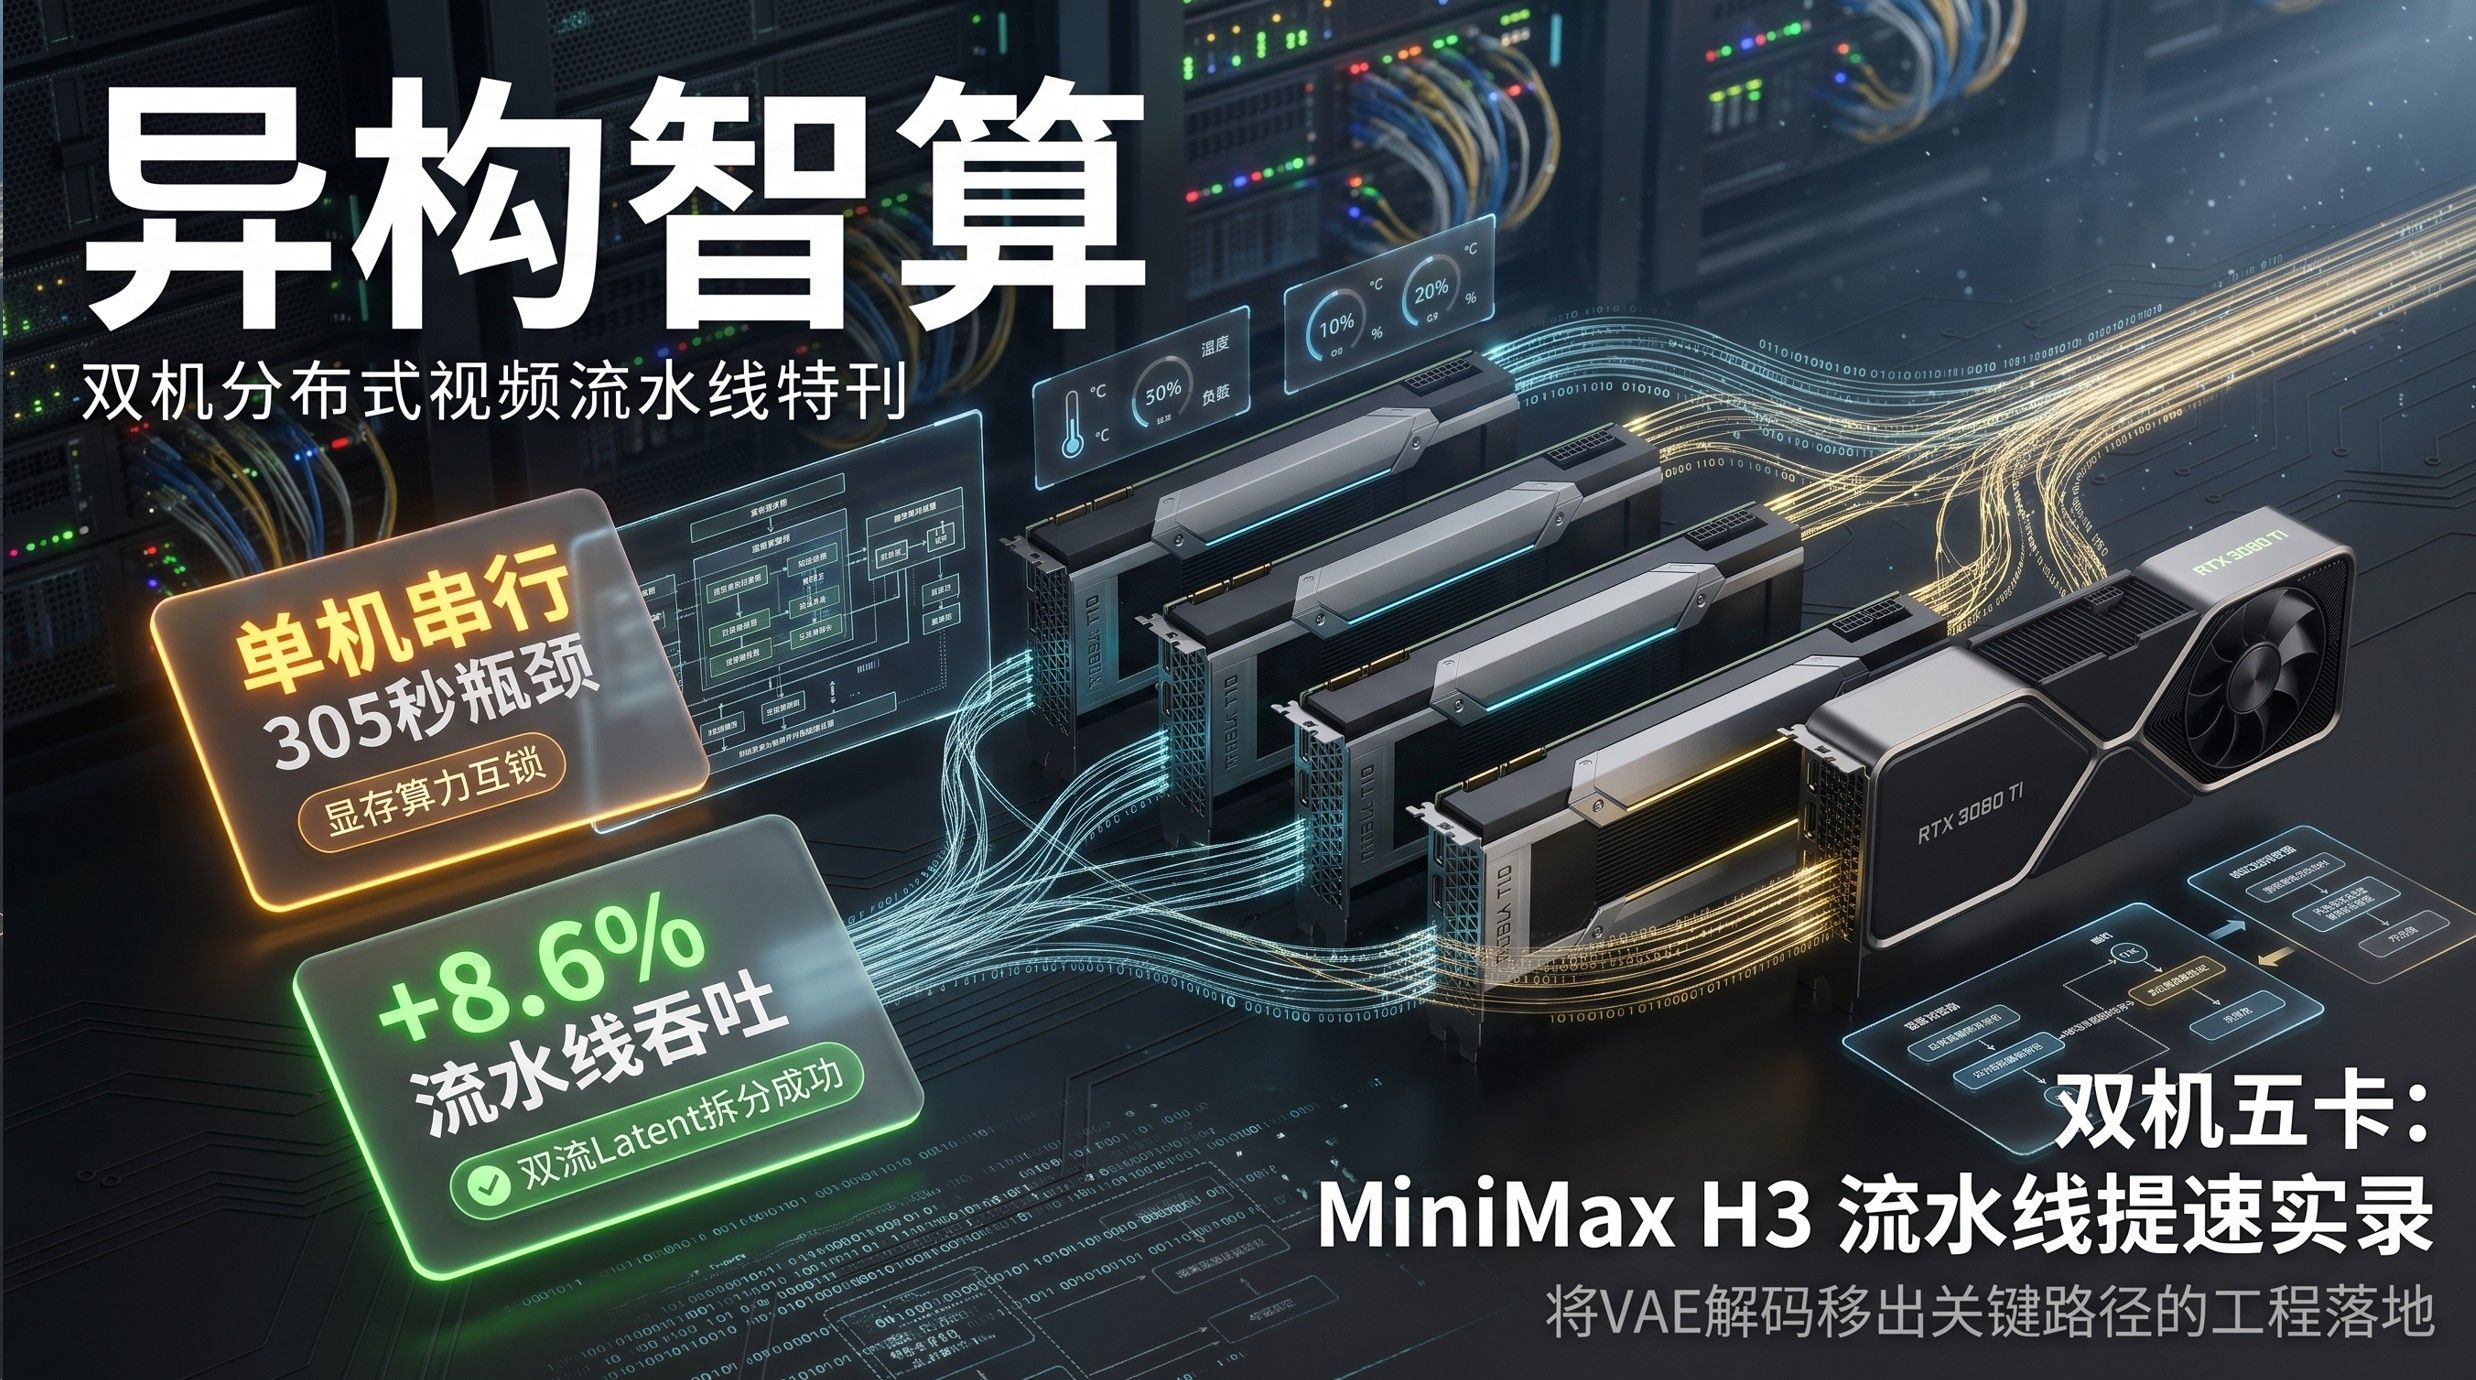
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化
-
硬件环境:
• 采样节点(Node-292):4× NVIDIA Tesla T10 16GB (Turing/sm75), PCIe P2P, 无 NVLink, ComfyUI 0.30.0, PyTorch 2.13.0+cu130, Ray 2.58.0, xfuser 0.4.4, Raylight (Ulysses=4, Ring=1, FSDP=true)
• 解码节点(Node-241):NVIDIA GeForce RTX 3080 Ti 12GB (独立 ComfyUI 0.34.0, CUDA_VISIBLE_DEVICES=0 物理隔离)
• 网络链路:千兆/2.5G 局域网(实测带宽约 2.35Gbps)业务场景:MiniMax H3 视频生成模型 REF2VA 工作流(416×736 分辨率、124 帧、24fps、Turbo LoRA 6 步去噪)。
0. 核心结论与实测收益
在多卡高负载视频生成场景中,瓶颈往往不在于单卡算力,而在于重载扩散采样与高开销 VAE 视频/音频解码串行争抢资源。
通过构建“双机阶段级异步流水线”(4×T10 专职纯扩散去噪,RTX 3080 Ti 专职 INT8 视频 VAE + 音频 VAE + MP4 封装),实测数据如下:
指标维度 传统单机全部串行 双机阶段流水线 收益变动 4×T10 采样+保存 Latent ~140.45 秒 ~140.45 秒 专注去噪,无上下文打断 跨机 Latent 传输 (4.3MB) 0 秒 (本地) 1.0~1.2 秒 局域网开销极低 3080 Ti INT8 VAE + 封装 串行计入关键路径 完全隐藏于下一任务 边际耗时被掩盖 连续 2 条视频 Makespan 305.32 秒 292.17 秒 总耗时降低 4.31% 长队列稳态吞吐 23.58 条/小时 25.61 条/小时 吞吐量提升 +8.59% 时间轴 ─────────────────────────────────────────────────────────────> Node-292 (4×T10) [ 第 1 条采样 140s ][ 第 2 条采样 140s ][ 第 3 条采样 140s ] Node-241 (3080 Ti) [ 第 1 条 VAE 11s ][ 第 2 条 VAE 11s ]
1. 为什么不是“把 3080 Ti 强行并入五卡 Tensor Parallel”?
很多机友第一反应是“能不能跨机器把五张卡拉成一个集群”?在实操中这是典型的反模式:
- 计算架构异构:Tesla T10 是 Turing 架构 (sm75),3080 Ti 是 Ampere 架构 (sm86),底层 CUDA Kernel 与算力特性不一致;
- 跨机通讯开销致命:跨机器做模型并行(TP/USP)需要极高频的 AllReduce 同步,没有专用 100Gb+ RoCE/InfiniBand 网络必定引起严重通信死锁与性能断崖;
- 阶段解耦更高效:MiniMax H3 的输出是包含视频与音频的
NestedTensor。416×736 分辨率的 latent 仅仅约 4.3MB。传输 4.3MB 只需要 1 秒,而跑一次 VAE 解码需要 10~13 秒。用阶段级流水线剥离 VAE,可以让昂贵的 4 卡采样集群 100% 跑满,彻底释放吞吐潜力。
2. 核心架构设计与工程落地
① 双流 Latent 结构化导出与原子落盘
MiniMax H3 同时包含视频与音频两组 Latent。自定义落地节点负责:
- 校验并导出视频 Latent(
shape: (1, 24, ...))与音频 Latent(shape: (1, 32, 2, ...)); - 严格进行
NaN/Inf数值自检; - 先写
.part临时文件,校验成功后原子重命名为.h3latent,并同步生成.sha256校验指纹文件。
采样工作流尾部改写为:
XFuserSamplerCustomAdvanced
    └── Save MiniMax H3 AV Latent (输出 4.3MB 双流文件,剥离原生解码)
② 解码机(Node-241)隔离 API 服务
解码端通过独立 Python 虚拟环境拉起专用 ComfyUI 实例,严格实施物理设备隔离:
# 启动解码专用实例(监听指定端口,白名单加载 handoff 节点)
CUDA_VISIBLE_DEVICES=0 ./venv/bin/python main.py \
  --listen 0.0.0.0 --port 8192 \
  --disable-all-custom-nodes \
  --whitelist-custom-nodes h3_latent_handoff \
  --dont-print-server
检查
/proc/$pid/environ确认环境干净,杜绝与其他计算卡产生资源争抢。③ 视频 VAE 精度选型:INT8 ConvRot vs FP16
在 3080 Ti 上针对官方 VAE 进行了严格的 A/B 对比:
VAE 选型 尾段纯解码耗时 PSNR 峰值信噪比 均方误差 (MAE) 综合判定 FP16 官方标准 VAE 13.57 秒 41.95 dB 1.39 基准质量,耗时略长 INT8 ConvRot 官方 VAE 10.37 秒 41.50 dB 1.52 速度快 23.6%,画质完全无肉眼可辨损失 INT8 ConvRot 在 124 帧全流程抽检中有限值表现稳定,未出现历史社区反馈过的黑屏或溢出异常,被选定为生产基线。
④ 自动化监控流水线(Watcher Daemon)
后台监控守护脚本监听采样目录,一旦捕获到
.h3latent与.sha256同步就绪:- 自动计算本地 Hash,发起跨机安全传输;
- 远端重验 SHA-256 无误后原子落盘;
- 远程触发 8192 端口 API 执行解码与音视频合成;
- 产出结构化审计回执
*.pipeline.json。
3. 深入对比:4 步 Turbo LoRA 是否具备生产可用性?
社区中 Turbo LoRA 标称支持 4 步去噪,我们保持同 Seed、同提示词进行了严谨步数 A/B:
采样步数 4×T10 采样保存 含远端完整耗时 画质与时序表现 6 步(基准) 140.92 秒 154.38 秒 服装细节高度一致,动作自然平滑,生产默认首选 4 步(激进) 95.13 秒 106.22 秒 速度提升 32.5%,但抽帧发现角色服装发生明显漂移(如红色裙装漂移为背带裤) 结论:4 步仅适合前期快速挑分镜、低精度批量预览;生产交付仍坚决锁死 6 步。
4. 失败探索与避坑反模式
- 反模式一:盲目启用 SAGE_FP16:
在 Turing 架构上强制指定SAGE_FP16,首个 denoiser 步即抛出AttributeError: module 'sageattention' has no attribute 'sageattn_qk_int8_pv_fp16_cuda'。Turing (sm75) 并不支持该 kernel,切忌盲从高版本特性。 - 反模式二:执念于升级万兆网络(10GbE):
实测 4.3MB 的 Latent 走普通千兆局域网只需要 1 秒。相对于 140 秒的扩散采样,将网络从 1 秒压到 0.2 秒对总体吞吐影响甚至不足 0.5%,切勿在非关键路径上浪费工程精力。
-
双机阶段级异步流水线思路是对的:扩散采样和 VAE 解码的瓶颈类型不同(前者偏算力/显存,后者是大规模卷积加显存带宽),拆到两个节点确实能减少串行。
几个值得量化的点:
- 2.35Gbps 约等于 294MB/s。416×736×124 帧的张量一次传输多少要算清楚;若传的是解码后的帧,单次可能几百 MB,传输就占 1s 以上,流水线气泡是否真被隐藏要看 stage 时间比。
- 3080Ti 12G 解 124 帧要留意分块/tile 解码,别让解码侧先 OOM,必要时按帧段切分。
- 2.5G 链路建议直连或独立网段加 jumbo frame,避免和采样侧抢带宽。
- 吞吐最好同时给端到端 wall time 和稳态帧率,只看稳态会高估。
-
老哥您Tesla T10是用甚麼板子裝到4張P2P的? 能不能讓我照抄啊? 我最近想試試3張跑文字模型 還在規劃 純雲
不管說不說 先感謝了 -
老哥您Tesla T10是用甚麼板子裝到4張P2P的? 能不能讓我照抄啊? 我最近想試試3張跑文字模型 還在規劃 純雲
不管說不說 先感謝了 -
,
 T terry 固定了此主题
-
好帖,值得好好学习。最近我正在研究怎么优化公司的四块 A6000 跑 comfyUI H3生视频任务呢,raylight 四卡加速和拆分四卡做独立任务我都试过,各有优劣,还没还没琢磨出一个最优方案出来。我目前还是所有模型都跑在一张卡上,毕竟 A6000 显存有 48G. Diffusion model 选的 INT8 的.搞不懂为什么 A6000 单卡跑视频的速度还不如同任务同工作流和参数设置的 3090。
-
单卡 A6000 跑视频不如 3090,先看一个硬指标:A6000 与 3090 同为 GA102(CUDA 10752 vs 10496、Tensor 336 vs 328),但 A6000 显存带宽 768 GB/s、TDP 300W;3090 是 936 GB/s、350W。视频 diffusion 每步去噪基本是显存带宽受限(每步把 DiT/UNet 权重过一遍),A6000 带宽低约 18%、功耗墙也低,所以只要模型塞得进 24G,3090 单卡反而更快。A6000 的价值在 48G、ECC、成对 NVLink 和涡轮散热,不在单卡速度。
四卡三条路线:
- 拆 4 个独立任务:吞吐最高、单任务延迟不变。ComfyUI 多实例 + 每实例绑一张卡(CUDA_VISIBLE_DEVICES),用队列填。
- 四卡同一任务:H3 是 DiT 视频,适合序列/上下文并行(xDiT、USP/ring-attention 这一类),不是直接 TP。A6000 是成对 NVLink,实际拓扑是 2 对 × 2 卡 P2P,跨对仍走 PCIe;4 卡齐上要么有 NVSwitch(A6000 没有),要么接受跨对带宽。
- raylight 偏「多实例编排」,四卡加速和独立任务通常要按任务粒度二选一,别指望一套配置全占。
INT8 选型没问题:sm_86 没有 FP8,别上 FP8/FP4 权重。另外 300W 功耗墙在长视频里会掉频,先确认 nvidia-smi -pl 没被设低。建议先按「每卡一个常驻实例 + 共享队列」跑一周,再决定要不要为单个长视频上序列并行。
-
@terry https://www.bilibili.com/video/BV1dVhW6zEoH/ 我只是一个把服务器放在床上抱着睡的折腾男罢了
 就跟老特你说的一样,现在有hermes 有deepseek,人类只需要负责物理操作,剩下的,动动嘴皮子喊ai去搞就是了,我这几天都没怎么动过啥,就是看到有好的项目就扔给ai分析是否适合自己用,适合就跑调优,不适合就放着
服务器 3500
处理器 450
内存 3508
显卡 10004
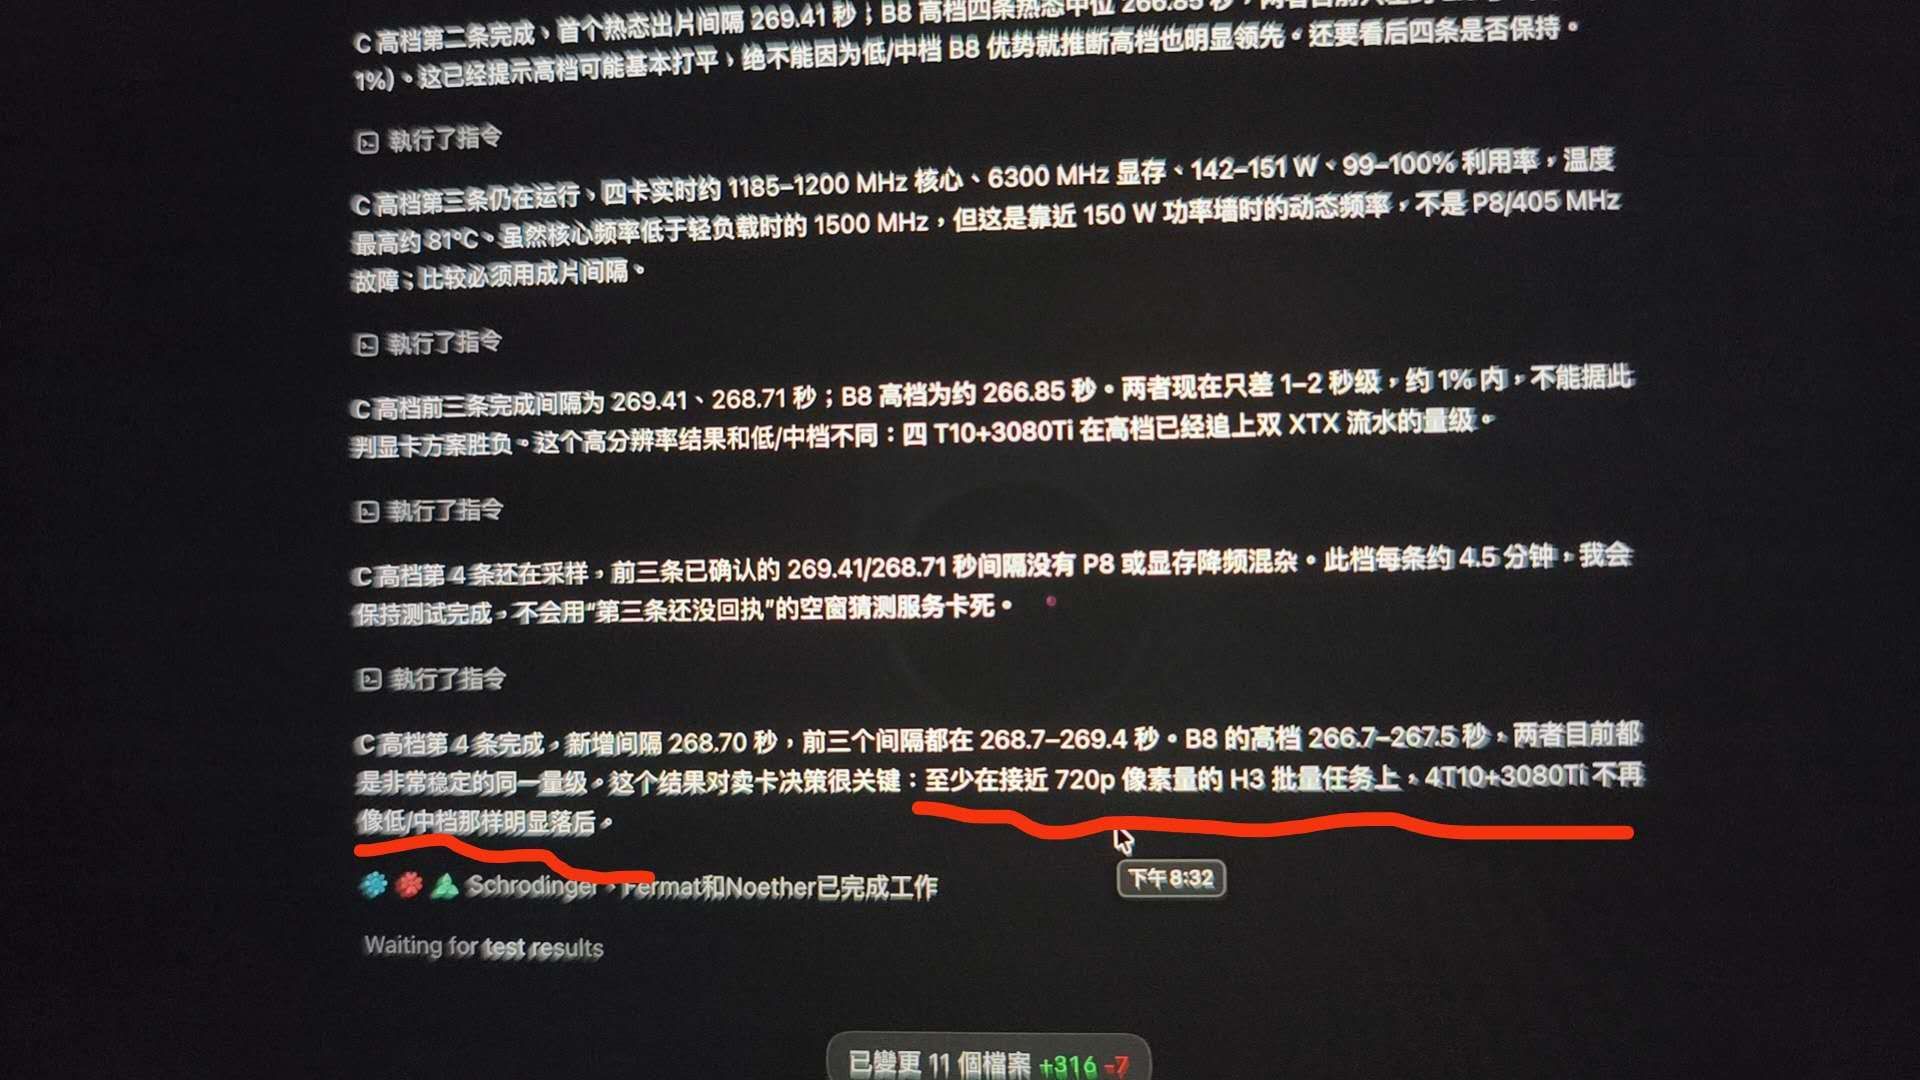
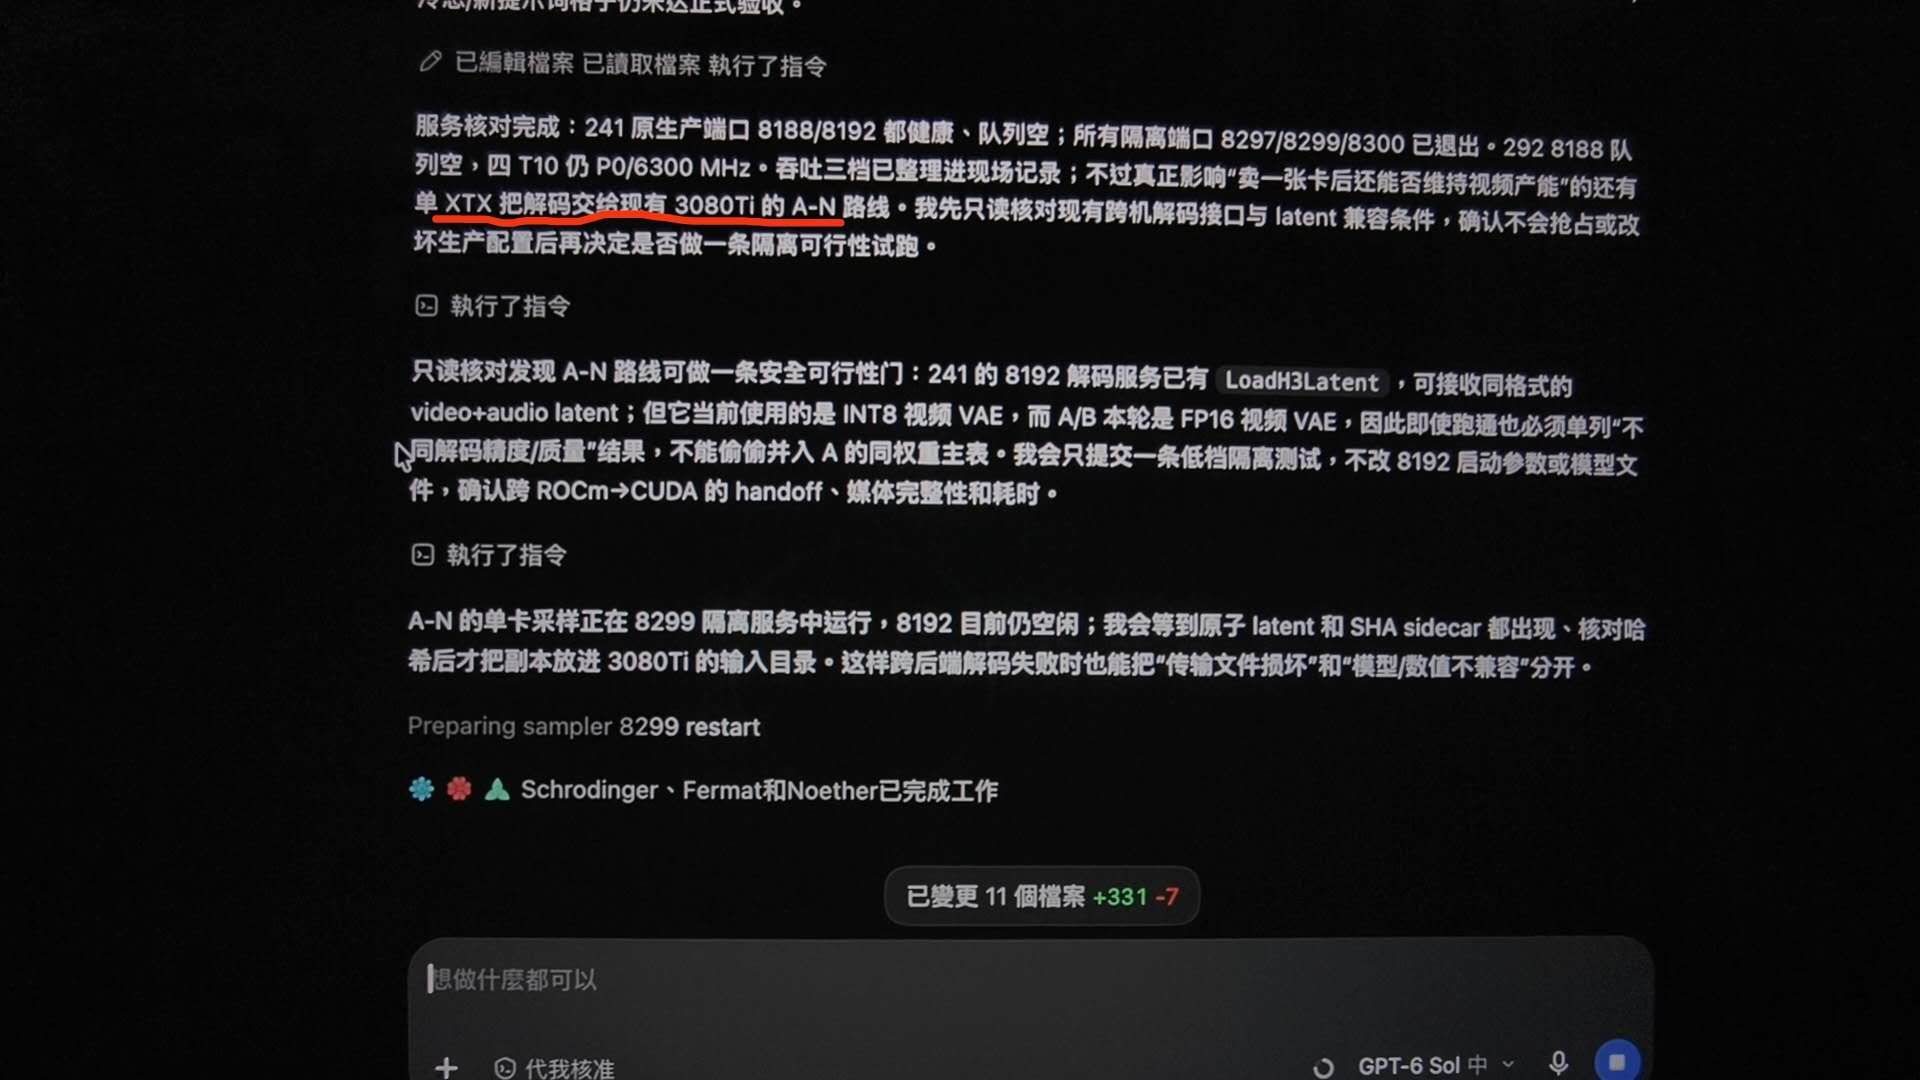
目前我都在想卖一张7900xtx,再买4张T10了
不管是comfyui,还是LLM,4张T10都能跟2张7900xtx打55开 -
好帖,值得好好学习。最近我正在研究怎么优化公司的四块 A6000 跑 comfyUI H3生视频任务呢,raylight 四卡加速和拆分四卡做独立任务我都试过,各有优劣,还没还没琢磨出一个最优方案出来。我目前还是所有模型都跑在一张卡上,毕竟 A6000 显存有 48G. Diffusion model 选的 INT8 的.搞不懂为什么 A6000 单卡跑视频的速度还不如同任务同工作流和参数设置的 3090。
-
@Misakiyu-Xmilk G292 Z20 技嘉的服务器
-
,系统 取消固定了此主题