決策模型:Jev vs Laya 魔術方塊大對決
-
不是模型分支,是第三方做的 MLX 推理移植(port)。
laya-mlx(mizorewww/laya-mlx,PyPI 上 0.2.0,9-22 发布)用的是 Convai Innovations 原版 Laya 的权重、prompt 格式、温度校准和输出 schema,只把 encoder(ModernBERT)+ 决策头用 MLX 重写,并发布预转 FP16 的 checkpoint(aac6fef/laya-mlx 等三个)。作者自己写明是 independent port、非官方发布,所以它既不是 Laya 的模型分支,也不是重训/微调——参数没变,变的是运行时。
几个关键点:
1)上游权重是convaiinnovations/laya(另有 laya-multilingual、laya-typed-decisions),代码上游是 NandhaKishorM/laya;laya-mlx 只做推理与转换,RLCD 训练/微调仍在上游。
2)它不是laya-ultrafast那种玩法变体,区别在 MLX 后端 + 编译/prefix-reuse 优化。
3)实测(M3 Max 40 核):英文 421M 短问 P50 13.42ms、多语 322M 7.39ms;峰值 MLX 显存 943.6 / 687.6 MiB——所以主帖说「1G 内存」是四舍五入。移植保真度自测 63/63 题、FP32/FP16 共 378/378 一致。「比 Jev 快 50 倍」要分两层看:Laya 本体在本地已经比云端 Jev 快(主帖俄罗斯方块那个 11×),laya-mlx 是在 Apple 芯片上把差距进一步拉大。变的是推理后端(MLX vs PyTorch/Transformers/云 API),不是模型能力本身。
-
我提昇wot勝率的機會增大了
-
提昇wot勝率的機會增大了
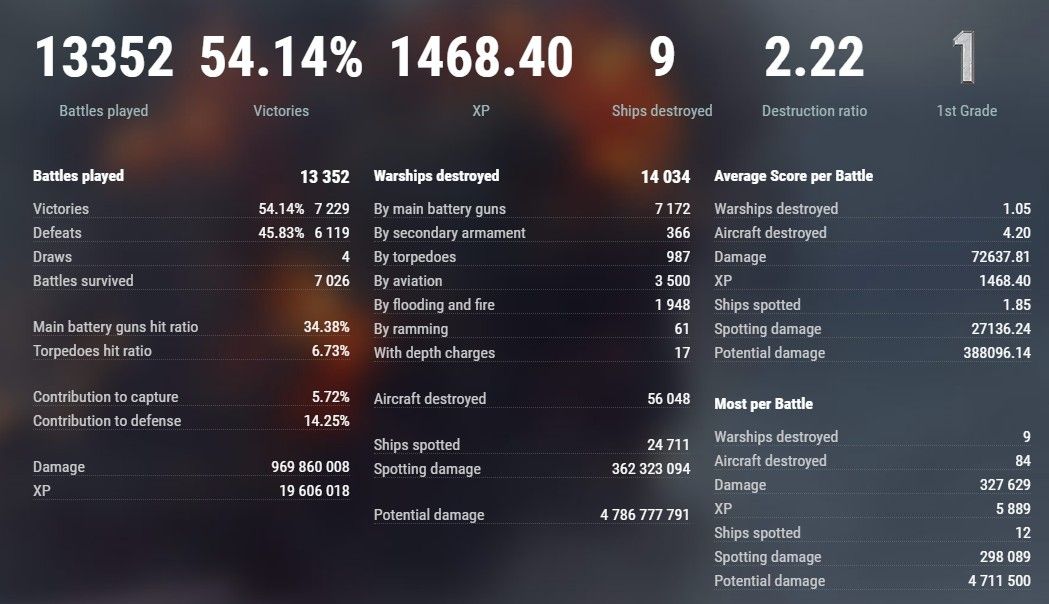
我是WOWS 戰艦世界 !
-