
7900 XTX 的可能性探索|单卡篇(二):KVMem 是个好东西—— 7900XTX 24GB 显存实测跑通 512K Context
-
先感谢 KVMem 的作者和贡献者
首先一定要特别感谢 KVMem 项目的作者和贡献者。
KVMem 是一个很有意思的长上下文 KV 管理方案,由 Di Chai、Leye Wang、Zeshen Su、Zhiguo Xia、Zhihang Yu 等作者开发。
项目地址:
https://github.com/kvmem/kvmem-llama.cpp
作者相关 Bilibili 介绍视频:
https://www.bilibili.com/video/BV1r2ey6EEh5/
也感谢作者把这套方案和实现公开出来,给消费级显卡探索超长上下文提供了一个很有价值的方向。
1. 为什么我又来折腾 KVMem
最近本地推理的新技术和新玩法层出不穷,我自己最感兴趣的几个方向里,就包括 NInfer、KVMem 和 JEV。
之前我已经在 NVIDIA 显卡上测试过 KVMem,对这个方案一直很感兴趣。前两天突然看到项目开始支持 AMD / ROCm,我一下又来劲了,于是连续肝了两天,把单卡 7900 XTX 下的适配、排错和长上下文测试基本完整跑了一遍。
下面就是这轮测试的阶段性结果。
2. KVMem 到底解决什么问题?
传统 Full-KV 的问题很直接:
Context 越长,KV Cache 占用的显存越大。
消费级显卡即使模型权重能放进去,Context 继续往上拉以后,最后很容易撞到显存墙。
KVMem 的思路不是要求整个超长历史的 KV 全部长期驻留在 GPU。
简单理解:
- GPU 只维持一个有限大小的 active KV working set
- 更大的历史状态放到 Host RAM
- 需要时再进行 retrieval / restore
- 因此逻辑 Context 可以远远超过传统 Full-KV 能容纳的范围
所以它解决的核心问题不是:
“怎么让模型本身变快”
而是:
“怎么用有限的 GPU 显存,维持远大于显存容量本身能承载的上下文。”
众所周知,7900XTX先生威猛但是显存略短,对于24GB的它来说,这个方向非常有吸引力。

3. 测试环境、部署方法和参数
硬件与环境
项目 配置 GPU AMD Radeon RX 7900 XTX 24GB GPU 数量 1 CPU AMD Ryzen 5 9600X 主板 GIGABYTE B850 AI TOP AMD AM5 ATX 系统内存 64GB DDR5 PCIe PCIe 4.0 x8(主机安装双卡,本篇仅使用 GPU0 单卡) OS Linux ROCm 7.2.3 Backend llama.cpp HIP Model Qwen3.8-27B Q4_K_M GPU offload Full GPU offload Flash Attention ON KV q8_0KVMem budget 32K MTP 模型自带 nextn head GPU arch gfx1100 KVMem 版本
这轮测试使用的是 KVMem 官方 AMD / ROCm Beta 分支:
rc3-rocm-beta2项目地址:
https://github.com/kvmem/kvmem-llama.cpp
我没有直接使用通用多架构 build,而是在本机针对
gfx1100重新编译。主要编译方向:
- HIP / ROCm
gfx1100only- Native build
- Ninja 并行编译
- 针对 RX 7900 XTX 使用本地优化参数
本轮测试使用的主要编译参数包括:
GGML_NATIVE=ONGGML_OPENMP=ON以及:
CMAKE_HIP_FLAGS="-mllvm --amdgpu-unroll-threshold-local=600"这样做的目的很简单:
尽量减少和本机 RX 7900 XTX 无关的通用架构开销,把测试环境固定在
gfx1100。推理参数
本轮长上下文测试统一使用:
参数 设置 GPU 单张 RX 7900 XTX Model Qwen3.8-27B Q4_K_M KV q8_0KVMem budget 32768Flash Attention ON Batch 2048UBatch 512Threads 6Output cap 512 tokensMTP OFF / ON 两组 Context 128K / 256K / 512K 这里的
32768不是最大 Context。它表示:
GPU 侧 KVMem active working set 的预算约为 32K。
真正测试的逻辑 Context 分别为:
- 128K
- 256K
- 512K
也就是说,512K 测试并不是让 512K KV 全部常驻显存,而是:
用约 32K 的 GPU active KV budget,配合 Host RAM 中更大的历史状态,通过 retrieval / restore 机制维持 512K 逻辑 Context。
为什么 KV 继续使用 q8_0
上一篇传统 Full-KV 测试里,我已经对
q8_0和q4_0KV 做过对比。在我的机器和这套模型上,两者对 Prefill 性能影响很小。
因此这篇为了减少变量,继续统一使用:
q8_0 KV不再同时展开 q4 KV 测试。
测试口径
所有 Context 档位都使用实际 tokenizer token 数,不使用字符数估算。
标称 Context Actual Prompt 128K 130,942 256K 261,875 512K 523,744 测试要求不是单纯:
“服务能启动”
“ctx-size 能设置成功”
“模型没有立刻 OOM”而是必须完成:
完整 Prompt Prefill → 正常进入 Decode → 正常输出
下面直接看完整测试结果。
4. 长上下文完整测试结果
Context Actual Prompt MTP Prefill Decode TTFT Acceptance 128K 130,942 OFF 557.63 tok/s 26.98 tok/s 235 s — 128K 130,942 ON 533.94 tok/s 36.59 tok/s 246 s 50.8% 256K 261,875 OFF 532.61 tok/s 26.94 tok/s 493 s — 256K 261,875 ON 511.73 tok/s 36.38 tok/s 513 s 50.0% 512K 523,744 OFF 520.34 tok/s 26.85 tok/s 1009 s — 512K 523,744 ON 500.34 tok/s 39.81 tok/s 1049 s 58.4% 其中 512K 档实际完成:
523,744-token Prompt → 完整 Prefill → 正常进入 Decode
这里不是单纯把
ctx-size设置成 512K,也不是只完成模型加载,而是真正把超过 52 万 token 的 Prompt 完整跑完并正常生成。测试结果图
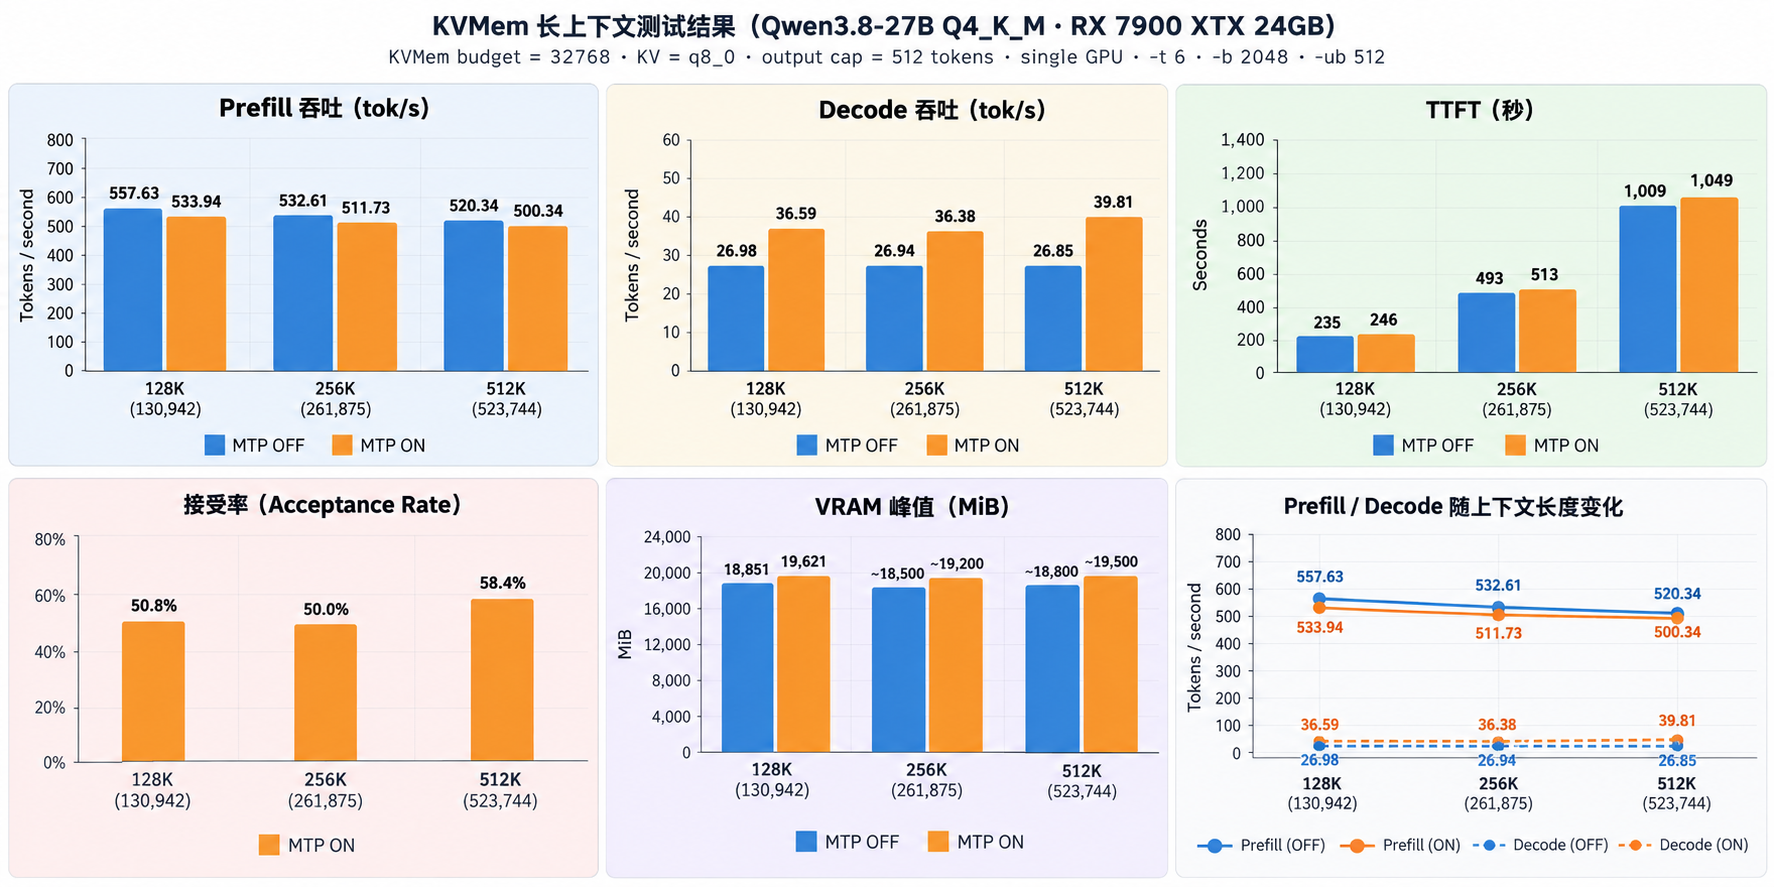
从表格和图里已经可以比较直观看到:
- Context 从 128K 一路增加到 512K 后,Prefill throughput 仍然保持在较高水平;
- MTP OFF 的 Decode 基本稳定在约
27 tok/s; - MTP ON 后,Decode 提升到约
36~40 tok/s; - 512K 实际 Prompt 达到 523,744 tokens,整轮测试正常完成。
后面不再重复展开 Prefill 曲线,重点看 KVMem 真正带来的几个实际变化。
5. VRAM 与 Host RAM:24GB 为什么能跑到 512K
这其实是我认为 KVMem 最核心的价值。
在 128K / 256K / 512K 的测试过程中,VRAM Peak 基本维持在:
约 18.2~19.5 GiB
Context VRAM Peak 128K 约 18~19 GiB 256K 约 18~19 GiB 512K 约 19 GiB 逻辑 Context 从 128K 增长到 512K,GPU 显存并没有跟着线性增加。
上一篇同一个
Qwen3.8-27B Q4_K_M、q8_0 KV的传统 Full-KV 测试中,128K 实际 Prompt 为 130,941 tokens:- MTP OFF VRAM Peak:21,168 MiB
- MTP ON VRAM Peak:23,008 MiB
也就是说,在传统 Full-KV 下,128K 已经开始明显逼近 24GB 显存上限。
而 KVMem 并不是把这些 KV “变没了”。
更准确地说,它是在做一种资源交换:
减少 GPU VRAM 中长期驻留的 KV,用 Host RAM 承载更大的历史状态。
GPU 侧只维持有限的 active KV working set,需要时再进行 retrieval / restore。
因此:
更少的 VRAM 压力
 更多的 Host RAM 使用
这台测试机一共只有 64GB DDR5 系统内存。
所以随着逻辑 Context 继续扩大,GPU VRAM 不再是唯一的容量边界,Host RAM 也会逐渐成为新的限制因素。
这里需要特别说明:
这次测试停在 512K,不代表 KVMem 的最大能力就是 512K。
我没有继续把正式测试推到 1M,主要有两个原因:
- 512K 已经足够验证单张 24GB RX 7900 XTX 上 KVMem 的长上下文扩展能力;
- 继续向 1M 推进会进一步增加 Host RAM 和整机资源压力,而这台测试机只有 64GB 系统内存,继续追求最大 Context 已经偏离本轮测试重点。
本文能够严谨确认的是:
这套配置实际完整验证到了 523,744-token Prompt。
至于 1M 或更高,本轮没有完整验证,因此不做结论。
所以 KVMem 解决的首先是:
Context Capacity。
它不是把 24GB 显存“变成了 48GB”,也不是把 50 万 token 的计算成本变没。
它改变的是:
“全部历史 KV 必须长期驻留在 GPU 显存里”这个前提。
6. KVMem Budget 到底控制什么?
这一点我觉得有必要单独讲。
本文性能测试统一使用:
KVMem budget = 32768这里的
32768并不是最大 Context,而是 GPU 侧允许保留的 active KV working set 大小。简单理解:
Budget 越大,GPU 里同时保留的 KV 越多;Budget 越小,就越依赖 Host RAM 和 retrieval / restore。
所以 KVMem budget 本质上控制的是一个资源平衡:
KVMem Budget GPU VRAM Retrieval 依赖 Recall 潜力 较小 更低 更高 极端场景更容易出现 miss 较大 更高 更低 通常更有利于 Recall 这也是为什么:
KVMem budget = 32768并不意味着只能跑 32K Context。
本轮测试里,GPU active KV budget 固定在约 32K,但实际逻辑 Context 分别跑到了:
- 128K
- 256K
- 512K
也就是说:
Context 可以继续增长,但 GPU 侧 active KV 的预算基本保持固定。
超出 active budget 的历史状态更多地由 Host RAM 承担,需要时再通过 retrieval / restore 重新带回。
为什么这篇统一使用 32K Budget?
这轮测试的目的不是找“最大 Recall”,而是想回答一个更直接的问题:
如果把 GPU 侧 active KV 固定在一个比较小的范围内,单张 24GB RX 7900 XTX 到底能把逻辑 Context 推多远?
所以我统一使用:
32768最终实测:
32K active KV budget → 523,744-token Prompt 完整跑通
同时 GPU VRAM Peak 基本仍维持在约:
18.2~19.5 GiB
这正是 KVMem 最有意思的地方之一。
Budget 不是越小越好
Budget 越小,确实越省 GPU KV 空间,也更有利于把逻辑 Context 往上推。
但代价也很明确:
更依赖 retrieval。
而 retrieval 越频繁、active working set 越小,在极端长上下文场景下,就越有可能暴露 Recall 边界。
我们之前的测试也已经观察到:
提高 active KV budget 后,极端 needle Recall 会改善。
所以实际部署时不能只追求最小 budget。
更合理的选择是根据用途做平衡:
- 追求最大 Context / 节省 VRAM:budget 可以偏小
- 更重视 Recall:budget 可以适当增大
- 系统内存有限:还要同时考虑 Host RAM 压力
最终实际上是在四个变量之间找平衡:
VRAM / Host RAM / Context Capacity / Recall Quality
所以 KVMem 的真正玩法,并不是单纯问:
“最大能跑多少 K?”
而是:
“在我能接受的显存和内存占用下,需要多大的 active KV budget,才能获得足够可靠的 Recall?”
7. MTP:可以和 KVMem 叠加,但要看实际 E2E
KVMem 和 MTP 可以正常一起使用。
Decode 实测:
Context MTP OFF MTP ON Decode 提升 128K 26.98 tok/s 36.59 tok/s +35.6% 256K 26.94 tok/s 36.38 tok/s +35.0% 512K 26.85 tok/s 39.81 tok/s +48.3% 512K 下:
26.85 → 39.81 tok/s
Decode 提升还是很明显的。
不过超长 Context 下有一个需要特别注意的问题:
不能只看 Decode。
512K 时:
MTP OFF
- TTFT:约 1009 s
- Decode:26.85 tok/s
MTP ON
- TTFT:约 1049 s
- Decode:39.81 tok/s
MTP ON 的 TTFT 增加了大约 40 秒。
而这轮测试的输出上限只有 512 tokens。
所以在这种:
超长 Prompt + 短输出
的场景里,虽然 MTP 明显提高了 Decode,但节省下来的生成时间还不足以覆盖前面增加的 TTFT 成本。
本轮 512K 测试中:
MTP ON 的 E2E 反而慢约 34 秒。
按照当前实测速度粗略计算,512K 这一档大概要输出:
约 3,320 tokens
MTP 才可能开始进入 E2E 正收益区间。
这里特别说明:
3,320 tokens 是根据当前实测速度推算出的 break-even,不是已经完成的实测点。
所以我目前对两者的理解很简单:
KVMem 主要解决容量。
MTP 主要解决生成速度。
两者可以叠加,但 MTP 到底值不值得开,需要结合 Prompt 长度和最终输出长度来看。
8. Retrieval:还有一点瑕疵,但整体已经可用
除了性能和显存,我也专门做了超长上下文 Recall 测试。
测试方法比较简单:
- 在超过 52 万 token 的长文本里,人工埋入 20 个彼此独立的 needle;
- needle 大多是随机编号、数字或者孤立事实,本身几乎没有语义关联;
- 然后在超长上下文末尾逐个提问;
- 最后检查 20 个事实能不能准确找回来。
这其实是一个故意把 Retrieval 推向极端的 needle-in-a-haystack 测试:
信息只出现一次、距离非常远、语义线索很弱,然后要求在 50 多万 token 后精确找回。
我此前用同类 Recall 方法测试的结果:
- SGLang:100%
- NInfer:100%
- KVMem:18 / 20,90%
所以 KVMem 目前还不能说完全无损,确实还有少量 retrieval miss。
不过我不会把这个
90%理解成:“日常使用有 10% 概率出错。”
这种测试本身就是人为构造出来放大 Retrieval 边界的极端场景。
正常 Agent、多轮对话、代码分析和长文档处理中,重要信息通常会有更多语义关联、上下文线索和重复引用,与这种“几十万 token 前只出现一次随机数字,然后最后精确追问”的情况并不完全相同。
所以我的阶段性评价是:
和 SGLang、NInfer 的 100% Recall 相比,KVMem 目前还有一点瑕疵;但考虑到它已经能在 24GB RX 7900 XTX 上把 Context 推到 512K,我认为整体已经可用,瑕不掩瑜。
9. 长上下文真正带来的好处是什么?
把 Context 从 128K 推到 256K、512K,真正有价值的地方并不是“数字更大”。
对实际 Agent 和长 Session 来说,更重要的是:
更多历史可以继续留在可访问范围内,而不用那么早就做 Context Compression、截断旧消息或者丢弃前面的工作状态。
这一点和我之前测试 SGLang HiCache、NInfer Prefix Cache 时感受到的价值有一些相似,但三者的机制并不一样。
- SGLang HiCache / NInfer Prefix Cache 更偏向:已经计算过的 KV 尽量复用,Cache 命中后可以减少重复 Prefill;
- KVMem 更偏向:让远大于 GPU active KV budget 的历史状态仍然可以被保存,并在需要时 retrieval / restore。
所以不能简单把 KVMem 等同于 SGLang HiCache 或 NInfer Prefix Cache。
但对于长期运行的 Agent,它们最终都在改善同一个现实问题:
不要因为 Context 很快装满,就频繁压缩、截断或者丢掉已经积累的工作历史。
比如一个 Agent 已经连续工作了几个小时,前面累计了:
- 大量对话历史
- 工具调用结果
- 日志
- 文档内容
- 中间分析
- 已经做过的决策
传统 Context 不够时,就不得不开始:
- 压缩历史
- 删除较早内容
- 重新总结
- 重新构造工作上下文
这些操作不仅增加管理成本,也可能造成信息损失。
而更大的可用 Context,配合 KVMem 这类 KV 管理机制,可以让 Agent 更长时间保持连续工作状态。
所以对我来说,512K 的意义并不只是:
“能塞进去 52 万 token。”
更重要的是:
让一个长 Session 能保留更多已经发生过的事情,晚一点再被迫压缩和截断。
这才是超长 Context 在实际使用里的价值。
10. 512K 和 Qwen3.8-27B 原生 256K Context 到底是什么关系?
这里需要单独解释一下,不然很容易把两个概念混在一起。
Qwen3.8-27B 的原生 Context Length 是:
262,144 tokens,也就是约 256K。
而本文测试的:
512K / 523,744 tokens
首先证明的是另外一件事情:
KVMem 可以让 24GB RX 7900 XTX 在运行时承载并处理超过 52 万 token 的逻辑历史,而不会因为传统 Full-KV 的显存需求直接 OOM。
也就是说,KVMem 主要解决的是:
KV Capacity
它解决的是:
这么长的历史能不能装得下、能不能继续运行。
512K 是总 Context,不是额外再加 512K
这里还有一个很容易误解的地方。
本文说的:
512K Context
指的是整个当前逻辑上下文的总长度约为 512K。
不是:
模型原生 256K + KVMem 再额外增加 512K
所以不存在:
256K + 512K = 768K
这样的关系。
更准确地理解:
概念 长度 Qwen3.8-27B 原生 Context 约 256K 本文 KVMem 测试的总逻辑 Context 约 512K 512K 档实际 Prompt 523,744 tokens 其中超过原生 256K 的部分,已经进入模型的长上下文扩展区域。
所以:
512K 能跑,不等于模型原生 Context 变成了 512K。
超过模型原生 256K 后,还可能涉及模型本身的长上下文扩展机制和外推质量,例如:
- RoPE Scaling
- YaRN
- 超出原生训练长度后的 Recall / Reasoning Quality
- 长距离信息关联能力
因此需要把两个问题分开看:
问题 KVMem 能解决吗? 24GB 显存能不能承载 512K 逻辑历史 可以,本文已实测 Full-KV 会不会因为 512K 直接把 VRAM 撑爆 KVMem 主要解决这个问题 模型原生 Context 是否因此变成 512K 不是 模型在 512K 下质量是否和原生 256K 一样 不能仅靠 KVMem 保证 512K 下 Recall 是否可靠 需要实际测试,本文已做初步验证 所以从工程角度看:
KVMem 负责解决“装不装得下、跑不跑得起来”。
而模型本身的 Context Extension、RoPE Scaling 和长上下文能力负责回答:
“跑到这么长以后,还能不能答得准。”
这也是为什么前面我没有因为“512K 跑通”就直接宣布“512K 完全无损”,而是另外做了 Recall 测试。
所以本文里的 512K,最准确的理解应该是:
在 KVMem 帮助下,在我的机器上(64G系统内存),24GB RX 7900 XTX 已经具备承载约 512K 总逻辑 Context 的能力;但超过模型原生 256K 之后的最终质量,还要结合模型本身的长上下文扩展能力和实际 Recall 测试一起判断。
11. 一句话总结
这个 KVMem 是我最近做的一大堆乱七八糟测试中,唯一让我产生爽感的好东西。
跑到 512K 以后,依然还能保持:
- Prefill:520.34 tok/s
- Decode:26.85 tok/s
- VRAM:约 18~19.5 GiB
逻辑 Context 从 128K 增长到 512K,扩大了 4 倍,而 Decode 基本没有变化。
对于一张只有 24GB VRAM 的 RX 7900 XTX 来说,这已经把可用的 Context 空间向前推了很大一步。
24GB 显存,512K Context,能跑、能用,而且速度还没有塌,真牛

 。
这就是我这两天折腾 KVMem 以后最直观的感受。
-
-
好贴,对7900来说很有价值的技术
-
,
 T terry 固定了此主题
-
,系统 取消固定了此主题
