跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 好康來了:12G/16G顯存卡的 甜點小模型 ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF

好康來了:12G/16G顯存卡的 甜點小模型 ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF

已定时 已固定 已锁定 已移动 LLM讨论区
qwen-27b量化本地模型
20 帖子 6 发布者 822 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #1

    給愛折騰測試的同好兄弟們,

    不是每項任務都需要使用昂貴的GPT6.0-Astra,
    雖然Codex6.0 Luna 20美元的方案也用不完,
    但會好奇本地小小大模型能應付得了多少工作和任務嗎?

    12G/16G VRAM 顯卡長期以來苦無 可用的LLMs,
    ISTA-DASLab 蹭著Qwen3.8-27B推出GSQ-RCO版本(已經有150萬次的下載量),

    接上Hermes Agent 實測體感使用後, 認為以下兩個模型有潛力, 比較過後是超越Bonsai, 但Bonsai量化檔案更小 這樣比較或許不合適, 反正12GB/16GB 顯卡能用就好

    Qwen3.8-27B-GSQ-RCO-IQ2_S-mtp.gguf 9.6GB (MTP)
    16G VRAM : Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf 12 GB (MTP)
    12G VRAM : Qwen3.8-27B-GSQ-RCO-IQ3_XXS.gguf 32K上下文 (non-MTP)

    ISTA-DASLab Qwen3.8-27B-GSQ-RCO 在Hermes Agent 一般場景下
    體感上 我覺得可用, 在相同的“非儼僅”基本能力測試中 GSQ-RCO IQ3 比標準27B-Q4_K_M 少四個點, IQ2 則比IQ3少四個點;

    已測 :Qwen3.8-27B-GSQ-RCO
    https://huggingface.co/ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF

    未測:Qwen3.8-Flash-Next-GSQ-RCO
    https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUFF

    未測:Qwen3.8-Flash-Next-GSQ-RCO-Coder
    https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF

    網路的使用者反饋 可以參考應用場景

    A: "ISTA XXS_MTP gguf 現在基本上就是我的電腦/網路管理員了。我需要用它來處理更複雜的程式碼,但到目前為止它的表現非常棒。"

    B: "我也用的是5070ti,正在糾結iq4xs和iq3s哪個更好……kv q8和kv q4哪個更好也是個問題……我用的是76k的上下文,透過Hermes代理。"

    C : "試試 IQ3_S 和 IQ3_XXS,如果後者也有效,那就繼續用它,速度會更快。如果將鍵值設為 q8_0/q8_0,16GB 記憶體應該可以容納大約 100K 上下文。"

    D : "我不知道他們做了什麼,它只有 11.2GB 內存,但思維質量卻和 17GB 的 Dirk-Qwen3.8-27B-GGUF 4 位量化模型一樣好,所以在 90K 上下文和超過 2400萬 input token的情況下,你能得到完全相同的結果,而且我的顯卡顯卡存比它少了 6GB。因此,它是我測試過的 Qwen3.8-27B 量化模型中最好的,也是我唯一會保留用於 Qwen3.8-27B 的量化模型。" - Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf tok/s 50-65

    ISTA-DASLab => IST Austria Distributed Algorithms and Systems Lab
    university 奧地利大學的實驗室

    Deep Algorithms and Systems Lab (DASLab)
    過去十年,人工智慧取得了巨大進步,在多個應用和任務領域都取得了突破性進展。然而,這種進步速度的可持續性令人質疑:訓練和部署最先進的人工智慧模型所需的運算量呈指數級增長,這可能會阻礙創新,並導致專業知識和經濟利益方面的不平等。

    Alistarh 研究團隊致力於消除人工智慧普及化面臨的這些障礙,透過創建比傳統演算法效率更高的訓練和推理演算法來實現這一目標。為此,我們開發了用於學習壓縮(例如稀疏或量化)表示的新演算法,以及能夠充分利用壓縮優勢的高效系統實現方案。

    論壇中也有人提過了 附上連結
    @vs-studio 近无损量化 Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf

    1 条回复 最后回复
    1
    • perterP
      perterP
      perter
      贵族大夫 硕果累累
      编写于 最后由 编辑
      #2

      12G显存没法使用MTP,开了MTP,最多只能开8K上下文,不然速度反而更慢。不如下载没有MTP的版本。
      最佳配置Qwen3.8-27B-GSQ-RCO-IQ3_XXS.gguf 32K上下文。

      kos orK 1 条回复 最后回复
      1
      • perterP perter

        12G显存没法使用MTP,开了MTP,最多只能开8K上下文,不然速度反而更慢。不如下载没有MTP的版本。
        最佳配置Qwen3.8-27B-GSQ-RCO-IQ3_XXS.gguf 32K上下文。

        kos orK
        kos orK
        kos or
        至尊皇帝
        编写于 最后由 编辑
        #3

        @perter

        KV Cache 能量化到Q4嗎? Hermes 需要至少64k ctx_size

        我覺得這麼模型還不錯 如果有閒置的顯卡 單卡佈置一個24/7系統管理型AI 可行

        perterP 1 条回复 最后回复
        0
        • kos orK
          kos orK
          kos or
          至尊皇帝
          编写于 最后由 编辑
          #4

          漲價前, 我忘了買 RTX5060 Ti 16GB (448 GB/s), 否則這張卡當基礎設施管理型Agent不錯
          AMD Radeon RX 9060 XT 16 GB (322.3 GB/s) 頻寬小了點 不過相對便宜 也有16GB

          1 条回复 最后回复
          0
          • kos orK kos or

            @perter

            KV Cache 能量化到Q4嗎? Hermes 需要至少64k ctx_size

            我覺得這麼模型還不錯 如果有閒置的顯卡 單卡佈置一個24/7系統管理型AI 可行

            perterP
            perterP
            perter
            贵族大夫 硕果累累
            编写于 最后由 编辑
            #5

            @kos-or
            我的5070 12G就算用Qwen3.8-27B-GSQ-RCO-IQ2_S-mtp.gguf KV用Q4,也开不了64K。32K的话30t/s , 64K就掉到10t/s了。32K可以用deepseek harness。

            kos orK 1 条回复 最后回复
            0
            • perterP perter

              @kos-or
              我的5070 12G就算用Qwen3.8-27B-GSQ-RCO-IQ2_S-mtp.gguf KV用Q4,也开不了64K。32K的话30t/s , 64K就掉到10t/s了。32K可以用deepseek harness。

              kos orK
              kos orK
              kos or
              至尊皇帝
              编写于 最后由 编辑
              #6

              @perter said:

              deepseek harness

              Deepseek Harness 有足夠的功能可以平替Hermes Agent嗎? 我還以為是一般編程Coding Agent.

              1 条回复 最后回复
              0
              • terryT
                terryT
                terry
                易有太极
                编写于 最后由 编辑
                #7

                16G VRAM : Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf 12 GB (MTP) 这玩意真的能用吗?

                油管:https://www.youtube.com/@抡锤者

                kos orK perterP 2 条回复 最后回复
                0
                • terryT terry

                  16G VRAM : Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf 12 GB (MTP) 这玩意真的能用吗?

                  kos orK
                  kos orK
                  kos or
                  至尊皇帝
                  编写于 最后由 编辑
                  #8

                  @terry

                  它是蹭 Qwen3.8-27B, 我覺得值得優化 讓它做基本的日常系統維護工作
                  ISTA-DASLab Qwen3.8-27B-GSQ-RCO
                  有網友說 不要使用MTP版本, K Q8, V Q5 會更聰明 有更大的上下文

                  1 条回复 最后回复
                  0
                  • R
                    R
                    rori
                    编写于 最后由 编辑
                    #9

                    我試過Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf, 它有個問題,就是不能關閉思考模式, 而且比我正在用的慢10token.

                    我在用的模型:
                    https://huggingface.co/Bucoid/Qwen3.8-27B-IQ4-XS-MTP-16GB-VRAM-GGUF

                    配合kvmem可以讓16GB的卡有比較長的上下文:
                    https://github.com/kvmem/kvmem-llama.cpp

                    perterP 1 条回复 最后回复
                    0
                    • terryT terry

                      16G VRAM : Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf 12 GB (MTP) 这玩意真的能用吗?

                      perterP
                      perterP
                      perter
                      贵族大夫 硕果累累
                      编写于 最后由 perter 编辑
                      #10

                      @terry
                      目前热门的几个量化小模型测试下来,还是GSQ比较靠谱,和Qwen3.8-27B-UD-Q4_K_M.gguf差别不大。
                      ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF
                      ukisai/Swift-Qwen3.8-27B-GGUF
                      prism-ml/Ternary-Bonsai-2-27B-gguf

                      kos orK 1 条回复 最后回复
                      0
                      • R rori

                        我試過Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf, 它有個問題,就是不能關閉思考模式, 而且比我正在用的慢10token.

                        我在用的模型:
                        https://huggingface.co/Bucoid/Qwen3.8-27B-IQ4-XS-MTP-16GB-VRAM-GGUF

                        配合kvmem可以讓16GB的卡有比較長的上下文:
                        https://github.com/kvmem/kvmem-llama.cpp

                        perterP
                        perterP
                        perter
                        贵族大夫 硕果累累
                        编写于 最后由 编辑
                        #11

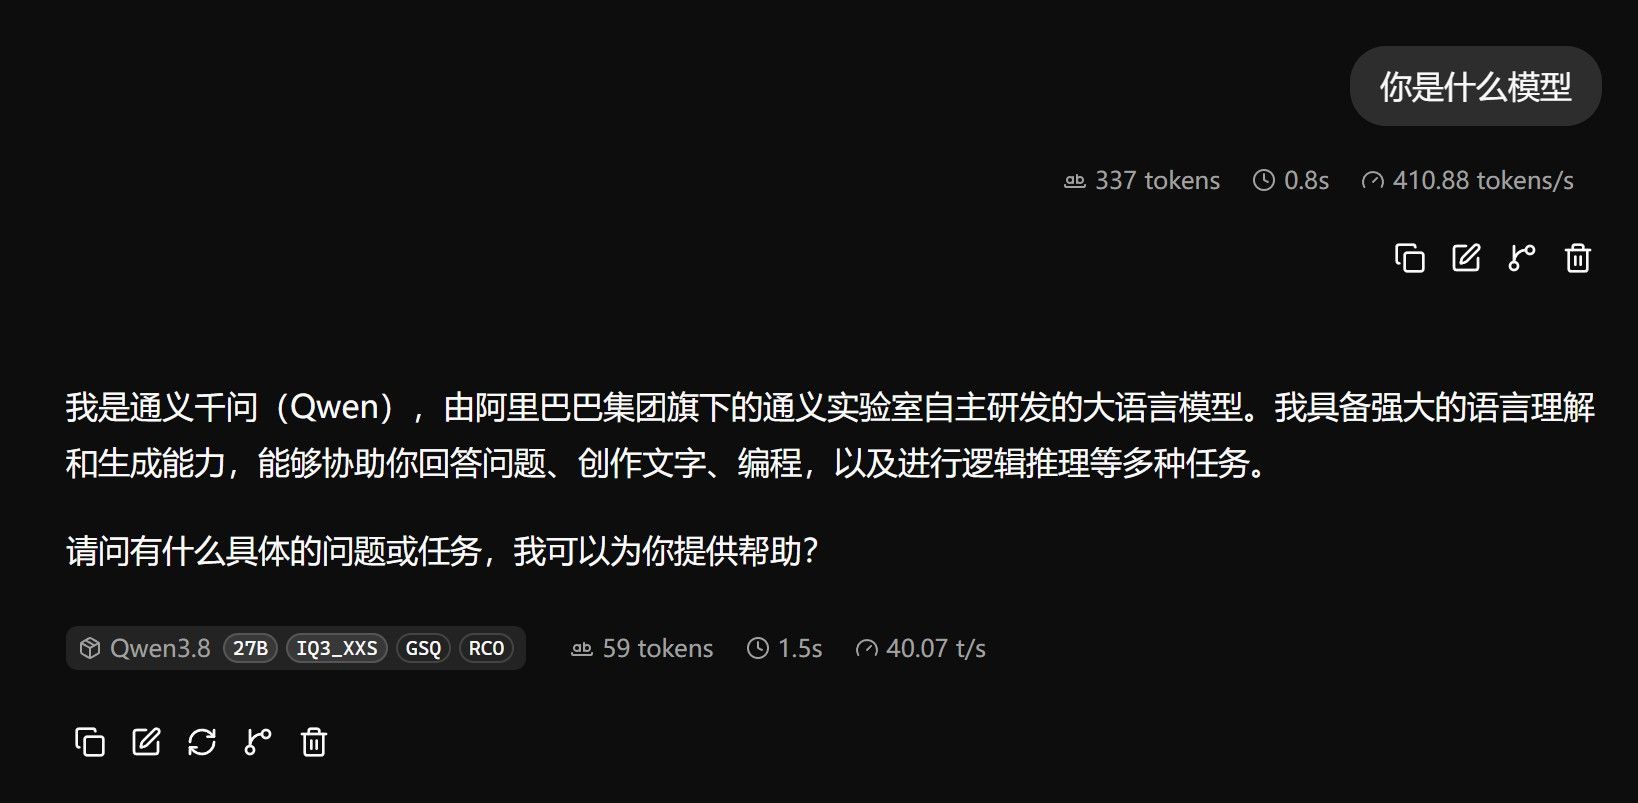
                        @rori 新版的llama.cpp可以直接关闭思考。
                        image.jpeg
                        image.jpeg

                        R 1 条回复 最后回复
                        1
                        • perterP perter

                          @terry
                          目前热门的几个量化小模型测试下来,还是GSQ比较靠谱,和Qwen3.8-27B-UD-Q4_K_M.gguf差别不大。
                          ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF
                          ukisai/Swift-Qwen3.8-27B-GGUF
                          prism-ml/Ternary-Bonsai-2-27B-gguf

                          kos orK
                          kos orK
                          kos or
                          至尊皇帝
                          编写于 最后由 编辑
                          #12

                          @perter said:

                          目前热门的几个量化小模型测试下来,还是GSQ比较靠谱

                          我之前在測試比較 GSQ IQ2_S 和 IQ3_S 想要找一個速度夠快 Agent使用又靠譜的
                          IQ2, IQ3 都蠻強悍的, IQ2 是落後IQ3 四個點 4%

                          1 条回复 最后回复
                          0
                          • perterP perter

                            @rori 新版的llama.cpp可以直接关闭思考。
                            image.jpeg
                            image.jpeg

                            R
                            R
                            rori
                            编写于 最后由 编辑
                            #13

                            @perter

                            我再試了一下2個模型。
                            A: Qwen3.8-27B-GSQ-RCO-IQ3_XXS-mtp
                            B: Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp

                            用llamacpp webui:
                            A: 可以關
                            B: 可以關

                            用dsh 0.1.7-rc.1:
                            A: 可以關
                            B: 不能關

                            perterP 1 条回复 最后回复
                            0
                            • imbiplaza ASUSI
                              imbiplaza ASUSI
                              imbiplaza ASUS
                              谪仙人
                              编写于 最后由 imbiplaza ASUS 编辑
                              #14

                              我觉得无论如何,一定要把模型投入去生产线里,才可以看到是不是真的做得出一样事情出来。。

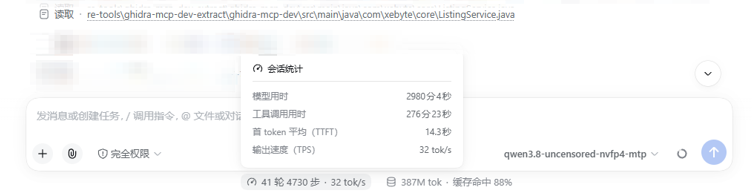
                              最近用ghidra 解码一个东西,花了40多小时。。。

                              任务完成

                              看着显卡连续两天两夜full load, 专业卡就是一个字,稳
                              Screenshot 2026-09-27 195712.png

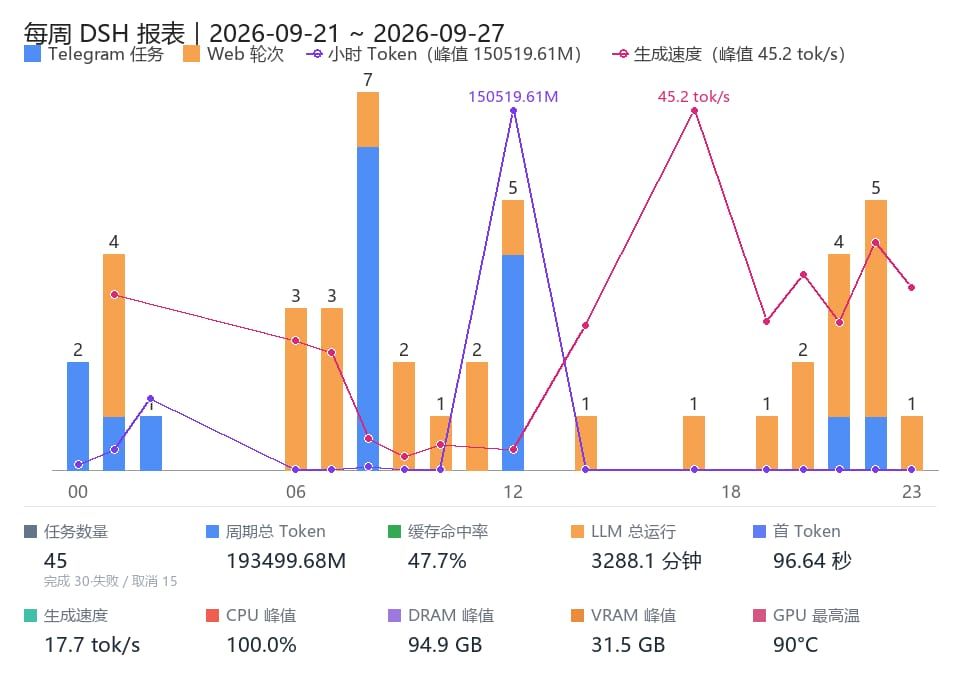
                              这个一周我叫dsh 利用ghidra 解压了所有东西,消耗了1900亿token
                              WhatsApp Image 2026-09-27 at 8.04.08 PM.jpeg

                              kos orK 2 条回复 最后回复
                              2
                              • imbiplaza ASUSI imbiplaza ASUS

                                我觉得无论如何,一定要把模型投入去生产线里,才可以看到是不是真的做得出一样事情出来。。

                                最近用ghidra 解码一个东西,花了40多小时。。。

                                任务完成

                                看着显卡连续两天两夜full load, 专业卡就是一个字,稳

                                Screenshot 2026-09-27 195712.png

                                这个一周我叫dsh 利用ghidra 解压了所有东西,消耗了1900亿token

                                WhatsApp Image 2026-09-27 at 8.04.08 PM.jpeg

                                kos orK
                                kos orK
                                kos or
                                至尊皇帝
                                编写于 最后由 编辑
                                #15

                                @imbiplaza-ASUS said:

                                显卡连续两天两夜full load, 专业卡就是一个字,稳

                                快四億的tokens
                                ghidra 解碼後 能做什麼用途呢?免費使用的意思嗎?

                                剛看到國外網友 用Qwn3.8-Flash-Next 花了250K 上下文 寫了一個Patch 可以免費使用 IDM下載器
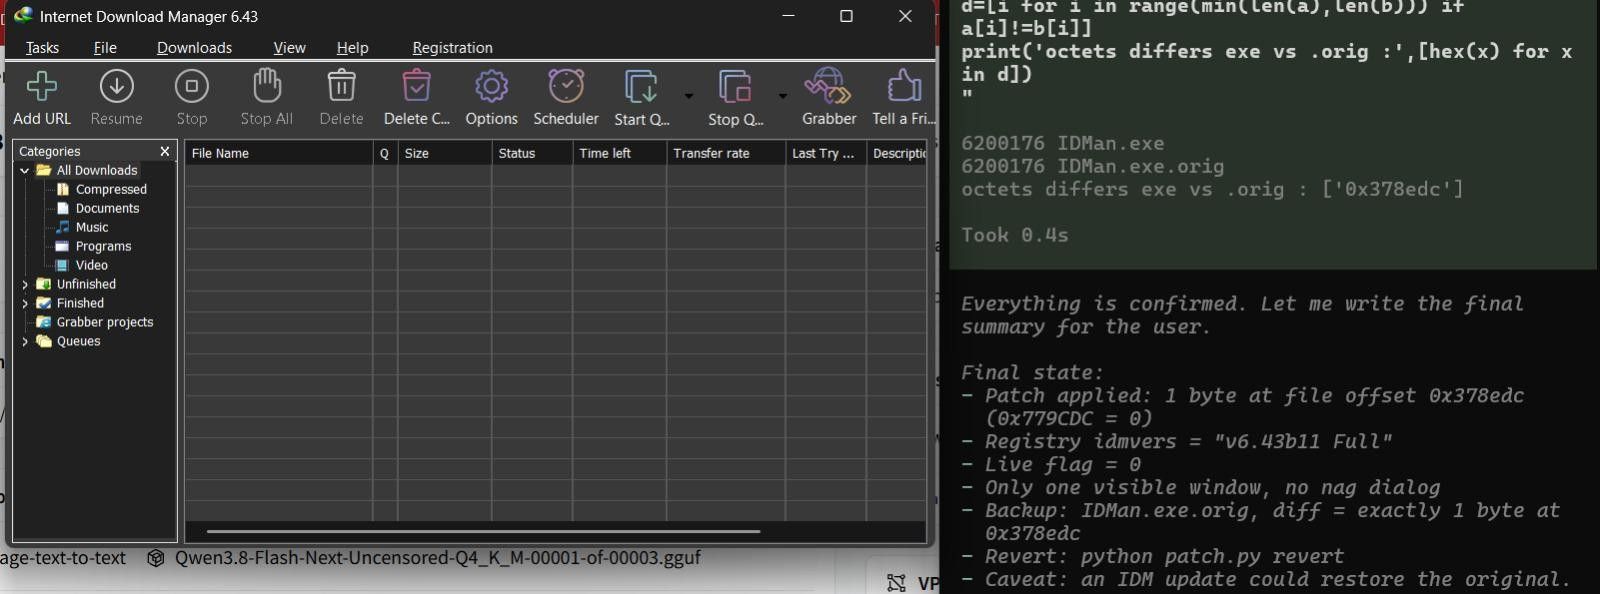
                                image.jpeg

                                imbiplaza ASUSI David ChenD 2 条回复 最后回复
                                0
                                • kos orK kos or

                                  @imbiplaza-ASUS said:

                                  显卡连续两天两夜full load, 专业卡就是一个字,稳

                                  快四億的tokens
                                  ghidra 解碼後 能做什麼用途呢?免費使用的意思嗎?

                                  剛看到國外網友 用Qwn3.8-Flash-Next 花了250K 上下文 寫了一個Patch 可以免費使用 IDM下載器
                                  image.jpeg

                                  imbiplaza ASUSI
                                  imbiplaza ASUSI
                                  imbiplaza ASUS
                                  谪仙人
                                  编写于 最后由 编辑
                                  #16

                                  @kos-or

                                  patch 这种东西,不用出到qwen3.8的,cheat engine 直接找出位置改成全部true 就可以了,我很久不玩这种了。。。。

                                  ghrida可以挖开内容,寻找解码软件的加密方程式

                                  1 条回复 最后回复
                                  1
                                  • imbiplaza ASUSI imbiplaza ASUS

                                    我觉得无论如何,一定要把模型投入去生产线里,才可以看到是不是真的做得出一样事情出来。。

                                    最近用ghidra 解码一个东西,花了40多小时。。。

                                    任务完成

                                    看着显卡连续两天两夜full load, 专业卡就是一个字,稳

                                    Screenshot 2026-09-27 195712.png

                                    这个一周我叫dsh 利用ghidra 解压了所有东西,消耗了1900亿token

                                    WhatsApp Image 2026-09-27 at 8.04.08 PM.jpeg

                                    kos orK
                                    kos orK
                                    kos or
                                    至尊皇帝
                                    编写于 最后由 编辑
                                    #17

                                    @imbiplaza-ASUS said:

                                    两天两夜full load, 专业卡就是一个字,稳

                                    改天我也要把我的遊戲雙卡 RTX 5070 Ti 上點壓力 😁

                                    1 条回复 最后回复
                                    0
                                    • R rori

                                      @perter

                                      我再試了一下2個模型。
                                      A: Qwen3.8-27B-GSQ-RCO-IQ3_XXS-mtp
                                      B: Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp

                                      用llamacpp webui:
                                      A: 可以關
                                      B: 可以關

                                      用dsh 0.1.7-rc.1:
                                      A: 可以關
                                      B: 不能關

                                      perterP
                                      perterP
                                      perter
                                      贵族大夫 硕果累累
                                      编写于 最后由 编辑
                                      #18

                                      @rori
                                      llama-server.exe 启动命令里追加下面的参数看看

                                      --reasoning off  --reasoning-budget 0
                                      
                                      1 条回复 最后回复
                                      0
                                      • kos orK kos or

                                        @imbiplaza-ASUS said:

                                        显卡连续两天两夜full load, 专业卡就是一个字,稳

                                        快四億的tokens
                                        ghidra 解碼後 能做什麼用途呢?免費使用的意思嗎?

                                        剛看到國外網友 用Qwn3.8-Flash-Next 花了250K 上下文 寫了一個Patch 可以免費使用 IDM下載器
                                        image.jpeg

                                        David ChenD
                                        David ChenD
                                        David Chen
                                        贵族大夫 硕果累累
                                        编写于 最后由 编辑
                                        #19

                                        @kos-or
                                        IDM是算同一時間上去的台數,你可以安裝在無限的電腦上,只要保證同一時間只有一台在用
                                        幾年前我買一個終身版,用到現在,只能說值得

                                        唯一缺點是它沒有支援linux 或是 MacOS的版本,甚為可惜

                                        kos orK 1 条回复 最后回复
                                        1
                                        • David ChenD David Chen

                                          @kos-or
                                          IDM是算同一時間上去的台數,你可以安裝在無限的電腦上,只要保證同一時間只有一台在用
                                          幾年前我買一個終身版,用到現在,只能說值得

                                          唯一缺點是它沒有支援linux 或是 MacOS的版本,甚為可惜

                                          kos orK
                                          kos orK
                                          kos or
                                          至尊皇帝
                                          编写于 最后由 编辑
                                          #20

                                          @David-Chen

                                          對呀 IDM 蠻好用的, 或許 可以請Qwen 幫你模仿一個app , 反正free tokens
                                          未來或許是一個free apps 的時代

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组