
本地部署AI划算吗?GPT Plus订阅/DeepSeek V4.1 Flash 比本地部署更划算,ComfyUI/隐私/扛审查/API稳定性等特殊场景例外!
-
啊,本期视频我们再分享一下当下这个阶段,在本地部署个人 AI 是否有意义、是否有必要。啊,这个话题呢,每隔一两个月我们就要谈一下,因为每隔一两个月形势就大不相同,啊,条件就变了,那么我们的结论也就变了。首先说一下,就是说当下啊,还是那句话,不是部署本地 AI 的最好、最佳时机,原因很简单,就是因为现在各大 AI 模型企业正在打价格战。OpenAI 它这个什么 GPT Plus 订阅计划,20 美金一个月,给足了 GPT-6 Luna 的这个使用额度,而且 Luna 的这个能力,虽然相比于 DeepSeek V4.1 Flash 呃显得有点弱,但是总体上,你用这个什么一定的额度去跑这个 GPT-6,做帮你规划任务,然后把杂活脏活累活交给这个 GPT-6 Luna,它还是能够完成的。而且 20 美金一个月的订阅计划,根据我的使用状况,你只要不是重度开发,像我这样的中度、甚至中度有点偏重的开发,它都是用不完的。
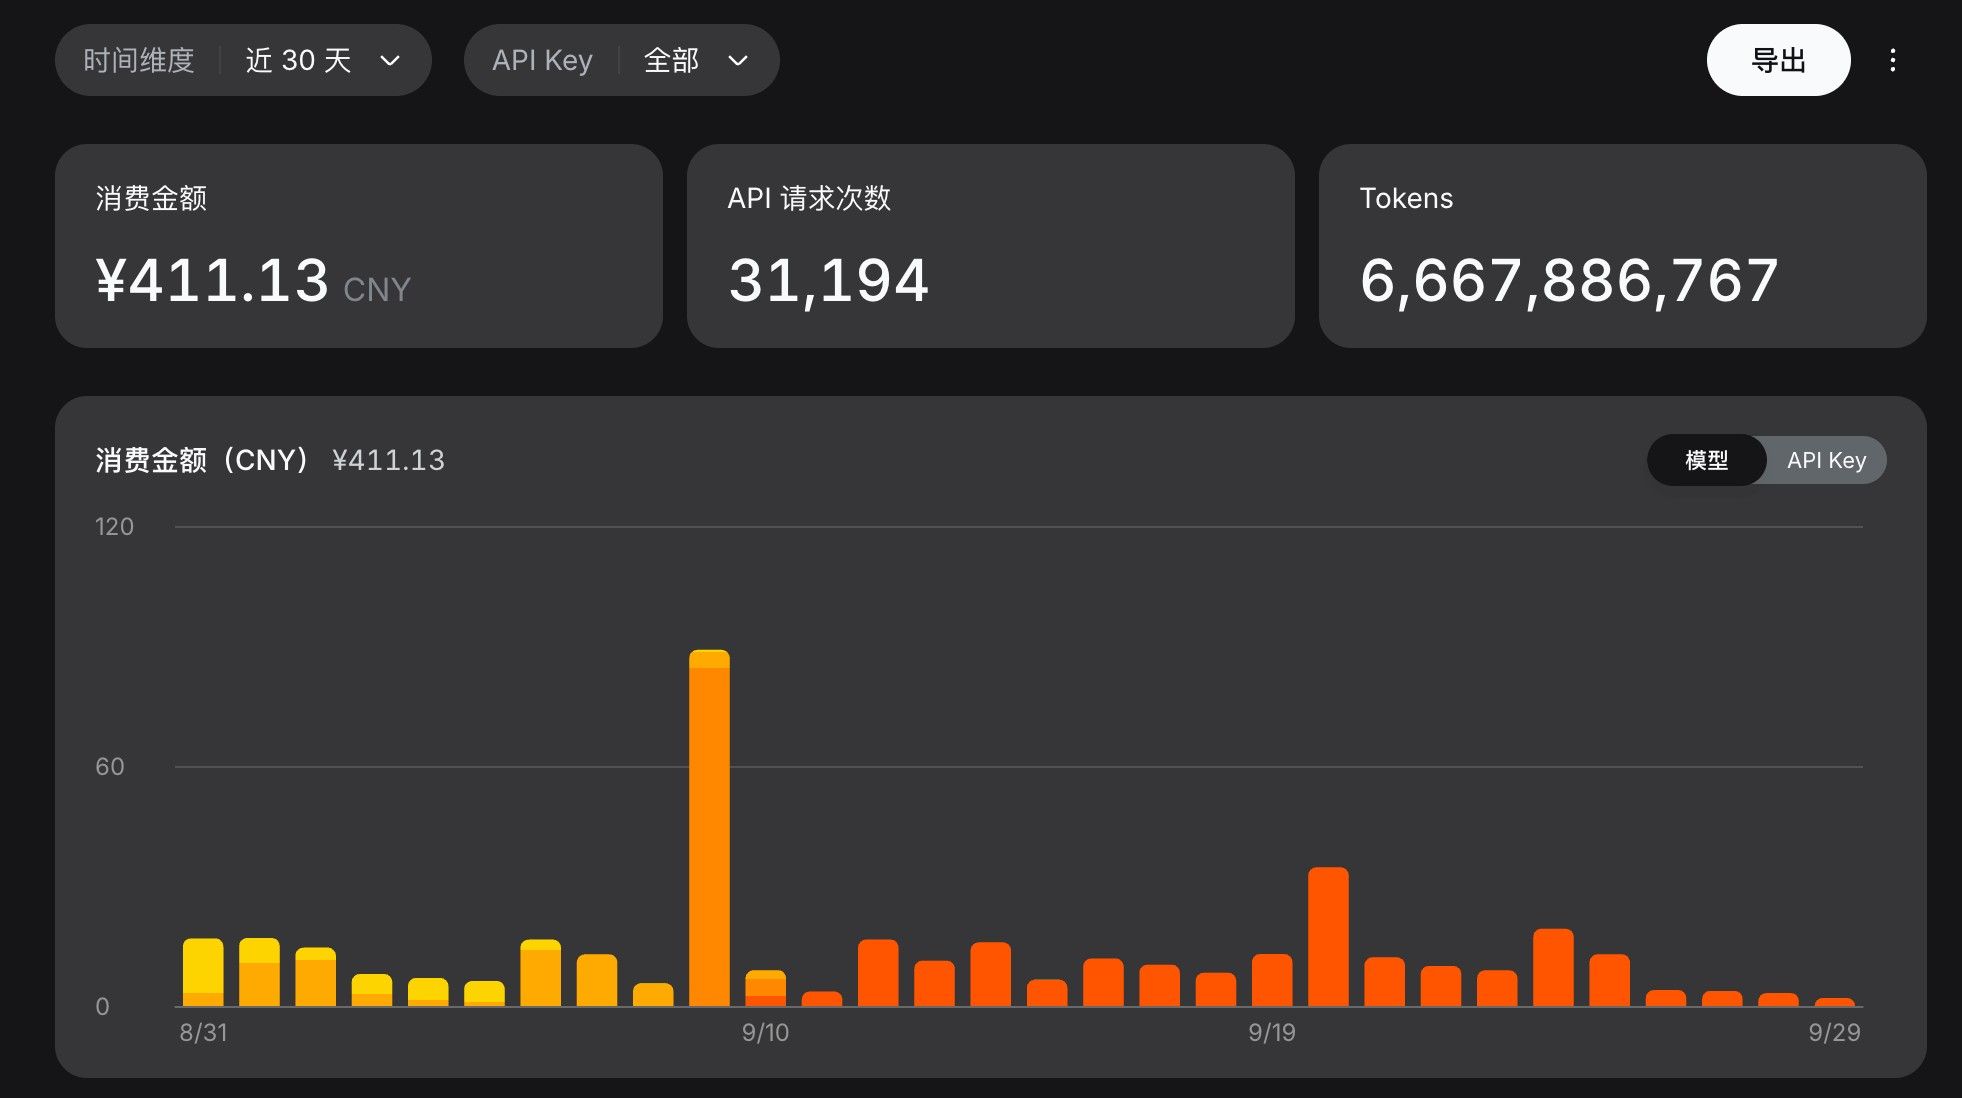
如果说你是呃 DeepSeek Flash 的用户,你的体验会稍微好一点。像我这样一个网站有好几千人注册,然后可能每天都有这个好几百人访问,然后每天有大量的帖子、有大量的回帖。然后我是用这个 DeepSeek V4.1 Flash 驱动 Hermes 和 DeepSeek Harness,来维护我这个网站,包括这个什么安全巡检、包括这个数据备份、包括这个用户违规处理,然后有些内容的初审、发一些资讯帖子、整理一些数据帖子,然后回复用户的提问。也包括这个,我围绕这个呃网站开发了一些定制页面,然后我还开发了一个 APP,就是面向苹果用户和安卓用户。啊,开发已经基本上完成,我会找时间把它上线,啊,让大家帮我先测试一下。可能国庆节吧,等我稍微找个时间测试一下,国庆之后我找个合适的时机把它发布。
这个就是我平时的工作,然后我还用它来开发什么一些小的工具,比如说 AI 视频生成器、剪辑器,然后平时让它来帮我呃粗剪视频、修复字幕。在这种使用强度下,我每个月的开销大概是 450 块钱左右。另外呢,我还在什么腾讯啊、在阿里啊、在小米啊,还有在这个国外的 OpenRouter 这样的聚合网站上面,啊,包括这个字节跳动,我都是充了一些钱的,但是这些都是零零碎碎的花销,就是有新模型出来我要第一时间测试一下,我觉得不错的模型我就会跟大家分享。就如果说你不像我一样有做视频的需求,需要这么多素材,你就订阅一个 GPT Plus,甚至你奢侈一点订阅两个 Plus,40 美金一个月,一个月的开销不到 300 块钱;或者像我一样纯粹使用 DeepSeek,那么一个月的开销在 450 块钱左右,啊,不到 500 块钱。
那你想一想,你在这种情况下,如果单纯地算这个经济账,你觉得有必要部署吗?一张 7900XTX 就 8,500 块钱,二手的 3090 大概也要 8,500 左右,然后如果是二手 3090 芯片拆下来重做的所谓的新卡,新的涡轮卡,要 1 万多块钱。是吧,我们就以 1 万块钱为这个参照基准来算一算。如果说你每个月的使用开销比我低一点,假设是 400 块钱,这个绝对是大部分人都够用了,你可以使用两年多的 API。我觉得未来一段时间,你说 AI 这个服务大幅涨价,这个是不可能的,因为价格战越来越激烈,OpenAI 都已经下场了,然后 Anthropic 也在降价。中国的这些所谓的呃 AI 几小龙也好,啊,开源的 AI 大模型,还是说像字节跳动呃这个腾讯,包括阿里都在想办法降价,也包括小米了,吸引客户。在这种情况下,你在本地部署 AI,它从经济上来讲的话就不太划算。
那么像我之前视频中提到的本地部署 AI 的几个硬性的要求,首先我们看业务。如果说你是跑这个视频,就 ComfyUI 生态,你要这个视频跟画图为主,你每天都有一两百张图片,有这个什么十几个短视频片段要生成,甚至几十个短视频片段,啊,在这种情况下,你说你用在线的 API,无论如何你肯定是用不起的。那么有 MiniMax H3,有千问 Qwen Image 2.1 这样非常牛逼的本地的视频和图像模型,这个时候你花个 8,500,花个 1 万,是吧,去买张 7900XTX,买张这个 AI Pro R9700,买张 3090、4080S 32G、4090 48G,或者说更高端的几万块钱的、五六万块钱的 RTX Pro 5000、十几万块钱的 RTX Pro 6000,你只要你每天确实有硬性的需求,能生产这个几十个视频片段,甚至上百个视频片段,是吧,你有这样的需求,你在本地去部署显卡,它就是有生产力的。可是问题是,你一定要生产出来的视频它,它不是 AI slop,它是能够给你挣到钱才行。是吧,你的这个图片能够唉被客户采用、能够卖出去,它才有意义。如果只是自娱自乐,你在本地部署它又有什么意义呢?
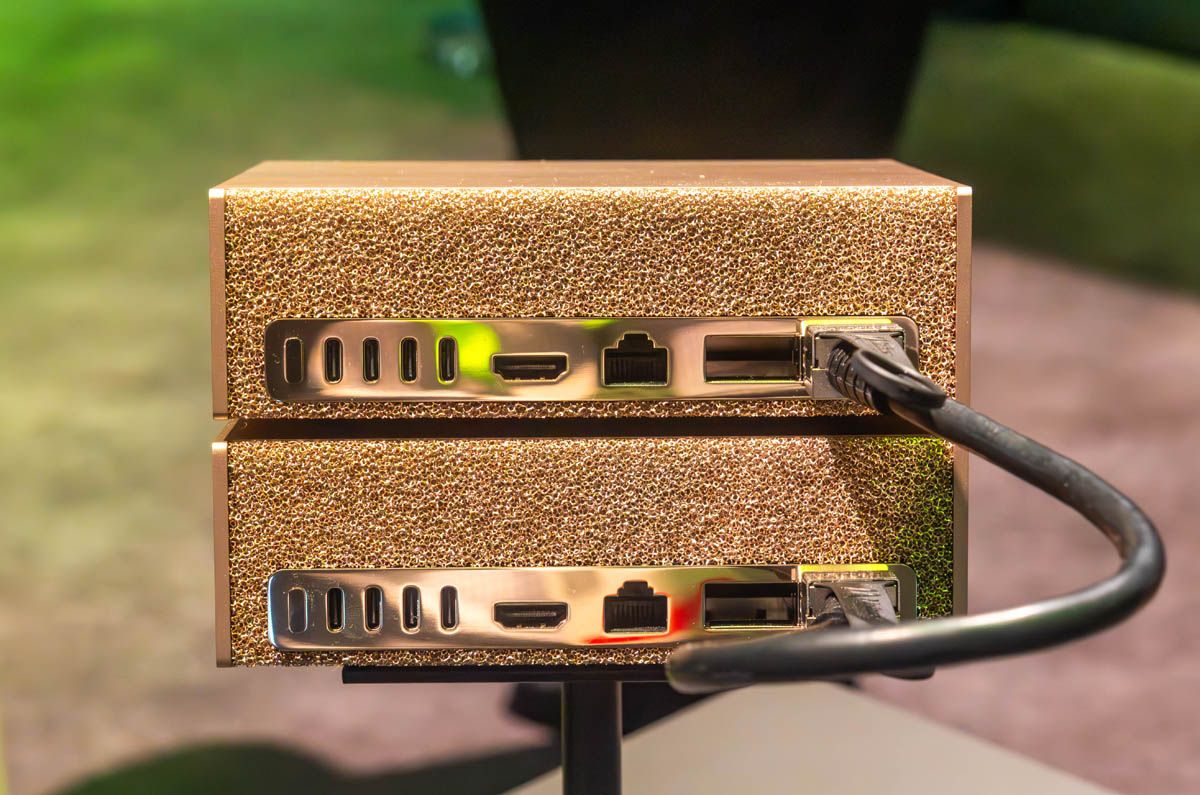
另外一个就是,如果说你是要使用这个 AI agent 驱动文本大模型,讲实话你在本地的选择是寥寥无几的,是吧,屌丝就是千问 3.8 27B,这个本地性价比最高的模型。然后稍微有一点能力的,啊,买贵一点的这种小主机的,你可以跑个什么千问 3.8 Flash,也可以跑这个什么两个小主机驱动 DeepSeek V4 Flash,或者 GLM-5.3-Flash。那么在这种情况下,我觉得你本地部署的模型跟在线模型之间的体验还是有差距的。就我们以这个本地性价比之王千问 3.8 27B 来说,就它的智力,我认为在复杂任务开发中还是要比这个什么呃 GPT-6 Luna 要好一点点的。GPT-6 Luna 虽然上下文长度够,但是它的这个幻觉又比较严重,呃,两个在伯仲之间嘛。搭配 Codex 之后,GPT-6 Luna,啊,我认为体验要比这个本地的千问 3.8 27B 要好那么一点点,综合体验。可能它的单个任务中,它的执行体验是不如千问 3.8 27B,但是总体上,它的使用体验是要更好一点。这个就是在线模型中,我讲的是走这种低价量大管饱的这个路线的模型,20 美金一个月就够你用了,100 多块钱人民币吧,一百四五十块钱人民币。那你说就算你花个什么五六万块钱,你花个 6 万多块钱、7 万块钱,买两个什么呃 DGX Spark,你去部署了 DeepSeek V4 Flash,前两个月可能说唉还不错,现在你已经落伍了,因为 V4.1 Flash 你就跑不动了。那你就可能需要 4 个小盒子来跑,那这就需要十几万了。你不要说十几万了,你就说 7 万块钱,是吧,你买这个 DeepSeek API,你给它充给梁子,你得用多久啊?你很有可能能够用到人类社会灭绝、机器人统治人类。
那么当然了,我在之前反复强调的,其实有三个硬性的需求。第一就是数据隐私的需求,是吧,你怕别人知道你的银行呃账户余额是 8 块 6,怕别人知道你曾经这个浏览过 9 站、X 站、P 站,是吧,喜欢看什么类型的视频,喜欢哪个老师的作品;或者说你要去创作这个岛国爱情动作电影风格的这么一种影视作品,然后你需要去审查,你不能使用这个在线的模型。要么是你要搞什么这个反清复明大业,是吧,靠一些反动的一些创作,你就不能接受在线的审查。再或者你的业务对于这个 API 的稳定性有极高的要求,就你的业务是一种常规性的啊,比如说是数据清洗也好,还是说这种非常复杂的这些呃文档整理也好,然后你这个什么缓存命中率不高,每天就需要它这个显卡在高强度的工作,你要的只是稳定,不是能力。这几种情况你可能说本地部署 AI,它还是有意义的。除此之外,我真的想不出你为什么要在本地去部署 AI,因为它们的使用体验和性价比,在当下来说都是非常地不好。
另外呢,我需要大家知道,就是说我们 95% 的人都认为自己用 AI 能够什么呃放大自己的优势,但是前提是你真的有优势。啊,比如说像我擅长吹牛,啊,我就喜欢瞎逼逼,那么我对着镜头逼逼,有些观点大家就是喜欢听,那么我就能去养活我这个小频道,把我这个小频道支棱起来。我的小频道就有流量,我通过这个流量每个月就能够赚到哎,还怎么讲,还不错的、能够维持我基本生活的、能维持我体面生活的这种收入。那我多做几个频道,我的这个收入水平就还不错了,是吧?多出来的钱还能还债,我每天生活就比较惬意。然后我这个频道还能为我的这个网站带来流量,我的这个网站它的流量又能反哺我的频道,形成一个正向的循环。如果说做的时间长了,比如说做个两年,是吧,甚至我觉得可能要不了两年,呃,到明年的这个 4 月份、5 月份满一周年的时候,我这个网站就能赚钱,就能开始赚钱。是吧,那我就会多一个这个收入点,就再怎么说,我这个网站还是有意义、有价值的,有很多新人在这里能够解决自己的问题、学到知识,有很多大牛能够在这里来分享自己的看法、分享自己的高见,它能够获得情绪价值,就它本身还是有意义的。
可是说实话,有的时候我看到有些朋友在我网站推广他们的网站,我讲实话我也去看了一下,那些博客讲实话做得跟狗屎一样,就是毫无意义的。还有一些朋友,他们认为自己的作品、影视作品可能做得不错,还非常有创意,可是事实上一眼就能看出来这些东西是 AI slop。他们分享了某些看法,总觉得 AI 帮助自己放大了自己的优势,实际上他们并没有任何的优势。他们的作品如果放到 YouTube 上,连这个什么 YPP 都过不了,更不要说赚钱了。就是 AI 可以成为我们生产效率的放大器,但是前提是你生产的东西一定要有意义,一定要有现实的价值,它要有客观的受众才行。
在这个本地部署 AI 之前,像别人一样去采购什么 3 万块钱、5 万块钱,甚至十几万块钱的设备之前,你要从自身的经济角度考虑。如果说这个钱对于你来说是九牛一毛,你无所谓,就是玩票,你不在乎,那么你就捡贵的买就行了,越贵体验越好。如果说你是真的在乎这个投入,那么你投入之前一定要最起码地先把你本身的这个创意、你的这个想法验证一下,到底有没有价值。哪怕有这个 0.01% 的可能是盈利的,0.01% 的这个市场需求,那它也是有的。这个事情你还得提前去验证一下。
-
-
市場變化的速度真快
4月 Qwen3.6-27B 本地不錯 => 買顯卡 (4月22日)
5月使用低價Deepseek-V4-Flash-Preview, 線上API便宜 => 本地不用了 (4月24日)
7月底 2026年7月31日推出 DeepSeek-V4-Flash 正式版 API 便宜 => 本地不用了
8月Qwen3.8-27B 本地不錯 => 買顯卡 (8月14日)
9月 DeepSeek-V4.1 Flash(9月10日), Codex5.6/6.0-Luna Max 線上API用不完 => 本地不用了
9月29日 Qwen3.8-Flash-NEXT 顯卡單卡8, 12, 16GB可以跑 => 買顯卡 -
-
youtube 上评论过了,这里也发下,算初来乍到点个卯
- 私有化模型需求,生图生视频需求。其实还可以租共享算力的,runpod 之类的平台,国内可能淘宝上在租的也有很多,我没用过不好说,只能说说 runpod的使用体验。支持容器化不用每次搭环境,支持 AWS 云存储你的容器,快速部署到你租的机器上,租机器按时长收费。一般个人,新入行,即便是生图生视频领域,完全可以先用这种方式试试水,租赁价格基本都比电费高不了多少,跑顺了有明确收益方向了再投资硬件不迟。而且用什么样的硬件配置,不同机器测试过之后,心里也稍微清楚点。毕竟买了之后要改要换更头疼。
- 买设备对商业工作室是个不错的投资。很少有生产资料投资之后,几乎无折旧的。花 10~20 个投入硬件,项目就算黄了,也就亏点电费和人力。真的挺划算。
-
-
市場變化的速度真快
4月 Qwen3.6-27B 本地不錯 => 買顯卡 (4月22日)
5月使用低價Deepseek-V4-Flash-Preview, 線上API便宜 => 本地不用了 (4月24日)
7月底 2026年7月31日推出 DeepSeek-V4-Flash 正式版 API 便宜 => 本地不用了
8月Qwen3.8-27B 本地不錯 => 買顯卡 (8月14日)
9月 DeepSeek-V4.1 Flash(9月10日), Codex5.6/6.0-Luna Max 線上API用不完 => 本地不用了
9月29日 Qwen3.8-Flash-NEXT 顯卡單卡8, 12, 16GB可以跑 => 買顯卡 -
-
錘哥想看 那我晚點整理一下基本資訊 ,
目前還在測試QFN (Qwen3.8-Flash-Next)的輸出品質表現
評估是否可以替代雙卡 NInfer-Qwen3.8-27B-NVFP4 Decode 100~140 tok/s (缺點是沒有 KV cache reuse, PP約3500 tok/s)現在機台上 兩張RTX 5070 Ti 16GB 各開一個 QFN on GPU0 and GPU1 + DSH
目前第一個作業通過了 QFN 的網頁設計有美感 我給過
目前正在進行 GPT-SOL and Astra 所出的極限考題測試, 想看看QFN的能耐 有比Qwen3.8-27B-NVFP4 or Q4_K_M 強嗎? -
-
-
-
市場變化的速度真快
4月 Qwen3.6-27B 本地不錯 => 買顯卡 (4月22日)
5月使用低價Deepseek-V4-Flash-Preview, 線上API便宜 => 本地不用了 (4月24日)
7月底 2026年7月31日推出 DeepSeek-V4-Flash 正式版 API 便宜 => 本地不用了
8月Qwen3.8-27B 本地不錯 => 買顯卡 (8月14日)
9月 DeepSeek-V4.1 Flash(9月10日), Codex5.6/6.0-Luna Max 線上API用不完 => 本地不用了
9月29日 Qwen3.8-Flash-NEXT 顯卡單卡8, 12, 16GB可以跑 => 買顯卡 -
@jlist
[strata] writing a tool call: write: 9731 of max 32000 tokens, 53.9 tok/s, 182 s
[strata] writing a tool call: write: 9795 of max 32000 tokens, 53.9 tok/s, 183 s
[strata] writing a tool call: write: 9851 of max 32000 tokens, 53.9 tok/s, 184 s
[strata] writing a tool call: write: 9915 of max 32000 tokens, 54.0 tok/s, 186 s
[strata] writing a tool call: write: 9977 of max 32000 tokens, 54.0 tok/s, 187 s可以了,我是5090 24G laptop。感觉不慢。跟我部的27b差不多,但是没有27b雷霆大思考。
-






 Qwen3.8-Flash-NEXT都能跑了。今天零度发视频了。github上

