跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 7900 XTX + Strata 0.1.27:全档位实测与 Prefill 调优

7900 XTX + Strata 0.1.27:全档位实测与 Prefill 调优

已定时 已固定 已锁定 已移动 精华 LLM讨论区
7900xtxstrataqwen-flash
20 帖子 9 发布者 1.5k 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • N
    N
    naniandemeng
    编写于 最后由 编辑
    #1

    Strata 0.1.27 · ROCm 10.0 · 256K 上下文 · 1K~256K 八档实测 + hipBLASLt Prefill 调优


    结论先行

    • AMD RX 7900 XTX(24GB)+ 64GB DDR3,跑 Qwen3.8-Flash-Next(125B MoE) IQ3_XXS
    • Prefill:峰值 1,602 tok/s,256K 超长 prompt 仍有 1,258 tok/s(读满 26 万 token 约 3.5 分钟)
    • Decode:16K 以内 ~84 tok/s;32K 以上掉到 48–64 tok/s(可调优,见文末)
    • hipBLASLt 调优:prefill 743 → 1179 tok/s(+58.7%),回退率 55.1% → 0%
    • 全程 ROCm / HIP,不是 NVIDIA

    一、配置

    项目 配置
    GPU AMD RX 7900 XTX 24GB(RDNA3 / gfx1100)
    后端 ROCm 10.0,HIP 本地编译
    CPU Xeon E5-2678 v3,12 核 24 线程(无 AVX-512)
    内存 64GB DDR3(X99 D3 主板)
    系统 Ubuntu 24.04.4 LTS
    模型 Qwen3.8-Flash-Next 125B MoE / Swift 1.5 微调 / IQ3_XXS 量化
    引擎 Strata 0.1.27(local-hip,gfx1100)

    启动脚本:

    #!/bin/sh
    cd "~/Strata-main"
    exec ".venv/bin/python" "serve/server.py" --engine strata \
      "--config" "strata-swift-iq3_xxs.json" "--port" "8080" "--open"
    

    引擎参数(strata-swift-iq3_xxs.json):

    {
      "exe": "~/Strata-main/engine/strata",
      "args": [
        "--pack", "~/Strata-data/packs/swift-iq3_xxs",
        "--native", "~/Strata-data/models/swift-IQ3_XXS/Swift-....gguf",
        "--ple-gguf", "~/Strata-data/models/swift-IQ3_XXS/Swift-....gguf",
        "--expert-profile", "~/Strata-main/data/expert-profile.bin",
        "--expert-cache", "auto",
        "--prefill", "auto",
        "--spec", "4",
        "--spec-min-p", "0.5",
        "--mtp", "~/Strata-data/mtp/rt",
        "--max-context", "262144",
        "--kv", "int8"
      ],
      "port": 8080,
      "backend": "hip",
      "api_key": "<你的 API key>",
      "env": {
        "STRATA_HIPBLASLT_TUNING": "~/Strata-main/tools/hip/gfx1100-hipblaslt-100401.txt"
      }
    }
    
    参数 作用
    --expert-cache auto 热专家驻 VRAM,其余留 RAM 由 CPU 算
    --prefill auto 自动选 prompt 分块(本机 8192 token)
    --spec 4 + --mtp MTP 投机解码,每轮最多草拟 4 token
    --max-context 262144 256K 上下文
    --kv int8 KV 用 int8,比 fp16 省一半显存

    二、实测结果

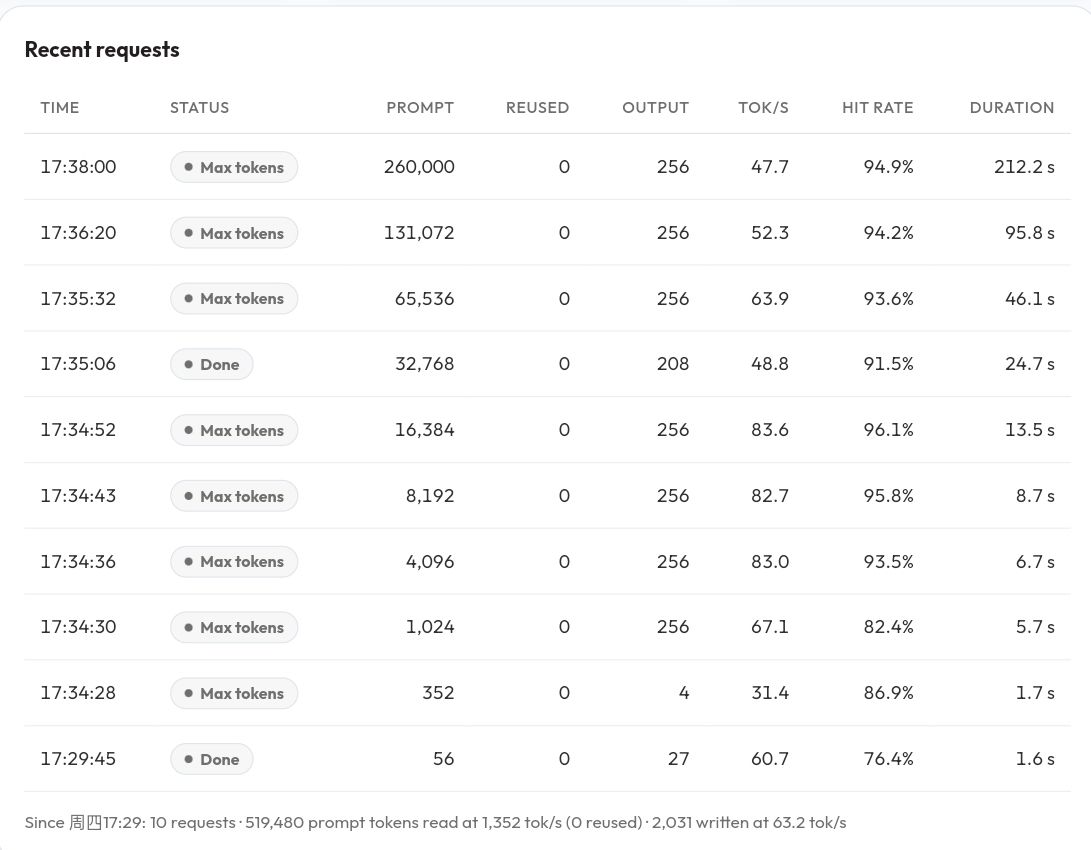
    方法:每档用全新随机 prompt(cache_n=0,真全量 prefill),固定生成 256 token,temperature=0,顺序执行。

    上下文 Prefill (tok/s) Decode (tok/s) 草稿接受率
    1K 555 67.1 95%
    4K 1,139 83.0 98%
    8K 1,453 82.7 91%
    16K 1,568 83.6 93%
    32K 1,602 48.8 58%
    64K 1,559 63.9 82%
    128K 1,442 52.3 65%
    256K 1,258 47.7 54%

    同配置跑两遍,prefill 偏差仅 ±0.2%(最大 1.9%),decode 偏差 ±1.4%。


    三、Prefill 调优(hipBLASLt)

    上面的 prefill 不是开箱就有的。 官方调优表版本是 100200,本机 hipBLASLt 是 100401,版本不等 → 引擎静默回退 hipBLASEx:

    prefill gemm: hipBLASLt version mismatch: file=100200 runtime=100401; using hipBLASEx
    

    用项目自带的 tools/hip/tune_hipblaslt.cpp 重新调优,三次迭代:

    迭代 做法 Prefill vs 基线
    基线 回退 hipBLASEx 743 tok/s —
    1 用调优器默认形状(仅 3 个) 835 tok/s +12.4%
    2 提取原表全部形状(15 个) 1,179 tok/s +58.7%
    3 VERBOSE=1 诊断真实负载,补 2 个盲区形状 回退率 55.1% → 0% 表扩到 34 行

    三个关键点:

    1. 迭代 1 是弯路:调优器默认只覆盖 3 个形状,其余的仍在回退。当时以为"+12% 就是全部",其实官方文档说的 +40–60% 是真的,是我的表不完整。
    2. 迭代 3 才是大头:跑 STRATA_HIPBLASLT_VERBOSE=1 才发现仍有 55.1% 的调用在回退,根因只是 f16 N=1280 K=2560(出现 528 次)等两个盲区形状。
    3. 查表是精确匹配:dtype/N/K/ldy 四项必须全等(只有 token 桶做最近邻),所以差一个维度就完全回退——必须用真实负载复查覆盖率。

    调优表不与模型绑定,只绑「GPU 架构 + hipBLASLt 版本」,所以换模型直接沿用,不用重调。
    decode 几乎不受影响(+2.8%):hipBLASLt 优化的是大 M 的 prefill,decode 瓶颈在专家路由与显存带宽。


    四、两个值得注意的现象

    1. Decode 在 32K 处有断崖,是因为 MTP 草稿窗口默认只有 32K

    16K 时 83.6 tok/s,32K 掉到 48.8,接受率从 93% 崩到 58%。原因是草稿层默认只看最后 32,768 个 cell,超出后"看不见"开头,草拟质量下降。

    加 --mtp-window 65536 复测:

    上下文 默认 32K 窗口 64K 窗口 提升
    32K 48.8 64.5 +32%
    128K 52.3 54.3 +4%
    256K 47.7 50.9 +7%

    显存代价几乎为零(MTP 层 +13 MiB,专家缓存 −10 槽位)。

    2. 上下文翻倍会吃掉专家缓存

    从 128K 改到 256K,KV 从 1.55 → 3.10 GiB,这部分直接从专家缓存扣:10,198 → 9,026 槽位(−11.5%)。后果是短 prompt 变慢(1K 档 prefill −25%),因为少掉的专家得让 CPU 算。


    五、总结

    一张 24GB 消费卡 + 64GB DDR3,跑 125B MoE:短上下文 83 tok/s、256K 长上下文仍有 47–64 tok/s,读 prompt 峰值 1,602 tok/s。

    两个最值得动手的优化:

    • --mtp-window 65536:长上下文 decode 白赚 7–32%,显存几乎零成本
    • hipBLASLt 调优:prefill +58.7%,且必须用 VERBOSE=1 复查覆盖率,否则会漏掉一半以上的回退

    实测环境:Ubuntu 24.04.4 / RX 7900 XTX 24GB / Xeon E5-2678 v3 / 64GB DDR3 / ROCm 10.0 / Strata 0.1.27 (HIP)

    参考:Strata(MIT,github.com/Niko1221/Strata)· Qwen/Qwen3.8-Flash-Next · ISTA-DASLab GSQ-RCO GGUF

    paul houP 1 条回复 最后回复
    1
    • N
      N
      naniandemeng
      编写于 最后由 编辑
      #2

      Screenshot_2026-10-01-18-07-50-12_82b10d9f3584360f08225ddcebbb4f6d.jpg

      1 条回复 最后回复
      0
      • ,N naniandemeng 引用了 此主题
      • terryT
        terryT
        terry
        超级版主
        编写于 最后由 编辑
        #3

        牛逼,xtx这张卡是玩出了花样

        油管:https://www.youtube.com/@抡锤者

        1 条回复 最后回复
        0
        • 6
          6
          6cccccc
          编写于 最后由 编辑
          #4

          好耶,刚好我也是无AVX-512

          1 条回复 最后回复
          0
          • K
            K
            kenshin
            编写于 最后由 编辑
            #5

            加油啊!!好期待。

            1 条回复 最后回复
            0
            • C
              C
              coin1860
              编写于 最后由 编辑
              #6

              mark,买了两个笔记本内存着,台式机,等着到货测试一下。现在用27B的模型。850 prefill,60 token感觉还不错

              N 1 条回复 最后回复
              0
              • C coin1860

                mark,买了两个笔记本内存着,台式机,等着到货测试一下。现在用27B的模型。850 prefill,60 token感觉还不错

                N
                N
                naniandemeng
                编写于 最后由 编辑
                #7

                @coin1860 可以部署试下,Strata现在版本迭代频繁,性能提升明显,prefill与decode速度很快并且很稳,基本不随上下文长度增加而大幅度衰减,reused率挺高,实用性很强

                1 条回复 最后回复
                0
                • ,terryT terry 固定了此主题
                • terryT
                  terryT
                  terry
                  超级版主
                  编写于 最后由 编辑
                  #8

                  这个帖子质量被低估了,讲的很好,回答了DDR3平台的问题,也回答了24G显存的能力。总体上64G RAM + 24G VRAM时个黄金搭配。AMD平台依然可以玩的很嗨。加精鼓励一次。

                  油管:https://www.youtube.com/@抡锤者

                  N 1 条回复 最后回复
                  0
                  • XiaoteX
                    XiaoteX
                    Xiaote
                    编写于 最后由 编辑
                    #9

                    ⭐ 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!

                    奖励凭证:精华 +5 分 · 编号 f2032-439-1(系统自动发放,显示稍有延迟)

                    老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                    1 条回复 最后回复
                    0
                    • terryT terry

                      这个帖子质量被低估了,讲的很好,回答了DDR3平台的问题,也回答了24G显存的能力。总体上64G RAM + 24G VRAM时个黄金搭配。AMD平台依然可以玩的很嗨。加精鼓励一次。

                      N
                      N
                      naniandemeng
                      编写于 最后由 编辑
                      #10

                      @terry 感谢认可,hipBLASLt 调优有相同部署的可以试下,收益很高。现在最新版本的Strata,我实测prefill可以到1700tok/s,并且调优表不与模型绑定,只绑「GPU 架构 + hipBLASLt 版本」,所以换模型直接沿用,不用重调。

                      1 条回复 最后回复
                      0
                      • nami ryuuN
                        nami ryuuN
                        nami ryuu
                        编写于 最后由 编辑
                        #11

                        @naniandemeng 问一下,你有没有感觉每次给模型发消息都像是最开始prefill那么慢,我的很慢,感觉每次给模型发消息,不管大小都是像是第一次给他system prompt是我哪设置的有问题吗?我cpu是9700x ,显卡7900xtx,内存96g ddr5 6000

                        N paul houP 3 条回复 最后回复
                        0
                        • C
                          C
                          coin1860
                          编写于 最后由 编辑
                          #12

                          我现在是b450m 32g ddr4 + 7900xtx , 看了楼主的帖子买了2条32g内存凑64g 还没到货

                          主要担心是双通道ddr4 + pcie3 x16 可能是prefile的瓶颈

                          楼主的x99 ddr3 是开了4通道么?用的内存频率是多少, ddr3 和pcie3 x16 都不是瓶颈那Strata的潜力确实很大, 否则光是买昂贵的ddr5 64g 就是一个不小的门槛。

                          N 1 条回复 最后回复
                          0
                          • long longL
                            long longL
                            long long
                            编写于 最后由 编辑
                            #13

                            strata真是神了,解决了我不会ubuntu的痛。可以windows使用是最大的优势!

                            1 条回复 最后回复
                            0
                            • nami ryuuN nami ryuu

                              @naniandemeng 问一下,你有没有感觉每次给模型发消息都像是最开始prefill那么慢,我的很慢,感觉每次给模型发消息,不管大小都是像是第一次给他system prompt是我哪设置的有问题吗?我cpu是9700x ,显卡7900xtx,内存96g ddr5 6000

                              N
                              N
                              naniandemeng
                              编写于 最后由 编辑
                              #14

                              @nami-ryuu 没有感觉慢,反应速度挺快,如果不是首轮,你看下你的reused数据怎么样

                              1 条回复 最后回复
                              0
                              • C coin1860

                                我现在是b450m 32g ddr4 + 7900xtx , 看了楼主的帖子买了2条32g内存凑64g 还没到货

                                主要担心是双通道ddr4 + pcie3 x16 可能是prefile的瓶颈

                                楼主的x99 ddr3 是开了4通道么?用的内存频率是多少, ddr3 和pcie3 x16 都不是瓶颈那Strata的潜力确实很大, 否则光是买昂贵的ddr5 64g 就是一个不小的门槛。

                                N
                                N
                                naniandemeng
                                编写于 最后由 编辑
                                #15

                                @coin1860 我是16x4,ddr3 1866,四通道

                                1 条回复 最后回复
                                0
                                • nami ryuuN nami ryuu

                                  @naniandemeng 问一下,你有没有感觉每次给模型发消息都像是最开始prefill那么慢,我的很慢,感觉每次给模型发消息,不管大小都是像是第一次给他system prompt是我哪设置的有问题吗?我cpu是9700x ,显卡7900xtx,内存96g ddr5 6000

                                  N
                                  N
                                  naniandemeng
                                  编写于 最后由 编辑
                                  #16

                                  @nami-ryuu 你可以让dsh帮你检查配置,调优有问题的话,把这个贴子丢给它,然后让它调优。

                                  1 条回复 最后回复
                                  1
                                  • N naniandemeng

                                    Strata 0.1.27 · ROCm 10.0 · 256K 上下文 · 1K~256K 八档实测 + hipBLASLt Prefill 调优


                                    结论先行

                                    • AMD RX 7900 XTX(24GB)+ 64GB DDR3,跑 Qwen3.8-Flash-Next(125B MoE) IQ3_XXS
                                    • Prefill:峰值 1,602 tok/s,256K 超长 prompt 仍有 1,258 tok/s(读满 26 万 token 约 3.5 分钟)
                                    • Decode:16K 以内 ~84 tok/s;32K 以上掉到 48–64 tok/s(可调优,见文末)
                                    • hipBLASLt 调优:prefill 743 → 1179 tok/s(+58.7%),回退率 55.1% → 0%
                                    • 全程 ROCm / HIP,不是 NVIDIA

                                    一、配置

                                    项目 配置
                                    GPU AMD RX 7900 XTX 24GB(RDNA3 / gfx1100)
                                    后端 ROCm 10.0,HIP 本地编译
                                    CPU Xeon E5-2678 v3,12 核 24 线程(无 AVX-512)
                                    内存 64GB DDR3(X99 D3 主板)
                                    系统 Ubuntu 24.04.4 LTS
                                    模型 Qwen3.8-Flash-Next 125B MoE / Swift 1.5 微调 / IQ3_XXS 量化
                                    引擎 Strata 0.1.27(local-hip,gfx1100)

                                    启动脚本:

                                    #!/bin/sh
                                    cd "~/Strata-main"
                                    exec ".venv/bin/python" "serve/server.py" --engine strata \
                                      "--config" "strata-swift-iq3_xxs.json" "--port" "8080" "--open"
                                    

                                    引擎参数(strata-swift-iq3_xxs.json):

                                    {
                                      "exe": "~/Strata-main/engine/strata",
                                      "args": [
                                        "--pack", "~/Strata-data/packs/swift-iq3_xxs",
                                        "--native", "~/Strata-data/models/swift-IQ3_XXS/Swift-....gguf",
                                        "--ple-gguf", "~/Strata-data/models/swift-IQ3_XXS/Swift-....gguf",
                                        "--expert-profile", "~/Strata-main/data/expert-profile.bin",
                                        "--expert-cache", "auto",
                                        "--prefill", "auto",
                                        "--spec", "4",
                                        "--spec-min-p", "0.5",
                                        "--mtp", "~/Strata-data/mtp/rt",
                                        "--max-context", "262144",
                                        "--kv", "int8"
                                      ],
                                      "port": 8080,
                                      "backend": "hip",
                                      "api_key": "<你的 API key>",
                                      "env": {
                                        "STRATA_HIPBLASLT_TUNING": "~/Strata-main/tools/hip/gfx1100-hipblaslt-100401.txt"
                                      }
                                    }
                                    
                                    参数 作用
                                    --expert-cache auto 热专家驻 VRAM,其余留 RAM 由 CPU 算
                                    --prefill auto 自动选 prompt 分块(本机 8192 token)
                                    --spec 4 + --mtp MTP 投机解码,每轮最多草拟 4 token
                                    --max-context 262144 256K 上下文
                                    --kv int8 KV 用 int8,比 fp16 省一半显存

                                    二、实测结果

                                    方法:每档用全新随机 prompt(cache_n=0,真全量 prefill),固定生成 256 token,temperature=0,顺序执行。

                                    上下文 Prefill (tok/s) Decode (tok/s) 草稿接受率
                                    1K 555 67.1 95%
                                    4K 1,139 83.0 98%
                                    8K 1,453 82.7 91%
                                    16K 1,568 83.6 93%
                                    32K 1,602 48.8 58%
                                    64K 1,559 63.9 82%
                                    128K 1,442 52.3 65%
                                    256K 1,258 47.7 54%

                                    同配置跑两遍,prefill 偏差仅 ±0.2%(最大 1.9%),decode 偏差 ±1.4%。


                                    三、Prefill 调优(hipBLASLt)

                                    上面的 prefill 不是开箱就有的。 官方调优表版本是 100200,本机 hipBLASLt 是 100401,版本不等 → 引擎静默回退 hipBLASEx:

                                    prefill gemm: hipBLASLt version mismatch: file=100200 runtime=100401; using hipBLASEx
                                    

                                    用项目自带的 tools/hip/tune_hipblaslt.cpp 重新调优,三次迭代:

                                    迭代 做法 Prefill vs 基线
                                    基线 回退 hipBLASEx 743 tok/s —
                                    1 用调优器默认形状(仅 3 个) 835 tok/s +12.4%
                                    2 提取原表全部形状(15 个) 1,179 tok/s +58.7%
                                    3 VERBOSE=1 诊断真实负载,补 2 个盲区形状 回退率 55.1% → 0% 表扩到 34 行

                                    三个关键点:

                                    1. 迭代 1 是弯路:调优器默认只覆盖 3 个形状,其余的仍在回退。当时以为"+12% 就是全部",其实官方文档说的 +40–60% 是真的,是我的表不完整。
                                    2. 迭代 3 才是大头:跑 STRATA_HIPBLASLT_VERBOSE=1 才发现仍有 55.1% 的调用在回退,根因只是 f16 N=1280 K=2560(出现 528 次)等两个盲区形状。
                                    3. 查表是精确匹配:dtype/N/K/ldy 四项必须全等(只有 token 桶做最近邻),所以差一个维度就完全回退——必须用真实负载复查覆盖率。

                                    调优表不与模型绑定,只绑「GPU 架构 + hipBLASLt 版本」,所以换模型直接沿用,不用重调。
                                    decode 几乎不受影响(+2.8%):hipBLASLt 优化的是大 M 的 prefill,decode 瓶颈在专家路由与显存带宽。


                                    四、两个值得注意的现象

                                    1. Decode 在 32K 处有断崖,是因为 MTP 草稿窗口默认只有 32K

                                    16K 时 83.6 tok/s,32K 掉到 48.8,接受率从 93% 崩到 58%。原因是草稿层默认只看最后 32,768 个 cell,超出后"看不见"开头,草拟质量下降。

                                    加 --mtp-window 65536 复测:

                                    上下文 默认 32K 窗口 64K 窗口 提升
                                    32K 48.8 64.5 +32%
                                    128K 52.3 54.3 +4%
                                    256K 47.7 50.9 +7%

                                    显存代价几乎为零(MTP 层 +13 MiB,专家缓存 −10 槽位)。

                                    2. 上下文翻倍会吃掉专家缓存

                                    从 128K 改到 256K,KV 从 1.55 → 3.10 GiB,这部分直接从专家缓存扣:10,198 → 9,026 槽位(−11.5%)。后果是短 prompt 变慢(1K 档 prefill −25%),因为少掉的专家得让 CPU 算。


                                    五、总结

                                    一张 24GB 消费卡 + 64GB DDR3,跑 125B MoE:短上下文 83 tok/s、256K 长上下文仍有 47–64 tok/s,读 prompt 峰值 1,602 tok/s。

                                    两个最值得动手的优化:

                                    • --mtp-window 65536:长上下文 decode 白赚 7–32%,显存几乎零成本
                                    • hipBLASLt 调优:prefill +58.7%,且必须用 VERBOSE=1 复查覆盖率,否则会漏掉一半以上的回退

                                    实测环境:Ubuntu 24.04.4 / RX 7900 XTX 24GB / Xeon E5-2678 v3 / 64GB DDR3 / ROCm 10.0 / Strata 0.1.27 (HIP)

                                    参考:Strata(MIT,github.com/Niko1221/Strata)· Qwen/Qwen3.8-Flash-Next · ISTA-DASLab GSQ-RCO GGUF

                                    paul houP
                                    paul houP
                                    paul hou
                                    德高望重 劳动模范
                                    编写于 最后由 编辑
                                    #17

                                    @naniandemeng

                                    感謝大神分享
                                    依相同方式調整 Strata 0.1.41版 + R9700 + 3700X + DDR4 3200 32G + IQ3_XXS
                                    實際工作,非AI測速
                                    看LOG自行計算,150K的PREFILL 1600左右
                                    DSH顯示的DECODE 平均值 68 ,峰值有出現130,最低大多50以上。

                                    1 条回复 最后回复
                                    0
                                    • ,系统 取消固定了此主题
                                    • nami ryuuN nami ryuu

                                      @naniandemeng 问一下,你有没有感觉每次给模型发消息都像是最开始prefill那么慢,我的很慢,感觉每次给模型发消息,不管大小都是像是第一次给他system prompt是我哪设置的有问题吗?我cpu是9700x ,显卡7900xtx,内存96g ddr5 6000

                                      paul houP
                                      paul houP
                                      paul hou
                                      德高望重 劳动模范
                                      编写于 最后由 编辑
                                      #18

                                      @nami-ryuu

                                      我的設備來說,跟27B+VLLM相比新會話一開始的速度相差滿多的
                                      一樣的DSH
                                      27B+VLLM -> 2~2.5秒就會開始工作
                                      STRATA -> 8~10秒才會開始工作,開頭約有4秒的時間,是完全無LOG的空轉,應該是還有很多優化的空間。

                                      N 1 条回复 最后回复
                                      0
                                      • paul houP paul hou

                                        @nami-ryuu

                                        我的設備來說,跟27B+VLLM相比新會話一開始的速度相差滿多的
                                        一樣的DSH
                                        27B+VLLM -> 2~2.5秒就會開始工作
                                        STRATA -> 8~10秒才會開始工作,開頭約有4秒的時間,是完全無LOG的空轉,應該是還有很多優化的空間。

                                        N
                                        N
                                        naniandemeng
                                        编写于 最后由 naniandemeng 编辑
                                        #19

                                        @paul-hou 我这边实测主要原因可能是DSH 的 system prompt + 工具 schema 实测 11,285 tokens,1287 t/s 下就是 8.8 s。发起新会话时,需要prefill系统提示词与工具 schema,这是没有缓存的,后续对话因为有缓存了所以会快。


                                        paul houP 1 条回复 最后回复
                                        0
                                        • N naniandemeng

                                          @paul-hou 我这边实测主要原因可能是DSH 的 system prompt + 工具 schema 实测 11,285 tokens,1287 t/s 下就是 8.8 s。发起新会话时,需要prefill系统提示词与工具 schema,这是没有缓存的,后续对话因为有缓存了所以会快。

                                          paul houP
                                          paul houP
                                          paul hou
                                          德高望重 劳动模范
                                          编写于 最后由 编辑
                                          #20

                                          @naniandemeng
                                          我看了一下是真的沒有任何log的4秒,也許是要清掉上一輪別的工作留下的上下文,我的prefill是在1600-2000之間。

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组