跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!

不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
rtx3090strataqwen-flash
103 帖子 27 发布者 4.3k 浏览 5 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Harvey KingH Harvey King

    @Prio 請問, 您HyperQuen 如何做到166 token/sec ? 我也是3090單卡 HyperQwen, 我的速度在40Tok/sec 上下 164k 上下文 多謝

    kos orK
    kos orK
    kos or
    超凡大师
    编写于 最后由 编辑
    #77

    @Harvey-King said:

    HyperQuen 如何做到166 token/sec

    HyperQwen 27B這麼快喔? 真可怕 怎麼突然間 TG 暴衝

    1 条回复 最后回复
    0
    • PrioP
      PrioP
      Prio
      编写于 最后由 编辑
      #78

      大佬们,为什么我单卡 3090 实测 130k 上下文到达 65k的时候,每秒decode 就只有 15-26token输出了,单卡3090 pice X3 16 ,ddr3 96gb ,x99平台

      johnnybegoodJ 1 条回复 最后回复
      0
      • PrioP Prio

        大佬们,为什么我单卡 3090 实测 130k 上下文到达 65k的时候,每秒decode 就只有 15-26token输出了,单卡3090 pice X3 16 ,ddr3 96gb ,x99平台

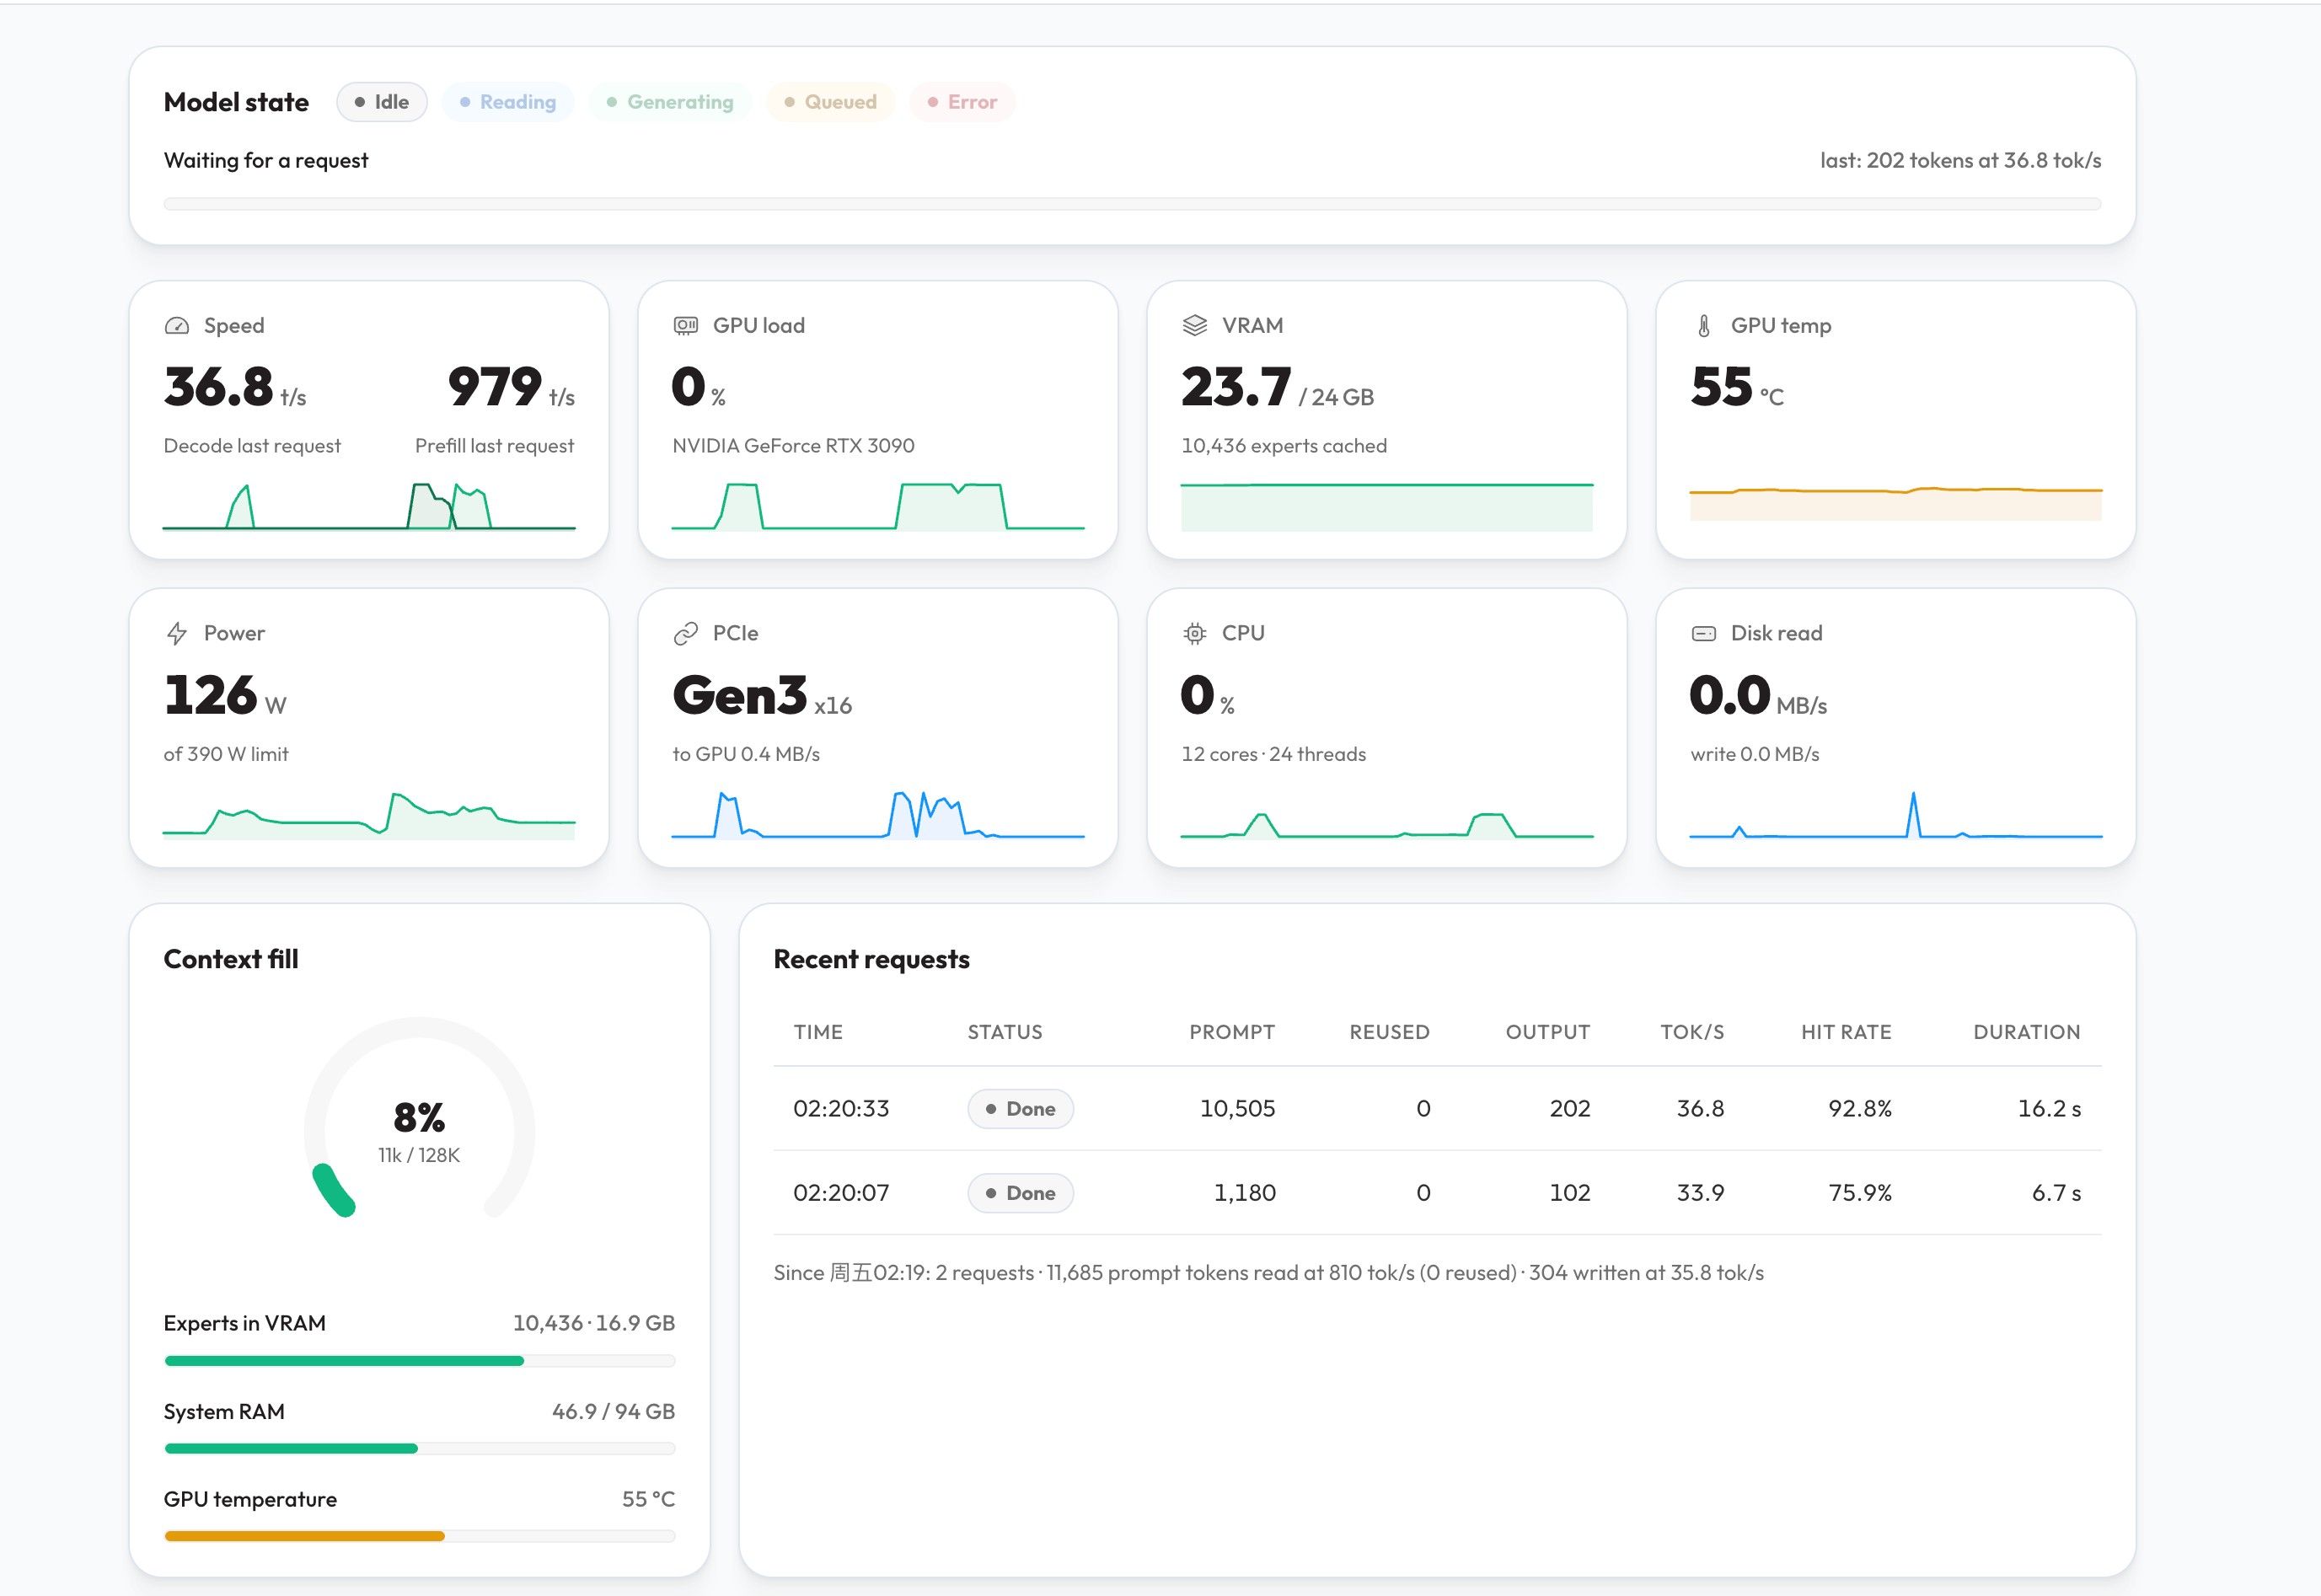
        johnnybegoodJ
        johnnybegoodJ
        johnnybegood
        超凡大师
        编写于 最后由 编辑
        #79

        @Prio 监测一下3090的温度和功率输出, 看看是不是撞了温度墙了

        PrioP 2 条回复 最后回复
        0
        • johnnybegoodJ johnnybegood

          @Prio 监测一下3090的温度和功率输出, 看看是不是撞了温度墙了

          PrioP
          PrioP
          Prio
          编写于 最后由 编辑
          #80

          @johnnybegood 温度正常66-70度,我在测试一下

          1 条回复 最后回复
          0
          • johnnybegoodJ johnnybegood

            @Prio 监测一下3090的温度和功率输出, 看看是不是撞了温度墙了

            PrioP
            PrioP
            Prio
            编写于 最后由 编辑
            #81

            @johnnybegood 启动命令如下:
            --expert-cache auto
            --prefill auto
            --spec 4
            --spec-min-p 0.5
            --mtp /data/mtp/rt
            --max-context 131072
            --kv int8
            --kv-resident 32768

            -e MODEL=IQ3_XXS
            -e FAMILY=swift
            -e CONTEXT=131072
            -e VISION=no
            -e GPU=0

            johnnybegoodJ 1 条回复 最后回复
            0
            • PrioP Prio

              @johnnybegood 启动命令如下:
              --expert-cache auto
              --prefill auto
              --spec 4
              --spec-min-p 0.5
              --mtp /data/mtp/rt
              --max-context 131072
              --kv int8
              --kv-resident 32768

              -e MODEL=IQ3_XXS
              -e FAMILY=swift
              -e CONTEXT=131072
              -e VISION=no
              -e GPU=0

              johnnybegoodJ
              johnnybegoodJ
              johnnybegood
              超凡大师
              编写于 最后由 编辑
              #82

              @Prio 这个软件都不用自己调启动参数啊, 下载下来有个 START_HERE.bat 直接在终端执行, 回答几个问题, 它自动都给你配好了自动起来啊

              PrioP 1 条回复 最后回复
              0
              • A
                A
                applejuice
                技术大牛 劳动模范
                编写于 最后由 applejuice 编辑
                #83
                Decode, code Decode, English Decode, Chinese chat Prefill 19K Prefill 89K
                Strata Flash-Next 125B 134.6 t/s 91.1 88.8 2,613 t/s 3,661
                SGLang Swift 1.5 273.2 t/s 117.0 76.3 3,019 t/s 2,018

                让claude 设置了
                还没真正用上

                这个是可以用的速度
                而且长上下文没影响

                PrioP 1 条回复 最后回复
                0
                • A applejuice
                  Decode, code Decode, English Decode, Chinese chat Prefill 19K Prefill 89K
                  Strata Flash-Next 125B 134.6 t/s 91.1 88.8 2,613 t/s 3,661
                  SGLang Swift 1.5 273.2 t/s 117.0 76.3 3,019 t/s 2,018

                  让claude 设置了
                  还没真正用上

                  这个是可以用的速度
                  而且长上下文没影响

                  PrioP
                  PrioP
                  Prio
                  编写于 最后由 编辑
                  #84

                  @applejuice 你这是双卡?

                  A 1 条回复 最后回复
                  0
                  • PrioP Prio

                    @applejuice 你这是双卡?

                    A
                    A
                    applejuice
                    技术大牛 劳动模范
                    编写于 最后由 编辑
                    #85

                    @Prio 双卡

                    1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

                      @Prio 这个软件都不用自己调启动参数啊, 下载下来有个 START_HERE.bat 直接在终端执行, 回答几个问题, 它自动都给你配好了自动起来啊

                      PrioP
                      PrioP
                      Prio
                      编写于 最后由 编辑
                      #86

                      @johnnybegood
                      image.jpeg

                      重新安装,让他自己调参数也是死,我明天重新看看

                      1 条回复 最后回复
                      0
                      • PrioP Prio

                        Harvey-King 说:

                        @Prio 請問, 您HyperQuen 如何做到166 token/sec ? 我也是3090單卡 HyperQwen, 我的速度在40Tok/sec 上下 164k 上下文 多謝

                        你可以设置 HyperQwen项目的long的启动模式,然后需要开启加速,然后关闭思考可以达到166token,开启思考有100token, 上下文150k。

                        我的启动命令如下:
                        ai-server:~$ cd ~/HyperQwen && grep -E '^(SPEC|CTX|PREFIX_CACHE|MODEL|MAX|GPU|PORT|TP|QUANT)' .env
                        SPEC=dflash2
                        CTX=long
                        PREFIX_CACHE=1
                        MODEL=/app/models/Qwen3.8-27B-Uncensored-W4A16-AutoRound

                        SPEC=dflash2 速度最快,

                        SPEC=mtp 速度慢

                        Harvey KingH
                        Harvey KingH
                        Harvey King
                        编写于 最后由 Harvey King 编辑
                        #87

                        @Prio 謝謝

                        我之前也在ctx=long 還是 huge 糾結, 結果我是接Hermes驛神外掛Deepseek 做了比較, 結果發現 ctx=long 快不少。
                        我用的是thinking=low.

                        我好奇的是: 我之沒有用Dflash2的原因是因爲他對顯存的要求比較高, 我不認爲我塞得下。 我目前的gpu util 是0.94, 再往上拉就會爆(OOM).
                        請問, 你的併發是多少, 還是你沒開併發? 您的KV 等 Quant用得是?

                        我會拿你的參數回去試試。

                        我的參數如下:
                        • CPU: 2× Intel Xeon E5-2620 v3 @ 2.40 GHz
                        • RAM: 96 GB DDR4-2133 ECC
                        • Inference GPU: RTX 3090 24 GB (single card, PCIe 3.0 ×16)

                        Serving stack (syv-qwen38, vLLM 0.29.0 / syv-ai image 1cf8665)
                        • Model: Qwen3.8-27B-W4A16-AutoRound (dbirks checkpoint)
                        • Quantization: W4A16 = int4 weights (Intel AutoRound) + FP16 activations
                        • Activation quant: INT8_ACT=int8, INT8_LAYERS=mlp
                        • Speculative decode: SPEC=mtp, DRAFT_TOKENS=3 (built-in MTP draft head)
                        • KV cache: FP16, KVARN_POOL_MEM_FRAC=0.15 (tail-pool budget for 4 request slots)
                        • Vision: VISION=1 + VISION_OFFLOAD=1 (vision tower on, offloaded to CPU)
                        • Context: CTX=long, MAX_LEN=164000
                        • Prefix cache: PREFIX_CACHE=1
                        • Scheduling: MAX_SEQS=5, GPU_UTIL=0.94, ASYNC_SCHED=1
                        • Tools: TOOLS=1, TOOL_PARSER=qwen3_coder

                        我把3090的功率限制在265瓦。 但這貌似不是問題。 大部份的時候3090功耗在170瓦上下徘迴...

                        1 条回复 最后回复
                        0
                        • tom23T
                          tom23T
                          tom23
                          编写于 最后由 编辑
                          #88

                          比较大的突破,个人主机也可以跟上线上大模型了

                          1 条回复 最后回复
                          0
                          • A
                            A
                            applejuice
                            技术大牛 劳动模范
                            编写于 最后由 applejuice 编辑
                            #89

                            跑了 一个 20分钟的任务
                            3.8 flash 模型想很多
                            刚好昨天用3.8 27b 跑一轮 结果不理想
                            今天3.8 flash 的确达成目的

                            Metric Value
                            Duration 19.5 min (10:34:02 → 10:53:32)
                            Requests 47
                            Tool calls 46
                            Final answers 1
                            Context, first → last request 43,886 → 117,415 tokens
                            Output tokens, total 97,134
                            Engine busy 1,058 s (≈ 90% of the session)
                            Tool time on the client ≈ 112 s (≈ 10%)
                            Errors, cancelled requests, malformed tool calls 0

                            Decode speed (per request, all 47)

                            Statistic t/s
                            p10 97.3
                            Median 100.9
                            Mean 104.9
                            p90 116.7
                            Min / max 95.4 / 121.9
                            Requests with 500+ output tokens (n = 27), median 99.4

                            Output length per request

                            Statistic Tokens
                            p10 145
                            Median 1,127
                            Mean 2,066
                            p90 5,161
                            Max 7,654

                            Prefill

                            Kind of read New tokens Time Rate
                            First request (cold) 43,886 ~15 s ~2,900 t/s
                            Large addition (file read) +6K to +16K ~4 s —
                            Typical turn (110-117K conversation) +486 to +1,332 0.65-1.4 s dominated by the fixed start-up of ~0.5-1 s

                            GPU expert cache

                            Statistic Hit rate
                            Median 99.5%
                            Min 98.2%

                            System load

                            Metric Busy mean Busy max Idle mean
                            CPU usage 39.8% 50.4% 13.5%
                            CPU threads > 50% busy (of 64) 30.1 32 8.0
                            RAM used 49.97 GB 50.11 GB 49.98 GB
                            GPU metric GPU0 busy mean GPU0 max GPU1 busy mean GPU1 max
                            --- --- --- --- ---
                            Utilisation 41.0% 100% 56.7% 100%
                            Power 235.9 W 244.5 W 246.8 W 265.5 W
                            SM clock 1,864 MHz 1,920 MHz 1,798 MHz 1,905 MHz
                            Core temperature 65.2 °C 67 °C 65.9 °C 67 °C
                            Hotspot 78.7 °C 80 °C 82.9 °C 85 °C
                            1 条回复 最后回复
                            0
                            • A
                              A
                              applejuice
                              技术大牛 劳动模范
                              编写于 最后由 编辑
                              #90

                              这个引擎最大的的问题就只能单发

                              johnnybegoodJ 1 条回复 最后回复
                              1
                              • A applejuice

                                这个引擎最大的的问题就只能单发

                                johnnybegoodJ
                                johnnybegoodJ
                                johnnybegood
                                超凡大师
                                编写于 最后由 编辑
                                #91

                                @applejuice 更新的很快的,早晚什么都有,这就是ai vibe coding的好处,当然也有点可怕

                                1 条回复 最后回复
                                0
                                • ,Data WuD Data Wu 引用了 此主题
                                • Quanta MagicQ Quanta Magic

                                  @deadnessking 坐等你的4080s 结果, 是32g 魔改版吗? 我也在考虑这张

                                  D
                                  D
                                  deadnessking
                                  编写于 最后由 编辑
                                  #92

                                  @Quanta-Magic 4080s 32g魔改版,decode巅峰100左右,prefill在128k左右可以达到巅峰3700,用的是IQ3_S。不过我那个是服务器,256g内存随便浪

                                  1 条回复 最后回复
                                  0
                                  • abenzhuA abenzhu

                                    Strata 复现报告
                                    目标:单卡 RTX 3090 + Xeon E5-2680 v4 + 128GB 4ch DDR4-2400 · Swift-1.5 Qwen3.8-Flash-Next IQ3_XXS (76GB) · 引擎 Strata 0.1.21 · 2026-09-29

                                    结论:复现成功。 Strata 跑出稳态 decode ~71 tok/s、prefill 618.5 tok/s, 相比同机 llama.cpp 的 11.18 tok/s,decode 提升 6.4×。官方对 RTX 3090 + IQ3_XXS 的短上下文估算约 103–106, 但那是基于 Ryzen 5 7600 + DDR5-5200 的外推(±20%);本机 ~71 约低 30%,差距在主机侧(CPU/内存,见第 4 节)。
                                    71.7
                                    Strata decode(tok/s,稳态)
                                    差分法,隔离 prefill/首 token
                                    6.4×
                                    vs llama.cpp decode
                                    11.18 → 71.7 tok/s
                                    618.5
                                    Strata prefill(tok/s)
                                    llama.cpp 481.4,1.29×

                                    wei DaiW
                                    wei DaiW
                                    wei Dai
                                    编写于 最后由 编辑
                                    #93

                                    @abenzhu 我是V100 32G+E5-2686 V4+256G DDR4 2133.跑wen3.8-Flash-Next IQ3_XXS,我只跑到18token左右,还不如llama.cpp+Q4,两者速度一样。纠结死我了。

                                    terryT 1 条回复 最后回复
                                    0
                                    • wei DaiW wei Dai

                                      @abenzhu 我是V100 32G+E5-2686 V4+256G DDR4 2133.跑wen3.8-Flash-Next IQ3_XXS,我只跑到18token左右,还不如llama.cpp+Q4,两者速度一样。纠结死我了。

                                      terryT
                                      terryT
                                      terry
                                      超级版主
                                      编写于 最后由 编辑
                                      #94

                                      @wei-Dai 这卡没有BF16,很多原生技术都不支持,以后新模型越来越不能玩,买个7900xtx或者3090吧。

                                      油管:https://www.youtube.com/@抡锤者

                                      wei DaiW 1 条回复 最后回复
                                      0
                                      • terryT terry

                                        @wei-Dai 这卡没有BF16,很多原生技术都不支持,以后新模型越来越不能玩,买个7900xtx或者3090吧。

                                        wei DaiW
                                        wei DaiW
                                        wei Dai
                                        编写于 最后由 编辑
                                        #95

                                        @terry 我是DELL R730服务器,机器丢在公司,不怕声音大,我一直都是RDP连接的。所以V100 32G这张卡对我来说是性价比最高的卡。我跑27B模型,Q4-K-M+220K上下文,输出能到40T/S,我用得不错。

                                        1 条回复 最后回复
                                        1
                                        • T
                                          T
                                          tszhoill
                                          编写于 最后由 编辑
                                          #96

                                          跑IQ3_S 的速度怎麼樣, 3090 96gb,但無論reasoning low or Medium 都是30-40t/s

                                          PrioP johnnybegoodJ 2 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组