
Qwen3.8-Flash-Next(176B MoE)單卡 72GB 實測 —— Strata NVFP4 引擎完整數據
-
大家好,之前一直做CD-rom。這是我第一篇的文章。
我今天測試了strata,以下是測試報告。一、測試環境
項目 規格 GPU NVIDIA RTX PRO 5000 72GB Blackwell(compute capability 12.0 / sm_120) CPU AMD Ryzen 9 9950X3D(16C/32T,AVX-512) RAM 96 GB(實測可用 93.6 GB)DDR5 儲存 NVMe SSD(模型) 驅動 616.92(CUDA UMD 13.4) OS Windows 11
二、安裝(完全不需要編譯)
用的是
sergqwer/strata-nvfp4的 release bundle —— 422 MB,已內嵌 CUDA 13.3 runtime + cuBLAS,不用裝 CUDA Toolkit:# 1. 下載 bundle(release zip 已含 strata.exe) curl -sL -o bundle.zip https://github.com/sergqwer/strata-nvfp4/releases/download/v0.1.28-nvfp4.4/strata-nvfp4-v0.1.28-nvfp4.4-windows-x64.zip python -c "import zipfile; zipfile.ZipFile('bundle.zip').extractall('.')" cd strata-nvfp4 # 2. 一鍵準備模型(7 步,可斷點續跑) cmd.exe /c prepare-model.cmd # 3. 起 server cmd.exe /c start-server.cmdprepare-model.cmd會建立自己的 venv、下載 126 GB checkpoint、然後跑完 7 個轉換步驟:產出檔案 大小 checkpoint\(來源,可刪)126 GB ple-fp8.gguf(n-gram 表,FP8)48 GB orca-nvfp4.gguf(NVFP4 權重)69 GB pack\experts.bin(expert arena)64 GB token-embd-bf16.gguf1.2 GB mmproj-f32.gguf(vision tower)1.7 GB mtp\rt\experts.bin(draft head)675 MB 126 GB 下載實測 43 分鐘(我這邊沒裝
hf_xet,fallback 到普通 HTTP)。完成後models\約 317 GB,其中checkpoint那 126 GB 可以刪掉。Large pages(建議開)
powershell -ExecutionPolicy Bypass -File tools\enable-large-pages.ps1   # 需要 admin
# 之後一定要登出再登入,或重新開機
小提醒:我第一次跑
secedit回傳 exit 1 失敗,再跑一次就 exit 0 成功。看到 exit 1 就再執行一次。效果:冷載入從 26.6s(4KB 分頁)降到 18.8s(2MB 大頁)。
三、實測數據
3.1 Decode / Prefill
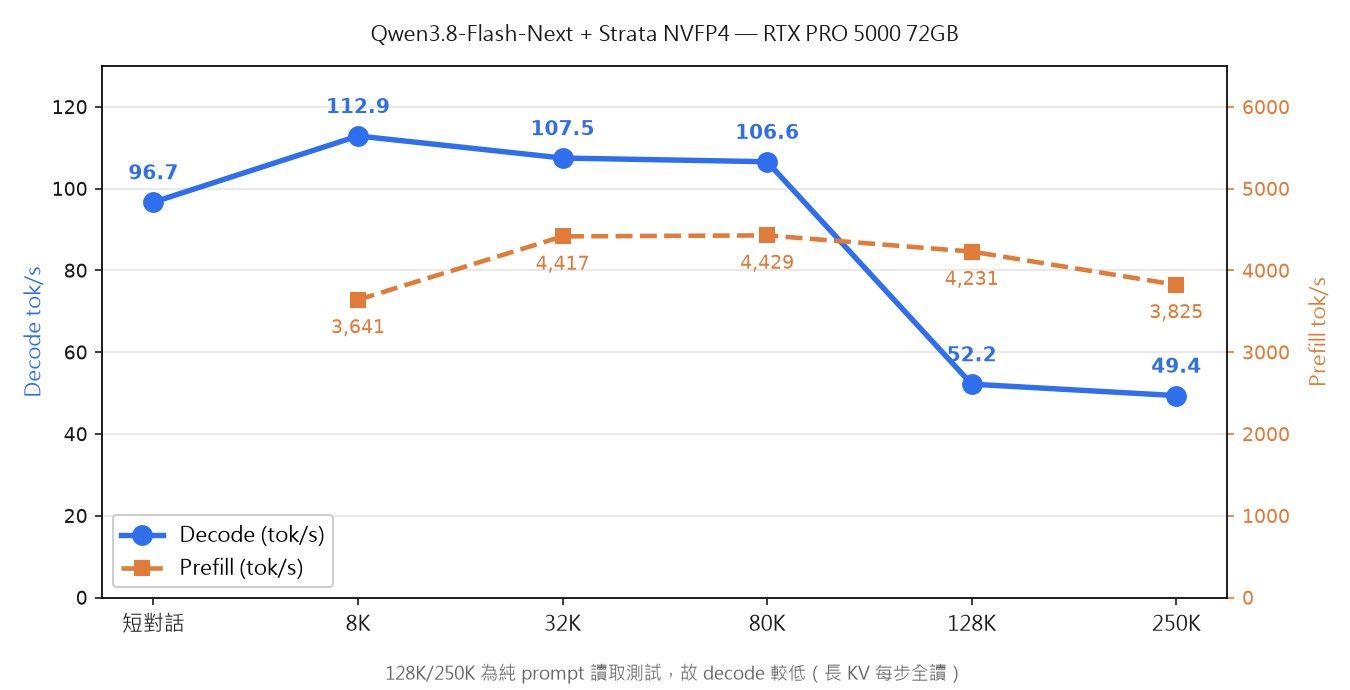
Decode 場景 結果 短對話(冷) 96.7 tok/s 穩定輸出 1000 tokens 91.2 tok/s(10.96 ms/token) ~8K context 112.9 tok/s ~32K context 107.5 tok/s ~80K context 106.6 tok/s Prefill 結果 --- ---: ~8K 3,531 – 4,087 tok/s ~32K 4,417 – 5,069 tok/s ~80K 4,429 – 5,074 tok/s (官方在 RTX 5090 32GB + 128GB RAM 上測到約 115 tok/s,我這邊數字相當)
3.2 資源佔用
數值 VRAM 69.0 / 73.4 GB Expert cache 21,278 slots / 54.79 GiB Expert cache 命中率 98.3 – 99.9%(每個 request) RAM 84.6 / 93.6 GB(63.28 GiB arena pinned) Commit 155 / 189.6 GB 冷載入 18.8 秒(大頁) 對照:RTX 5090 32GB 只有 7,352 slots,這張卡有 21,278 slots(2.9×)。不過實際 decode 速度差不多——5090 的記憶體頻寬(GDDR7)抵銷了 cache 較小的劣勢。
3.3 長 context
prompt Prefill 首 token Decode 28,905 tok(~32K) 4,685 tok/s 6.2s 66.4 tok/s 121,479 tok(~128K) 4,231 tok/s 28.7s 52.2 tok/s 235,870 tok(~250K) 3,825 tok/s 36.6s 49.4 tok/s 上限
--max-context 262144。decode 會隨 context 變長而下降(66 → 52),因為每步都要讀完整 KV。3.4
 ️ 並行 —— 這是單流引擎
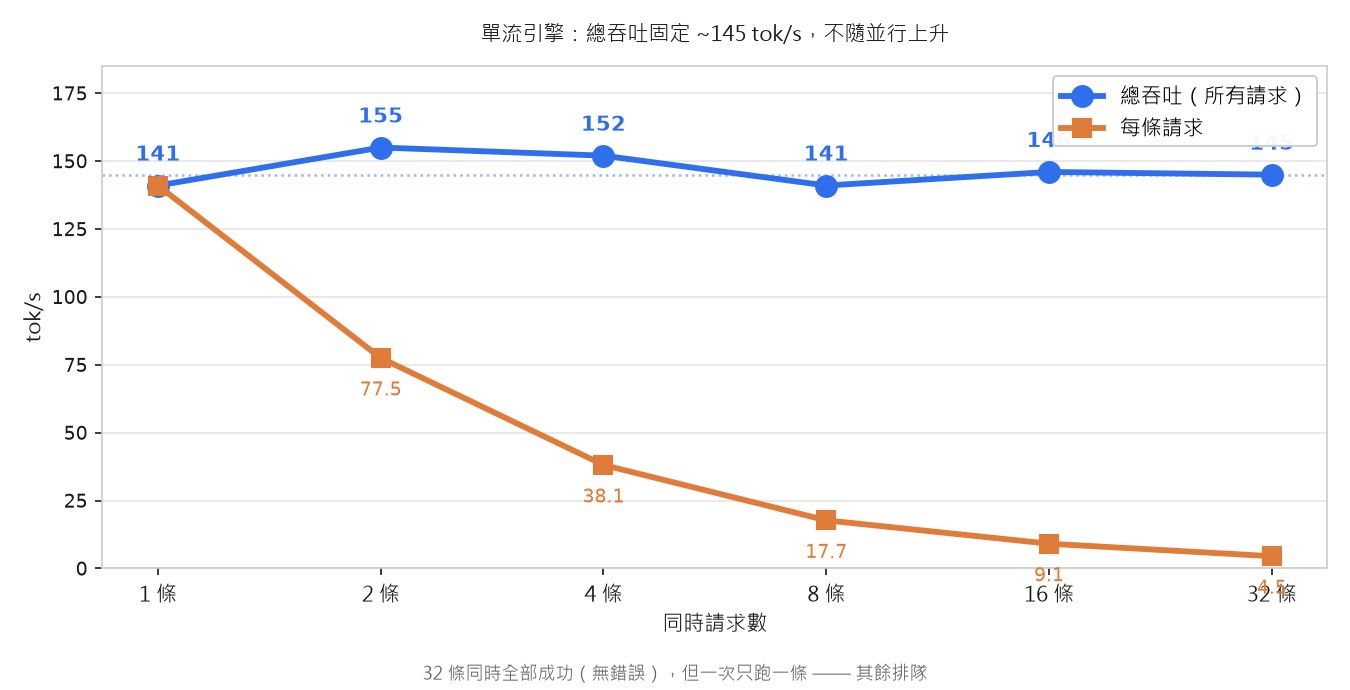
這點很多人在意,我實測了完整的 1→32 並行:
同時 N 條 總吞吐 每條實際 成功 1 141 tok/s 141 1/1 2 155 77.5 2/2 4 152 38.1 4/4 8 141 17.7 8/8 16 146 9.1 16/16 32 145 4.5 32/32 總吞吐一直維持在 ~145 tok/s,完全不隨並行數上升。 收多少 client 都可以(32/32 零錯誤),但一次只跑一條。
證明是排隊而不是 batching:同時丟 3 個 128K prompt,完成時間是 29.6s / 58.2s / 86.8s——一個接一個。如果是 batched 會差不多時間一起完成。
我自己一開始量錯過:把每個 request 自報的
decode_tok_s相加,得到「4 條 365 tok/s」的錯誤數字。正確做法是 wall-clock:總 output tokens ÷ 總 wall time。3.5 Prefix cache —— 同一個 session 極快,兩個 session 互相沖掉
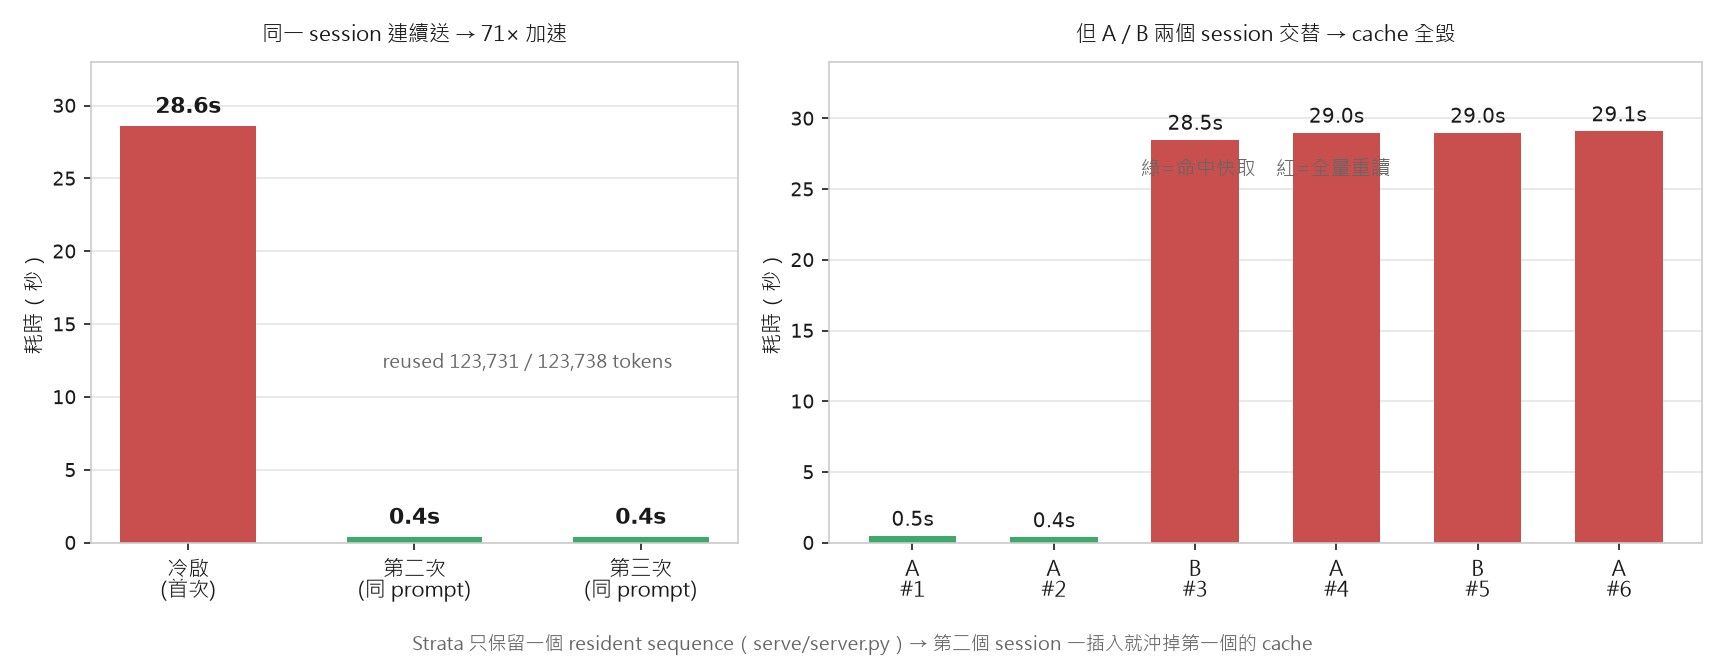
這是我覺得最值得分享的發現。
同一個 prompt 連送三次:
次數 耗時 reused read 1(冷) 28.6s 0 123,738 2 0.4s 123,731 7 3 0.4s 123,731 7 → 28.6s → 0.4s(71×)。Prefix cache 是有效的,而且很強。
但是——A / B 兩個不同 session 交替時:
步驟 agent 耗時 reused 1 A 0.5s 123,731 2 A 0.4s 123,731 3 B 28.5s 0 4 A 29.0s 0 5 B 29.0s 0 6 A 29.1s 0 原因寫在
serve/server.py開頭:"One sequence at a time behind a FIFO (plan: one resident sequence)"
只 cache 一個 resident sequence,所以 B 一插入就沖掉 A 的 cache。
→ 實務結論:跑兩個長 context 的 coding agent 時,兩邊每一輪都要重讀全部 context(~29s)。 不是「慢一半」,是兩邊都變慢 70 倍。
context 每輪 prefill(兩個 agent 交替) 130K ~29s 60K ~14s 30K ~7s 3.6 Vision(讀圖)
圖片 image tokens 耗時 讀對? 256×256 66 1.1s 
1024×768 770 5.8s 1920×1080 1,010 8.1s 3840×2400 1,002 8.1s image token 上限約 1,024/張 → 4K 圖和 1080p 一樣貴。
時間瓶頸是 CPU 圖像編碼,不是 LLM。 證據:64 張 frame 共 14,234 tokens,引擎實際只花 3.6 秒讀完,但總耗時 86.1 秒——其中約 82 秒是 CPU 編碼。編碼吞吐約 130–175 image-tokens/s。
準確度測試(我自己畫的圖表,含標題、四個數值、一組 REF code):6/6 全對。
️ 一個 request 上限 64 張圖——超過會失敗。這是 server 的 bug,不是硬體限制:# serve/server.py 第 496 行 — vision embedding cache if len(self.cache) > 64: old = next(iter(self.cache)) self.cache.pop(old)[0].unlink(missing_ok=True) # 刪掉 .sve 檔 # 但第 771/789 行是「先全部 encode,之後才讀檔」 encoded = [self.vision.encode(src) for src in images] for path, _ in encoded: f.write(path.read_bytes()) # FileNotFoundError:已被驅逐超過 64 張時,最前面那批
.sve會在後續 encode 時被驅逐刪掉。Server 不會掛,下一個 request 正常。context 本身不是瓶頸(262,144 ÷ 770 ≈ 340 張)。3.7
STRATA_PREFILL_NVFP4調校:w4a8 vs w4a4context w4a8(預設)w4a4提升 ~8K 3,641 4,087 +12.2% ~32K 4,417 5,069 +14.8% ~80K 4,429 5,074 +14.6% 但代價(官方
docs/NVFP4.md,first-token KL vs fp16):mode KL mean top-1 一致率 w4a8 0.0018 8/8 w4a4 0.0080(差 4.5×) 7/8 只快 prefill,decode 完全一樣。 檢索能力我也實測過(needle-in-haystack 6/6、5 針一次問齊 5/5,兩個模式都過)。
→ 建議保留預設
w4a8。3.8 長 context 品質驗證
很多人問「接近 260K 會不會變笨/失憶」,我實測了:
測試 2K 32K 128K 200K 250K 單針檢索(深度 10/50/90%) — 3/3 3/3 3/3 3/3 5 針一次問齊 — — — — 5/5 多跳推理(兩個事實隔 90% 距離要組合) 多跳推理是關鍵測試(retrieval 測不出「變笨」):兩個事實分別插在 5% 和 95% 的位置,答案是
VELMORA-7719,從 2K 到 250K 完全一致。不會變笨。 原因:262,144 是原生訓練窗口(不是 YaRN 外推),而且模型有 QSA sparse attention + indexer budget。
順帶一提:Strata 曾經有一個真正的長 context bug——RoPE 用 fast-math 角度,在 262K 時差約 0.02 rad。已修(改用 float64 angle table)。
3.9
️ 但有一個硬牆:~245.7Kprompt + max_tokens ≤ 262,136 (max_context 262144 − CTX_SLACK 8)prompt 最多可出 若 client 要 16384 230K 32,136 245K 17,136 ← 轉折點 ≈ 245,752250K 12,136  HTTP 400
260K 2,136 超過的錯誤訊息:
"prompt (N tokens) + max tokens (M) exceeds the context (262144); requests are never truncated"過去的話不是「慢慢變笨」,是 session 直接壞死(每個 call 都 400)。
四、模型大小 / 量化
Flash-Next 跟一般 dense 模型不一樣——不能只挑一個 Q4/Q8 檔:
176B = 125B backbone + 51B n-gram 表 + 4B MTP,而那個表的大小不隨量化縮小(GGUF 版固定 26.85 GiB IQ4_NL/Strata 版 48 GB FP8)。
級別 磁碟總計 其中 n-gram 表 GPU 必需 BF16(原始) 329.7 GiB — 裝不下 FP8 172.8 GiB 47.7 裝不下 72GB 卡 Q8_0(GGUF) 174.65 GiB ~26.9 ~148 UD-Q4_K_XL 103.68 26.85 76.82 UD-IQ4_XS 87.24 26.85 60.38 UD-IQ3_XXS 76.32 26.85 49.47 UD-IQ1_S(最小) 67.55 26.85 40.70 範圍 67.55 → 329.7 GiB(4.9×);對比 27B 的 15.66 → 27.05 GB(1.7×)。差距窄是因為那張 26.85 GiB 的表佔最小版本的 40%。
我目前跑的 NVFP4 ≈ 4.5-bit,工作集約 184 GB(表 48 GB + 權重 69 GB + arena 64 GB),但 VRAM 常駐只需 69 GB——因為 experts 放 RAM、表串流自 SSD。
量化對輸出的影響
官方(unsloth)對 Qwen3.8 做的 NVFP4 vs BF16 實測:
領域 KLD mean top-1 一致率 中文 0.0163 93.55% 程式碼 0.0260 96.68% 閒聊 0.0582 92.15% → NVFP4 保留約 92–97% 的 BF16 品質(寫程式最抗跌)。
而 1-bit 家族(KLD 0.56–1.11)比 NVFP4 差 10–20 倍,top-1 掉到 66–79%。過 4-bit 之後就開始急墮。
另外這個 checkpoint 的 model card 寫明:NVFP4 只量化 routed experts,attention、Gated-DeltaNet、router、shared experts、hyper-connections、PLE、embeddings、LM head、MTP 全部保留高精度。這是「保護好所有關鍵模組、只壓縮大宗 FFN」的配方——尤其 router 不量化對 MoE 至關重要。
五、實測踩過的坑
- thinking 預設開啟——Qwen3.8 會先輸出
reasoning_content,可能吃光max_tokens讓content變 null。要關就送chat_template_kwargs: {enable_thinking: false} enable-large-pages.ps1第一次可能 exit 1 → 再跑一次fit_max_tokens是 server 層設定——一開全機所有 client 都受影響。我沒有開,因為:① 我的 harness 會在 0.8 × contextWindow ≈ 209.7K 自動 compact,距離 245.7K 硬牆有約 36K 餘裕;② clamp 會把「寫檔案/JSON/tool call」的答案剪短,產生半截檔案——比一個明確的 400 更危險
六、結論
數值 Decode 91–113 tok/s(短→8K context) Prefill 4.4–5.1K tok/s VRAM 常駐 69 GB(單卡 72GB 可跑) Expert cache 21,278 slots,98–99.9% 命中 冷載入 18.8 秒 250K context 可用,品質零退化 並行 ️ 單流,總吞吐固定 ~145 tok/sPrefix cache ️ 同 session 71× 加速,兩個 session 互相沖掉適合:
- 單一重型 session(長 context、要品質、要離線)
- 需要 250K context 又不想上雲
不適合:
- 多個 agent 並行(會互相沖掉 prefix cache,每輪 ~29s)
- 需要同時跑其他 GPU 工作
在 72GB 單卡上,這是我目前找到最好的 Flash-Next 方案。官方在 5090 32GB 測到約 115 tok/s,這張卡因為 VRAM 大了一倍多,expert cache 多 2.9 倍(21,278 slots),但受限於單流架構,實際吞吐相當。
結論:這是目前少數能在 72GB 單卡上跑,同時又保有 MTP speculative decoding 的 Flash-Next 路線。
TL;DR
- RTX PRO 5000 72GB 單卡可跑,完全不必編譯(release bundle 已內含 CUDA runtime)
- Decode 91–113 tok/s、Prefill 4.4–5.1K tok/s、VRAM 常駐 69 GB
- 250K context 可用,且品質零退化(含多跳推理)
- ️ 單流引擎:總吞吐固定 ~145 tok/s,開再多 client 只會排隊
- ️ Prefix cache 同一個 session 有 71× 加速,但兩個 session 會互相沖掉(每輪 ~29s)
- ️ 硬牆在 ~245.7K(
prompt + max_tokens ≤ 262,136),超過直接 HTTP 400
- thinking 預設開啟——Qwen3.8 會先輸出
-
-
-
第一次发帖就是这种完整度的实测,感谢分享。几点可复现性上的建议:
- decode 段固定 batch=1、ctx(建议 8K 与 32K 各一条)与 KV dtype 再对比;MoE 的 decode 主要吃权重带宽和 expert 命中率,只看总 t/s 不好归因。
--spec(投机)关闭/开启各跑一遍,才能把「NVFP4 引擎收益」和「投机收益」拆开。- Windows 那个 release bundle 内嵌了 CUDA runtime,跟驱动 616.92 是两套版本;换驱动后建议重测一次,排除 runtime/driver 差异。
如果方便,把 prefill/decode、ctx、量化与 spec 参数列成一张表,后面别人复现会容易很多。
-
-
我是8月才買的電腦,一開始是用qwen3.8 27b,用sglang可以同一時間跑3個agent+comfyui qwen image 2.1都有大概80-100tok/s。但一開始用qwen3.8-flash-next加上這個速度,那種模型質素和聰明提升的感覺真的很明顯,比較像用之前的deepseek v4。我覺得做長任務的說,只得單流都是值得的。
-
strata真是带火了一波 q38 flash !啥时候带带 deepseek v4 flash呀!
strata真是带火了一波 q38 flash !啥时候带带 deepseek v4 flash呀!
這內存海,到時候換洋垃圾漲價
-
-
-
-
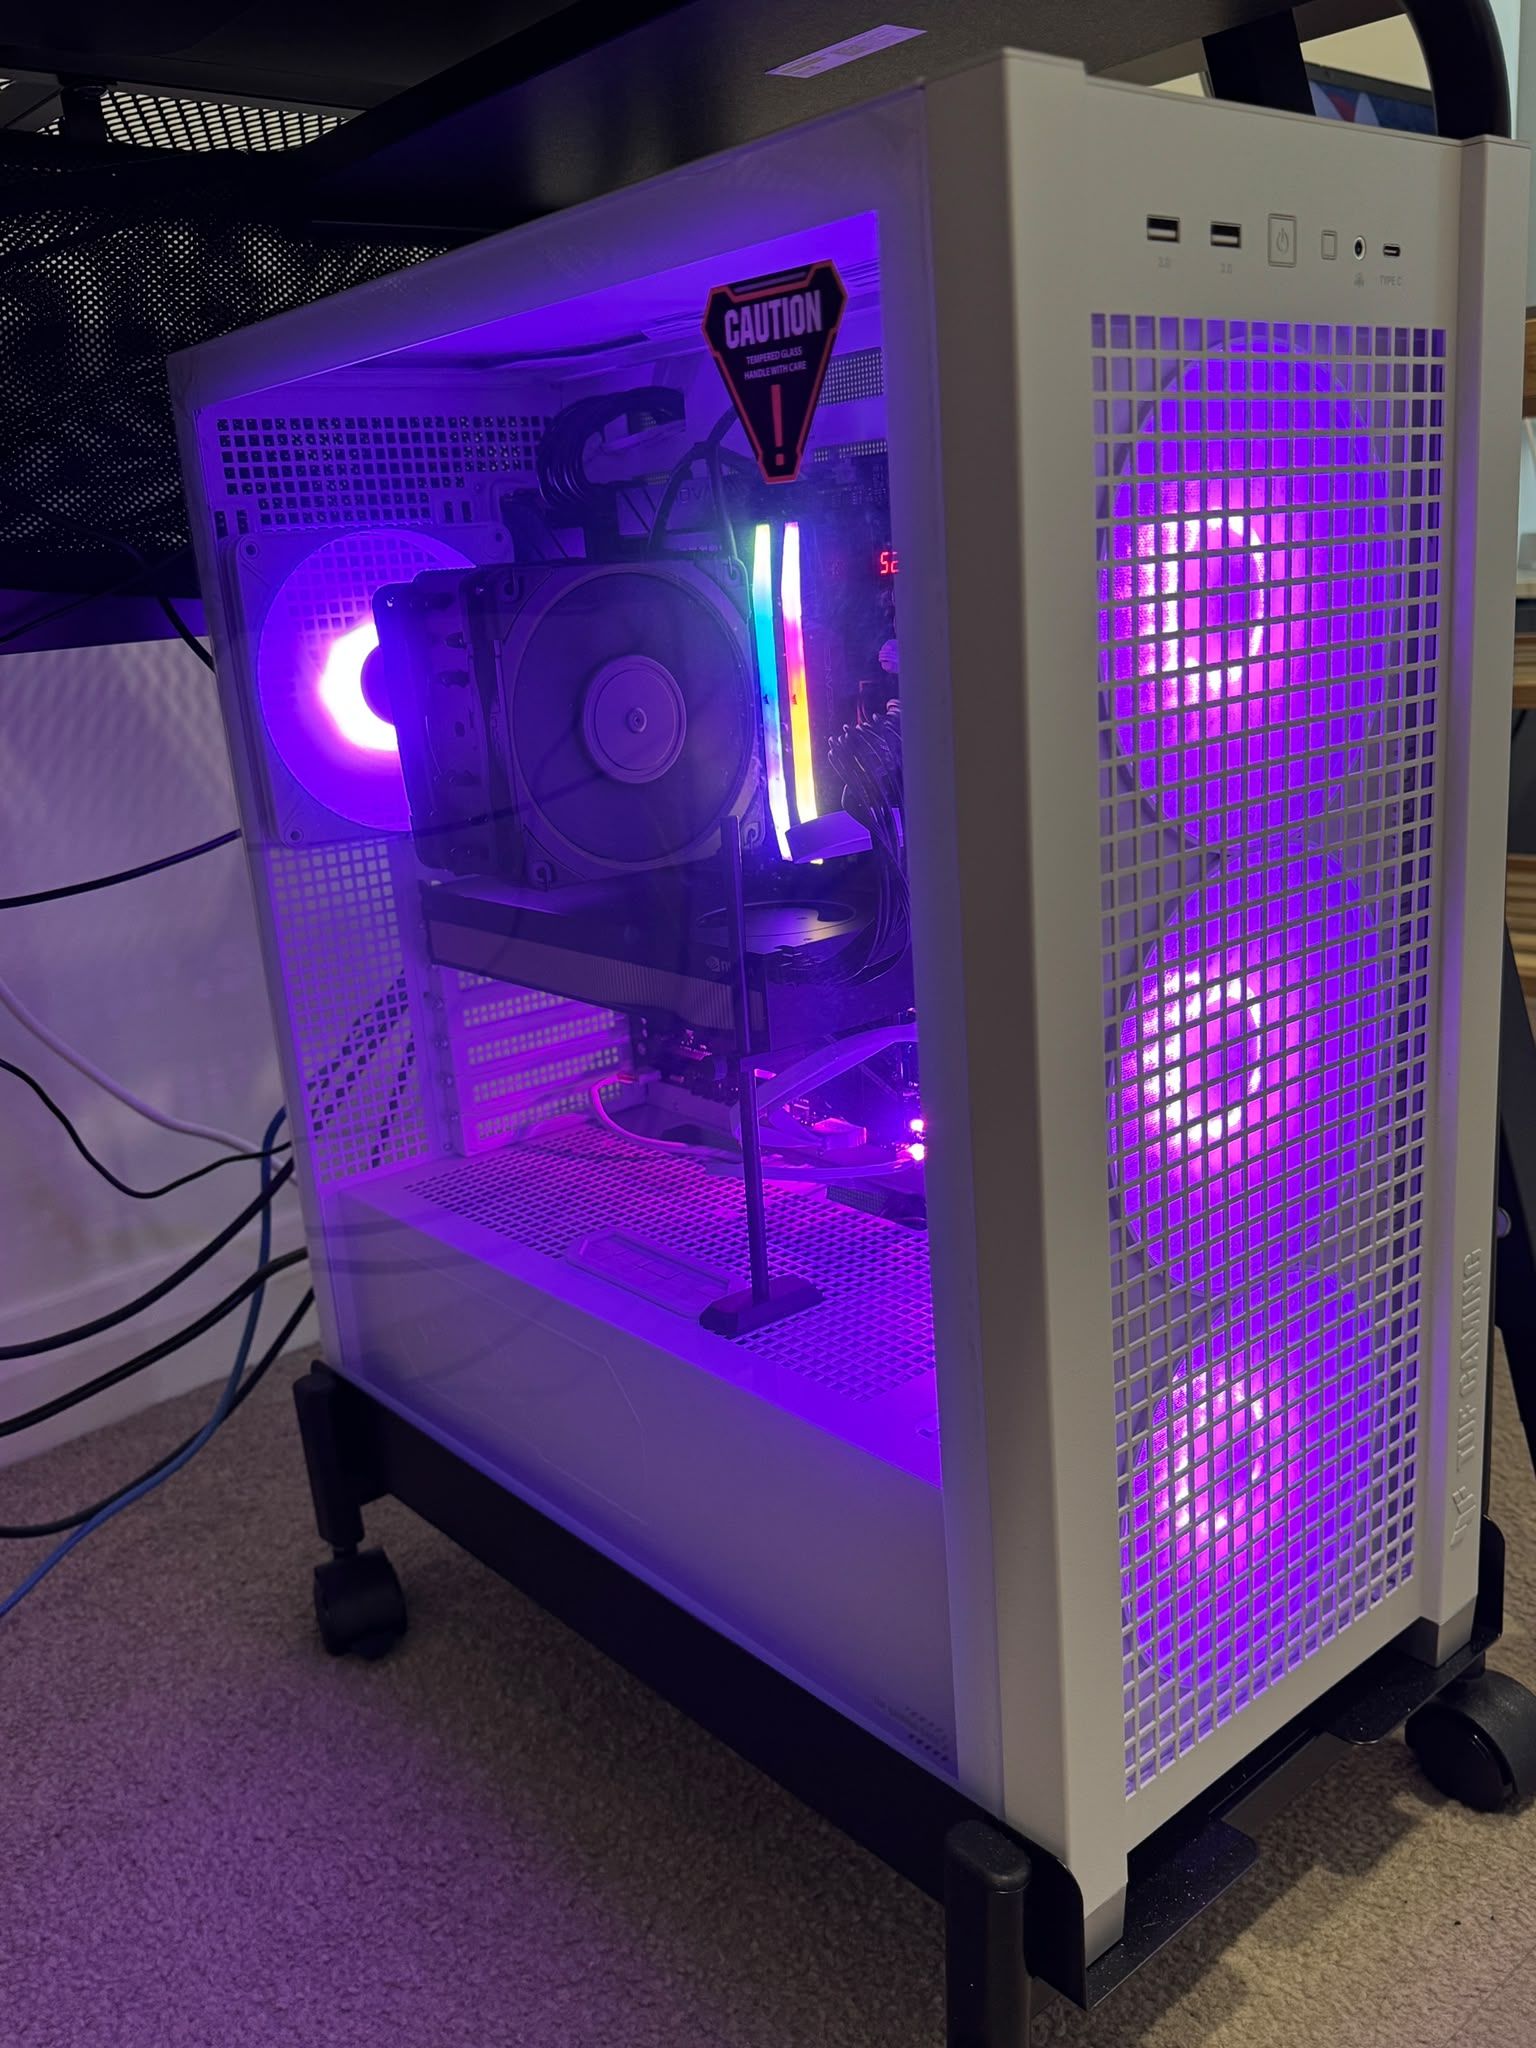
@terry 第一次自己組裝
-
Strata NVFP4 版本更新實測 —— 0.1.28 → 0.1.32 → 0.1.38:快了什麼、又加了什麼
上次在同一塊板貼過 72GB 單卡跑 Qwen3.8-Flash-Next(176B MoE)+ Strata NVFP4 的完整數據,當時用的是 0.1.28-nvfp4.4。
那之後官方半個月內連出到 0.1.38,我中間升了兩次:0.1.28 → 0.1.32 → 0.1.38。這篇補兩件事:
- 同設定 A/B 之下,版本之間到底快多少(不是感覺,是逐次載入、同一批 script 量出來);
- 每個版本加了什麼,以及 一點容易誤讀的陷阱 —— 我中途改過自己的設定,有一批數字變動其實和版本無關。
最後附我最後一輪完整重測(0.1.38)的數據。
先講結論:兩次升級都是純賺 —— 沒有任何一項變差。 0.1.28→0.1.32 是 decode 大躍進(+21~53%,平均 +25~44%),0.1.32→0.1.38 幅度細(多在雜訊內),但換來每一輪對話省約 0.3 秒,長對話流程直接受惠。
TL;DR
- 0.1.28 → 0.1.32:decode 平均 +25~44%(單次量測 +21~53%)、prefill +7~12%;長 context 基本平手
- 0.1.32 → 0.1.38:零退步;128K prefill +4.2%、128K decode +9%、暖 turn 快約 2×(0.7→0.3s)
 最有感的一項:0.1.38 的 tokenizer 只編碼新增部分 —— 同一個 107K prompt,暖 turn 由 739 ms → 442 ms(-40%)
- ️ 誤讀陷阱:我 10-02 把 expert 由 pinned RAM 改成 file-tier,prefill 因此跌 29~42% —— 這和版本無關,不要拿去比版本
- ️ 版本功能面的重點:對話 cache(0.1.30 起)、取消 request 一秒放 engine(0.1.34)、引擎靜默保護(0.1.37)、沒 API key 時的 Host/跨站 403(0.1.38)
- ️ 升 0.1.31+ 之後低 RAM tier 會自動開(我 96GB 機器中招)→ 要
--no-low-ram或改用 file-tier - 我上次貼的長 context decode(128K 52.2 / 250K 49.4)是量測 artifact,同一顆舊引擎重測是 116.6 / 101.9 —— 這篇一併更正
一、版本時間線
版本 日期 主打 0.1.28-nvfp4.4 09-30 桌面版 decode 穩定(Windows VRAM reserve 700→1500 MiB)、長 prompt 後 drafting 更快 0.1.29 09-30 有溫度取樣答案快達 40%(同 seed 逐位元相同)、prompt kernel 更快 0.1.30 10-01 短 prompt 快達 28%、多 GPU、AMD RDNA4、server 可交還 GPU、對話 cache 雛形 0.1.31 10-01 Unsloth UD-Q4_K_XL 可在 64GB RAM PC 跑、AMD decode +15%、Windows 載入快一倍 0.1.32 10-02 多 GPU 短 prompt 修復、AMD decode +12%、社群 30+ 改動 0.1.33 10-02 vision encoder 回復 portable build;setup 由「強制」改「建議」 0.1.34 10-02 AMD on Windows、MCP server(讓 AI 自己裝/起 Strata)、取消的 request 一秒內放 engine 0.1.35 10-03 Windows AMD 首 prompt 不再 crash、low-RAM 在 32GB Windows 可用 0.1.36 10-03 Q2_0 prompt +16~22%、長 context 出字 +18%、UPDATE.bat 一鍵更新、expert profile 記憶(opt-in) 0.1.37 10-03 server 偵測引擎靜默(不再互等)、Windows AMD 計桌面 VRAM、PCIe probe 更穩 0.1.38 10-04 prompt 更快( --kv q4_0走 tensor core)、6GB 卡可起動、沒 API key 時的安全檢查(Host+跨站 403)我兩次升級的路徑:
0.1.28-nvfp4.4→(跨 0.1.29~0.1.32)0.1.32-nvfp4.2→(跨 0.1.33~0.1.38)0.1.38-nvfp4.2。
二、效能差多少(同設定 A/B)
方法:新版解到另一個目錄、config 用絕對路徑指同一個
models\、另一個 port;舊版原封不動。兩個引擎逐次載入(69 + 60 GB > 72 GB 不可能並存),同一份 config、同一批 script、同一節 session。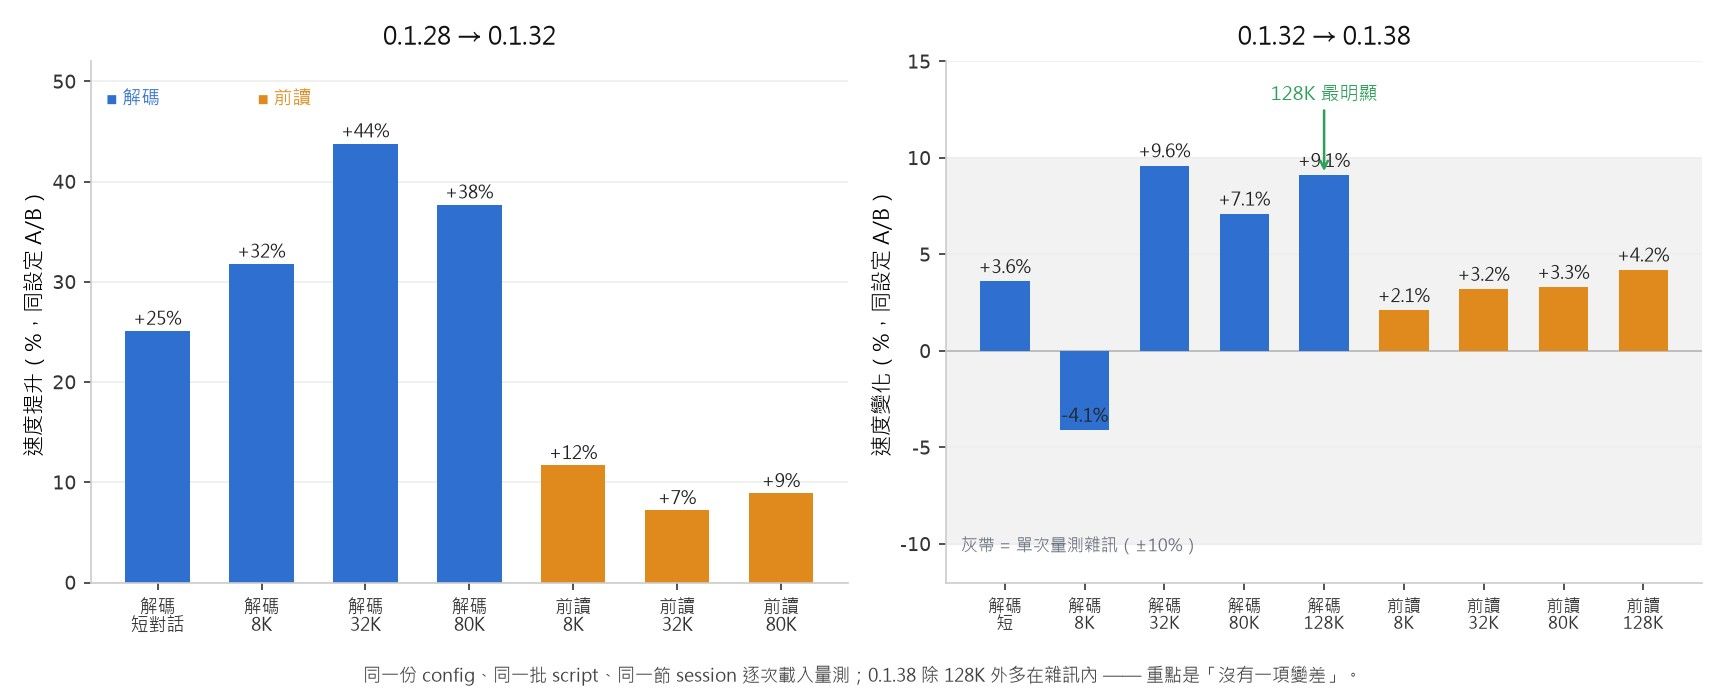
2.1 0.1.28 → 0.1.32
項目 0.1.28 0.1.32(2 次) 差 decode 短對話(~400 tok) 102.1 131.9 / 123.6 +21~29% decode ~8K 121.6 159.9 / 160.6 +31~32% decode ~32K 108.9 146.1 / 167.0 +34~53% decode ~80K 114.0 165.9 / 148.1 +30~46% prefill ~8K 3,577 4,014 / 3,977 +11~12% prefill ~32K 4,451 4,820 / 4,722 +6~8% prefill ~80K 4,408 4,845 / 4,754 +8~10% 長 context(舊 bundle 解到另一個目錄、共用同一
models\、同日量):0.1.28 0.1.32 128K(110,009 tok) 4,512 tok/s · 首 token 24.4s · decode 116.6 4,640 · 23.7s · 115.8 250K(214,865 tok) 4,187 · 51.3s · 101.9 4,288 · 50.1s · 106.8 結論:短/中 context decode 大贏(平均 +25~44%,單次量測 +21~53%)、prefill 小幅(+6~12%),長 context 基本平手(±3%)。
️ 更正上次的數字:我上次貼的長 context decode(128K 52.2、250K 49.4)是量測 artifact。同一個舊引擎今天重測是 116.6 / 101.9。上次那兩行不要引用。2.2 0.1.32 → 0.1.38
項目 0.1.32 0.1.38 差 decode 短 chat(400 tok) 119.6 / 124.1 120.1 / 132.4 +1~7% decode ~8K 138.0 / 160.7 151.8 / 134.6 雜訊內 decode ~32K 131.7 / 146.8 145.2 / 160.1 +3~10% decode ~80K 134.4 / 131.6 146.5 / 138.5 +3~9% prefill ~8K 2,461 / 2,460 2,421 / 2,601 ±2% prefill ~32K 2,909 / 2,819 2,978 / 2,936 +1~4% prefill ~80K 3,585 / 3,533 3,676 / 3,680 +3~4% prefill 128K(110,009 tok) 3,766(首 token 29.2s) 3,924(28.0s) +4.2% decode 128K 110.4 120.4 +9% decode 的單次 run-to-run 波動本身有 ±10%,所以除 128K 之外,decode 差異多數在雜訊內。重點是:沒有一項變差。
2.3
最有感的一項:tokenizer 只編碼新增部分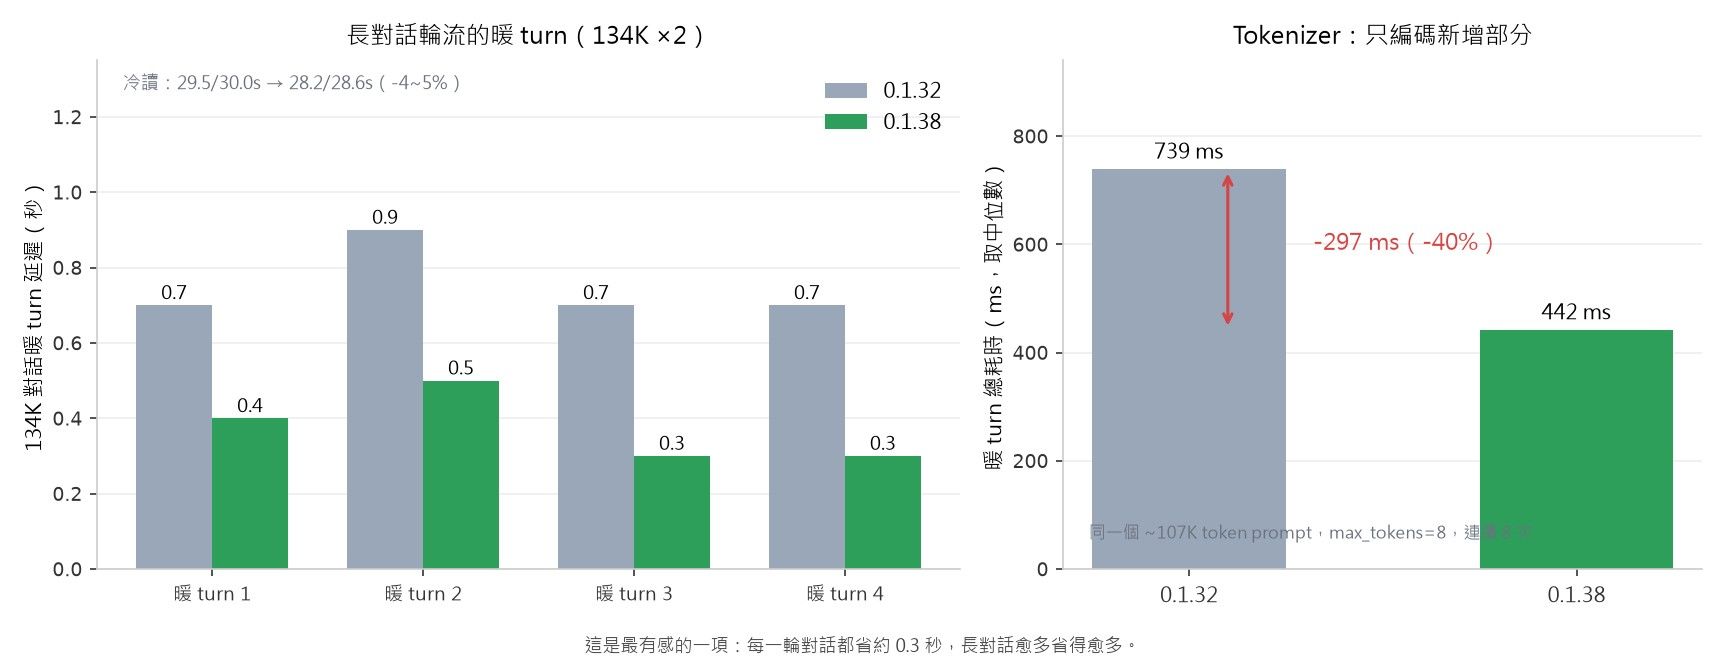
0.1.38 把 prompt 只有新增的部分送去 tokenizer(官方:125K 由 221 ms → 6.8 ms)。
我用自己的探針量同一個 ~107K token prompt,暖 turn(
max_tokens=8)連續 8 次取中位數:暖 turn 總耗時(中位數) 最快一次 0.1.32 739.1 ms 481.7 ms 0.1.38 442.1 ms 193.6 ms 差 -297 ms(-40%) -288 ms 兩個 134K 對話輪流(每次 16 output token)的暖 turn:
# 0.1.32 0.1.38 1 0.7 s 0.4 s 2 0.9 s 0.5 s 3 0.7 s 0.3 s 4 0.7 s 0.3 s 冷讀(首次) 29.5 / 30.0 s 28.2 / 28.6 s → 用 2~3 條 134K 對話輪流的話,每一 turn 省約 0.3 秒,對話越多省越多。這是我日常最有感的一項。
2.4
️ 但有一批數字「不是版本的事」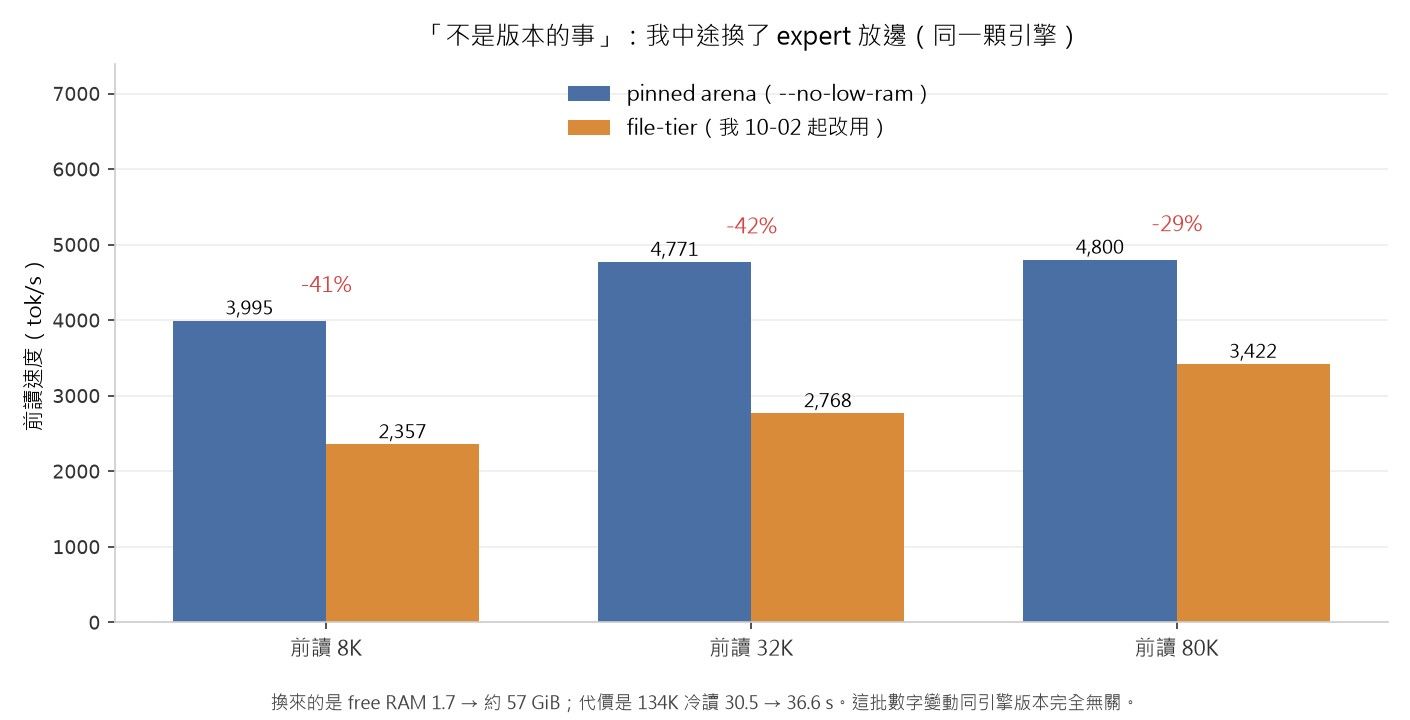
我 10-02 做了一個和引擎版本無關的決定:把 expert 由 pinned RAM arena 改成 file-tier(專家 miss 由 SSD 串流,換 ~56 GiB free RAM)。副作用是 prefill 跌 29~42%:
pinned arena( --no-low-ram)file-tier(我 10-02 起) 差 prefill 8K / 32K / 80K 3,995 / 4,771 / 4,800 2,357 / 2,768 / 3,422 -41% / -42% / -29% 134K 冷讀 30.1 / 30.8 s 35.7 / 36.6 / 37.6 s +10~23% free RAM 1.7 GiB 約 57 GiB — 暖 turn(134K) 0.7~1.3 s 0.7~1.0 s 一樣快 (pinned 一欄取兩次量測的平均;file-tier 是單次基準值。兩者是同一顆引擎、只差 config。)
所以看數據時要分清楚三件事:
- 我上次貼的 0.1.28 prefill 4.4~5.1K 是 pinned 年代;
- 0.1.32 的 prefill 4.0~4.8K 也是 pinned(這是公平 A/B,見 2.1);
- 0.1.38 的 prefill 2.4~3.9K 是 file-tier(見 2.2 表,兩邊都是 file-tier,所以那張表才可比)。
把 0.1.38 的 2,4xx 拿去和 0.1.28 的 4,4xx 比,會得出「新版慢一半」的錯誤結論。
三、每個版本加了什麼
3.1 對我這種「單卡跑長 context agent」最有用的
版本 新增 為什麼重要 0.1.30 對話 cache: --conversation-cache-mib N/--conversation-cache-slots N/--conversation-cache-min-free-mib N 我之前「兩個長 session 互相沖掉(每輪 ~29s)」就是靠這組 flag 解決:兩個 134K 對話輪流都保持 warm0.1.30 server 可交還 GPU: POST /unload、POST /load、--idle-unload 600、--min-free-vram-mib、--before-load "cmd"要給 ComfyUI 出圖時不用整個停掉,借位/還位有 API 0.1.34 取消的 request 一秒內釋放引擎 agent 中途按停,不用等它輸出完才輪到下一個請求 0.1.36 UPDATE.bat一鍵更新(只更新、不起模型)升級不用重跑 setup 0.1.36 expert profile 記憶(opt-in): "expert_profile_save": "path\profile.bin"記住你的工作用到哪些 experts,下次開機由它開始而不是出廠 profile 0.1.37 引擎靜默保護: engine_silence_s(預設 300s)引擎 freeze 時 server 會結束該 request 並在下次請求重啟引擎,不再是雙方互等 0.1.38 沒 API key 時的安全檢查:只回應認識的 host、跨站頁面 403(allowed_hosts/STRATA_ALLOWED_HOSTS) 我是 host: 0.0.0.0+ 沒 key,這個補洞一定要看(見第五節)3.2 順帶(AMD / 多卡 / 其他量化)
- 0.1.30:多 GPU(
--gpus 0,1、--gpus all);AMD RDNA4。 - 0.1.31:Unsloth UD-Q4_K_XL 可在 64GB RAM PC 跑(experimental);AMD decode +15%;Windows 無
experts.bin的模型載入快一倍。 - 0.1.32:多 GPU 短 prompt 修復;AMD decode +12%;社群改動(
response_format、anthropic_thinking: on_request、--coupled-draft、--flash-attn、/v1/messages/count_tokens…)。這個版本我也採用了anthropic_thinking: on_request。 - 0.1.33:️ 0.1.32 的
strata-vision.exe是用 AVX-512 + OpenMP 編的,在沒有 AVX-512 的 CPU(大部分 Zen 4 前的 Ryzen、很多 Intel 桌面 U)會 illegal instruction。0.1.33 改回 portable(AVX2)。我的 9950X3D 有 AVX-512,沒中,但值得提醒。 - 0.1.34:AMD on Windows(新);
tools/strata_mcp.py—— 一個 MCP server,讓 Claude Code / Cursor / Codex 自己裝、起、檢查、停 Strata。README 也重整(細節搬去docs/INSTALL.md、MODELS.md…)。 - 0.1.35:Windows AMD 用 bundled HIP runtime,首 prompt 不再 crash;low-RAM mode 在 32GB Windows 可用。
- 0.1.36:Q2_0 讀 prompt +16~22%、長 context 寫答案 +18%(我跑 NVFP4 不是 Q2_0,但同一批修正在)。
- 0.1.38:
--kv q4_0(prompt 的 Q4_0 K/V 走 tensor core,32K prompt 由 18.8s → 14.3s,代價是 KL 0.026 / top-1 95.1%,預設--kv int8不變);6GB 卡也能起動;--ple-io direct、STRATA_NO_LARGEPAGES;新的 opt-in--peer-device、--adapt-decay。
3.3 NVFP4 fork 自己加的(
sergqwer/strata-nvfp4)fork 版本 新增 0.1.28-nvfp4.4 Windows VRAM reserve 700 → 1500 MiB(避免桌面程式爭 VRAM 令 decode 掉到 58~90 tok/s) 0.1.31-nvfp4.3 自適應 VRAM tier 記得更久:每層 expert miss -37%、CPU expert pool -35%、PCIe 流量 -12% 0.1.32-nvfp4.2 可選更準的 experts pack(由 BF16 重轉,GPTQ + 27 層 Q8_0 down):median KL 0.0107 → 0.0051,代價 -12~15% decode、pack 63.3 → 73.8 GiB → 我沒開 0.1.36-nvfp4.1 Claude Code 用 Read開的圖能進 image encoder(修好「tool result 內的圖一律變文字」)0.1.38-nvfp4.2 VRAM reserve 回到 700 MiB(=多 ~113 expert slots);帶入上游 tokenizer 修正 那個更準的 experts pack 我實測過代價:-12~15% decode 換 KL 減半。用 agent 跑長 context 我選擇保留速度,沒換。
四、我最後一輪完整重測(0.1.38-nvfp4.2)
用原封不動的 script 重跑我裝機當天那套測試,全部打 live server(
full/auto、22,704 slots)。項目 0.1.38 實測 對照 並行 aggregate N=1/2/4/8/16/32 103 / 149 / 149 / 145 / 137 / 136 tok/s 同型(N≥2 差 ≤7%)每條實際 N=2/4/8/16/32 74.7 / 37.2 / 18.1 / 8.5 / 4.2 prefill 128K / 250K 3,655~3,924 / 3,397(首 token 28.0s / 44.8s) -11~14%(file-tier,見 2.4) 單針檢索(深度 10/50/90%)32K/128K/200K/250K 4 × 3/3 全中 5 針一次問齊 32K / 250K 5/5、5/5 多跳推理 VELMORA-77192K→250K 全部一致 同 session prefix cache 冷 55.1s → 0.8s(reused 115,652)= 69× 兩個 134K agent 交替 首次全讀 32.6s → 之後全部 cache hit(0.6~0.9s) 讀圖 1 張(256² / 512² / 1024×768 / 1920×1080 / 3840×2400) 0.8 / 2.1 / 6.1 / 8.4 / 8.6 s image token 66 / 258 / 770 / 1010 / 1002 frames 8 / 16 / 32 / 64 11.9 / 21.6 / 42.9 / 88.4 s 64 張答對 frames 96 / 128 / 200 全部失敗 64 張上限 bug 仍在 warm talk(~134K)1 / 2 / 3 個 session 94.5 / 96.7~105.0 / 97.8~109.2 tok/s 134K 冷讀 35.15 / 35.29 / 36.18 s 4.1 讓 VRAM 給 ComfyUI:三檔實測
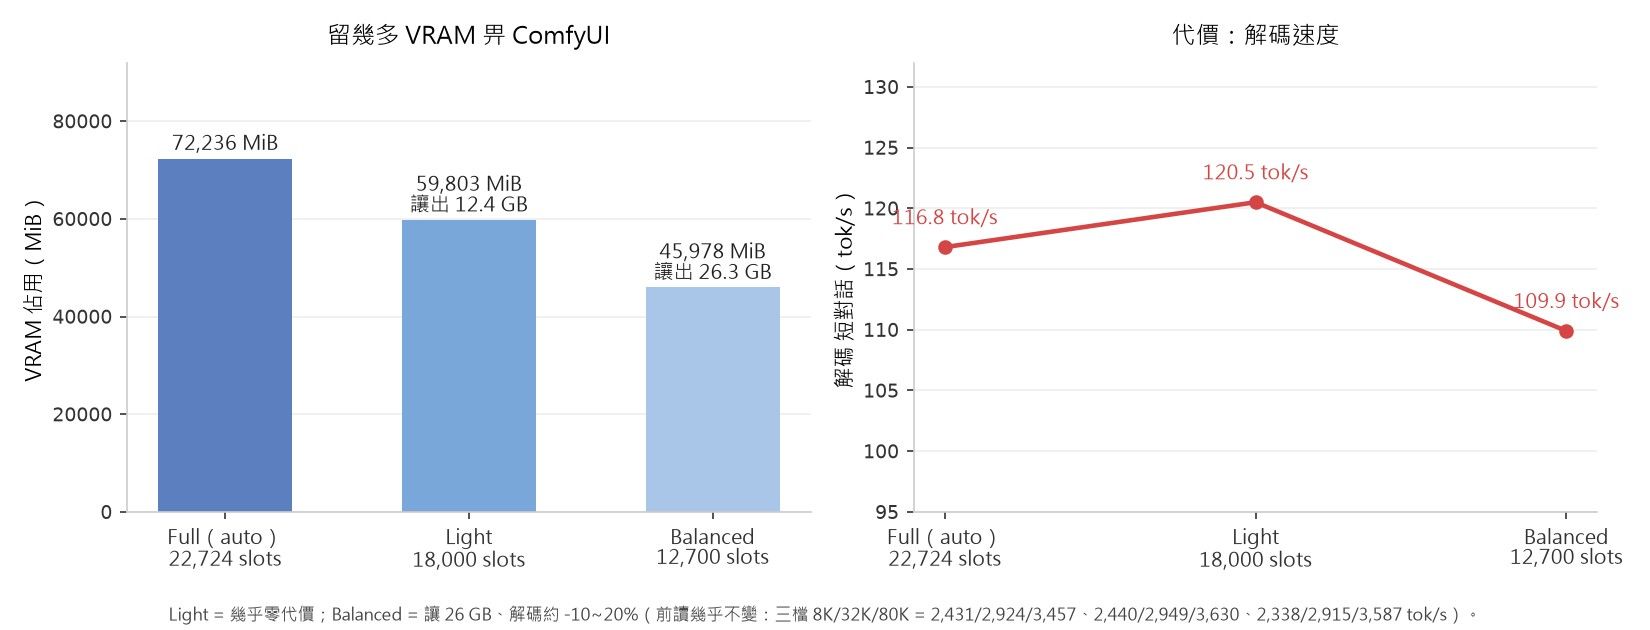
Full(auto) Light Balanced slots · cache 22,724 · 59,922 MiB 17,998 · 47,460 MiB 12,698 · 33,484 MiB VRAM 佔用 72,236 MiB 59,803 MiB 45,978 MiB 讓出 VRAM — 12.4 GB 26.3 GB decode 短/8K/32K/80K 116.8/138.3/135.9/120.6 120.5/123.2/122.1/132.8 109.9/115.6/116.8/144.3 prefill 8K/32K/80K 2,431/2,924/3,457 2,440/2,949/3,630 2,338/2,915/3,587 134K 冷讀 · decode 33.4s · 108.0 31.5s · 125.3 32.3s · 99.9 → Light = 讓 12 GB 幾乎零代價;Balanced = 讓 26 GB、decode 約 -10~20%(prefill 幾乎不變)。 對 Qwen-Image 2.1(峰值 22~26 GB)來說 Balanced 剛好。
4.2
STRATA_PREFILL_NVFP4:w4a8(預設)vs w4a4 重測先講方法上的坑:量 prefill 一定要看 engine log 自己那行
prompt N = M reused + R read。我一開始用正常 config 跑,第二輪同一個 prompt 命中 cache(7 tokens = 6544 reused + 7 read),量到的「prefill」完全不可信。改成「送一段不同文字踢走 resident sequence、確認0 reused」之後:context w4a8(預設) w4a4 差 ~8K 2,573.6 2,931.4 +13.9% ~32K 2,956.6 3,299.8 +11.6% ~80K 3,648.3 4,121.3 +13.0% 代價:KL 0.0018 → 0.0080(差 4.5×)、top-1 8/8 → 7/8。只快 prefill,decode 完全不變。 → 維持
w4a8。
五、升級要留意(我踩過 / 核過)
-
升級會蓋掉 3 個檔案,要自己 re-apply:
config\strata-nvfp4.json(我的host: 0.0.0.0+--conversation-cache-mib 9216)start-server.cmd(--port 8097)- ️ 若你有改
serve\server.py(我加了CREATE_NO_WINDOW防 cmd 彈窗),新版不能照抄舊檔 —— server.py 由 149,627 B 變 192,758 B、Popen 位置也搬了。要重新打 patch。 models\和.venv-serve不在 zip 內,會保留,不用重新轉換。
-
️ 0.1.31+ 的低 RAM tier 會自動開:安裝 RAM < 96 GB 就中(我的 93.6 GiB 中招)。它會放棄 pinned resident arena、改成只 pin ~5 GiB,其餘由 SSD 讀 → prefill 掉 17~34%。要判斷有沒有中,grep engine log 這三句:
low RAM (below 96 GB installed、resident RAM mode:、expert tiers:。處理:加--no-low-ram(回 pinned),或者像我一樣接受 file-tier。 -
️ 0.1.38 的安全變更:
host: 0.0.0.0而且沒有 API key 的話,server 只回應它認識的名字。實測:
Host header 檢查(防 DNS rebinding)
送出的 Host 結果 127.0.0.1/localhost200 192.168.x.x(LAN IP)/100.x.x.x(Tailscale IP)200 本機電腦名 200 evil.example.com403 MagicDNS 名( *.ts.net)403 ️跨站頁面檢查(
_foreign_page,只針對/v1POST)情境 結果 沒有 Origin(curl/OpenAI/Anthropic SDK/agent)200 Origin: http://127.0.0.1:8097(Strata 自己的頁)200 Origin: https://evil.com403 → 用 IP 直連完全沒影響;只有主機名/MagicDNS 名/reverse proxy 名要加
"allowed_hosts": ["..."]。-
/unload、/load現在只收 JSON:curl -X POST -H "Content-Type: application/json" localhost:8097/unload。 -
64 張圖/request 的 bug 仍在(新版一樣先全部 encode 再讀檔,cache 滿 64 就刪掉前面的
.sve)。我不會一個 request 送 >64 張,所以繼續不理。 -
長 context prefill 不要只取第一行:切模式/重載後第一個長 prompt 會重新熱身 expert cache,可能量到 942 tok/s 這種假數字(log 原文:33.9 秒內由 SSD 讀了 89 GB,≈2.6 GB/s)。緊接的 128K/250K 才反映穩定表現。
-
未變:單流 FIFO(總吞吐固定 ~145 tok/s)、~245.7K per-request 硬牆、
STRATA_ADAPT_WAIT仍然 opt-in(所以 greedy 答案仍不保證逐位元可重現)。
六、結論
每一欄都是同設定之下的版本對版本(不要跨欄比較):
0.1.28 → 0.1.32(pinned) 0.1.32 → 0.1.38(file-tier) decode 短對話 102.1 → 127.8(+25%) 121.9 → 126.3(+4%,雜訊內) decode 32K 108.9 → 156.6(+44%) 139.3 → 152.7(+10%) prefill 32K 4,451 → 4,771(+7%) 2,864 → 2,957(+3%) 128K prefill 4,512 → 4,640(+3%) 3,766 → 3,924(+4.2%) 128K decode 116.6 → 115.8(平手) 110.4 → 120.4(+9%) 134K 暖 turn (未同法量測) 0.7~0.9 s → 0.3~0.5 s tokenizer(107K 暖 turn) — 739 → 442 ms(-40%) 有無項目變差 無 無 值不值得升?值得。 兩次都是零退步:
- 0.1.32:decode +21~53%(平均 +25~44%)、prefill +6~12% —— 單次升級回報最大。
- 0.1.38:幅度細,但 tokenizer 修正每 turn 省 ~0.3 s(多長對話流程直接受惠)+安全補洞+128K 的 +4~9%。
代價:0.1.38-nvfp4.2 的 VRAM reserve 回到 700 MiB → load 後 free VRAM 由 1,119 → 446 MiB。如果看到 decode 忽快忽慢/桌面卡頓,config 加
--vram-reserve-mib 1500就回到舊行為(代價 = 少約 113 slots)。升級動作:其實就是「解壓蓋上去、保留
models\和.venv-serve、re-apply 上面那 3 個檔案」。
-
大佬,是如何跑多流的啊 @yu-yeung-lam 求教
-
大佬,是如何跑多流的啊 @yu-yeung-lam 求教
-
Strata NVFP4 版本更新實測 —— 0.1.38 → 0.1.39:prefill 快 22~44%、加了「並行」
上次在同一塊板貼過 72GB 單卡跑 Qwen3.8-Flash-Next(176B MoE)+ Strata NVFP4 的完整數據(0.1.28 → 0.1.32 → 0.1.38)。這次補 0.1.38 → 0.1.39。
這版官方 release note 寫得很少(「verify pass 少幾個 launch、long prompt ring 改成按 bytes 計」),我本來以為只是小更新。實測之後不是 —— 這版有一個對「像我這種用 file-tier 的人」影響很大的修正,而且第一次出現引擎層的並行。
先講結論:
TL;DR
- 0.1.39 修好了 #577:0.1.38 在「有 RAM budget」的設定下把 prompt 讀取判斷錯了,每個 prompt 之後都去讀硬碟 → 我這裡冷讀 prefill 是 2,511 / 2,885 / 3,570 tok/s,升上 0.1.39 變成 3,606 / 4,151 / 4,346(+44% / +44% / +22%)
- 同一支 battery script 也看到 128K +12.4%、250K +16.2%
- ️ 上游和 fork 都說這版 prefill「沒變」 —— 因為他們的測試機把 experts 全放 RAM;#577 只在 file-tier / 有
--ram-budget的設定才咬。所以:你是 file-tier 就賺到,是 pinned 就無感。怎麼分辨我寫在第 2.3 節 
"parallel": N(2~8):引擎層同時解碼 N 條對話。 上限 8 格;我這裡一條不慢(N=2 幾乎零、N=3 只 −3%),3 條同時反而總吞吐更高(114 → 128 tok/s)- 長 context × 並行實測:3 × 250K 同時成功(675K tokens 同時在跑);prefill 沒有變慢;長 context 答案逐字相同(solo vs 並行,兩邊都是 4/4 全對)
- ️ 重要否定結果:並行不能取代
--conversation-cache-mib。 關掉對話 cache 之後,3 條 134K 對話交替,每一輪都退回冷讀 23~26 秒 —— 三條長對話保溫靠的是對話 cache,不是 slot - ️ 每一格 slot 在 262K context 要 3.65 GiB(官方文件寫的 0.56 GiB 是 32K 的情況)。而且在「寫死
--expert-cache」的 co-run 模式裡,slot 是加在 cache 上面 → H3 模式讓出的 36 GB 會變 25 GB - ️ fork 這版還修了一個很痛的問題:長對話輸出 NaN logits 之後,之後每個 request 都只回
!(要手動重啟引擎)
一、版本時間線
版本 日期 主打 0.1.39 10-04 decode verify pass 少 launch(官方 12GB 卡 +6~7%)、long prompt ring 改用 bytes 計、 --prefill auto挑最大 chunk、>262K cells 的 attention top-k、/v1/responses(Codex 能用)、repeat_stop_tokens(同一 token 重複 256 次就收尾)、修 #577、"parallel": N0.1.39-nvfp4.1 10-04 fork:decode round 短 7%(GPTQ+Q8_0-down pack:16.88 → 15.72 ms/round,答案逐位元相同);long prompt ring 少借 1.2 GiB VRAM 0.1.39-nvfp4.2 10-05 fork:NaN logits 之後自動開新引擎(見 3.3)+補完 #606 的 q8_1 clamp 我這次是 0.1.38-nvfp4.2 → 0.1.39-nvfp4.2(跨 fork 的 .1、.2 兩版)。
二、效能差多少(同設定 A/B)
方法:新版解到另一個目錄、config 用絕對路徑指同一個
models\、同一個 port 逐次載入(69 GB + 60 GB 不可能同時放進 72 GB 卡),同一份 config、同一批 script、同一節 session。全部是 冷讀(engine log 自己那行prompt N tokens = 0 reused + N read確認),不是我猜的。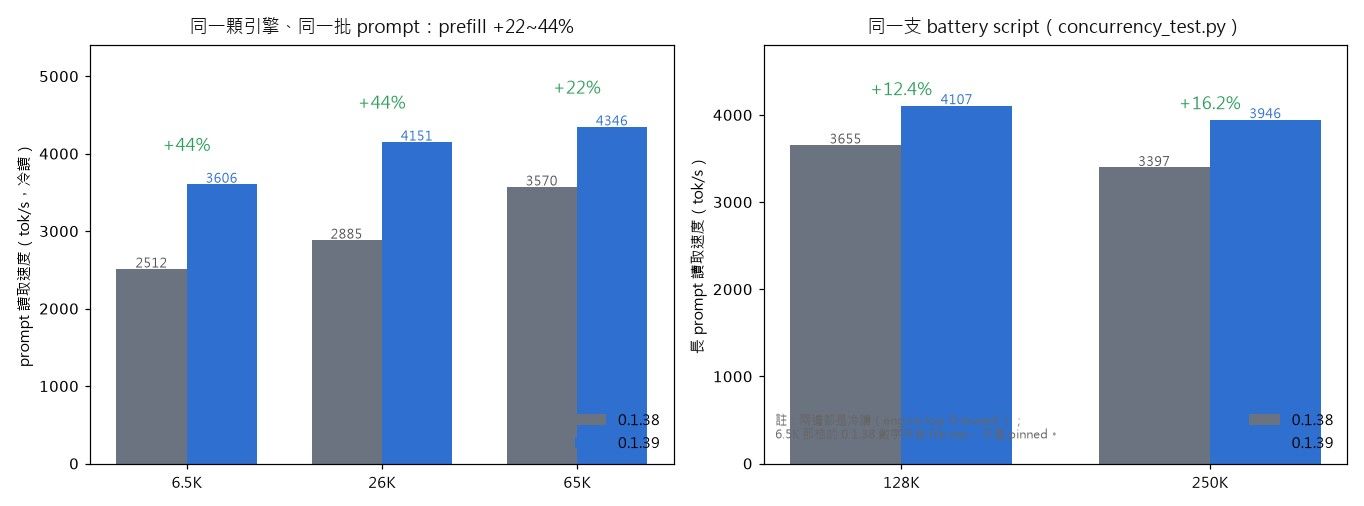
2.1
最大的差異在 prefill,不在 decode冷讀 prompt 0.1.38 0.1.39 差 6,551 tok 2,608 ms(2,511 tok/s) 1,817 ms(3,606) +44% 26,183 tok 9,076 ms(2,885) 6,308 ms(4,151) +44% 65,471 tok 18,341 ms(3,570) 15,066 ms(4,346) +22% decode(同一個 prompt 之後):0.1.38 是 115~145 tok/s,0.1.39 是 140~162 tok/s —— 兩者都在 run-to-run 波動範圍內,看不出有意義的差別(官方說大卡上的 decode 增益「沒量到」,我這邊一致)。
2.2 同一支 battery script 的對照
0.1.38 0.1.39 差 prompt 讀取 32K 942(量測假象,見第 6 節) 3,417 — prompt 讀取 128K 3,655 4,107 +12.4% prompt 讀取 250K 3,397 3,946 +16.2% 2.3
️ 為什麼官方說「沒變」——這修正只咬 file-tier#577 的原文是:0.1.38 太早決定要不要繞過 file cache,而且它拿「所有 model 檔的總大小」去比。 在 96 GB 機器 + 72 GiB budget 的設定下它判斷錯誤 → 每個 prompt 之後的 refill 都去讀硬碟,官方自己的說法是 prompts 慢 15–40%。
這完全對得上我這邊的量測(+22~44%)。側面證據:0.1.38 那個 arm 的 engine log 寫著
files 30,452 blobs 269,494.9 MB read—— 一趟測試從 SSD 讀了 269 GB。為什麼上游與 fork 都回報「prefill 沒變」? 因為他們的測試機把 experts 全放進 RAM(pinned arena / 大 RAM 機器),#577 那條路根本不會走到。
你要怎麼知道自己會不會賺到? 看 engine log 有沒有這三行之一:
low RAM (below 96 GB installed ...
resident RAM mode: ... of experts in RAM ...
expert tiers: ... files N blobs ... MB read
有的話你就在 file-tier,#577 對你有用。想回 pinned arena 就是
--no-low-ram(代價是少掉 ~56 GiB 可用 RAM,換 prompt 更快)。
三、0.1.39 加了什麼
3.1 實用功能
新增 為什麼有用 "parallel": N(2–8,預設關)引擎同時解碼 N 條對話。這是我這次最想要的東西(見第四節) /v1/responsesOpenAI Responses API,Codex CLI 可以直接指向它。stateless、支援 function tools/tool results/reasoning effort/JSON schema/streaming events。不支援 previous_response_id、hosted tools、reasoning summariesrepeat_stop_tokens(預設 256)同一個 token 連續出現 256 次就收尾。這是防「模型卡住一直吐同一個字」的保險(官方提到有人看到 36,689 個 !)修 #577 見第 2.3 節 —— 本版最有感的一項 --vram-elastic熱調整 VRAM(opt-in) "effort_position": "end"只改 effort 的 request 可以重用 cache(opt-in,預設關) 3.2 順帶(我沒硬體,沒法測)
- 多 GPU:
--remote-expert-opt(作者實測雙 4090:混合文字 +63%、程式碼 +132%)、3+ 卡的 layer split 重疊更好(4×3060:prompt +10~28%)、STRATA_PREFILL_HELP=1讓閒置卡幫讀一個 chunk 的 experts。 - 舊 NVIDIA 卡(Pascal / Volta):CUDA 13 編不了,所以 setup 會多帶一顆 CUDA 12.9 編的引擎;
--cuda 12也是「驅動比 580 舊」的解法。 - Intel Arc:社群 SYCL port(Linux + oneAPI 自己編,沒有現成引擎)。
- 沒有 AVX2 的舊 CPU:AVX-only / SSE4.2-only 也能編(
STRATA_ISA_FLOOR=avx|none,編一次 10–20 分鐘),只有 i-quant 模型能跑。 - Linux expert arena 走 transparent huge pages;
STRATA_IQ256_GATHER=1(AVX2 codebook gather);>64 CPU 的 thread affinity。
3.3
️ fork 這版修了一個很痛的東西(長對話變 !)sergqwer/strata-nvfp4的 release note 直說:一個 96K tokens 的長 Claude Code 對話中途變成一直吐!,而且之後每一個 request 都只回!,要手動重啟引擎才會好。0.1.39-nvfp4.2 的做法:只要出現「token 0 連續重複」這種狀態,就為下一個 request 開一顆新引擎 —— 一次壞掉的回覆,而不是整個 session 壞死。
官方也老實說:到底什麼把那顆引擎的狀態弄壞,還沒找到(expert arena、deterministic replay、elastic K/V、prompt loan、checkpoints、captured graphs 都排除過了)。
如果你會跑很長的 agent 對話,這個修正是升級的獨立理由。
四、新功能實測:
parallel(並行)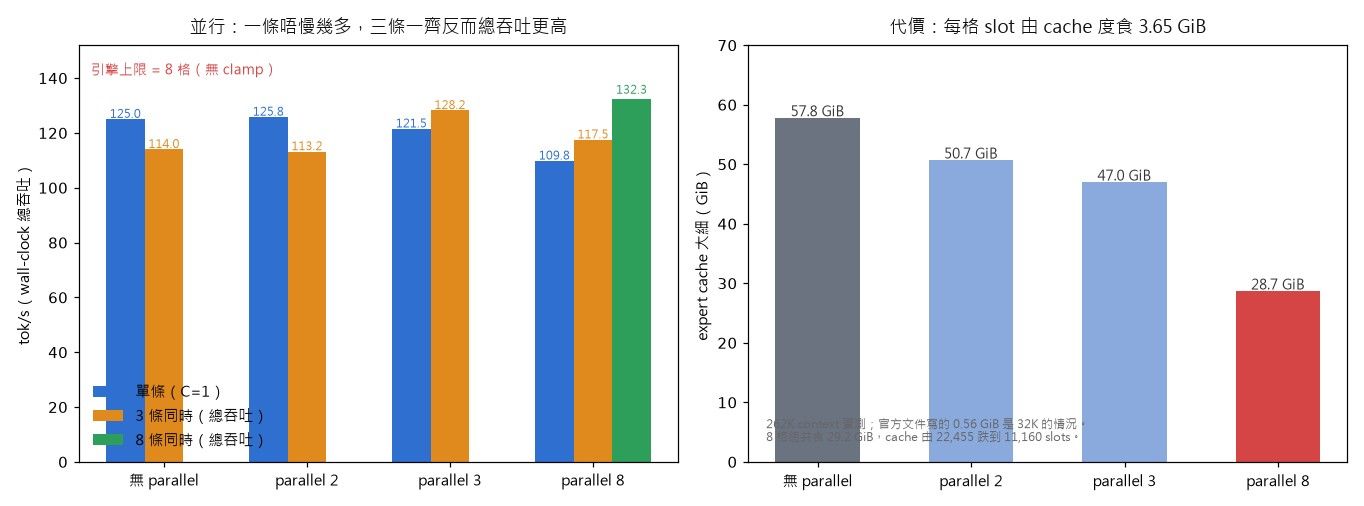
4.1 上限是 8 格,短 context 的速度如下
方法:
par_bench.py發 C 條不同題目(220 token、greedy、thinking off),取 wall-clock 總吞吐(總 output tokens ÷ 總秒數 —— 不能把各 request 自報的 tok/s 相加,那會浮報)。設定 slots · cache 單條(C=1) 3 條同時(總吞吐) 3 條各自完成時間 無 parallel 22,455 · 57.8 GiB 125.0 114.0 2.1 / 4.1 / 5.8 s(排隊) parallel: 219,675 · 50.7 GiB 125.8(−0%) 113.2 3.8 / 4.0 / 5.8 s parallel: 318,256 · 47.0 GiB 121.5(−3%) 128.2 5.1 / 5.1 / 5.1 s parallel: 811,160 · 28.7 GiB 109.8(−12%) 117.5 5.5 / 5.6 / 5.6 s - 引擎上限 = 8 格(
GET /v1/status→"concurrency": {"serving": 8, "requested": 8},沒有 clamp;engine log:--batch: 8 slot sessions on CUDA0 (3.65 GiB each))。 - 真正的好處是公平:沒有並行時第 3 條要等 3.7 秒才開始;開了之後三條一起跑、一起收。
- 單條的代價比官方在 12GB 卡上的數字輕很多(官方:2 格 −11%、4 格 −24%;我這邊 2 格 −0%、3 格 −3%)—— 因為大 VRAM 卡把大部分 experts 留在 VRAM,官方文件自己也是這樣建議的。
- 順帶:burst 掃描(1/2/4/8/16/24/32 條同時)在
parallel: 3之下總吞吐是 100.8 / 130.2 / 155.2 / 156.5 / 147.6 / 148.7 / 149.1 tok/s,比不開時的高段(136~145)高 5~10%。
4.2
️ 每一格 slot 的真實成本:262K 之下是 3.65 GiB官方
docs/BATCHING.md寫「每格 slot 0.56 GiB」——那是 32K context 的數字。你在 262K 之下實際是 3.65 GiB / 格:格數 slot 總佔用 expert cache 2 7.31 GiB 57.8 → 50.7 GiB(22,455 → 19,675 slots) 3 10.96 GiB 57.8 → 47.0 GiB(→ 18,256 slots) 8 29.23 GiB 57.8 → 28.7 GiB(→ 11,160 slots) 重點:成本是「slot sessions」本身,不是「你用到幾條」。 開 8 格就算你只跑 3 條,還是付 29 GiB 的帳(單條 −12%、C=2 總吞吐由 109 掉到 88)。
4.3 長 context × 並行:能跑,而且不變慢
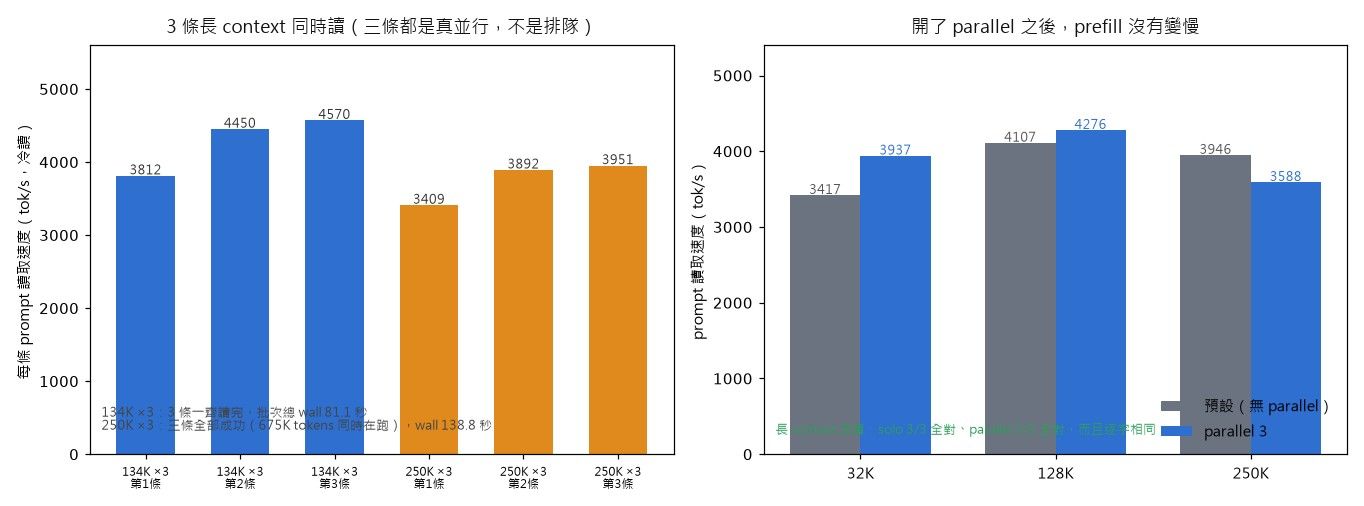
測試( parallel: 3,cache 47.5 GiB)結果 2 × 134K 同時、2 × 250K 同時 兩條都成功,讀取時間重疊3 × 134K 同時 三條冷讀同時進行:29.2 / 25.1 / 24.6 秒,各 3,812 / 4,450 / 4,571 tok/s(不是排隊 —— 排隊的話三條會是 25+25+25 秒)3 × 250K 同時 三條全部成功:224,389 / 224,919 / 225,352 tokens = 675K tokens 的 context 同時在跑,各 3,409 / 3,892 / 3,951 tok/s,批次總 wall 138.8 秒prefill 有沒有變慢? 沒有:32K 3,937 / 128K 4,276 / 250K 3,588 vs 預設的 3,417 / 4,107 / 3,946(128K 還更高) 長 context 答案有沒有變? 沒有:250K 品質測試(3 個針 + 1 個需要跨兩處事實組合的多跳題)solo 3/3 全 4/4、並行 3/3 全 4/4,而且逐字相同 官方說「batch window 裡的 greedy 答案會和單獨跑相同」,但也提醒預設設定下長 prompt 的 bits 會變、輸出可能漂移。我這台在 250K 之下量到的結果是逐字一致 —— 但那是我的環境,別當成普遍保證。
4.4
️️ 並行不能取代對話 cache(否定結果)我原本的假設是:既然 BATCHING.md 說「each slot is a conversation cache」,那三個 slot 應該能讓三條長對話保持 warm,說不定可以省掉
--conversation-cache-mib的 host RAM。實測答案:不行。 用同一組 3 條 ~134K 對話交替(A A B C A B C A):
設定 結果 parallel: 3+ 對話 cache 開著三次冷讀之後,每一輪都是暖的(0.2~0.7 秒,engine log 顯示 reused + 7 read)parallel: 3+ 對話 cache 關掉只有「緊接著重複同一條」才會暖(0.1 秒);一交錯到 B / C,之後每一輪都退回冷讀 23~26 秒 → 三條長對話保溫靠的是對話 cache,不是 slot。 並行只加快「同時打」和 burst 的吞吐,不會讓 slot 自己記住對話狀態。
五、我最後一輪完整重測(0.1.39-nvfp4.2)
用原封不動的 script 重跑裝機當天那套測試,全部打 live server(
full/auto)。項目 0.1.38(上次) 0.1.39(本次) prompt 讀取 32K / 128K / 250K 942(假象)/ 3,655 / 3,397 3,417 / 4,107 / 3,946 並行總吞吐 N=1/2/4/8/16/32 103 / 149 / 149 / 145 / 137 / 136 97 / 155 / 153 / 144 / 148 / 147 單針檢索(4 個深度 × 32K~250K) 全中 全中5 針一次問齊(32K / 250K) 5/5、5/5 5/5、5/5多跳推理(2K→250K) 全部一致 全部一致同 session prefix cache 冷 55.1s → 0.8s(69×) 冷 30.5s → 0.8s(reused 110,250/110,257) 讀圖 5 個尺寸(256² → 3840×2400) 0.8 / 2.1 / 6.1 / 8.4 / 8.6 s 0.8 / 2.2 / 6.1 / 8.2 / 8.1 s frames 8 / 16 / 32 / 64 11.9 / 21.6 / 42.9 / 88.4 s 11.4 / 20.9 / 42.6 / 86.5 s frames 96 / 128 / 200 全部失敗 全部失敗(64 張上限的 server bug 仍在) warm talk(8 條同時、900 tok) — 8.0 秒 = 111.9 tok/s 總吞吐 134K 冷讀 35.2 / 35.3 / 36.2 s 23.5~26.0 s(同一批 prompt,file cache 較暖) 沒有一項變差。
六、升級與設定要留意(我踩過/核過)
-
升級會蓋掉 3 個檔案,要自己 re-apply(
models\與.venv-serve不在 zip 內,會保留、不用重轉):config\strata-nvfp4.json(我的是host: 0.0.0.0+--conversation-cache-mib 9216)start-server.cmd(--port 8097)- ️
serve\server.py若你改過(我加了CREATE_NO_WINDOW防 cmd 彈窗)不能照抄舊檔 —— 每個版本的server.py都不同,要重新打 patch。這次 0.1.39 的server.py比 0.1.38 又多了一堆東西(serve/responses.py、batch slots、/v1/vram、/config…),Popen的位置也全部搬家。
-
️ 想給 ComfyUI 出圖:並行在 co-run 模式是「加在上面」(下圖)
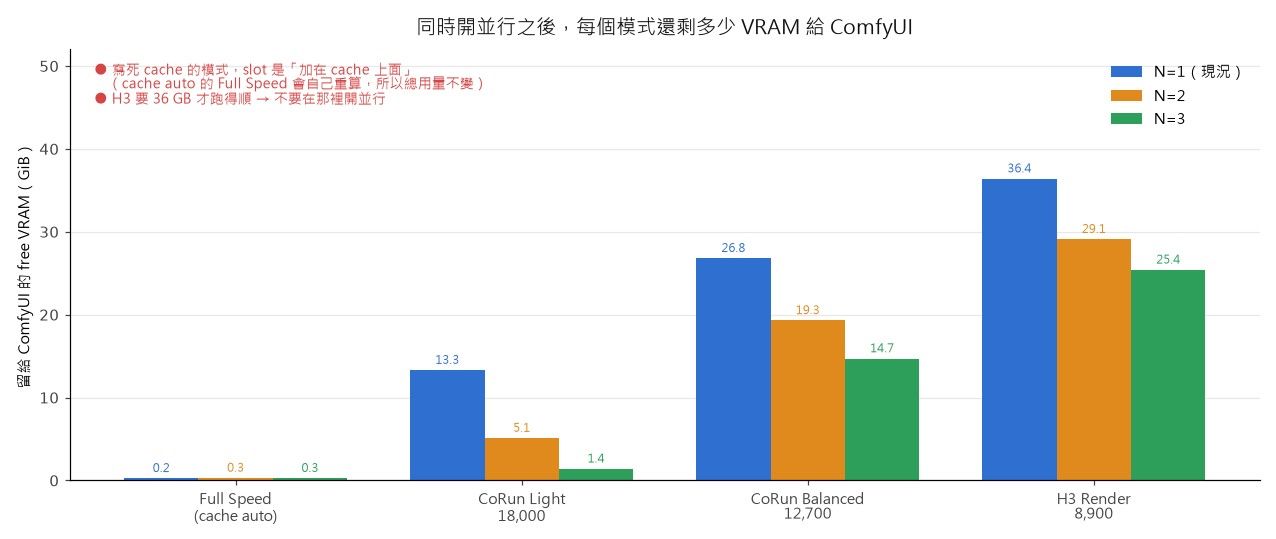
| 模式 | cache | N=1 剩 | N=2 剩 | N=3 剩 |
|---|---:|---:|---:|---:|
| Full Speed(cache auto) | auto | 0.2 GiB | 0.3 GiB | 0.3 GiB |
| CoRun Light | 18,000 | 13.3 GiB | 5.1 GiB | 1.4 GiB |
| CoRun Balanced | 12,700 | 26.8 GiB | 19.3 GiB | 14.7 GiB |
| H3 Render | 8,900 | 36.4 GiB | 29.1 GiB | 25.4 GiB |--expert-cache auto會在開機時重算 cache(所以 Full Speed 開並行總用量不變);但寫死數字的模式會保留 cache、slot 加在上面 → Light 由 13.3 掉到 5.1、H3 由 36.4 掉到 29.1。H3 需要 ~36 GB 才跑得順,就不要在那裡開並行。-
我自己最後的設定(給你參考):Full Speed 開
parallel: 3(日常零 VRAM 代價)、三個 render 模式都不開;另外做了light 2N/balanced 2N兩個變體,需要「出圖 + agent 同時跑」時才切。 -
️ 如果你自己寫 script 切換模式:模式身分不能只看 expert-cache slots。我踩到兩個坑 —— ①
light和light 2Ncache 一樣是 18,000(分不開);② Full Speed 用cache auto,slots 會飄(我是 18,384~22,798),開了parallel: 3之後是 18,384,比「≥20,000 就算 full」的舊判斷還低。0.1.39 的GET /v1/status有concurrency.serving,用 (cache, parallel) 兩個條件一起判斷。 -
長 context prefill 不要只取第一行:切模式/重載之後第一個長 prompt 會重新熱身 expert cache,可能量到 942 tok/s 這種假數字(log 原文:33.9 秒內由 SSD 讀了 89 GB)。緊接的第二、三個才反映穩定表現。
-
沒變的東西:預設仍是單流(要並行要自己開)、~245.7K 的 per-request 硬牆(
prompt + max_tokens ≤ 262136,超過是 400 而不是慢慢變差)、STRATA_ADAPT_WAIT仍 opt-in(所以 greedy 答案仍不保證逐位元可重現)、64 張圖/request 的 bug 仍在。
七、結論
0.1.38 → 0.1.39 prompt 讀取(file-tier) +22~44%(短)· +12~16%(128K/250K) decode 看不出有意義差異(波動內) 長 context 品質 不變(並行之下逐字相同) 並行 新增;上限 8 格;單條 −0~3%(2~3 格),3 條同時總吞吐 +12% 有沒有變差 沒有 值不值得升?對我值得,而且理由和官方寫的不一樣:
- 如果你是 file-tier(RAM < 96 GB 被自動開,或你像我一樣手動選它)→ #577 的修正直接送你 +22~44% 的 prompt 讀取,這是這次升級最大的價值,官方 release note 幾乎沒提。
- 如果你是 pinned arena → 這版對你主要是「多了並行 + Codex 支援 + NaN logits 保險」,效能上接近平手。
- 如果你跑很長的 agent 對話 → 0.1.39-nvfp4.2 的「NaN logits 自動重開引擎」是獨立於效能的保險。
升級動作就是「解壓蓋上去、保留
models\與.venv-serve、re-apply 上面那 3 個檔案」。






