
華碩雙DGX搭配tendordold引擎驅動deepseek v4.1 flash小測
-
最近論壇版面被strata這個新出的推理引擎霸榜,其實小盒子這區近期也是不斷再突破,例如tensorfold。
原本兩台DGX vram可輕鬆吃下deepseek v4.1 flash v4.0,v4.1 推出後,模型體積暴增,幸好開源的大神使用了exl3壓縮了體積可以放入,代價就是速度和上下文的犧牲,用起來體驗很差,而且這代deepseek也很愛思考,不像以前輕快。
然而事情再度反轉,tensorfold技術推出後,小弟在X上發現有老外結合了這項技術推出配方,幾天內就更新到了v0.4:
- Bertholomus AI (DeepSeek-V4.1 TensorFold 雙機配方)
https://github.com/bertholomus/deepseek-v4.1-tensorfold-tp2-2xgb10 - Bertholomus AI (TensorFold deepseek-v41-tp2 引擎分支)
https://github.com/bertholomus/TensorFold/tree/deepseek-v41-tp2
老實說技術啥的我也不懂,我爬到問就讓 hermes agent替我部署了,我只負責驗收成果。

測試環境:雙機推論叢集 (2× NVIDIA GB10 128GB Unified Memory,ConnectX-7 200Gbps 直連 RoCE TP2)
模型版本:DeepSeek-V4.1-Flash-EXL3-2.9bpw + 原生 Engram 詞表 + DSpark 5 Drafts (TensorFold v0.4, Commit d5d7bb3)
客戶端情境:使用Chatbox Agent 一句話"寫一個貪食蛇遊戲"讓deepseek v4.1產生html檔案(多輪工具調用 Tool-Calling、長上下文推理、思維鏈展開)
在本次 Agent 任務中,雙機叢集展現了高水準的穩定性與吞吐能力,特別是 v0.4 修正了前綴快取廣播問題後,Kept Prompt(前綴快取復用)在 1.8 萬 ~ 2.1 萬 Token 的長上下文下發揮了驚人效益:
- 總生成 Token 數:15,720 tokens(含思維鏈與代碼生成)
- 總運算耗時:426.2 秒(約 7.1 分鐘)
- 總 Prefill 耗時:38.7 秒
- 總 Decode 耗時:387.6 秒
- 整體平均解碼吞吐:40.6 tok/s(單輪最高達 63.6 tok/s)
- 前綴快取最高命中率:97.9%(長對話下首字延遲 TTFT 直接壓進 0.88 秒)
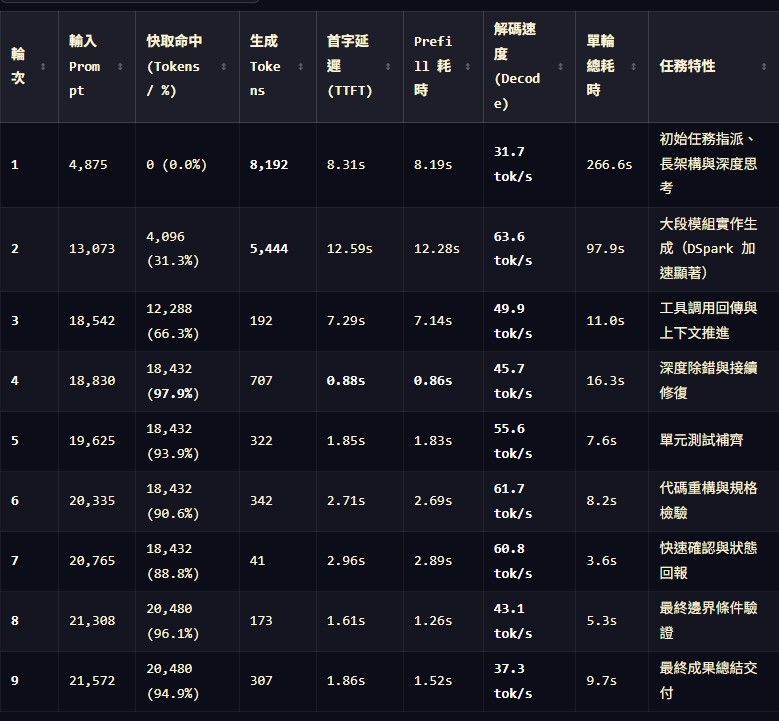
關鍵觀察與技術總結
- 前綴快取(Prefix Cache)徹底成熟: 在對話堆疊至 1.8 萬到 2.1 萬 Token 時,每輪後續互動的快取命中率均穩定維持在 90% ~ 98%。以往未啟用快取時,每輪光是 Prefill 就需要乾等 15~20 秒;現在首字延遲全部壓在 1~2 秒以內,體感極度流暢,且完全未再出現舊版的通道死鎖崩潰。
- DSpark Drafts(投機取樣)在長文本下的高接受率: 在第 2 輪高達 5,444 Token 的大量代碼與結構化輸出中,DSpark 草稿接受度極高,在雙機 200G 直連下跑出了 63.6 tok/s 的極速解碼,大幅縮減大段寫扣的等待時間。
成品: snake.html
- Bertholomus AI (DeepSeek-V4.1 TensorFold 雙機配方)
-
赞,本地模型全面爆发!
-
,
 T terry 固定了此主题
-
-
-
-
@Ali-Jiang 按照他给的方案,要不了多久苹果也能。互联有损耗,抵消掉英伟达的生态优势。最终应该是差不多,M5 Ultra的带宽在那。
最起码4.0 flash带视觉模块的exp权重可以跑,那已经很强了。到货来发下实测作业。
-
@Ali-Jiang 按照他给的方案,要不了多久苹果也能。互联有损耗,抵消掉英伟达的生态优势。最终应该是差不多,M5 Ultra的带宽在那。
最起码4.0 flash带视觉模块的exp权重可以跑,那已经很强了。到货来发下实测作业。
-
-
,系统 取消固定了此主题

 ,DGX小盒子在外文社群之間很火的,一堆大老在發力極致優化單機、雙機甚至4機,以v4.1 flash剛出時的配方,3機才比較舒服,4機完全體,2機只是能跑,可這兩天就出現我文中看到的新配方,效果著實還可以,從可以跑到進入實用階段。
