
本地AI入门显卡性能总结,Strata/Ninfer推理框架,12G显存起步,3060/4070/5060Ti/7900XTX/3090,Qwen3.8 Flash Next / 27B实测数据!
-
本期视频我们就谈一谈本地跑AI。就当下,2026年10月份,跑本地AI入门显卡的选择,主要参照模型是Strata推理框架下的千问3.8 Flash Next,或者千问3.8 27B,也会用一些NInfer这些新的框架。我们基本上不谈llama.cpp、vLLM、SGLang这种相对传统的推理框架了,这就是为了降低大家入门的门槛。
首先有人用3060 12G跑千问3.8 Flash Next的IQ3,速度还非常不错,而且有人是单卡跑的,但是他的tokens就有点低了。我们论坛的大神贾安阳用3060 12G双卡跑这个模型,选的是IQ3S,大概吐字速度是50 tokens/s,就非常不错了。然后我的频道视频下方有观众留言,他用5070 Ti跑,大概也能跑到100多 tokens/s。那么5060 Ti怎么说也得跑个六七十、七八十吧,起码60 tokens/s能跑。所以还是比较新的显卡、独立显存最好上16GB要好一点。
贾安阳这个帖子总结得比较详细,你到这上面看一看,看看TID 2156。我论坛这些帖子的地址都是这种数字号,到这里前面部分是通用的,你就把这个2156记住,然后给它输入进去,就能访问到这个帖子。看看它的详细教程,并且他也做了总结,大概就是40多、50多 tokens/s,这已经非常可用了。毕竟3060 12G这卡也便宜得很,而且功耗比较低。你插两张的话,尺寸也不大,一般大的机箱都能装下,一般的电源都能负担。它是风扇版本,没什么噪音。你把它用收洋垃圾的价格给收过来,跑一跑本地AI大模型还是能用的。跑ComfyUI估计是不行了,但是画画图、生成AI精品也没什么问题。
然后我们看看上到16GB的情况。刚才不是说了吗,5070 Ti 16G跑千问3.8 Flash的话体验不错,5060 Ti肯定也是能跑的。这个朋友用5060 Ti 16GB跑千问3.8 27B,跑这个稠密模型,难度比刚才那个更高。在内存足够的情况下,跑千问3.8 Flash Next建议内存一定要在64GB以上,要不然体验不会好。如果显存特别大,内存少一点没有关系,但总体上建议在64G内存以上。这个人跑出来的是96K上下文,吐字速度也是几十 tokens/s,还是非常不错、比较流畅的。具体数字大家自己到这上面研究。长上下文的时候,它依然能够维持在60 tokens/s左右,这相当不错了,也给了实际测试结果,就是实际干活的截图。
当然还有朋友用3060 12G加4070 12G这种异构来跑千问3.8 Flash Next。这个我跟大家说一下,Strata这个架构是专门为千问3.8 Flash Next这个模型定制的,这个架构只跑这一个模型,这就是它能这么牛逼的原因。其他推理框架要识别模型,然后加载对应的适配器,每个模型的特征还不一样,中间的判断、各种预热就要浪费很长时间。但如果框架知道就是这一个模型,很多信息都是预置的,那体验确实会快很多,相当于提前给它定制化了一个系统级别的缓存、框架级别的缓存。
它跟llama.cpp其实在原理上是一样的,就是串行计算,不是双卡TP,不是并行,同时只有一张卡在跑。第二张卡的意义就是,比如说你4070跑完了,你4070跑个50层,我这个3060跑剩下来的30层,一共80层。就是在分层计算的时候,你的显存越大,总的显存值越大,模型本身的效率就越高。然后内存你看也是64G。关于生成速度,他说大概30 tokens/s。他这个速度怎么比刚才的还慢呢?
既然说到内存,我们必须再提一下,有人问DDR3内存能不能跑。你看这就有实测的帖子。很多时候你们不要就在视频下方发一个问题,有些问题其实非常傻。为了回答你那几个字,我要给你打七八十个字,甚至100多个字,你们觉得有可能吗?每个人都在那里留言问一个问题,然后我给你们详细解答,这不可能的。你们自己到论坛来找答案。
64G DDR3、X99 D3主板,我是X99 CD3。这种主板、这种平台都非常便宜,这种洋垃圾CPU基本都是送的,你买主板就送。它跑起来的效果依然非常不错。我们看具体数字,吐字速度最高是80多 tokens/s,在16K上下文情况下跑出来的。达到128K上下文的时候,这已经是绝大部分开发任务都足够用的情况下,解码速度是52.3 tokens/s。到256K上下文之后,依然有47.7 tokens/s,这就非常牛逼了。当然他开了MTP,大家可以看一看。他的KV用的是INT8,INT8的KV包括FP8的KV,基本上不损失精度,大家可以放心用。
说到7900 XTX,那就必须提3090。3090是神卡,它跑的速度其实差不多。在128K上下文的时候,coding编码能够达到100 tokens/s,对话达到60 tokens/s,跟刚才7900 XTX的数据差不多,但是这边没有跑256K上下文。其实跑千问模型,我觉得跑128K上下文就好了。为什么呢?因为超过128K上下文,它的召回准确率就不行了,这是实话实说。我的经验还是比较丰富的,讲实话,我过往发了那么多测试视频,这个模型什么尿性我还是非常熟悉的。千问家族基本上都这个鸟样,最多最多跑个160K上下文就是阿弥陀佛了,再往后基本上就会变成傻逼。
然后这个哥们单卡3090 24G,用的内存也是64G,这玩意内存还是比较重要的。大家尽量把显存上到24G,内存上到64G,体验会好一点。当然有朋友用5070 Ti也跑过,但是那哥们用的内存可能比较大。24G显存为什么现在还重要?如果你已经有了5070 Ti、5080或者5060 Ti这种比较新的卡,就没有必要再怎么升级了,你就是跑大模型嘛。除非要跑ComfyUI。跑ComfyUI的话有两个选择:第一,用DDR5平台、PCIe 5.0接口的主板,搭配一张16G以上的Blackwell架构,也就是50系列的卡,5070、5080都能跑,可以使用内存作为显存缓存,当然这样比较慢,但是也能跑。还有一种就是一步到位,上24G显存以上的卡,比如RTX Pro 4500、RTX Pro 4000、3090 24G、4080S 32G。
3090跟7900 XTX这两张神卡之所以牛逼,除了能跑千问27B,搭配大内存跑千问3.8 Flash Next也能跑,吐字速度非常不错,还有就是能跑MiniMax H3、LTX 2.3。接下来看看这个哥们用5060 Ti 16G单卡跑千问27B,他用的是NInfer,不是Strata。NInfer就是专门为英伟达开发的推理框架,为英伟达显卡做定向优化。它16G显存搭配32G内存,看它是DDR5,基本上能猜出来一定是D5平台。PCIe最好是4.0、5.0,然后DDR5内存带宽高一点、PCIe带宽高一点,这样在内存和显存之间分层搬运数据,效率才高。它96K上下文能够跑到五六十 tokens/s吧,我看看,是大概60 tokens/s,可用度非常高,而且96K上下文也足够用了。
对了,刚才提3090还忘记一点更重要的:3090这个卡比较特殊,它有NVLink。英伟达两张卡连起来跑大模型的时候效率相当高。这张卡的价值,我认为现在炒到一万几千块钱、一万出头,本来才6000块钱,我觉得并不过分。这个卡还是相当牛逼的,生态在未来一段时间内还是相当好。
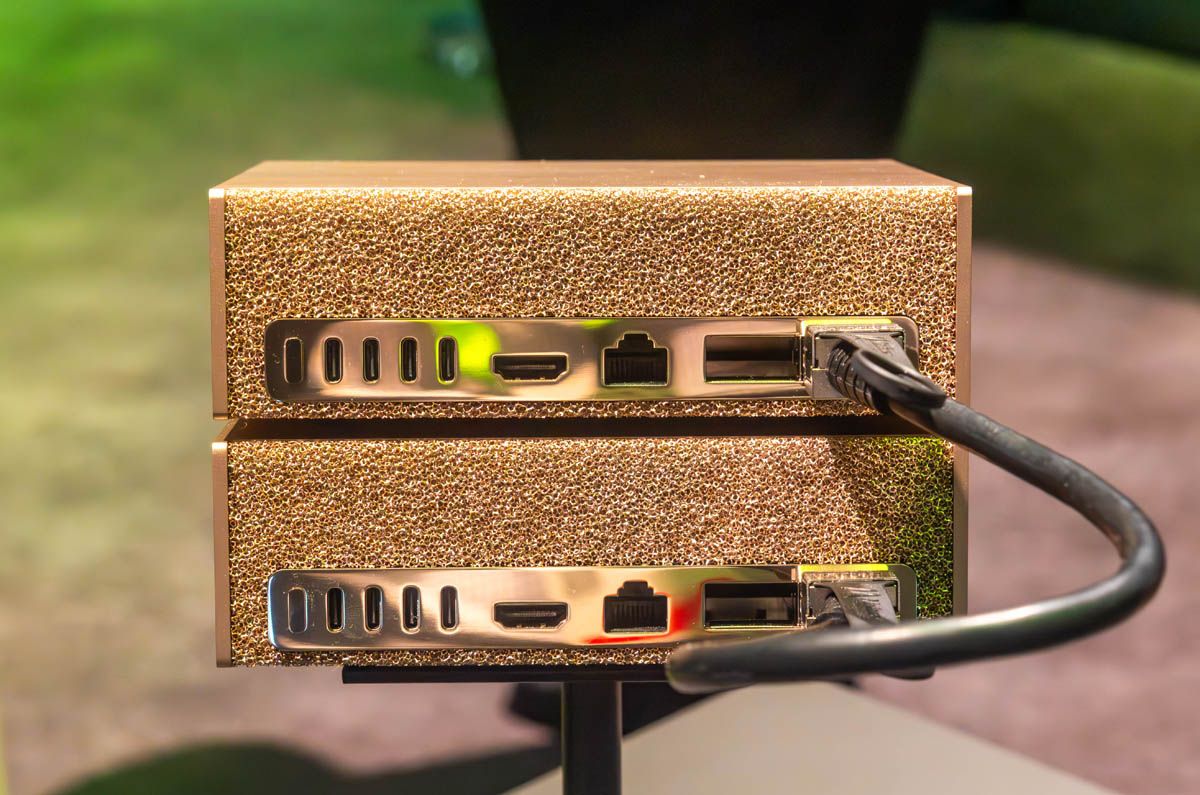
还有论坛有比较新的资讯。既然提到这里了,单独开一个视频就没什么意思,不值得。DGX Spark这个小盒子本来不是两个小盒子跑DeepSeek V4 Flash吗,大概六七万块钱,这就是相当甜点,很多高端个人用户自己就够得着。但是后来DeepSeek V4.1发起,突然间从284B干到了500多B、550B,体积翻倍了,两个小盒子不够,最少得要3个小盒子,最好是4个小盒子,这就击碎了很多DGX Spark玩家的心,觉得自己买的硬件吃了屎、贬值了。其实最近有新的东西出来,社区一直在围绕小盒子做优化,出了一个新的推理框架、新的引擎,大家可以来看一看。名字也比较奇怪、不好读,我就不读了。它能做到两个小盒子跑V4.1 Flash,开DFlash之后能够达到60多 tokens/s,非常不错,而且首token延迟压在一到两秒,体感上非常流畅,相当牛逼。
英伟达的小盒子DGX Spark比AMD强在哪里?就是它有类似NVLink一样的高速互联,有一根专门的线,那根线还挺贵的。但是线才能几个钱嘛,能把两个小盒子高速互联起来,这钱花得还是非常值得的。我们本地独立显卡迎来春天,小盒子也有自己的春天。尤其千问3.8 Flash Next火爆之后,AMD的小盒子、苹果的小盒子都有能够玩得比较爽的场景,最起码有了一个保底的模型。
-
