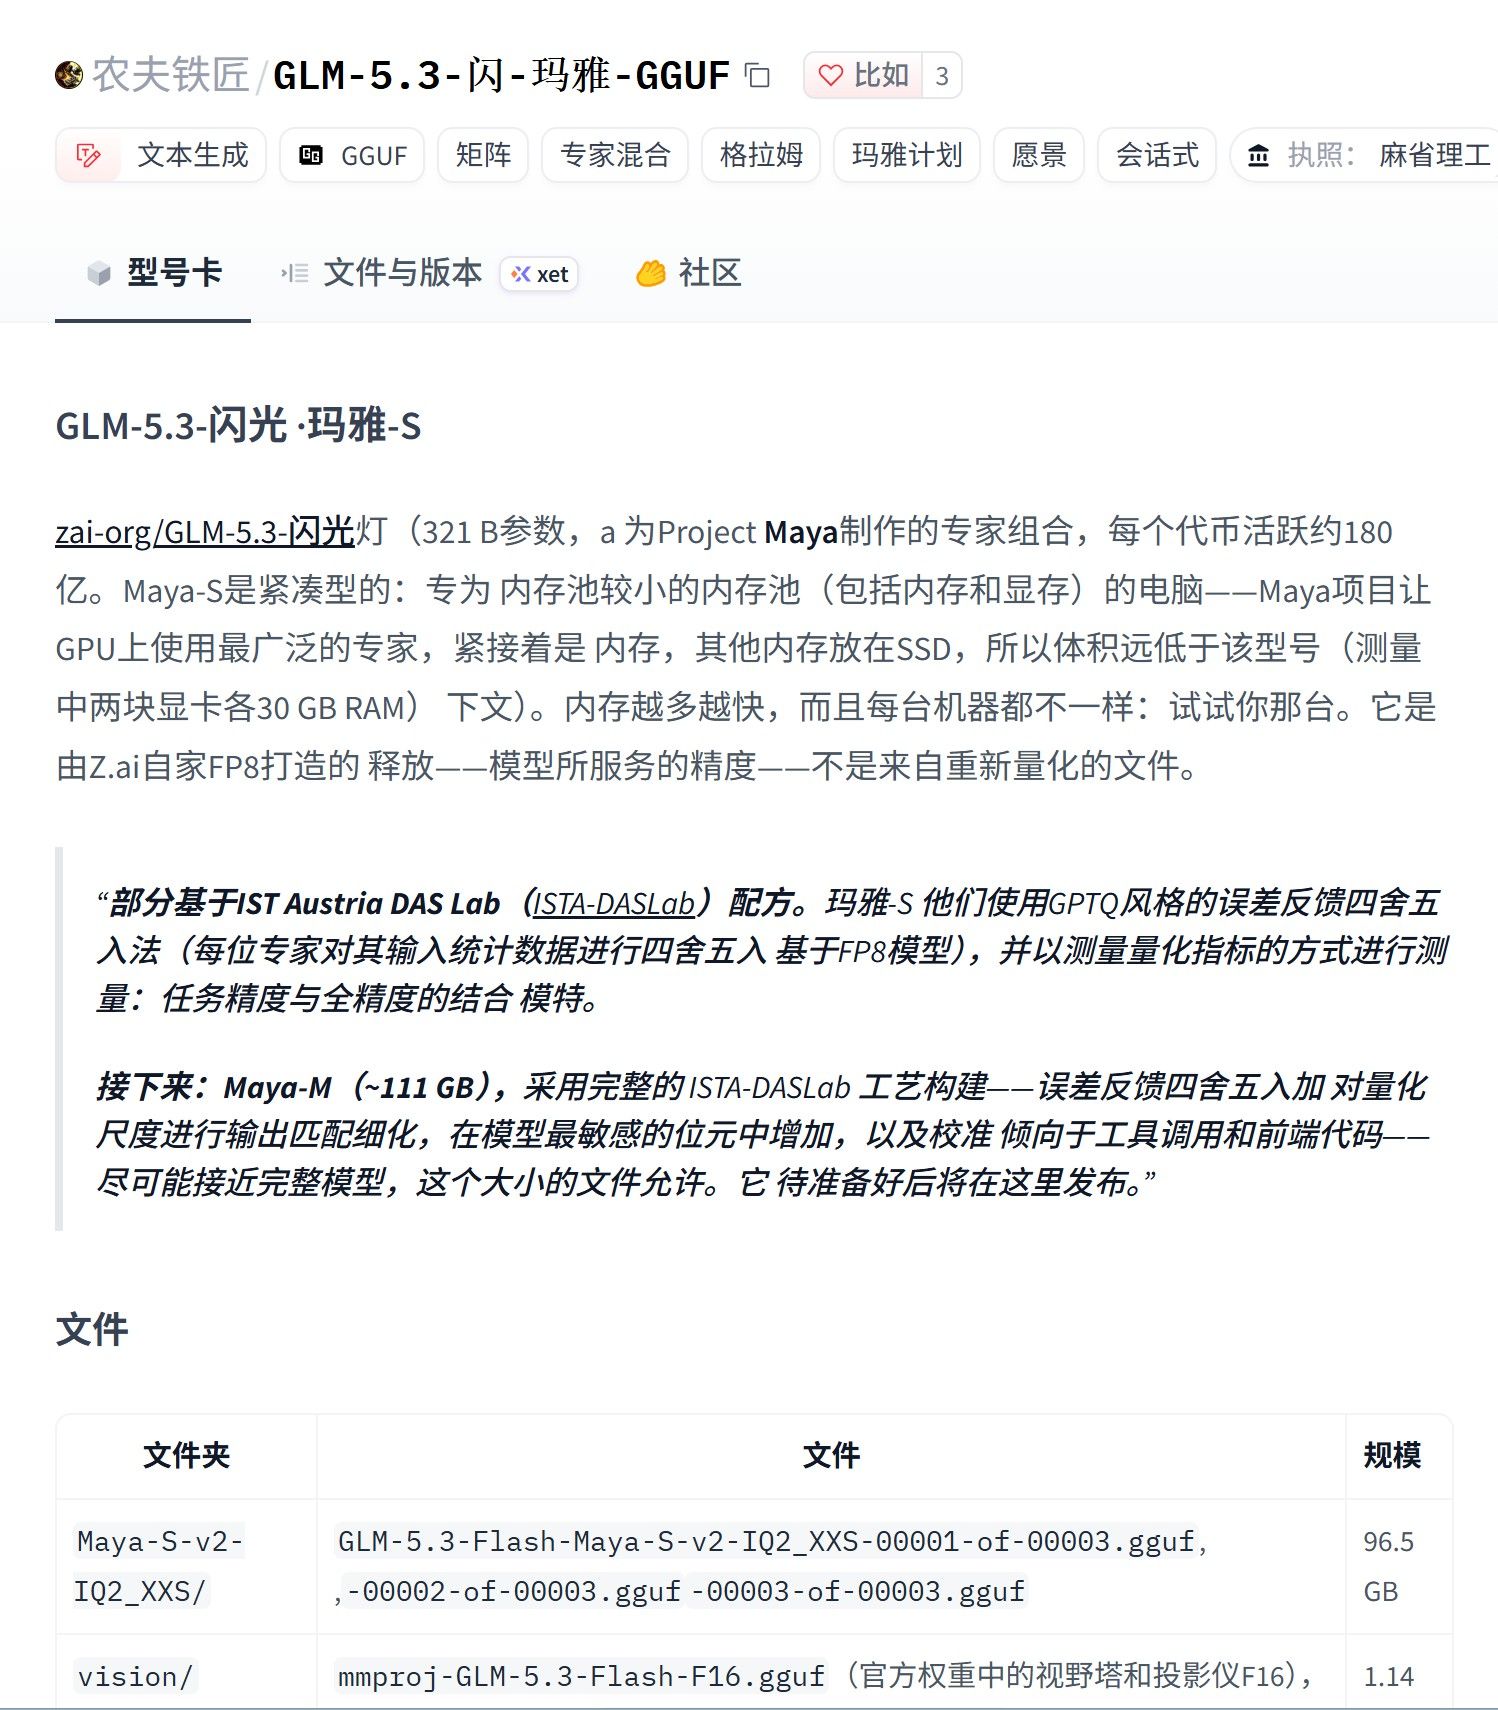
Strata 雙卡 RTX 5060 Ti 16GB Qwen3.8-Flash-Next :196K/256K 長 Context 實測
-
-
@johnnybegood 抱歉,18k台幣,我的數學是體育老師教的
-
-
-
-
-
-
-
-
-
-
RTX 5070 Ti 16GB 方案才是最有性价比
這是因為Nvidia 的產品規劃有問題
RTX 5080 和 RTX 5070 Ti 共用 GB203晶片, 一樣都是16GB VRAM 但5080價格差異不少(!?) ; decode 卡在 VRAM 頻寬只差異 7%
不過看網站Qwen3.6-Flash-Next (QFN) 的數據資料還不夠多, 後期排名應該會改變,
以打遊戲來說 當然要選 RTX 5080; 以VRAM來說就選 5060 Ti 16GB, 我看"yu
" 的數據跑分 QFN應該會是最有性价比, 但要依靠使用者們去上載測試數據 就會變第一了ChatGPT : RTX 5080 vs RTX 5070 Ti — GB203 GPU 規格比較
兩張顯卡均採用 NVIDIA Blackwell GB203 GPU,RTX 5070 Ti 為停用部分運算單元的版本。
GPU Specification Comparison
規格 (Specification) RTX 5080 RTX 5070 Ti 5080 優勢 GPU Die GB203 GB203 相同 Architecture Blackwell Blackwell 相同 SM 數量 84 70 +20% CUDA Cores 10,752 8,960 +20% Tensor Cores (5th Gen) 336 280 +20% RT Cores 84 70 +20% VRAM 16GB GDDR7 16GB GDDR7 相同 VRAM Bus 256-bit 256-bit 相同 VRAM Speed 30 Gbps 28 Gbps +7.1% VRAM Bandwidth 960 GB/s 896 GB/s +7.1% L2 Cache 64 MB 48 MB +33.3% Boost Clock 2,617 MHz 2,452 MHz +6.7% FP32 Compute 56.3 TFLOPS 43.9 TFLOPS +28.2% AI Performance 1,801 TOPS 1,406 TOPS +28.1% TGP 360W 300W +20% 功耗 PCIe 5.0 x16 5.0 x16 相同 Local LLM Inference Analysis
1. Decode Performance (TG)
- RTX 5080 記憶體頻寬比 RTX 5070 Ti 高 7.1%。
- 對 Memory Bandwidth-bound Decode 工作負載,
理論優勢主要來自 VRAM Bandwidth。 - CUDA Cores 增加 20%,不代表 TG 增加 20%。
2. Prefill Performance (PP)
- RTX 5080 SM 數量增加 20%。
- Tensor Cores 增加 20%。
- FP32 理論算力增加約 28%。
- Compute-bound Prefill 有機會獲得較大的效能提升。
3. VRAM Capacity
- 兩款均提供 16GB GDDR7。
- 單卡模型權重與 KV Cache 容量基本相同。
- RTX 5080 不具備 VRAM 容量優勢。
Conclusion
比較項目 RTX 5080 相對優勢 SM / CUDA / Tensor Cores +20% FP32 Compute +28.2% VRAM Bandwidth +7.1% VRAM Capacity 0% L2 Cache +33.3% TGP +20% 結論:
RTX 5080 具有明顯的運算能力優勢,
但 VRAM Bandwidth 僅比 RTX 5070 Ti 高 7.1%。對 Memory Bandwidth-bound 的 Local LLM Decode,
RTX 5070 Ti 可能提供更好的 Price/Performance。以上為硬體規格推導,並非實際 LLM Benchmark 數據。