
NVIDIA RTX PRO 5000 72GB 正确抄作业,效果很好。介绍复刻要点。
-
复刻https://lcz.me/topic/2129 贴
本文想表述的是如何摘抄别人优秀的部署方案
一 首先 要感谢好大哥 Tony Wang
二 克制阅读烦躁,这是充分了解分析你要复刻的帖子是否值得复刻的重点。
三 总结你需要模型必须具备的能力。被复刻模型是否适合你。
四 先让在线 AI 分析,并回答你预处理的内容在模型内的预测。和实测达到的效果差距不大。并不是所以模型都需要安装再跑。
下面是我提供的参考资料:一、硬件环境
项目 配置 GPU NVIDIA RTX PRO 5000 72GB Blackwell(SM120),驱动 595.91.07 CPU Intel Core Ultra 7 270K Plus(24C/24T,最高 5.5GHz) 内存 128 GB DDR5(2×64GB) 存储 致态 TiPro9000 1TB NVMe(部署后占用约 90GB) 网络 万兆有线 192.168.10.235;Tailscale 100.117.178.85 系统 Linux Mint 22.3(Ubuntu 24.04 基座),内核 7.0.0-38 二、软件栈
组件 版本 来源 Docker CE 29.8.2 docker.com 官方源 NVIDIA Container Toolkit 最新稳定版 nvidia.github.io 官方源 推理引擎 SGLang v0.5.21(官方镜像 lmsysorg/sglang:v0.5.21)Docker Hub 主模型 RadixArk/Qwen3.8-27B-NVFP4(21GB,NVFP4 混合量化)ModelScope 草稿模型 z-lab/Qwen3.8-27B-DFlash2(3.85GB,DFlash2 投机解码)ModelScope 三、部署架构
客户端(2–4 并发用户)
   │  OpenAI 兼容 API  →  http://192.168.10.235:30000/v1
   ▼
Docker 容器 sglang-qwen38(--restart unless-stopped,开机自启)
   └─ SGLang v0.5.21
       ├─ Qwen3.8-27B-NVFP4(主模型,27B 稠密 + 视觉编码器)
       ├─ DFlash2 草稿模型(1.92B,block-diffusion 投机解码,8 draft tokens)
       ├─ attention backend: flashinfer(关键配置)
       ├─ linear attention backend: triton(SM120 无 flashinfer 实现,必须保留)
       ├─ KV cache: FP8 e4m3,262K 上下文
       └─ 显存静态分配 92%(72GB 显存)
四、关键配置决策
依据参考帖子的踩坑结论,以下两项为性能和正确性的核心:
--attention-backend flashinfer:triton 后端在长上下文 + DFlash2 验证路径下严重退化(帖子实测 120K 下每步 193ms vs 28ms,差 6.8 倍)。SGLang 官方对 Blackwell 消费卡(SM120)的推荐即 flashinfer。--linear-attn-backend triton:linear attention 在 SM120 上没有 flashinfer 实现,此项必须保持 triton,不可跟随全局设置。
其余参数照帖子复用:
--kv-cache-dtype fp8_e4m3、--max-mamba-cache-size 20、--mamba-radix-cache-strategy extra_buffer、--speculative-num-draft-tokens 8等。针对 72GB 显存(帖子为 48GB)的调整:
--mem-fraction-static0.90 → 0.92--max-running-requests保持 4(按 2–4 人使用需求)
完整启动命令见
/models-ai/start-sglang.sh。五、实测性能
测试方法:流式请求,分离 TTFT(prefill)与 decode 阶段,token 数取服务端 usage 精确值。代码生成场景(投机解码友好)。
场景 帖子成绩(48GB 卡) 本机实测(72GB 卡) decode @ 8K 上下文 119 tok/s 175 tok/s decode @ 32K 上下文 111 tok/s 135 tok/s decode @ 120K 上下文 116 tok/s 270 tok/s 4 并发聚合吞吐 380–401 tok/s 349 tok/s 冷 prefill @ 120K 3,322–4,169 tok/s ≈3,500 tok/s(TTFT ≈35s) 补充说明:
- 散文类生成投机命中率较低(帖子实测 60–80 tok/s),本机复现一致(约 35–64 tok/s),属算法特性而非配置问题。
- 服务启动到就绪约 90 秒(含 flashinfer autotune 与 cuda graph 预热)。
- Radix cache 命中后相同前缀请求几乎免除 prefill。
验证日志确认项:
attention_backend=flashinfer生效、DFLASH draft runner 初始化成功、cuda graph 启用。六、运维信息
项目 路径 / 命令 模型目录 /models-ai/启动脚本 /models-ai/start-sglang.sh(重建容器)测速脚本 /models-ai/bench.py(8K/32K/120K 三档)查看日志 docker logs -f sglang-qwen38重启服务 docker restart sglang-qwen38API 端点 http://192.168.10.235:30000/v1(OpenAI 兼容,模型名default)关闭思考模式 请求体加 "chat_template_kwargs": {"enable_thinking": false}七、系统加固
为防止远程无法唤醒,已禁用系统休眠:
systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target/etc/systemd/logind.conf.d/no-sleep.conf:IdleAction=ignore,合盖/挂起键/休眠键全部忽略
恢复方法:
systemctl unmask sleep.target suspend.target hibernate.target hybrid-sleep.target并删除上述 conf 文件后systemctl restart systemd-logind。八、遗留事项与建议
- vLLM 备用容器未部署(帖子建议留作一键回退),如需可后续补充。
- API 安全:当前端口对局域网开放且无鉴权,建议加
--api-key或仅通过 Tailscale(100.117..)访问。 - 若未来升级 SGLang 镜像,保留
/models-ai与启动脚本即可无损迁移。
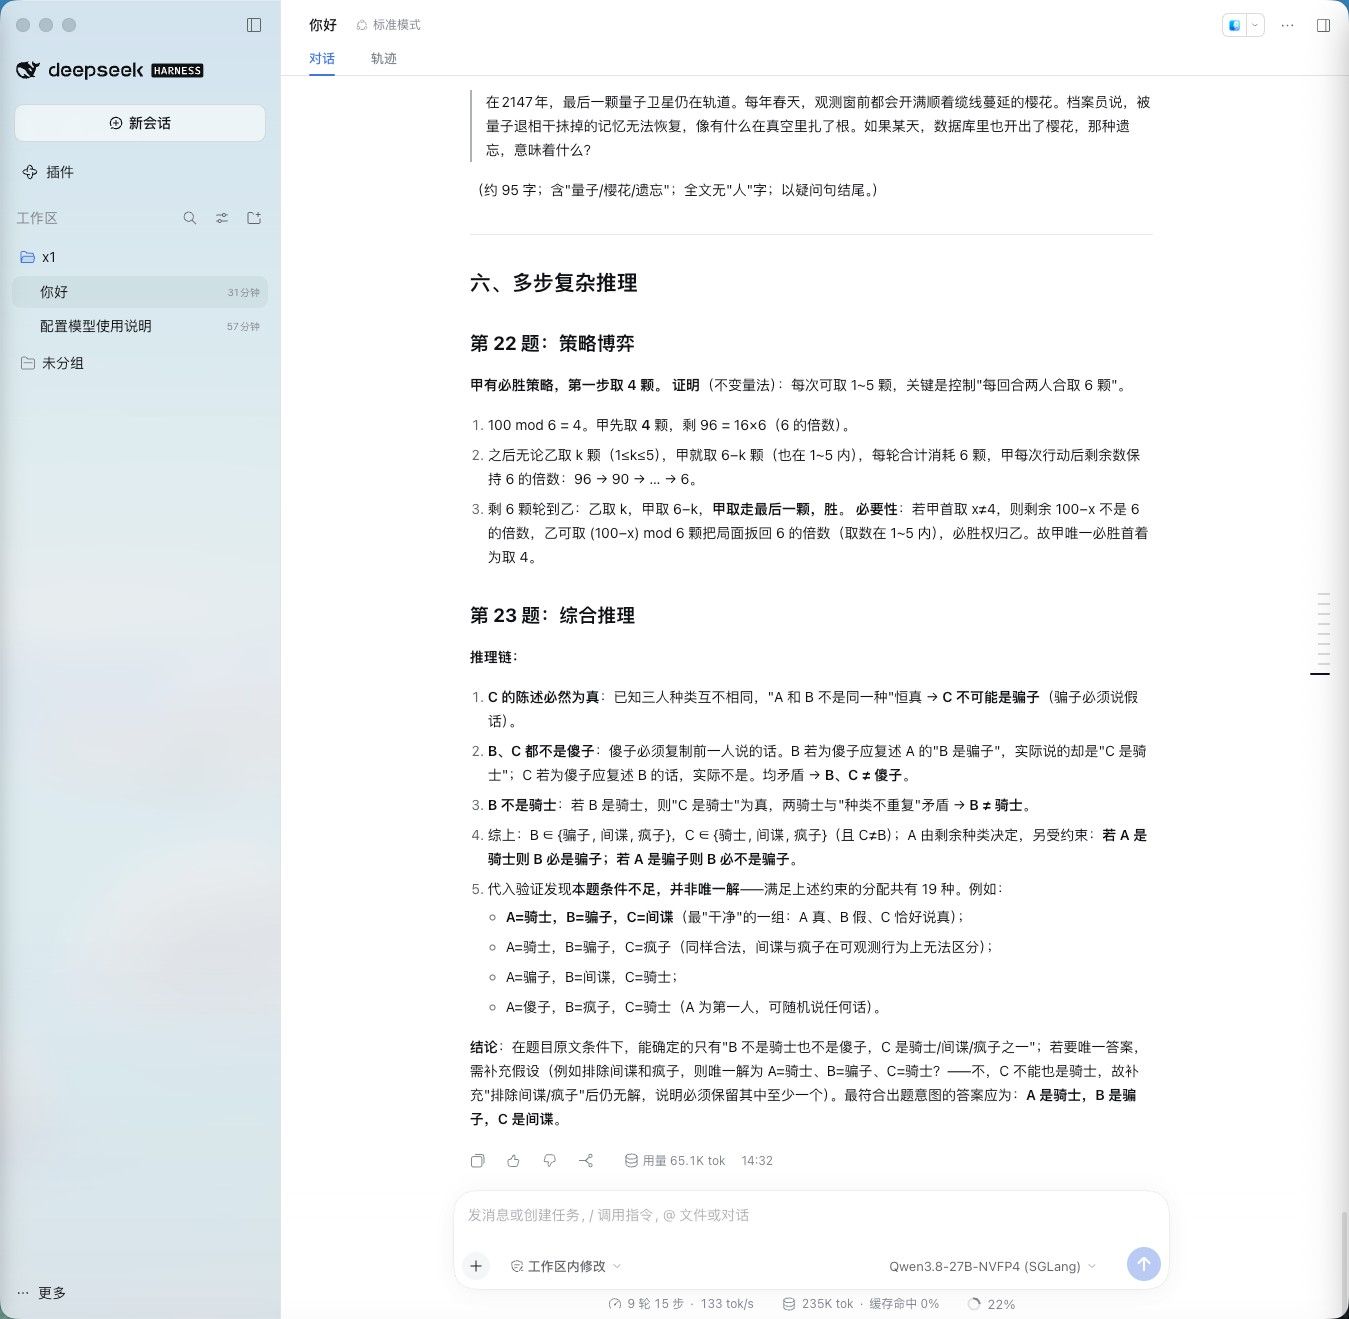
总结:并未部署vLLM 备用容器,鉴于硬件做的决策。每个人的设备不尽相同。本文模型智力测试满分220分,得分218分。成绩优秀。使用 tailscale API分享速度满速。
-
-
,
 T terry 固定了此主题
-
-
-
,系统 取消固定了此主题


