本地AI内存和主板怎么选,DDR3/4/5,PCIE3/4/5规格差异,对显卡跑AI的性能影响多大,LLM和ComfyUI的木桶效应短板在哪里?
-
评论区有网友留言问,这么多已经谈了的GPU,包括小主机、AMD、英伟达、苹果的这些生态,它们对应的设备跑AI的性能,那么能不能谈一谈如何选择主板和内存?这个刚刚玩了游戏,赢了几局,然后心情不错,那么我们就抽个幸运观众解答一下。深夜做视频不容易,有点错误的话大家多担待一下,因为有很多问题我也需要AI来帮我整理,再加上我个人的经验确实是有限的,水平也有限,只能讲一讲我个人的理解。
那么首先我就是结论先行,比较干脆,方便想知道结果的人不用浪费时间。就是你DDR3、4、5,或者说PCIe 3.0、4.0、5.0这些板子,你就自己有多少钱就买什么产品就行了。在我们本地个人AI玩家单卡或者说是双卡这种工作状态下,内存跟主板不会成为瓶颈,在绝大部分场景中都不会成为瓶颈,你是吃不了大亏的。当然了,我们不能说企业也是这样,因为你如果上到四卡、八卡,那它就非常吃这个主板,尤其吃PCIe跟内存的带宽性能。这个是在企业场景中,在这种非常高端的,像我们论坛有一些高端的大神玩家,人家出了四卡RTX Pro 6000,那你说在这种情况下,你肯定上DDR5内存、PCIe 5.0的板子。这些东西的成本在四张卡面前,那就是九牛一毛嘛。
但是普通的我们,比如说在本地玩7900 XTX、3090双卡,或者两张4090 48G、两张RTX Pro 5000,这已经是非常牛逼的配置了吧?两张RTX Pro 5000那可要十多万块钱呢,这是我们个人玩家购得非常高的场景。在这种场景下,你基本上无论是双卡TP跑大模型,还是开两个ComfyUI工作流跑音视频画图,那DDR3的内存加上PCIe 3.0的主板,都不会成为明显的瓶颈。当然了,你这个四代跟五代的体验会好一点,但是三代的体验也差不到哪去,不会有价钱上那么夸张的差距。
那么原理是什么呢?就是我们现在跑所有的AI大模型,无论是文本大模型,还是ComfyUI这个音视频模型,如果模型的权重经过量化之后可以完全放到显存中来,所有的计算就发生在显卡内部,就是在GPU跟显存之间交换数据,它不需要跟内存交换数据。那么我们的内存可能只是处理一些GPU返回的信息,比如大模型的推理结果,或者两张显卡跑大模型双卡TP的时候,它可能要通过PCIe直连来交换数据,或者通过内存作为中转交换数据。在这种情况下,你主板的PCIe性能和内存性能会影响到大模型的通信效率。但是跑文本模型的那点传输数据,以DDR3的参数,就算你PCIe 3.0 x8,不是x16这种满血接口,它也够了。甚至PCIe 3.0 x4的通信效率,你的推理效率也差不到哪里去。可能本质上对这件事情影响比较大的,就是显卡之间能不能进行P2P,就是能够直连,不要经过CPU周转数据。这个影响要远比你选了PCIe 3.0、4.0,还是DDR3、4、5重要得多。
当然了,如果你听到这里一头雾水,也不用担心,接下来讲的事情你也不一定能够听懂,你就记住开头的结论就行了,就是影响不大。那么说完这个文本大模型,我们就说ComfyUI。ComfyUI的推理运算量一般来讲比文本大模型要高得多。同样的,如果模型量化之后能够完全载入显存,这个运算全部发生在显卡内部,那么内存跟主板和GPU之间的通信,最主要的就是在VAE阶段,也就是解码阶段。这个GPU会向内存中写入大量的视频帧缓存。那么在这种情况下,PCIe 3.0或者4.0、5.0之间的那点差距并不重要,因为第一是它的性能完全够用,我们跑720P还是什么1080P的视频,PCIe 3.0的带宽都足够了。然后DDR3、4、5的效率也不重要,因为瓶颈在PCIe接口上。然后内存容量的重要性要远远大于它是三代、四代还是五代。你的内存容量一定要够,一般来讲,内存跟显存之间最好保持2:1的比例,这是一个通用的计算方法。
然后还是讲ComfyUI。ComfyUI的运算中,就是在AI音视频画图这个过程中,尤其是当下我们的音视频画图都是用Diffusion模型,也就是扩散模型,它只能用单芯片连续的内存、连续的显存。比如你4090 48G,所有的计算发生在一个GPU、一张显卡的显存中,它没有办法双卡TP计算。当然了,双卡可以用来跑两个工作流,也可以用来跑同一个工作流的不同阶段,比如一个负责生成潜在空间、生成latent文件,一个负责VAE,也就是视频解码,也都是可以的。但是你没有办法像大模型那样进行双卡TP计算,所以在这一块,它对主板也是不挑的。就是DDR3,哪怕你是x8不是x16的接口,它也无非就是载入模型的时候慢一点,无非也就是在VAE阶段,这个GPU向内存中大量写入视频帧的时候慢一点。那慢的这几秒钟,甚至几十秒钟,相比于漫长的动辄几个小时的工作时长,总体工作时长,因为一般都是批量生成片段嘛,它的影响是微乎其微的。
接下来呢,我们还是看一看数字。DDR3 1600双通道的话,对应的带宽大概是25.6 GB/s,然后它是大于PCIe 3.0 x16的单向带宽的。那么DDR4 3200对应的就是51.2,5600就是DDR5,它对应的是89.6。也就是说,一般的带宽瓶颈是发生在PCIe上,而不是内存上。因为我们这里讲的是双通道,我们需要知道有些主板支持四通道,甚至八通道。比如我们讲的一些洋垃圾主板,像华南金牌的X99-AD3、X99-QD3、X99-TF,它们都是支持DDR3或者DDR4,然后都是四槽,支持四通道,它的带宽就会翻倍,达到DDR5双通道的水平,达到50 GB/s。它就比PCIe 4.0能够提供的最大带宽要高很多,就是瓶颈在PCIe接口上面。比如我的4090 48G,它就是PCIe 4.0的接口。无论如何,就是你使用华南金牌的这几个主板,或者使用精粤对应型号的主板,那么瓶颈是发生在PCIe上,而不是内存上。所以你买的时候挑好你的主板。
这还只是单路CPU的主板,我还没有让它列出双路的,我故意把双路的给排除了,因为双路的话你要装两个CPU,但是它对应的通道数也会翻倍,它甚至可以装八通道的DDR3内存。而且这里举例的是用1600举例的,我们一般买的都是1866这样的高频三代内存条,它的带宽还会再高一点。你想想八路的话,哪怕给它配PCIe 5.0的插槽、PCIe 5.0的显卡,它都不会拖后腿。但是我们也必须要提个事实,就是这些洋垃圾主板一般都是PCIe 3.0接口的,哪怕是x16,它的带宽比起4090本身支持的PCIe 4.0还是要小一半的。
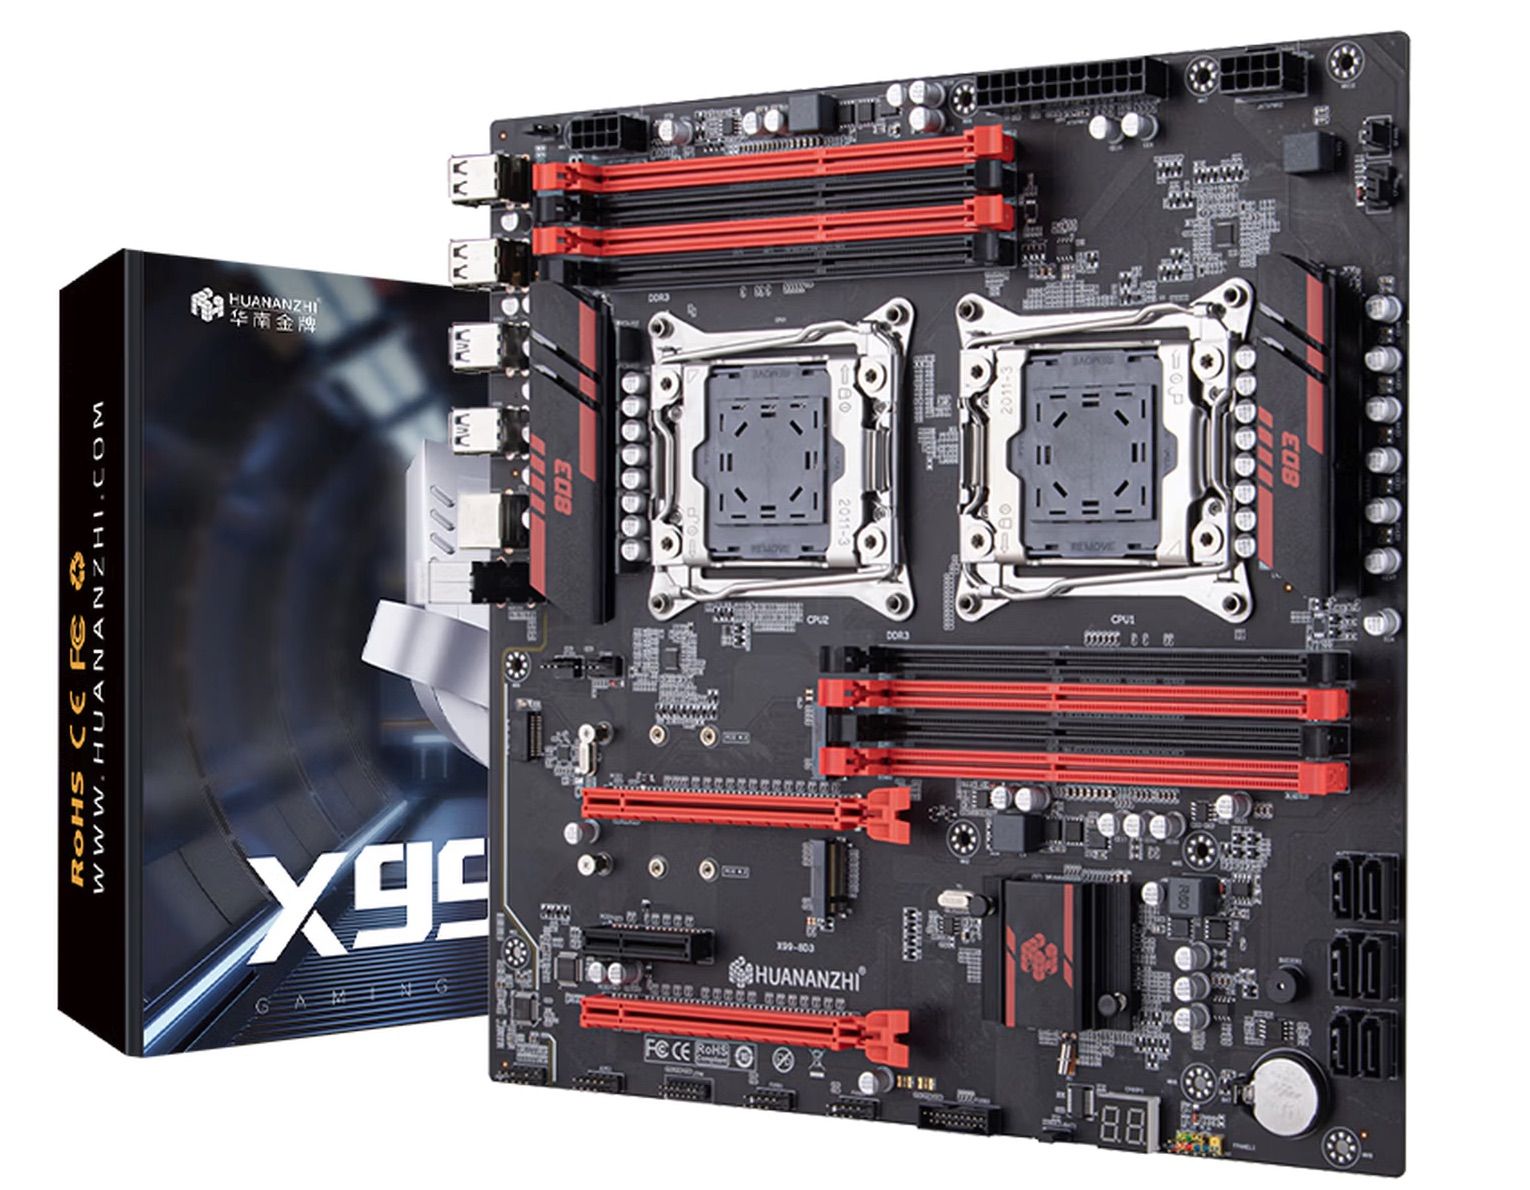
那么我们就可以往上,因为我这里给大家列举的是最差的、最老的X99平台的DDR3平台。那么如果你们买了两张4090 48G,或者两张RTX Pro 5000,你们应该怎么提升?很简单,因为4090 48G是PCIe 4.0接口,那么你就买AMD的EPYC洋垃圾,或者买AMD消费级CPU搭配X570主板,搭配DDR5内存,那你就能有一个非常不错的体验,就能把4090 48G的性能榨干。但如果你买的是RTX Pro 5000,它是PCIe 5.0接口,那你既然这个卡已经买了,如果你跟4090一样上DDR4平台的主板,它是可以用的,性能也不会差。但是如果你想心理上舒服一点,让它在任何环节都没有什么短板,那你就买贵一点的PCIe 5.0主板,搭配DDR5高频内存,可以发挥它两卡甚至四卡的潜能。但是我讲实话,带来的体验提升可以说是聊胜于无。一般来讲你双卡TP还是那句话,你跑的是文本大模型,哪怕你买一张X99的AD3,或者CD3这种垃圾卡,用来驱动两个RTX Pro 5000跑大模型,它都不是效率瓶颈。你买到的提升只是一种理论上的数值提升,不会给你的体感带来特别大的差异。
但是我们也要知道,现在DDR3毕竟已经是被淘汰的平台了嘛,DDR4还处于正当劲,DDR5还能占未来。如果你觉得未来硬件的价值是要不断往上走的,你想做这种财务投资,就是在买硬件、消费硬件的同时还希望赌一下未来、赌一下增值,那么你买新的,多花钱买新的就对了。
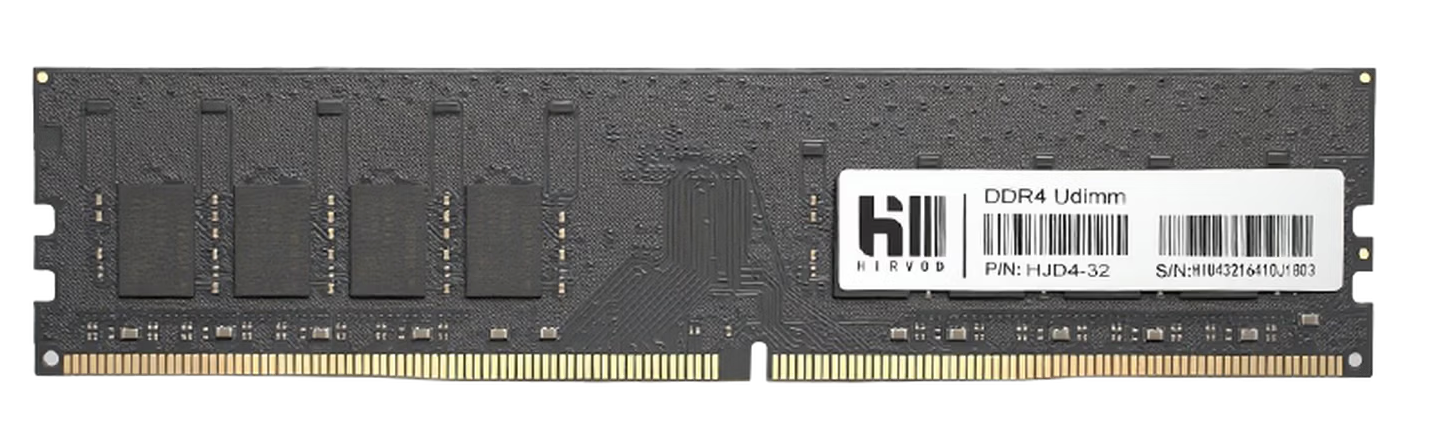
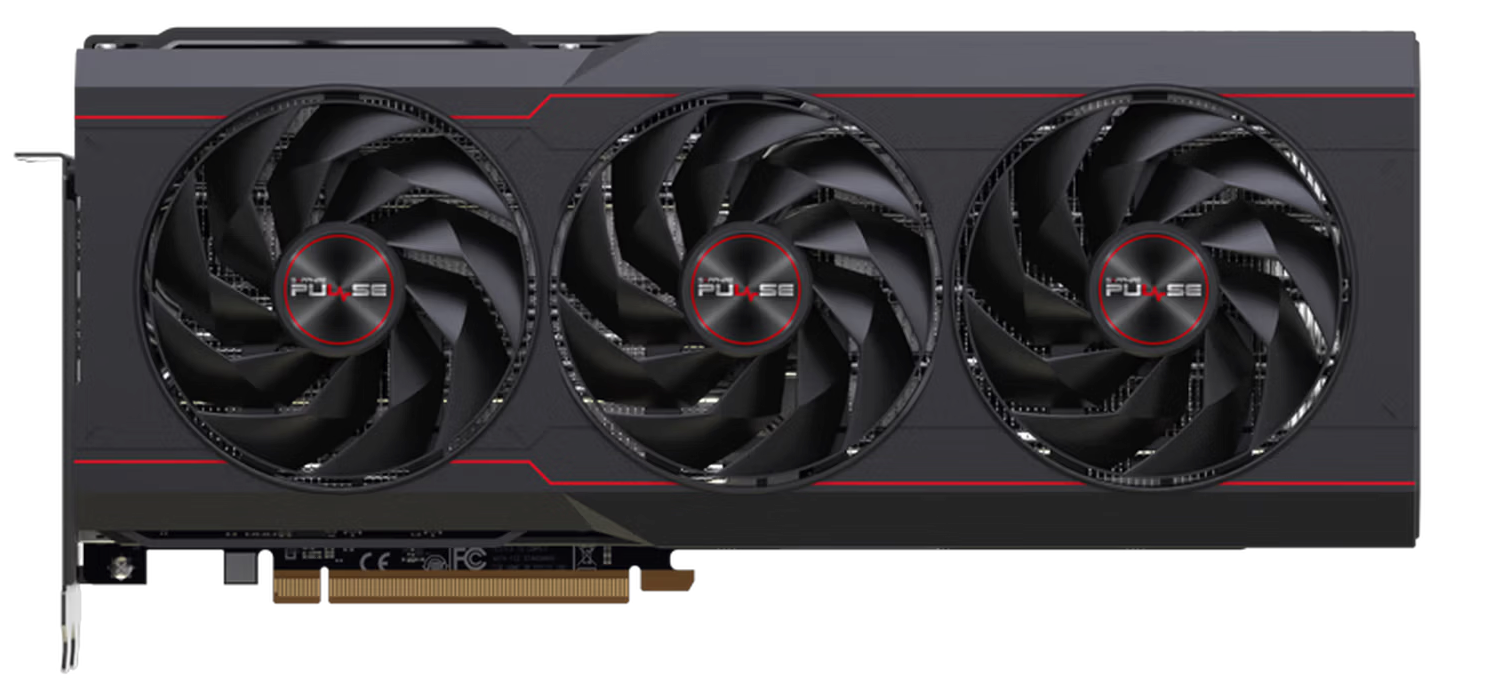
有一种情况比较特殊,忘记说了,后期补录一下。就假设你的手中有一张12G或者16G的入门显卡,那么你想要跑MiniMax H3、LTX 2.3这样的视频大模型,这些模型的尺寸经过4比特量化之后,依然没有办法放到你的显存中去,必须要使用内存作为offload。那么在这种情况下,你的选择逻辑一定是要最大化提升主板的PCIe接口性能,然后为之搭配对应的内存。比如你手中有一张4060 Ti 16G,那4060 Ti是PCIe 4.0接口,你肯定要选择一个最少支持PCIe 4.0 x16的主板,把4060 Ti放上去。然后你的内存选择DDR4,要把它的通道数、频率往上提,让内存带宽超过PCIe带宽,让PCIe成为木桶效应的最短板。
如果你手中是一张5060 Ti 16G,那就不一样了,那你就要选择PCIe 5.0 x16接口,为它搭配DDR5的内存。可是我也必须说,这种情况的改进,相比于把所有计算放在显存中、让GPU跟显存交互数据,效率要低得多。而且你也应该注意到,如果你是5060 Ti,要为它搭配高性能的主板和内存,多花的钱也不少。现在讲实话,64G的DDR5内存条得多贵啊。你有这个钱,不如直接买一张24G的7900 XTX或者3090,为它搭配一个洋垃圾整个平台。我之前不是算下来了吗?1000多块钱,板U套装加上内存1000多块钱。你这样也能最大化发挥效率,而且这样的使用体验肯定要比你用16G的卡、用12G的卡好得多。
这期视频就是我一个人对着这一张表格,还是AI总结出来的,很多地方标得都不是很准确,只是给大家做一个展示。这个是ChatGPT总结的,然后根据我本人的使用经验,跟大家分享交流一下。就是说得不一定完全准确,但是大致方向就是这样,就是不用担心你买了DDR3的内存,或者用的是PCIe 3.0的主板,就影响你跑AI,其实并不是的。很多时候,就以刚才我们举的例子,跑双卡TP、运行大模型,那它最大的瓶颈可能还是你的主板能不能支持显卡之间的P2P通信,就是显卡直连、PCIe直接交互数据,不要经过CPU中转。这个东西可能更加重要,并不是看着一两个数值。你要理解整个AI运行的流程,理解它的基本原理,才能够确定你在买什么硬件的时候,有些担心是完全多余的,是杞人忧天的。
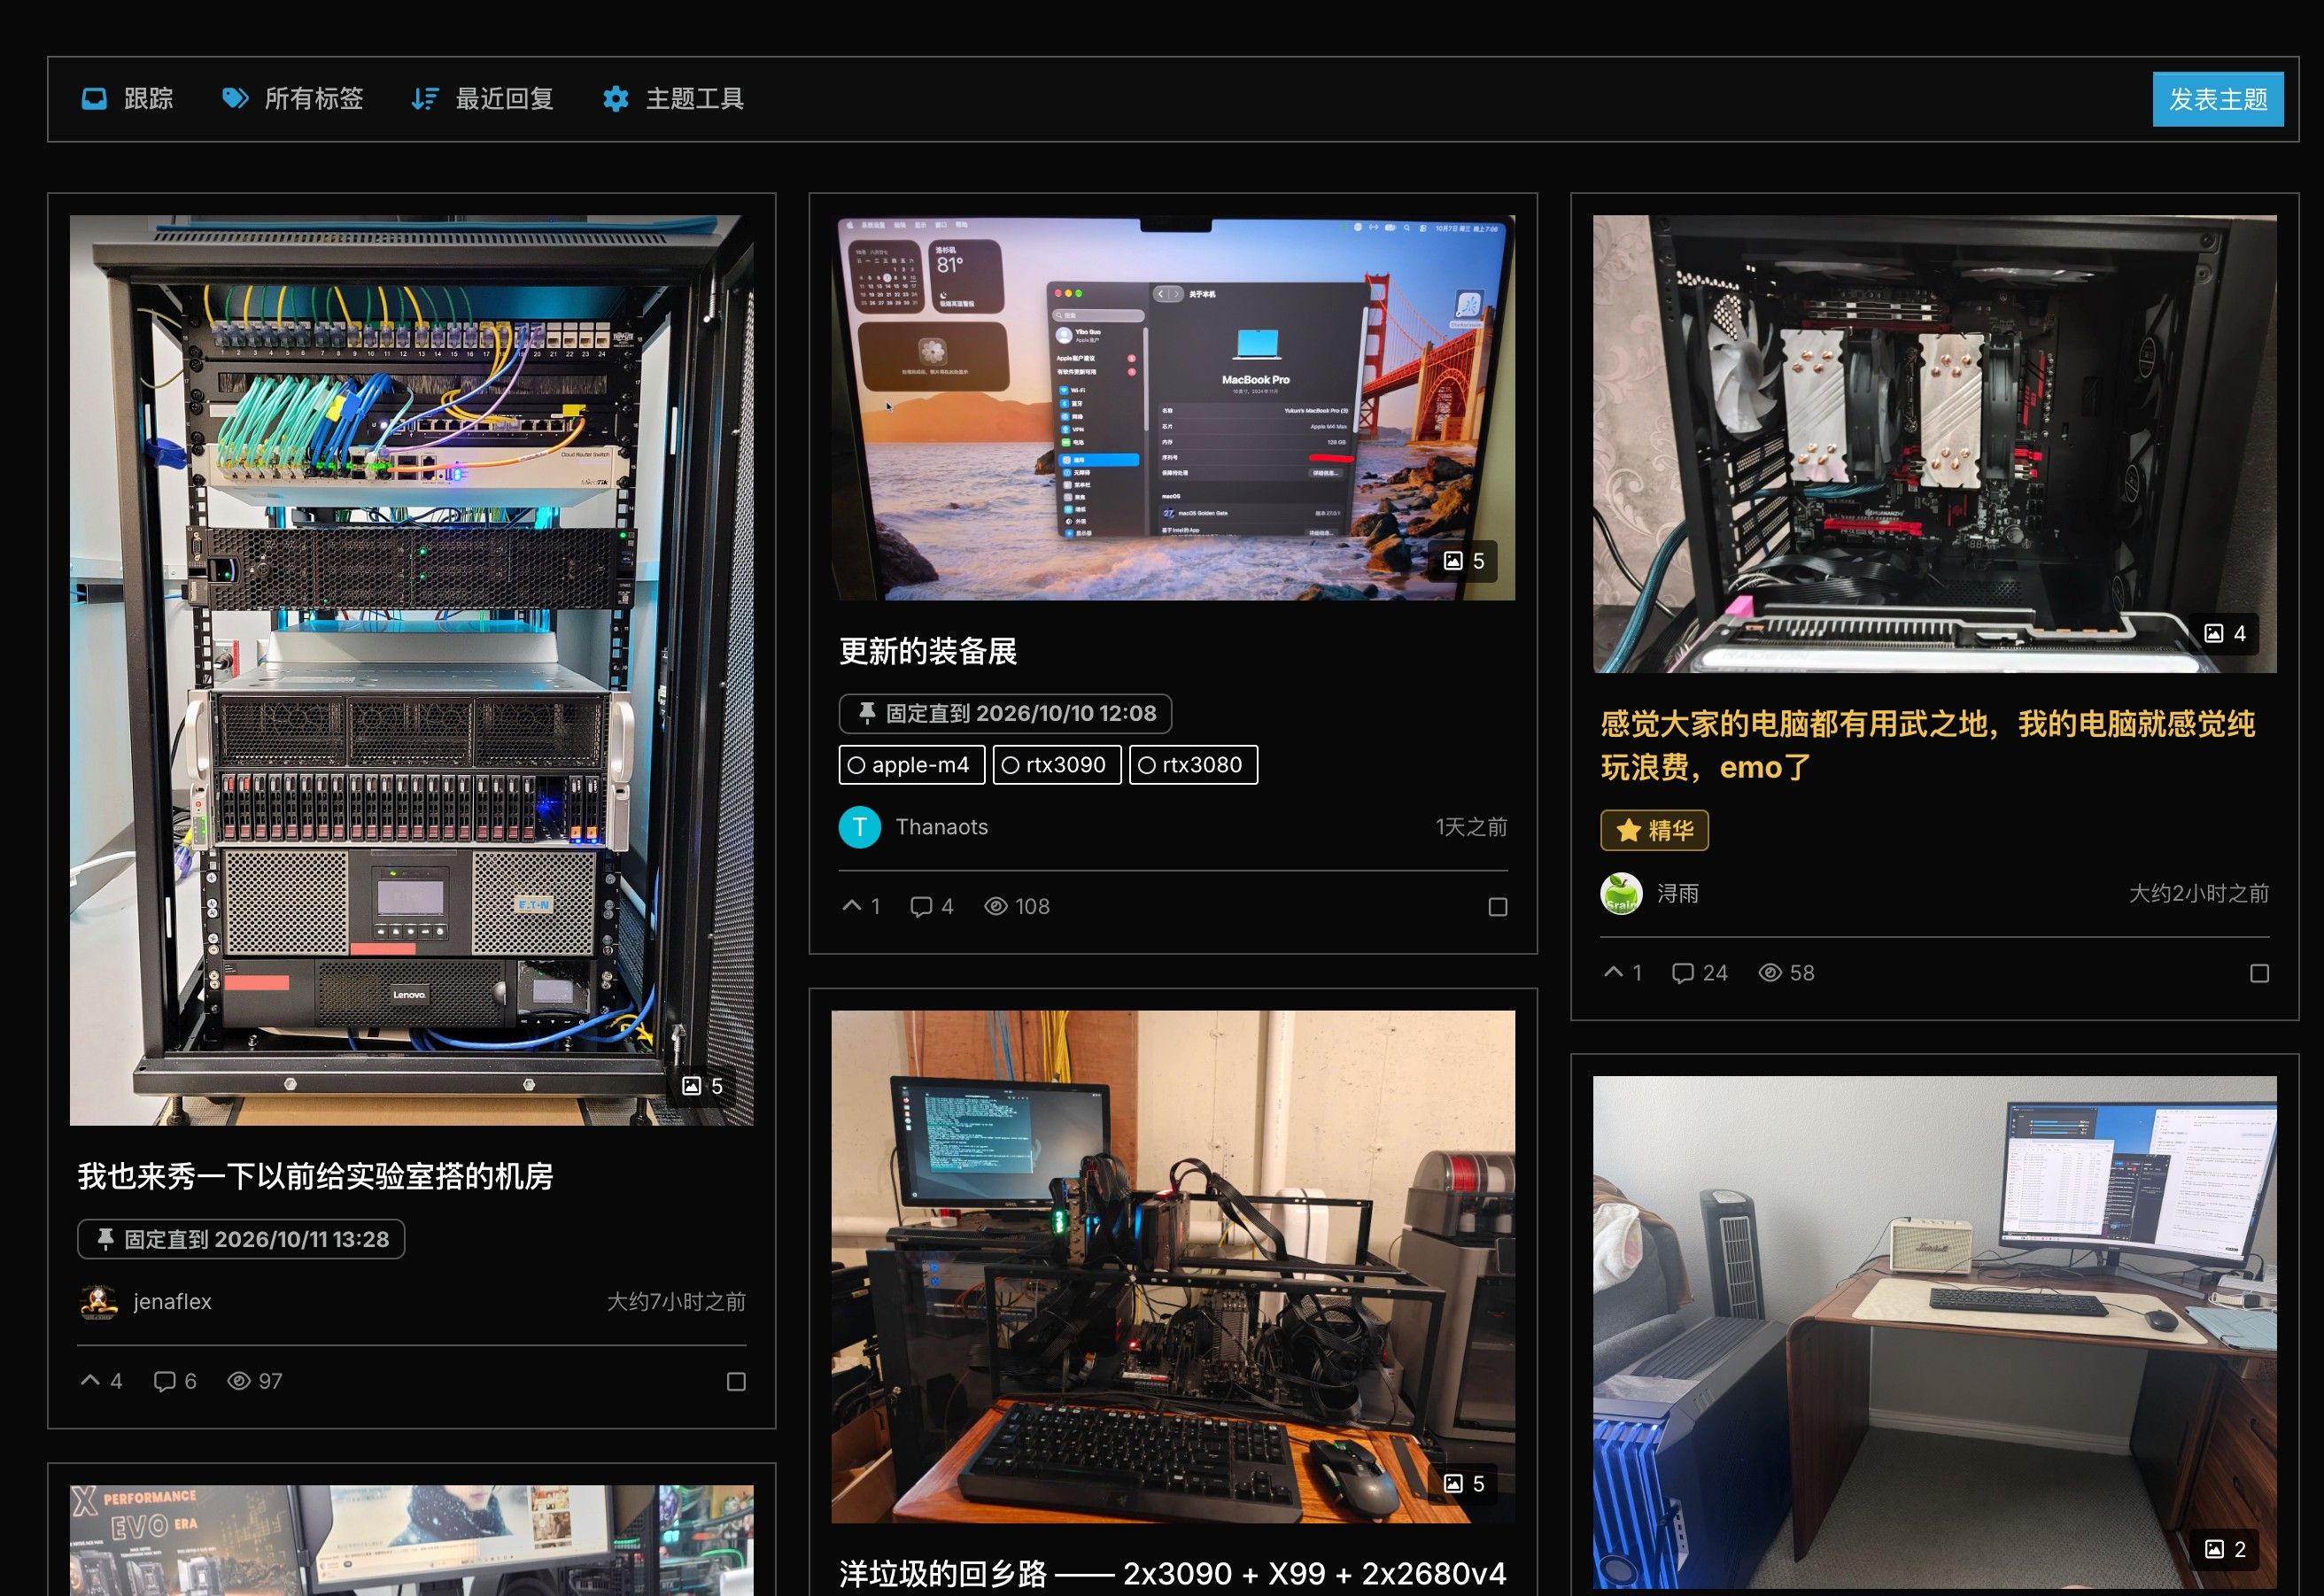
而且呢,我也必须要说,花太多时间去研究这些东西,讲实话意义并不是很大。你就到论坛去看大家是怎么装配的,这些大神们是怎么配的。在AI硬件中也有很多人贴出类似的帖子,他们发测试数据的时候,一般都会把自己的配置放进去。要解决什么问题的时候,他们也会把自己的设备都贴图贴出来,是什么设备,然后问题有哪些。你们到时候就跟着抄作业就是了,这些参数都贴得非常清晰,直接过来抄就行了。
好吧,本期视频就到这里。视频的后半部分就是为了给那些想要理解这些的新手朋友们提供一点心理安慰。讲实话,就算你们认真看上几遍,如果之前你不理解的话,看完之后你也不会觉得豁然开朗,因为这个东西,懂的人他自然懂,不懂的人你给他讲三遍、五遍是没什么意义的。
-
-
我很生气在马来西亚,什么都贵。。。
然而在ram 还没起价之前,出现很多洋垃圾server, 有128g, 256g dram 配套的,就好像单买5070ti的价格。。。
X99 平台,epyc 平台都有。。。如今买起来的价格仿佛可以买intel 15th ultra 平台那样。。。
我现在打算主装第二架,就有考虑主机板,要省电,又要至强,但是又不要13th ,14th 那样烂。。。上15th 只能用ddr5,
算来算去,还是当今12th intel 的ddr4 配套,原生支援pcie 5.0....
再看看年尾手上有剩下几十k美金,我再去选配多一个 -
我很生气在马来西亚,什么都贵。。。
然而在ram 还没起价之前,出现很多洋垃圾server, 有128g, 256g dram 配套的,就好像单买5070ti的价格。。。
X99 平台,epyc 平台都有。。。如今买起来的价格仿佛可以买intel 15th ultra 平台那样。。。
我现在打算主装第二架,就有考虑主机板,要省电,又要至强,但是又不要13th ,14th 那样烂。。。上15th 只能用ddr5,
算来算去,还是当今12th intel 的ddr4 配套,原生支援pcie 5.0....
再看看年尾手上有剩下几十k美金,我再去选配多一个 -
strata毫无疑问带火了内存。
-
我很生气在马来西亚,什么都贵。。。
然而在ram 还没起价之前,出现很多洋垃圾server, 有128g, 256g dram 配套的,就好像单买5070ti的价格。。。
X99 平台,epyc 平台都有。。。如今买起来的价格仿佛可以买intel 15th ultra 平台那样。。。
我现在打算主装第二架,就有考虑主机板,要省电,又要至强,但是又不要13th ,14th 那样烂。。。上15th 只能用ddr5,
算来算去,还是当今12th intel 的ddr4 配套,原生支援pcie 5.0....
再看看年尾手上有剩下几十k美金,我再去选配多一个@imbiplaza-ASUS 几w美金,我得送几w份外卖才赚的到啊

-
-
我很生气在马来西亚,什么都贵。。。
然而在ram 还没起价之前,出现很多洋垃圾server, 有128g, 256g dram 配套的,就好像单买5070ti的价格。。。
X99 平台,epyc 平台都有。。。如今买起来的价格仿佛可以买intel 15th ultra 平台那样。。。
我现在打算主装第二架,就有考虑主机板,要省电,又要至强,但是又不要13th ,14th 那样烂。。。上15th 只能用ddr5,
算来算去,还是当今12th intel 的ddr4 配套,原生支援pcie 5.0....
再看看年尾手上有剩下几十k美金,我再去选配多一个@imbiplaza-ASUS 我弟,你们那如果是洋垃圾涨价,你就可以买DDR4平台的x570主板,价格还能接受。但是你这样的土豪买东西也看价格?
-
老特一直说,过一阵就有计算中心淘汰下来的状态良好的h200什么的了,那个玩意需要什么主板,什么配置啊,要不要先囤起来,嘿嘿
-
@imbiplaza-ASUS 我弟,你们那如果是洋垃圾涨价,你就可以买DDR4平台的x570主板,价格还能接受。但是你这样的土豪买东西也看价格?
-
再看看年尾手上有剩下几十k美金,我再去选配多一个
GB300 100K 剛好可以買一顆喔

可以專心生產大型AI電影 -
老特一直说,过一阵就有计算中心淘汰下来的状态良好的h200什么的了,那个玩意需要什么主板,什么配置啊,要不要先囤起来,嘿嘿
-