[實測V] 你的 Windows 預設少給你 9%:用 Strata 的人請去 log 搜 large pages!
-
先給結論
-
在 Windows 上跑 Strata 的人,大概率都少了約 9% 解碼速度,而引擎在 log 里告訴你這很正常。
-
prefill 不是一個數字,是一條 34 倍的曲線(231 到 7,962 tok/s),取決於你給它多少新 token,不取決於設定。
-
三種格式里,解碼最快的仍是 IQ2_XS(167.8 / 130.8 / 131.5);NVFP4 只在讀長文件時贏。
-
這批流量 98.5% 在 60K context 以上,所以 131 是長上下文 agent 的數字,不是聊天的數字(短 context 實測 151.8)。
-
方法學、七個被否決的參數、我推翻自己的三個結論,在留言區。
你今天就能做的一件事
不用改任何參數:
secpol.msc→ 本地策略 → 用戶權限分配 → 「鎖定記憶體頁」→ 加入你的帳號 → 重新登入。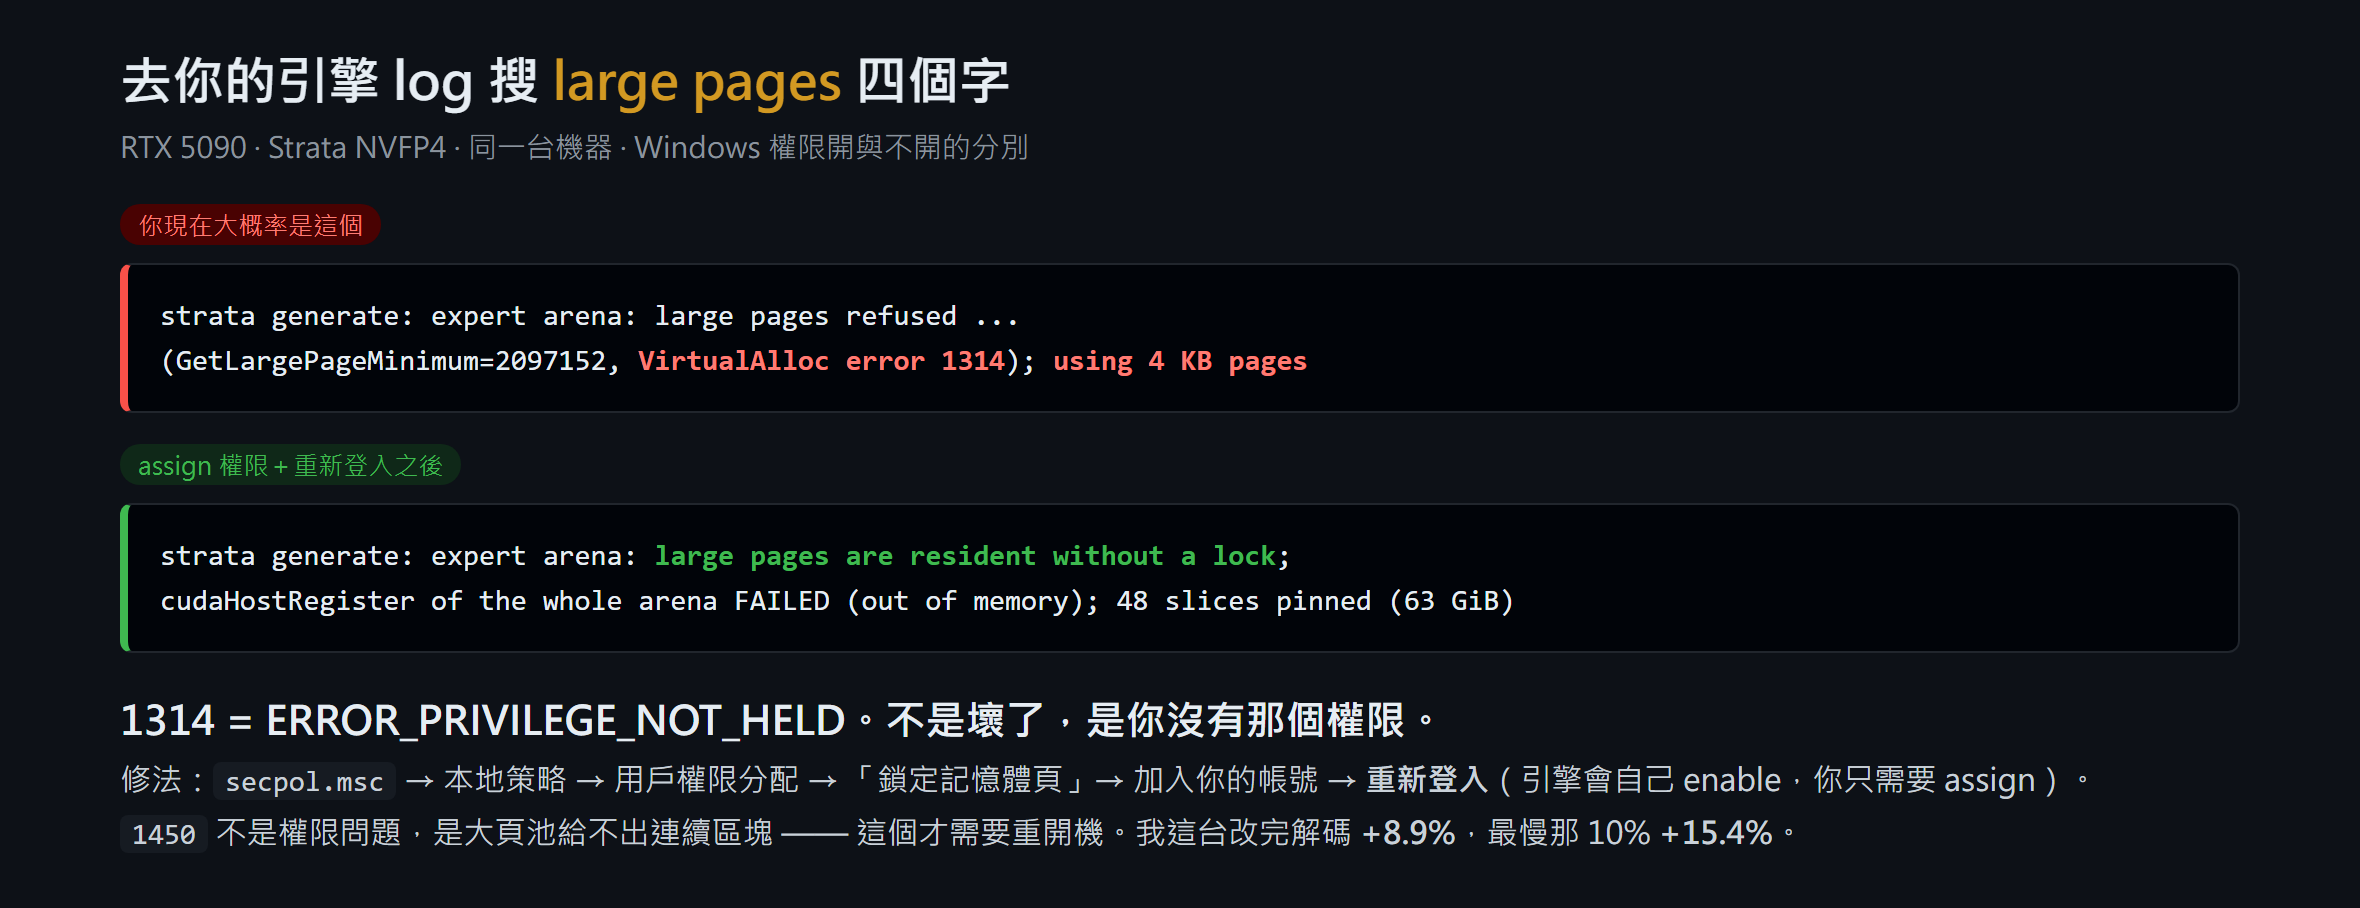
去你的引擎 log 搜
large pages四個字。看到error 1314或using 4 KB pages,你就是那個少了 9% 的人。環境
項目 內容 機器 RTX 5090 32,607 MiB(Gen5 x16)· 9950X3D · 192 GB DDR5-5200 模型/引擎 Qwen3.8-Flash-Next NVFP4 pack(4.5-bit,48 層 × 512 experts)· Strata 0.1.41 · Windows 流量 真實 agent 請求 2,279 個,98.5% 在 60K context 以上,不是跑分腳本 環境變更 10/4 記憶體從 64 GB 加到 192 GB(4800 → 5200 MT/s) 原因
引擎開機配置一個 63.3 GiB 的 pinned arena 放專家權重,先試 2 MB 大頁,失敗就無聲退回 4 KB 頁。63.3 GiB 用 4 KB 頁是 1,660 萬個 TLB 項目,而專家權重是隨機跳著讀的,等於每次跳躍查一次頁表。源碼
pinned.hpp:8-14寫得很直白:「every block of every expert matvec takes TLB misses」,同一檔也把 4 KB 退回稱為「the common case and not an error path」。Linux 用MAP_HUGETLB,不需要逐帳號權限,這個坑是 Windows 獨有;repo 里兩份社群 Windows 記錄(RX 9070 XT、R9700)留著同一個error 1314,所以不止我一個。重新登入不能省:token 在登入那一刻才建立。enable 那半步不用你做,引擎在
VirtualAlloc之前自己呼叫AdjustTokenPrivileges(pinned.cu:72-84),你只需要 assign。另外三個錯誤碼源碼特意分開註解(pinned.cu:101-105),很多人撈在一起當成同一個 bug:1314 是權限未 assign、1450 是大頁池給不出連續的 2 MB 區塊(這個才需要重開機清碎片)、87 是大小不是 2 MB 的倍數。我原本以為 1450 是我沒重開機,看完源碼才知道搞錯。4 KB 頁 大頁 差 解碼平均 118.5 129.0 +8.9% 中位數 114.5 130.6 +14.1% 最慢的那 10% 94.6 109.2 +15.4% 草稿接受率 71.3% 72.8% 沒變 prefill 7,747 7,565 沒變 形狀:最慢那批改善比平均還大,正是缺頁該有的樣子;接受率沒變,所以不是投機變好,是每一輪的固定成本變低了。
prefill 不是一個數字
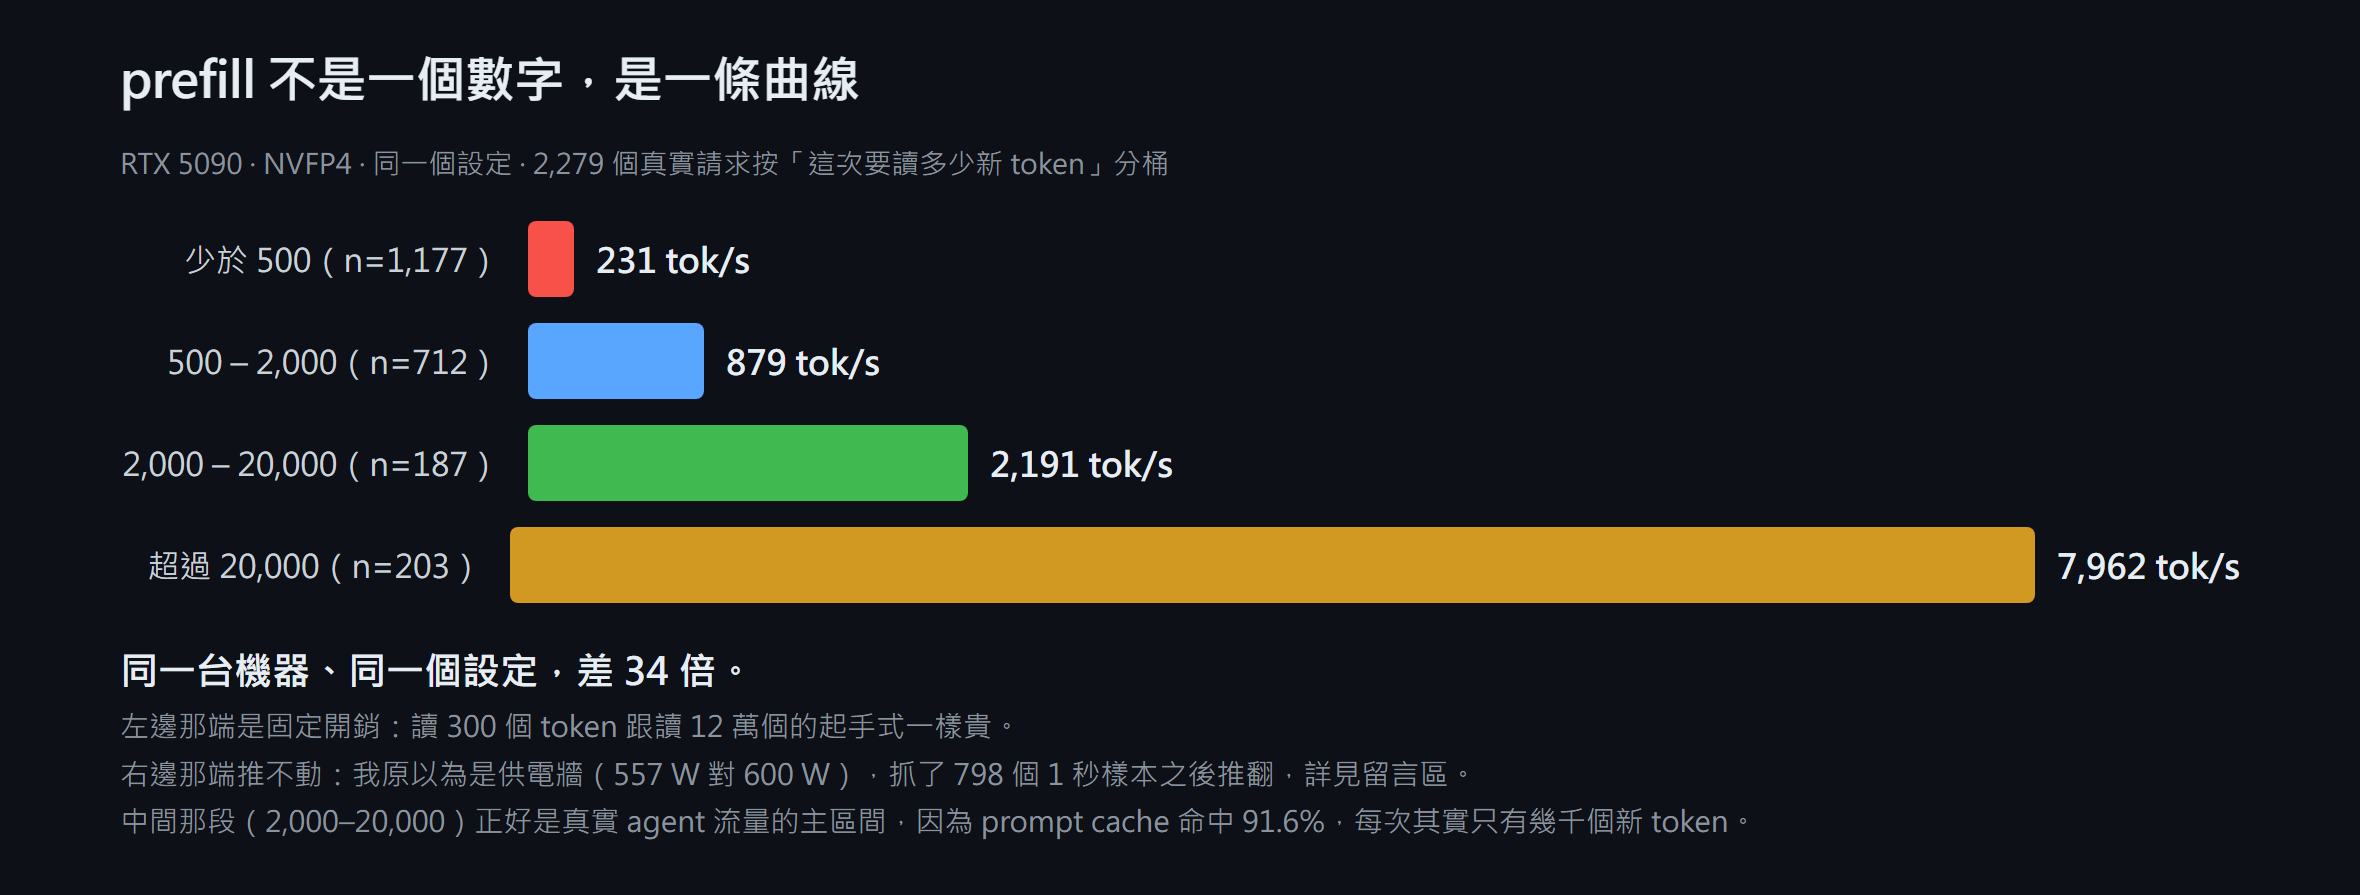
我原本想報「prefill 8,000 tok/s」。那個數字是真的,但會誤導:把 2,279 個真實請求按「這次要讀多少新 token」分桶,就是上面那個樣子。看到別人報 prefill 兩三千,不要以為自己設定錯了,那多數是真實流量的正常值(prompt cache 命中 91.6%,每次其實只有幾千個新 token);看到 8,000 也要先問對方拿多長的 prompt 量。想讓 prefill 快只有兩條路:每次讀多一點新 token,或者讓它命中 cache —— 我換了十幾個參數,同一個區間里一個都動不了。
到底換哪種格式?
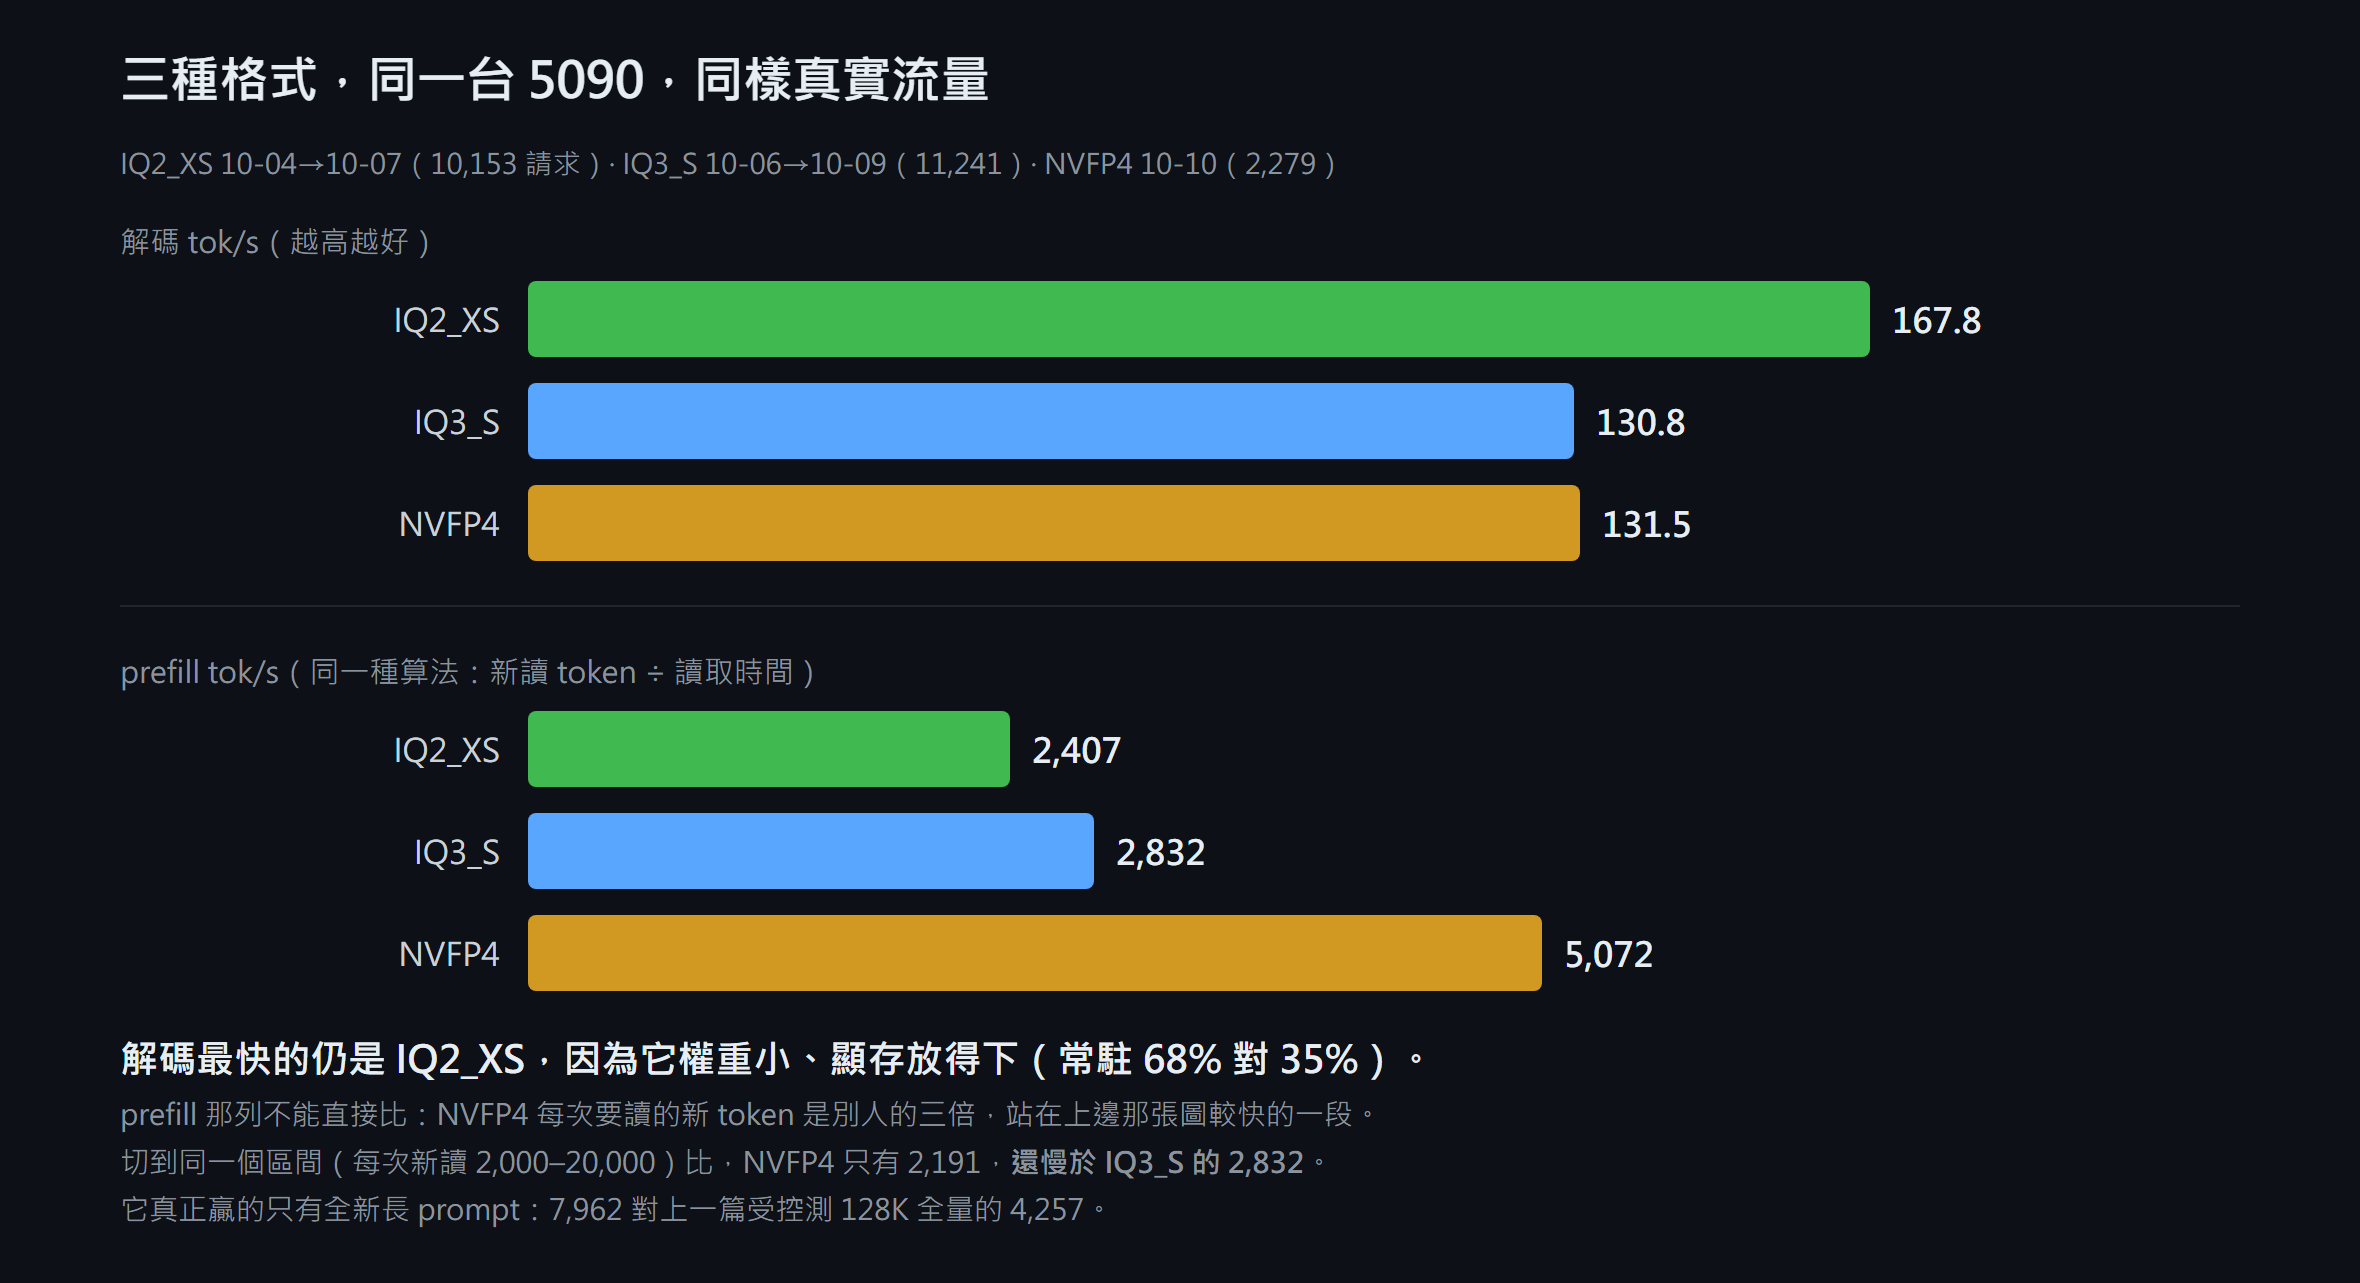
IQ3_S 那組是 2038 留言區我補的真實流量數(11,241 個請求),條件跟這篇最接近:同一張卡、同一顆 CPU、同樣 192 GB、同樣真實流量。
一句話:輸出為主選 IQ2_XS,那兩成差距用設定補不回來(它權重小,同樣 32 GB 擺得下 16,640 個專家,NVFP4 只擺得下 8,586 個);讀長文件為主選 NVFP4,全新長 prompt 它 7,962 對 IQ2_XS 受控測 128K 全量的 4,257,快近一倍,而權重是 4.5 bit 級。
可以直接抄的設定:
--spec 8   --spec-min-p 0.7   --pool-workers 15
pcie-frac 用預設 0.25   不加 split   不加 batch   GPU 0
+ Windows「鎖定記憶體頁」權限
這篇承接 1228 、 1462 、 1967 、 2038 。記憶體從 64 GB 加到 192 GB 之後,2038 里「61.4 GiB 是硬限制」和 parking 那些結論的前提已經失效,請把它們當成 64 GB 時代的記錄。
幫我一個忙
去你的引擎 log 搜
large pages,把結果貼上來:是error 1314、error 1450,還是resident without a lock? 加上你的卡和記憶體容量。我手上只有一份 Windows 樣本加兩份社群記錄。如果 1314 是普遍現象,這 9% 就是整個 Windows 社群一起漏掉的,值得往上游提。已經開過這個權限的人,也想知道你實測差多少。
本帖由本地全棧生成:Strata NVFP4(Qwen3.8-Flash-Next @ RTX 5090)出 token,DSH 負責讀 log、跑統計、核對數據、起草與修訂,圖由本地生成。全部數字可從引擎 log 逐項核對。有錯先係佢錯,歡迎打臉。
Tags: rtx5090 strata qwen-flash nvfp4 large-pages
-
-
補充:方法學、被否決的參數、以及我撤回的三個結論
我怎麼排除記憶體升速的干擾
同日我把 RAM 從 4800 換到 5200,兩件事一起變,所以 5090 那組分不開。引擎在
pinned.cu:88留了一個開關STRATA_NO_LARGEPAGES=1,註解寫「same run, same boot」,所以我用閒置的 5080 跑了一次同開機、同記憶體速度、只差這個變數:大頁開 大頁關 每輪耗時 247.0 ms 358.6 ms GPU 等專家串流 187.7 290.8 CPU 專家池 37.9 40.6 prefill 1138.90 1128.99 每輪快 31.1%,差異 92% 落在「GPU 等專家串流」那項。最有力的是
pool那行:關大頁那邊每層 CPU 專家只有開那邊的三分之一(1.23 對 3.92),做少三倍的事,時間還更高(40.623 對 37.910)。而 prefill 兩邊一模一樣。prefill 是整台最吃記憶體頻寬的階段,如果 4800→5200 有實質幫助它一定動 —— 它没動。所以 5090 那 8.9% 基本全部是大頁。
限制:兩邊專家路由發散了(每層 CPU 專家 3.92 對 1.23),所以 −31% 只取方向不取倍數;而且 5080 只有 12% 專家常駐(5090 是 35%)、x4 連結、卡本身慢,都是只取方向的理由。
同一個設定的擺幅
同一個設定(spec 8、fetch 開、大頁開)一天內量五次:131.2 / 129.9 / 114.9 / 120.3 / 121.3,擺幅 11.5%。真實 agent 流量的上下文長短自己會變。所以這篇所有對比只用前後接著跑的兩組,5% 以內一律當沒發生過;跌 15% 以上的才站得住。
被否決的參數(前後接著跑)
設定 結果 請求數 --batch 4 --batch-mtp−41% 7 --pool-workers 24−24.5% 36 --spec-min-p 0.5−23% 50 --spec-split−3.5%(重疊項) 56 --lookup-chain 3−5.7% 30 --pcie-frac 0.35−0.4% 52 --suffix-draft 8−3.5% 25 --pool-workers 24值得講:log 印「24 pool workers on logical processors 2,4,...,30」,24 個 worker 只列了 15 個邏輯核心。超出核心數的 worker 不綁核,會跟做 GPU 交接的主執行緒搶位置。想加 worker 之前先確認自己的核心數。--pcie-frac從預設 0.25 提到 0.35 完全沒分別(121.3 對 120.8),接受率升 2.6 個百分點但多出來的串流成本剛好抵消 —— 平台區,作者的預設值在我這台也對,雖然我是 Gen5 x16。--spec 8對--spec 6係 +4.6%,兩個唔同記憶體條件下重複出同一個倍數。這跟 2038 §9「--spec 4才是最佳值」相反,但量化、記憶體容量、pcie_frac都變了,兩篇都別外推到對方的條件。另外kMaxT = 8是硬上限(draft_policy.hpp:24、verify_kernels.hpp:21),構造時std::clamp就夾住,所以--spec 12靜默變回 8,不報錯、不變慢,就是沒效果。我撤回的三個結論
一、
--spec-split「重疊本身賠 17.9%」。 早期量到 92.0 tok/s,對當時基準 −29.9%,我就當成重疊的鍋。後來連續跑三組設定、中間不隔時間重測才拆開:PCIe fetch 開對關 +7.3%(中位數 +18.7%),重疊開對關(fetch 都關)只有 −3.5%(中位數 −0.5%)。那個 −30% 大部分是流量自己變了。 一個看起來很紮實的 −30%,重測變成 −3.5%。順帶講為什麼我最後沒改引擎的碼:
--spec-split預設關閉並關閉 fetch 不是保守,是正確性 —— fetch 靠逐出另一個專家來收新的,逐出規則是「本視窗沒用到的才逐出」(expert_source.cpp:3390),而 split 把視窗切兩半,第一半看不到第二半需要誰。修法存在,但用上面的分解算,把 fetch 接回去也只是從落後 10% 變回打平。二、「流量擺幅只有 0.5%」。 我只看了頭兩次採樣(差 0.5%)就以爲這台很穩定,拿那個 0.5% 去判所有對比。實際擺幅 11.5%。連帶影響:
--suffix-draft 8、--lookup-chain 3、--spec 6這三項改列「還不能確定」,不是出局。三、「prefill 撞到的是電,557 W 對 600 W」。 這個是在寫這篇的過程中被推翻的。
用 1 秒取樣抓了 15 分鐘、798 個樣本(同一台 5090、同一個設定、真實流量):
指標 實測 上限 功率 中位 293.3 W 600 W 功率 p90 / p99 / 最高 452.5 / 589.6 / 592.1 W 600 W 功率超過 550 W 的樣本 76 / 798(9.5%) — GPU 使用率 >80% 時的功率中位 295.2 W 600 W 時脈 最低 / 中位 / 最高 2850 / 2902 / 2940 MHz 3090 MHz sw_power_cap亮起0 次 / 798 — hw_slowdown亮起0 次 / 798 — 形狀:功率是尖峰型的,不是平台型的。 它會瞬間衝到 592 W 貼住上限,但 GPU 忙著的時候中位數只有 295 W —— 多數時間離上限還有 300 W 的餘裕。而供電限制旗標和降速旗標,798 個樣本一次都沒亮。
所以「撞到供電牆」沒有直接證據。剩下唯一的線索是時脈:最高 2940 MHz,從來沒碰到 3090 的最大加速值。這符合供電受限的樣子,但也可能只是那 15 分鐘的溫度和負載就停在這裡。正確說法是「長 prompt 那段有一道我沒證明到的牆」,不是「供電牆」。
想自己抓一份,這條就夠:
nvidia-smi --query-gpu=timestamp,power.draw,power.limit,utilization.gpu,clocks.sm,clocks_throttle_reasons.sw_power_cap,clocks_throttle_reasons.hw_slowdown --format=csv,noheader,nounits -i 0關鍵是最後兩個
clocks_throttle_reasons.*。只看power.draw會跟我一樣,被一個尖峰騙成一堵牆。未測項目與已知限制
長 context 的品質(YaRN accuracy)完全沒測,這篇全部是速度和容量。大頁和記憶體速度沒做最嚴格分離,5080 那組是替代證據。
STRATA_ADAPT_FETCH另外兩個子參數沒測,因為--pcie-frac已經是平台區,同一條曲線上其他旋鈕大概率也在平台上。三組格式的對照不是同一時期:引擎 0.1.31→0.1.41、記憶體 61.4→192 GiB、速度 6000→4800→5200、
pcie_frac0.55→0.25、--spec4→8,而且大頁只有最後一組開了。所以那是三個完整設定的對比,不是單變量實驗;凡是我把差異歸給格式本身的地方,都是推論。流量沒按 client 分開,18081 上所有請求混在一起算。這批 98.5% 在 60K context 以上(120–200K 佔 63.6%),所以 131.5 是長上下文 agent 的數字;短 context 只有 0.4% 的樣本(10 個),方向清楚但數量不足,實測 151.8。
-
让ai读贴分析了一下,慢点我去试试,谢谢
贴子里引的源码,我逐条查了你本地 0.1.41 的代码,全部对得上:
include/strata/core/pinned.hpp:9-14 —— 原话就是「33.97 GB at 4 KB pages is 8.3 million TLB entries, which does not fit in any TLB, so every block of every expert matvec takes TLB misses」,并把 4 KB 退回称为 "the common case and not an error path"。你机器是 42.9 GB,TLB 条目只会更多。
src/core/pinned.cu:101-105 —— 官方自己把三个错误码分开注释:1314 是权限未 assign、1450 是大页池碎片、87 是大小非 2 MB 倍数。贴子让你别把它们当同一个 bug,这点是照抄上游注释,说明作者真读了码。
docs/DETAILS.md:510, 515 —— 官方文档本来就有 "Large pages need a new logon (#1412)" 一节,明确说 secpol.msc → 用户权限分配 → 锁定内存页,必须重新登录(token 在会话启动时才生成)。
STRATA_NO_LARGEPAGES=1 这个 A/B 开关确实存在于 pinned.cu:88-89,注释写着 "same run, same boot" —— 作者做单变量验证的办法是真能跑的。
所以你不是在被安利一个玄学调参,是在补一个上游已知、文档有写、但默认没帮你开的 Windows 特权。
 ️ 一个容易踩的细节:我核对源码时发现 "resident without a lock" 不是病症,是治愈的标志——pinned.cu:416/444/487 那句是 #779: large pages cannot be paged out: nothing to lock,只有大页成功时才会打。贴子把它和 error 1314 并列让读者去搜,容易让人误判。
你今天能做的(一行命令,零风险)
以管理员开 cmd:
secpol.msc
本地策略 → 用户权限分配 → 锁定内存页 → 加入你的账号 → 注销并重新登录(或重启)。
然后重起 Strata,再看日志那行。变成 large pages (2097152 B) 就成了。 -
补两个验证点:
· Windows 上这个权限叫 SeLockMemoryPrivilege;log 里的 error 1314(ERROR_PRIVILEGE_NOT_HELD)就是没拿到锁页权限,拿到后引擎会打 using large pages。
· 4KB→大页那 9% 在长上下文/大 MoE 上更明显(TLB 未命中集中在每个 expert 的 matvec),短 prompt 聊天几乎测不出来;对比时固定 ctx 和 batch 才有意义。Linux 侧对应的是 THP / MAP_HUGETLB,不是开个开关就完事,得看 allocator 是否真用上——/proc/<pid>/smaps 里的 AnonHugePages 可验证。
-
我拿3060去測
模型 : iq3_s
run1
• 改前 4KB(line 651-661): 36.0
• 改後大頁(剛跑,line 864-886): 52.1run2
• 改前 4KB(line 651-661): 36.8
• 改後大頁(剛跑,line 864-886): 50.5run3
• 改前 4KB(line 651-661): 37.0
• 改後大頁(剛跑,line 864-886): 52.2run4
• 改前 4KB(line 651-661): —
• 改後大頁(剛跑,line 864-886): 51.5run5
• 改前 4KB(line 651-661): —
• 改後大頁(剛跑,line 864-886): 52.4中位數
• 改前 4KB(line 651-661): 36.8
• 改後大頁(剛跑,line 864-886): 52.2提升:+41.8%(36.8 → 52.2 tok/s)
對3060這工業拉機來說....這已經是神蹟了 我5090可以拿去賣了
-
硬件:RTX 4090 24GB,256GB DDR4-2400,洋垃圾E5V4+X99
模型:Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS修改前(平均值):
预填充:5078.53
解码:124.986修改后(平均值):
预填充:5316.73
解码:186.566预填充提升:4.69%
解码提升:49.27%预填充几乎没有变化,解码速度提升近50%,这有点惊人了。
-
--pool-workers 微调下 还有惊喜
-
-