
论坛装备秀第二期:4卡RTX Pro 6000 Max-Q vs 8卡4090 48G,PCIE-5 DDR5 256G内存 vs PCIE-4 DDR4 512G 内存!
-
论坛开设装备秀这个版块以来,已经有好几十个人陆续发布了自己的设备。那么这个装逼的局势有点失控,在彻底失控之前呢,我们找两个最土豪的人,两个最土豪的例子来研究一下,对比一下。
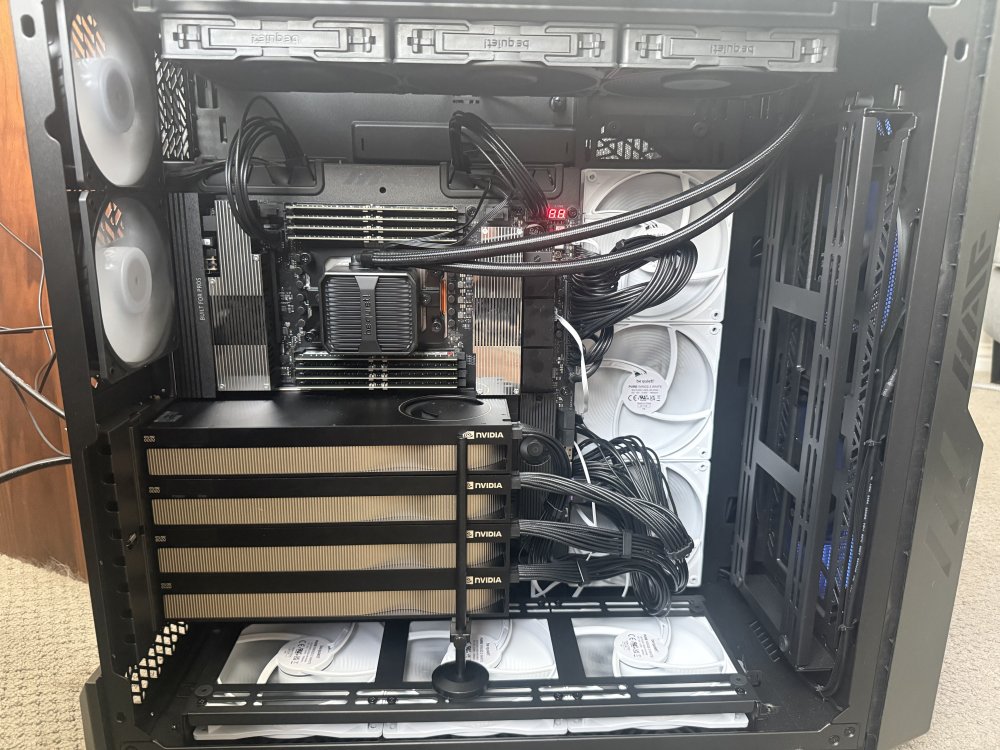
一个是8卡4090 48G的这个兄弟,胡适之发的;另外一个是4卡RTX Pro 6000 Max-Q。我们先看这个论坛的天花板吧,四张RTX Pro 6000 Max-Q,96G。这个Max-Q版本是限制在300瓦,它的性能大部分情况下相当于是RTX Pro 6000的百分之七八十吧。这虽然功耗砍半了,但是性能并没有砍半。它是支持NVFP4的,是Blackwell架构。
四卡Max-Q 96G,它的总显存是384G,搭配的内存是256G DDR5。CPU是线程撕裂者9975WX,这个CPU性能是溢出的,完全够用。系统是Windows加Ubuntu。硬盘这些东西就不用看了,都是够的。它这个机器的造价应该在60万块钱左右,就大致估计了,并没有认真去研究它具体多少钱,大家不要抬杠,说它70万或者说它50万。对于这个买四张RTX Pro 6000 Max-Q的土豪来说,这不是他关注的关键。我们反正也买不起,只是云一下,千万不要较真。
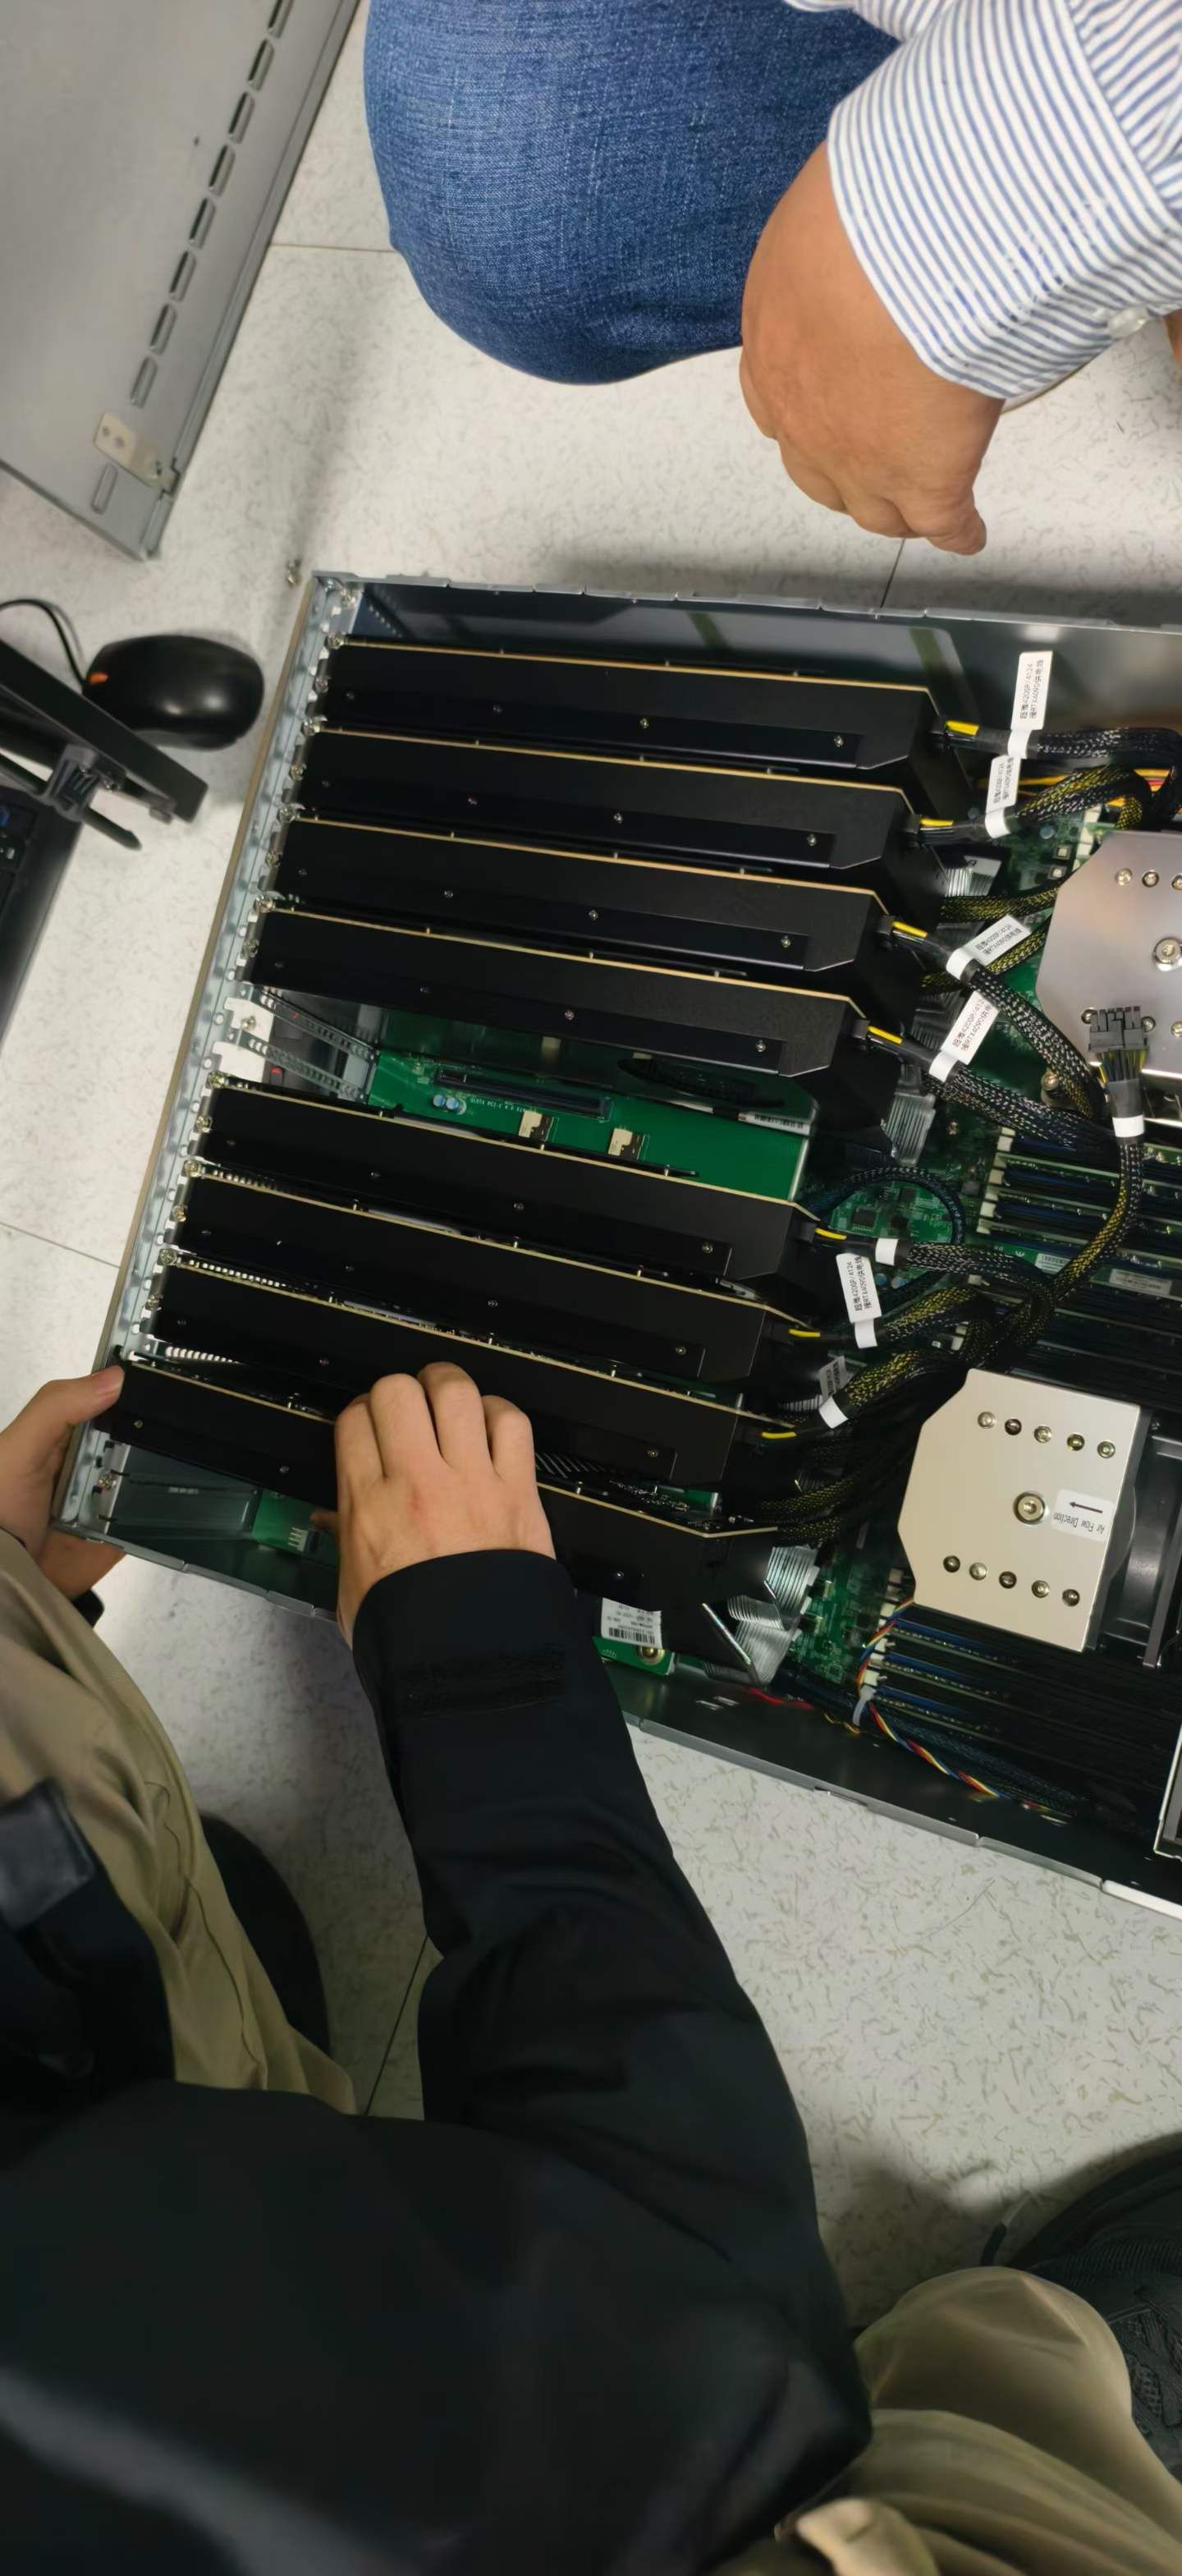
然后胡适之他发的这个8卡4090 48G,是他给一个银行做的定制机器。要求是并发10到15人,局网环境无法连通外网,不画图、不做视频,只处理文本。采购价格32.6万。他就买了8卡4090 48G,加上512G的DDR4、4T固态、4T机械盘,还有7443双路CPU。这个应该是买的二手服务器吧?这个服务器是DDR4平台的,已经出来很多年了。如果按照这样的话,32.6万的采购价格应该有不小的利润空间。你8张4090,按照市场价2万五来算,你买多的话估计能够谈到2万二三。2万五那也刚好就是20万块钱。这个服务器本身值个两三万吗?你还有个将近10万块钱的利润空间。而且根据这个老哥说的,好像是说他这个机器只是暂时给银行用,用到一定年限这个机器就归他了。这个利润空间真的是相当大啊。
你看8张4090 48G,这卡如果买的渠道不对的话,修服务器就能修得你头疼,这不是一个能轻易维护的。其实我倒是觉得,你买四张RTX Pro 5000,搞不好就完全能够胜任你现在的任务,你也有这个利润空间,但是算力确实是没这个强了。
那你说这两个服务器,价格我们按照1比3来算吧。你说这个8卡4090 48G,加上512G DDR4的这个平台,与四卡RTX Pro 6000 Max-Q,加上256G DDR5的平台,它们的算力差距大概能差多少呢?能差到3倍吗?
首先必须说,跑大模型的情况下,这有可能能够差个2倍左右吧,差不到3倍去。如果说都是这种聊天性质的,不跑Agent,没有什么特别长的上下文,这种配置不要说支持什么10到15人了,哪怕支持个三五十人用,完全没有问题。
如果是要全部长上下文工作,跑AI Agent,比如说跑DeepSeek Harness,跑Hermes这种AI助手,那这个8卡4090 48G的上限要更高一点。因为它的处理速度虽然比这个Pro 6000 Max-Q要慢不少,但是大体上的算力应该是有它的一半,甚至有一半更多。没有NVFP4的加持,但是它的内存是512G。当这个长上下文、多会话的实例多了之后,如果显存放不下,就要把KV缓存使用HiCache给它offload到内存中去。这里用的是SGLang,指的是SGLang。像你这种高端的4卡、8卡环境,你肯定是用SGLang的,不可能用其他的。如果是聊天居多的话,也有可能用vLLM,但是SGLang的效率是吊打其他东西的。
那么在这种情况下,你的内存容量大,支持多用户长上下文,它本身对于内存跟显存容量的要求,要远远大于对性能的要求。无论如何,两种配置都够了。所以说我认为这个8卡4090 48G这种服务器方案,如果是用来让企业跑DeepSeek V4.1 Flash这样的模型,那它的性价比是最高的,它不会比四卡RTX Pro 6000 Max-Q慢太多,不至于的。它的算力上面可能还更强一点,差就差在4090 48G的带宽。
虽然RTX Pro 6000是PCIe 5.0接口,但是讲实话,PCIe 4代和5代的带宽都够用了,因为大部分的计算发生在GPU内部,数据是在GPU和显存之间搬运。它不需要使用内存作为offload,内存只是用来存KV缓存,溢出的情况下存KV缓存,作为KV缓存的offload,或者存一下GPU输出的计算中间张量。在这种情况下,5代的内存和PCIe接口没有什么优势,4代就够用了。
所以说跑大模型,我还是推荐大家选择胡适之的方案。有人说NVFP4又提升了多少速度。哎呀,当你速度达到一定程度之后,那速度就没有什么意义了。4090 48G按照这种应用场景,15人、20人的这种应用场景,它是足够的。而且这个4090 48G它是有INT8加速的,知道吗?就是你跑DeepSeek V4.1 Flash的时候,可以到社区去找转换的版本,就是把NVFP4转为INT4的部分,它这个精度的损失是微乎其微的。推理的时候,大部分时候都是使用BF16,或者极端情况下使用FP8来推理。像DeepSeek V4.1 Flash它是比较特殊的,可以使用FP8来推理,精度损失不大。但是大部分的模型都是要用BF16来推理,否则损失的精度是肉眼可见的。
4090是支持FP8推理的。它的FP8生态没有Blackwell架构、没有RTX Pro 6000这么完善,但是它的基础能力是有的,所以说差距不会特别大。然后如果是跑ComfyUI,4090 48G这个方案可以跑8个实例,但是问题是它只有48G显存。它单卡要载入MiniMax H3或者LTX 2.3,就只能选择量化程度比较高的模型权重,用FP8来推理。比如说MiniMax H3用FP8来推理,它的性价比是最高的。这种情况下,即便是两张卡跑两个实例,它的速度比起Max-Q单卡,我觉得效率上还是要差的。
就是在跑ComfyUI的情况下,这四张Max-Q虽然只能跑四个实例,但是它可以装精度比较高的模型权重,然后推理的时候,由于总体带宽比4090 48G单卡要高,效率也会更好。当然了,今天是太膨胀了。像我这样只买了一张4090 48G的,我肯定是不好意思去畅想买8张是什么样的体验,还要搭配一个非常不错的服务器才行。我们普通的消费级主板肯定是不行的,更不要说去买四张RTX Pro 6000了。
哦,对了还别说,它这个256G内存还没有显存容量高。你跑ComfyUI的时候,如果在VAE阶段是非常吃亏的,因为VAE阶段最好是内存能够比显存大,最好是2比1。4090 48G这个大概是1.5比1,这也还算可以了,最好是2比1,要不然VAE阶段它的内存有可能会爆掉。
总之,如果说从性价比来讲的话,我觉得胡适之配的这个方案,虽然土豪程度不如楚浩,但是它的性价比要远远高于四张RTX Pro 6000。这个也就是在本地折腾的时候,理解硬件基础知识的重要性,在这个上面还是能够有所体验的。当然了,我相信楚浩他买这个四张Max-Q,本身就像有钱人去买LV、买Gucci,是吧?他买卡宴、买迈巴赫,他可能并没有想过他的这些包比起普通老百姓的包有没有性价比,或者说他买的这个车比起比亚迪有没有性价比,他们可能不太会考虑这个问题。
好吧,本期视频先水上一集,关于这两个机器的对比。欢迎大家到这个论坛去发个帖子,然后这两位哥们如果有空的话,可以把DeepSeek V4.1 Flash实测一下,看看你们跑出来的效果。胡适之已经发过他的测试结果了。我觉得老胡,你这个AI部署的能力还有待加强。你跑出来那个数据,真的我看了眼泪都掉下来了。
-
-
