MiniMax H3 Director Cut Studio 教程(教程更新在最新楼)
-
在20年前曾經跟朋友创办摄影论坛,那个时候曾經想要花4000去租 klpf 的口放自己的作品。还记得策划了一段 3d 视频,可惜当年的设备有限,想得到,但是做不出来的
如今把当年得有思创作,使用 ai 创作,原来是那么地简单・・・
内容是告诉我在 klpf 小径口的开幕典礼。我要的效果是一颗流星从太空飞越,一直到马来西亚、midvalley、klpf 会场,到我的档口 流行停下来变换成一颗 olympus ep2 相机,然后我幻化一个摄影师拿着相机自由拍摄 在 klpf 会场飞翔。看着底下的观众,然后人物在档口面前定格全体照[Verse 1]
深夜宇宙 星光在流浪
一颗流星 穿过银河中央
越过云海 飞向那远方
马来西亚 灯火渐渐发亮
掠过城市 穿越吉隆坡
Mid Valley 就在前方闪烁
跟着光芒 来到 KLPF
寻找属于摄影人的地方[Pre-Chorus]
穿过人群 穿过会场
镜头和照片都在发光
转过一个 又一个方向
终于看见熟悉的招牌
那颗流星 慢慢停下
所有星光在眼前聚合
就在这一刻 奇迹发生
FOTOGANG 等着它回家[Chorus]
FOTOGANG 今晚我们登场
一颗流星落在摄影的地方
Olympus E-P2 在发光
从星辰变成手里的梦想
按下快门 世界被收藏
飞过 KLPF 看人海流淌
每一个笑脸 每一道目光
都变成我们最美的影像[Verse 2]
星光散开 我站在中央
手里的相机轻轻发亮
踏出一步 身体开始飞翔
摄影让我越过整个会场
低头看见 人群在流动
有人挥手 有人举起镜头
我在空中 按下一次快门
这一秒变成永恒的梦[Chorus]
FOTOGANG 今晚我们登场
不是最大的店也一样发光
Olympus E-P2 在手上
带我飞过每一条走廊
从高空看见 KLPF 的模样
镜头记录每个人的脸庞
照片不是冰冷的一道光
是我们共同留下的时光[Bridge]
我飞回来 熟悉的方向
FOTOGANG 招牌越来越亮
朋友伙伴 全部靠近身旁
今天我们一起站在中央
不用飞翔 也不用魔法
这一刻已经值得珍藏
对准镜头 大家看向前方
三 二 一——把今天留下[Final Chorus]
FOTOGANG 今天正式登场
从宇宙一路来到这个地方
一颗流星 化成摄影梦想
Olympus E-P2 陪我飞翔
KLPF 人海就在身旁
Mid Valley 见证我们的开场
所有笑容 全部留在相框
这是属于 FOTOGANG 的第一张[Outro]
从星空来到你我身旁
从一颗流星变成一道目光
摄影让这一秒不会遗忘
FOTOGANG——
我们的故事
今天开场 -
-
-
根据以下剧本,创作一个minimax h3视频 不由得你不跟,不由得你不信,本質上南洋華人拜那麼多,是因為他們的骨子裡,依舊流淌著遠古百越人的血脈,而民間風俗的靈魂深處,則隱隱偏向著九黎戰神——蚩尤。 閩粵一帶的華人先民,歷史上本就是古代「百越」的後裔。百越民族自古「信巫鬼、重淫祀」,與蠻荒叢林搏鬥,對萬物皆懷有極深的原始敬畏。當這群帶著百越基因的子民跨越重洋來到南洋,面對瘴氣叢生、生死無常的惡劣環境時,這種血液裡的巫覡文化與生存本能瞬間被喚醒。他們不講求中原儒家的溫良恭儉讓,而是崇尚最直接、最狂野的靈力崇拜,而這種風俗的展現,恰恰契合了蚩尤的「兵巫」遺風。身為九黎之君,蚩尤是巫術、鋼鐵與反抗命運的化身。在南洋的民間信仰中,這種原始的野性被發揮得淋漓盡致,最典型的體現,莫過於當地極其興盛且血脈僨張的乩童文化。 在南洋的廟會與遊行中,乩童是人與神、生與死之間的媒介。每當九皇大帝聖誕或神明巡境,各路乩童紛紛「退童」入神。在震耳欲聾的鑼鼓聲與嗆鼻的煙香中,乩童們赤腳踏過滾燙的火炭路,用幾尺長的鋼針利刃直接刺穿臉頰,甚至手持鯊魚劍、七星劍往自己背上猛砍,鮮血淋漓卻面不改色。這種極致的自殘與耐痛儀式,像極了遠古蚩尤部落在沙場上作法、祈求戰神附體以獲得銅頭鐵臂的兵巫之術。 更奇特的是,南洋的乩童文化呈現出一種百越式的萬物有靈與包容性。除了大伯公、齊天大聖等正神「降駕」外,更有專門演繹地府陰神的大二爺伯(七爺八爺)與孝子爺乩童,他們頭戴高帽、口叼粗雪茄、身穿調色盤般的長袍,在深夜裡為信徒算命求財,散發著強烈的神祕與詭譎氣息;甚至連馬來在地的守護神「拿督公」,也會透過華人乩童「起乩」,口中說著馬來語、享用著椰漿飯與栳葉。 這種極致的實用主義與對「靈驗」的狂熱,本質上就是百越人對土地神靈的敬畏與九黎「以力事神」的現代變體。這股深埋在基因裡的野性力量與巫覡狂歡,在異鄉的土地上借殼還魂,演變成一種刻進骨子裡的集體潛意識,讓人在命運的無常面前,不得不跟,不得不信。
-
太牛了,比AI搅拌站那个导演台牛多了,赞大佬 @imbiplaza-asus
-
-
为了方便自己做视频,我自己vibe 了一套模仿premier pro 的那种操作方式来做minimax h3 视频,
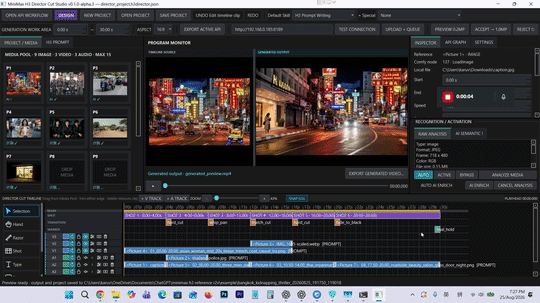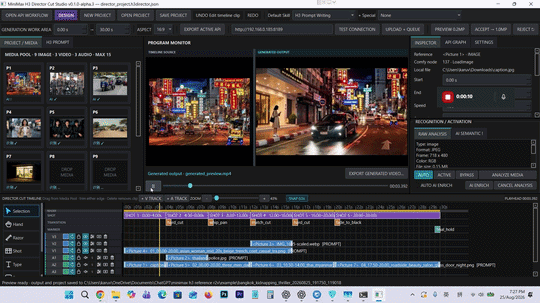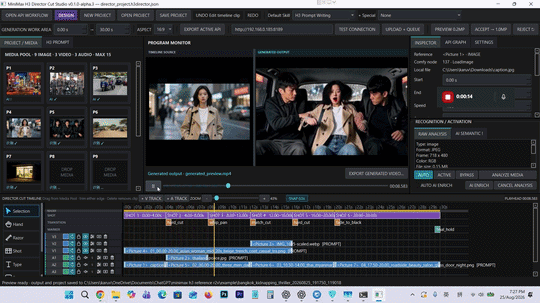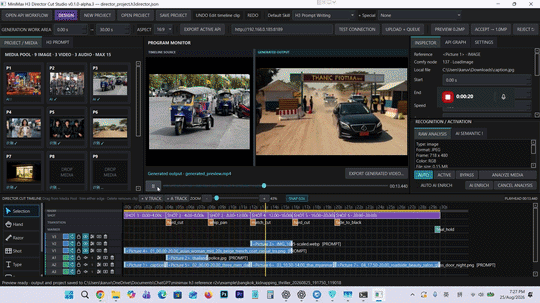
以后这个软件的教程 和 范例就全部放在这里,
google 下载:
这个整合包已经包括ai_libraries,解压了就可以玩
https://drive.google.com/file/d/1mC_GpmCuYw7zaQPfkaqtQVXTSt6DlRsM/view?usp=sharing
github:
https://github.com/karuvanan/MiniMax-H3-Director-Cut-Studio
所有最新代码都会直接放在github, 整合包是以ai_libraries 为主
我的懒人操作心得:
我的自己心得的流程很简单的,就是
1 资料,图片
2 load image
3 进入design
4 把资料大纲放在design reequirement
5 叫qwen3.8 & z image 补充必要的画面,照片,角色,剪辑角度,动作,对白
6 所有素材 auto 进入 timeline,
7 先做preview, 看效果
8 微调某些视频的出现帧数,比如里面的picture 4 画面在影片最后重复了,我就拉动帧数杆调整从30s > 15s
9 最终视频效果回自动根据 miniamx h3 自动并和
开始:
范例 1 (低清曼谷):
首先在网上找到一些资料:
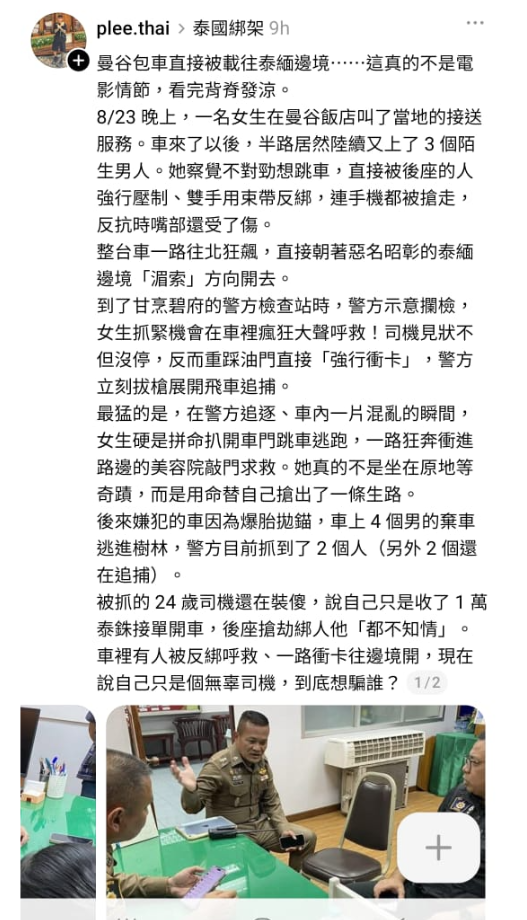
再根据相关新闻,找了相关图片,
第1步 load image 去 P1, P2, P3:(要不要load image 无关紧要,因为里面内置z image 创作照片)
第2步,进入Design:
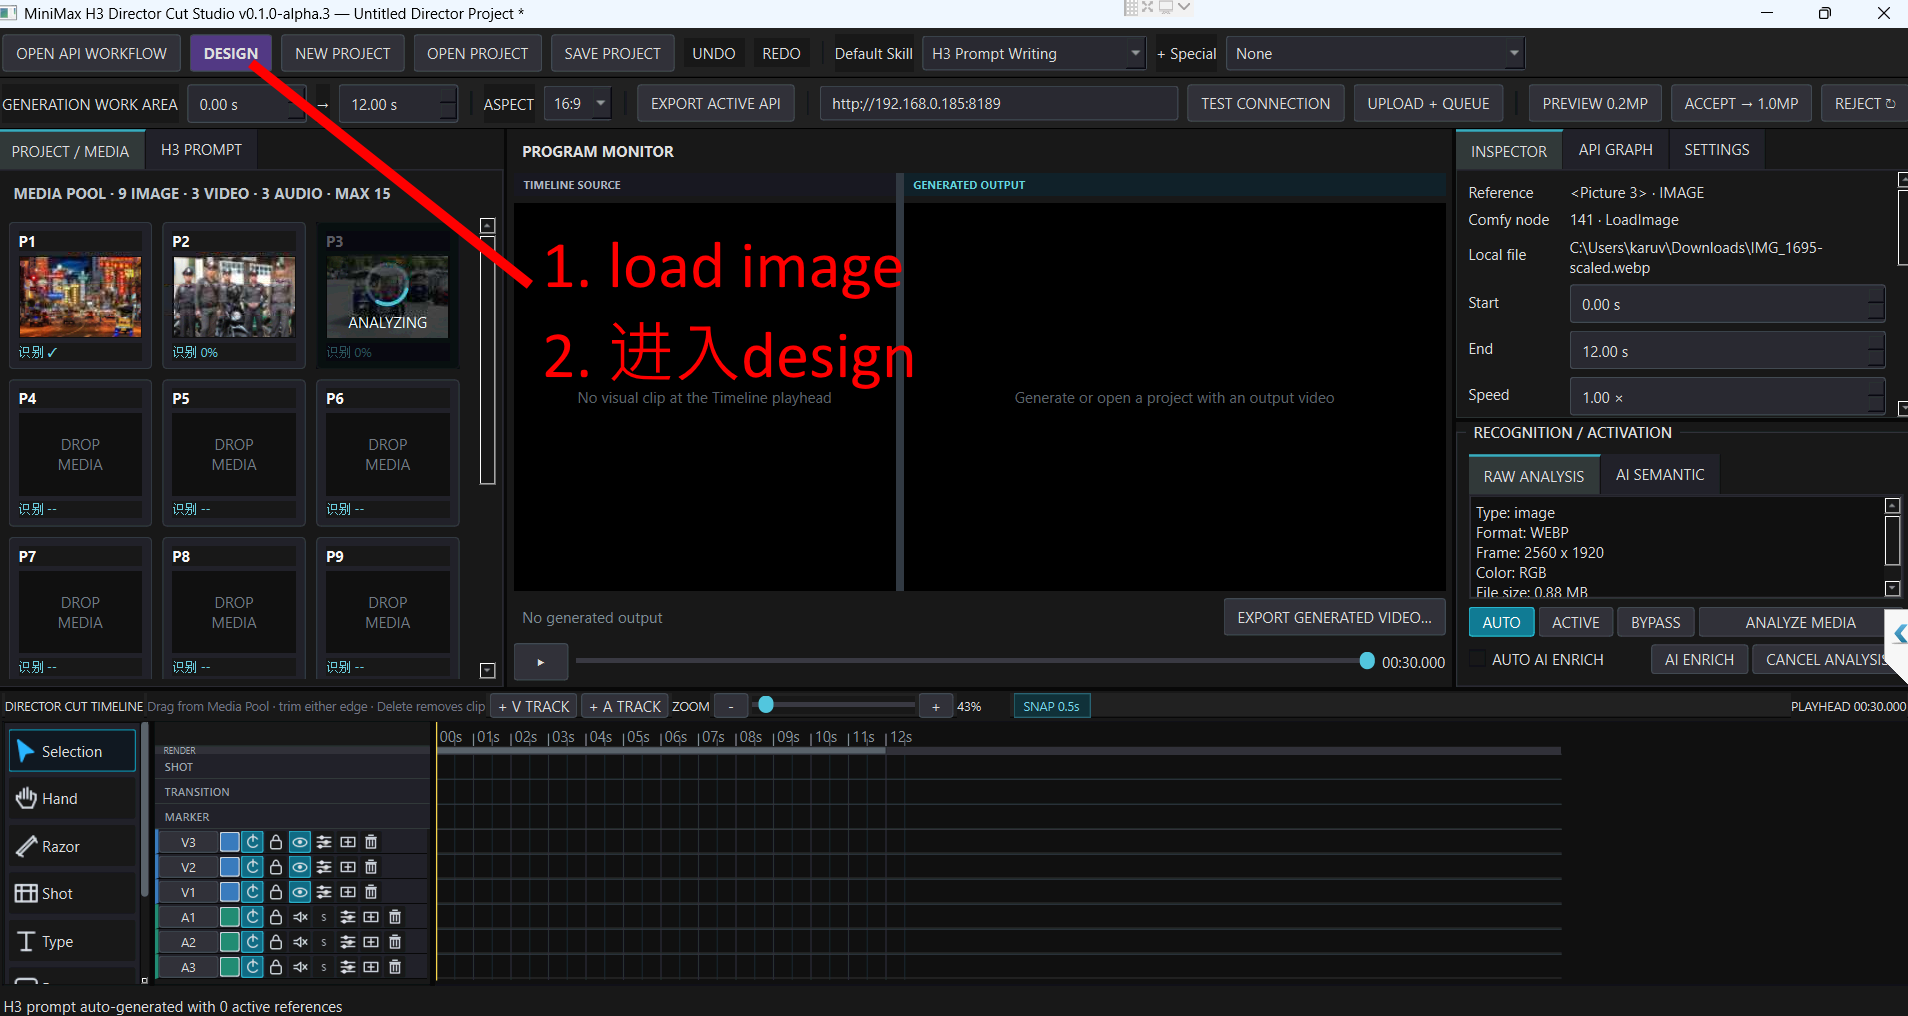
第3步,在Design Requirement 输入剧情,然后点击 create director design json
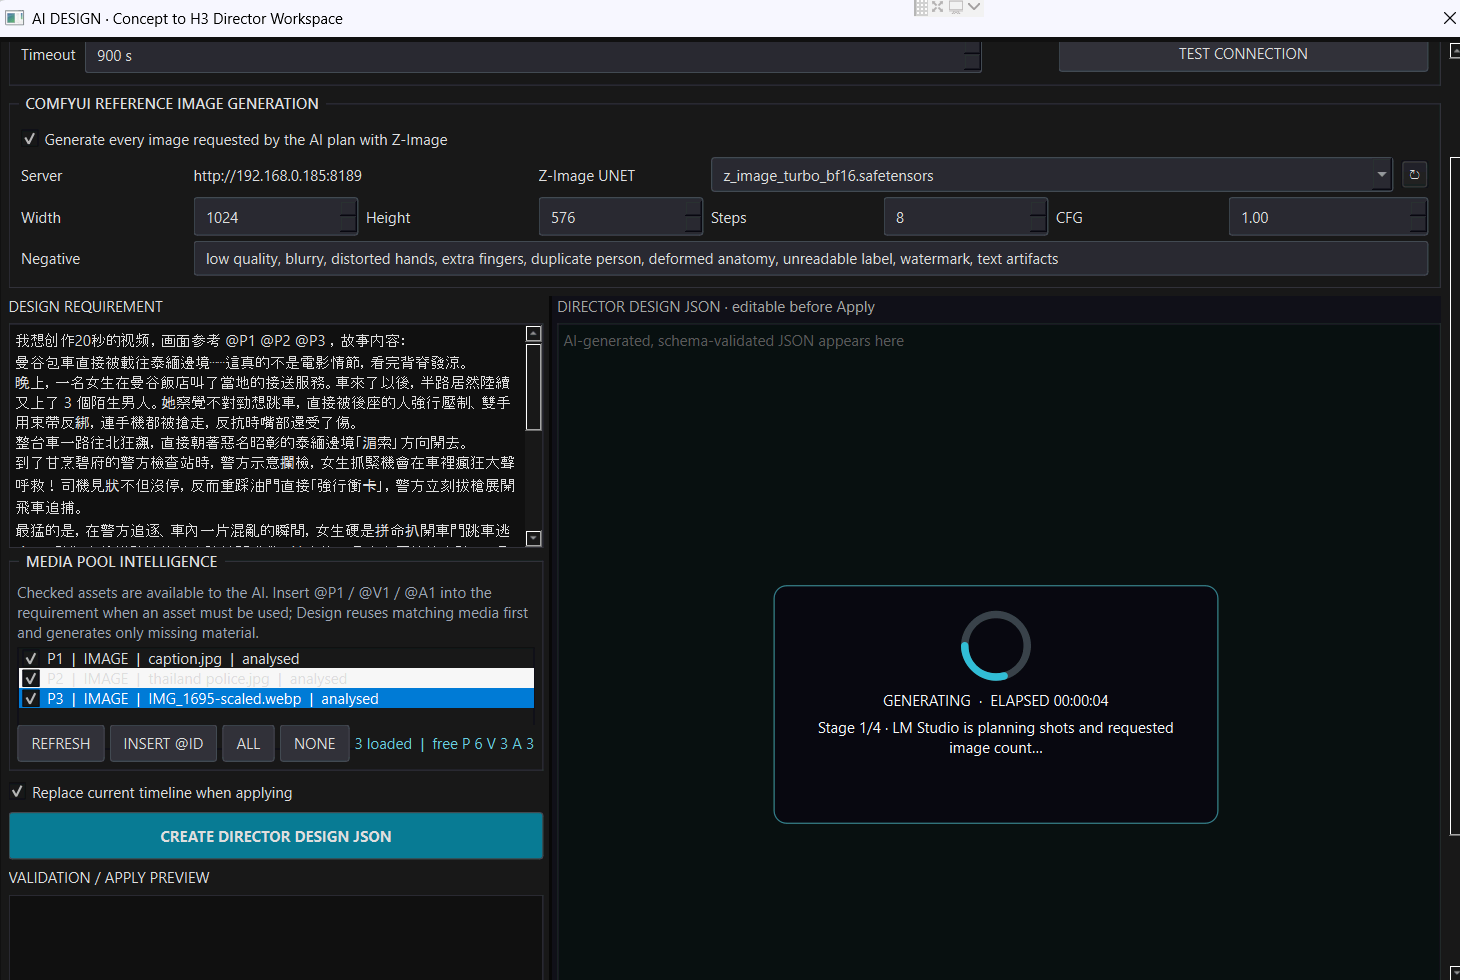
我这里使用了qwen3.8 & z image 来分析我的剧情,
在这里,他会叫 qwen3.8 来分析剧情,然后 使用 z image创作相关图片,然后再使用相关图片来自动铺排全部的镜头,剪辑,动作,对白,声音,timeline 素材时间帧第4步, 点击 apply to h3 workspace
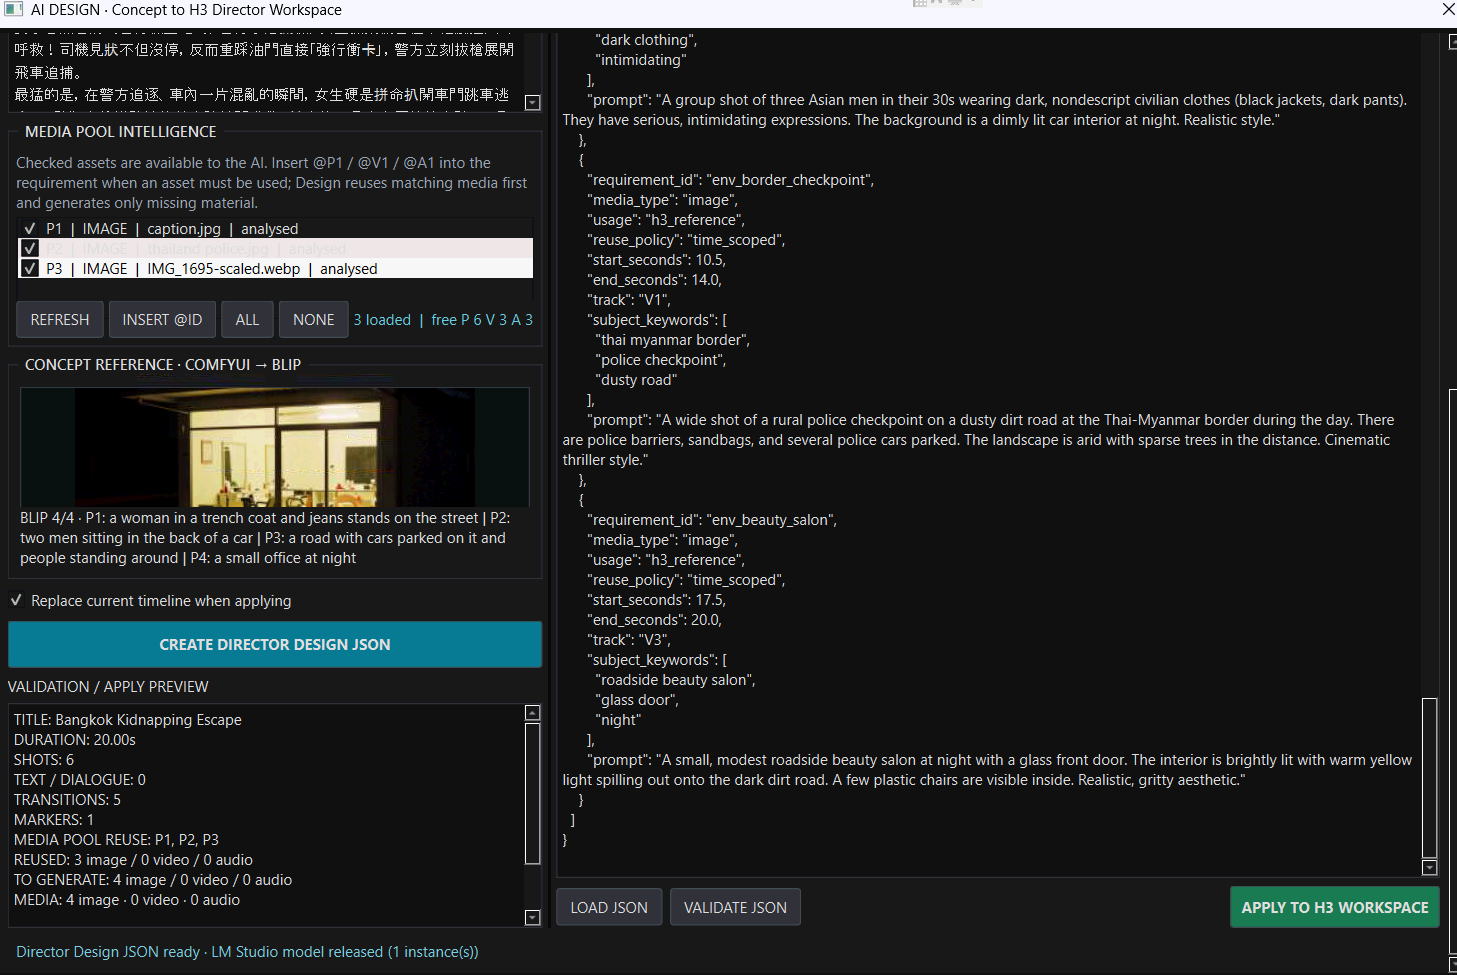
回到首页,这时候你会看到全部素材已经放好了
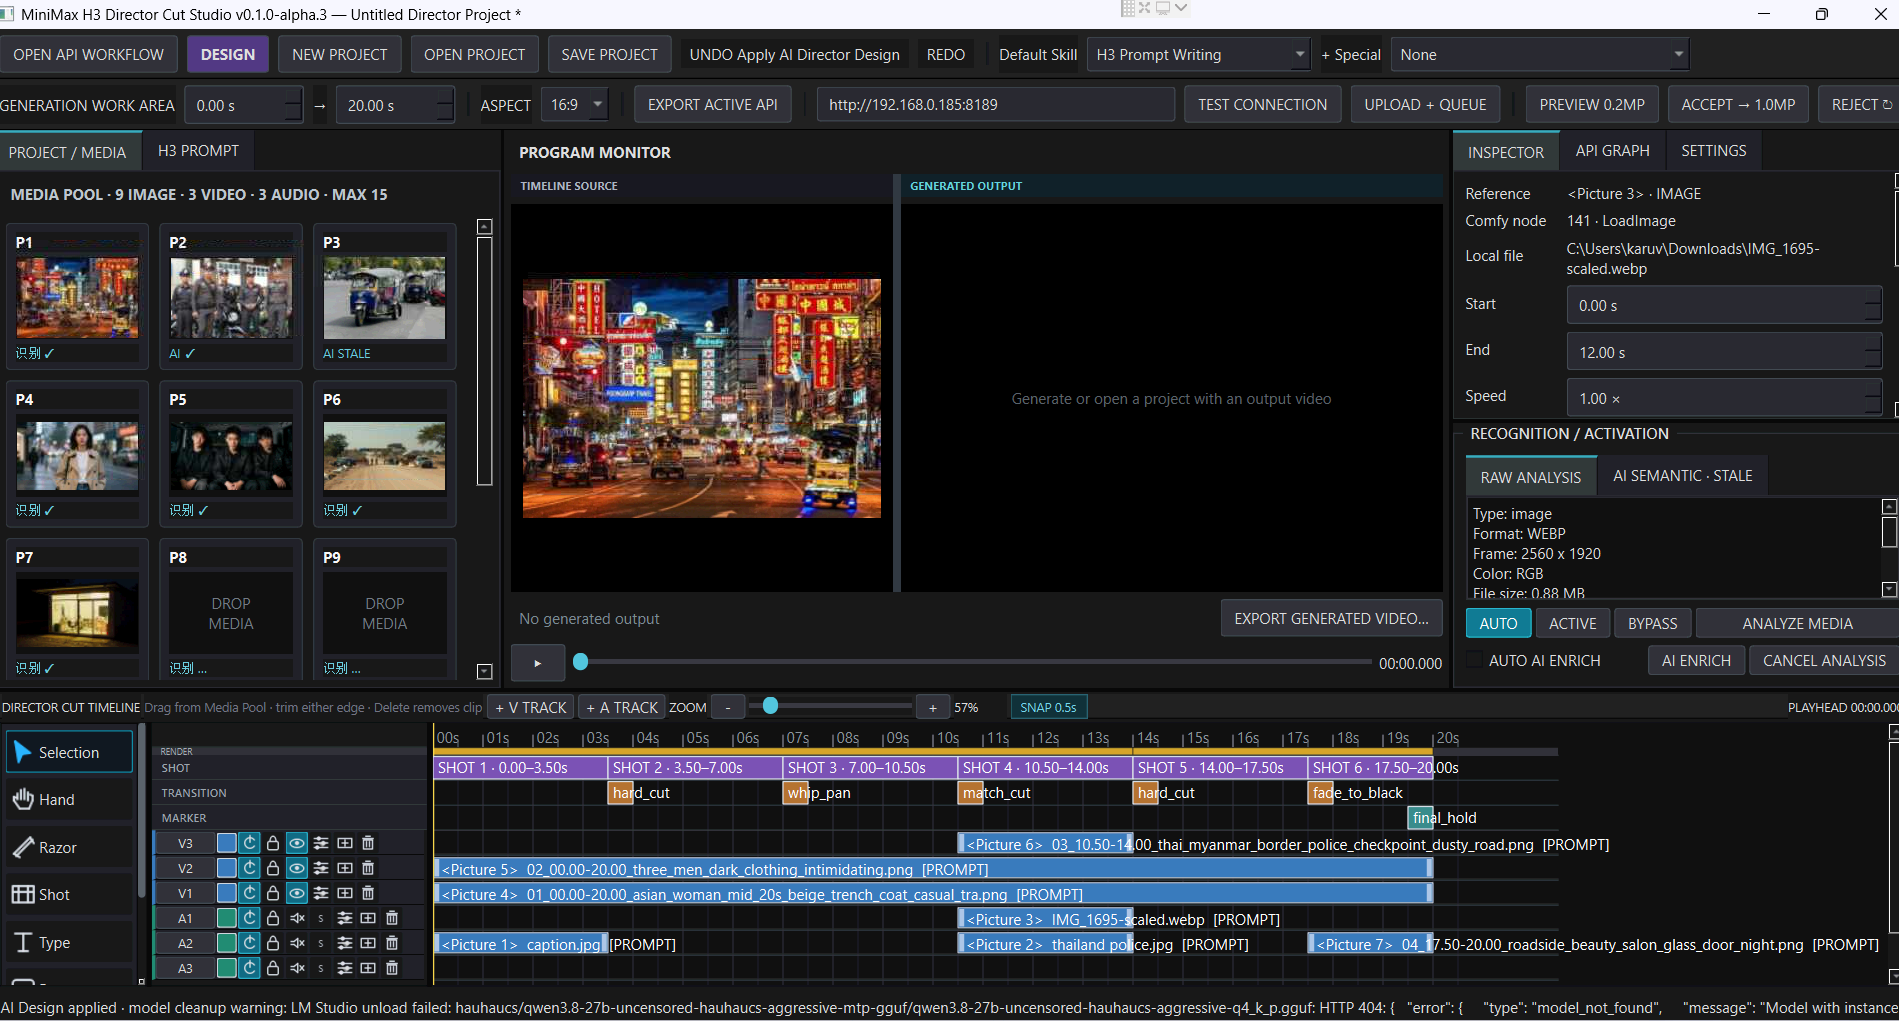
第5步,这个时候我习惯性点击 preview, 先预览效果,再看看要更改什么
等电脑处理,好了过后他会在program monitor 预览给你看
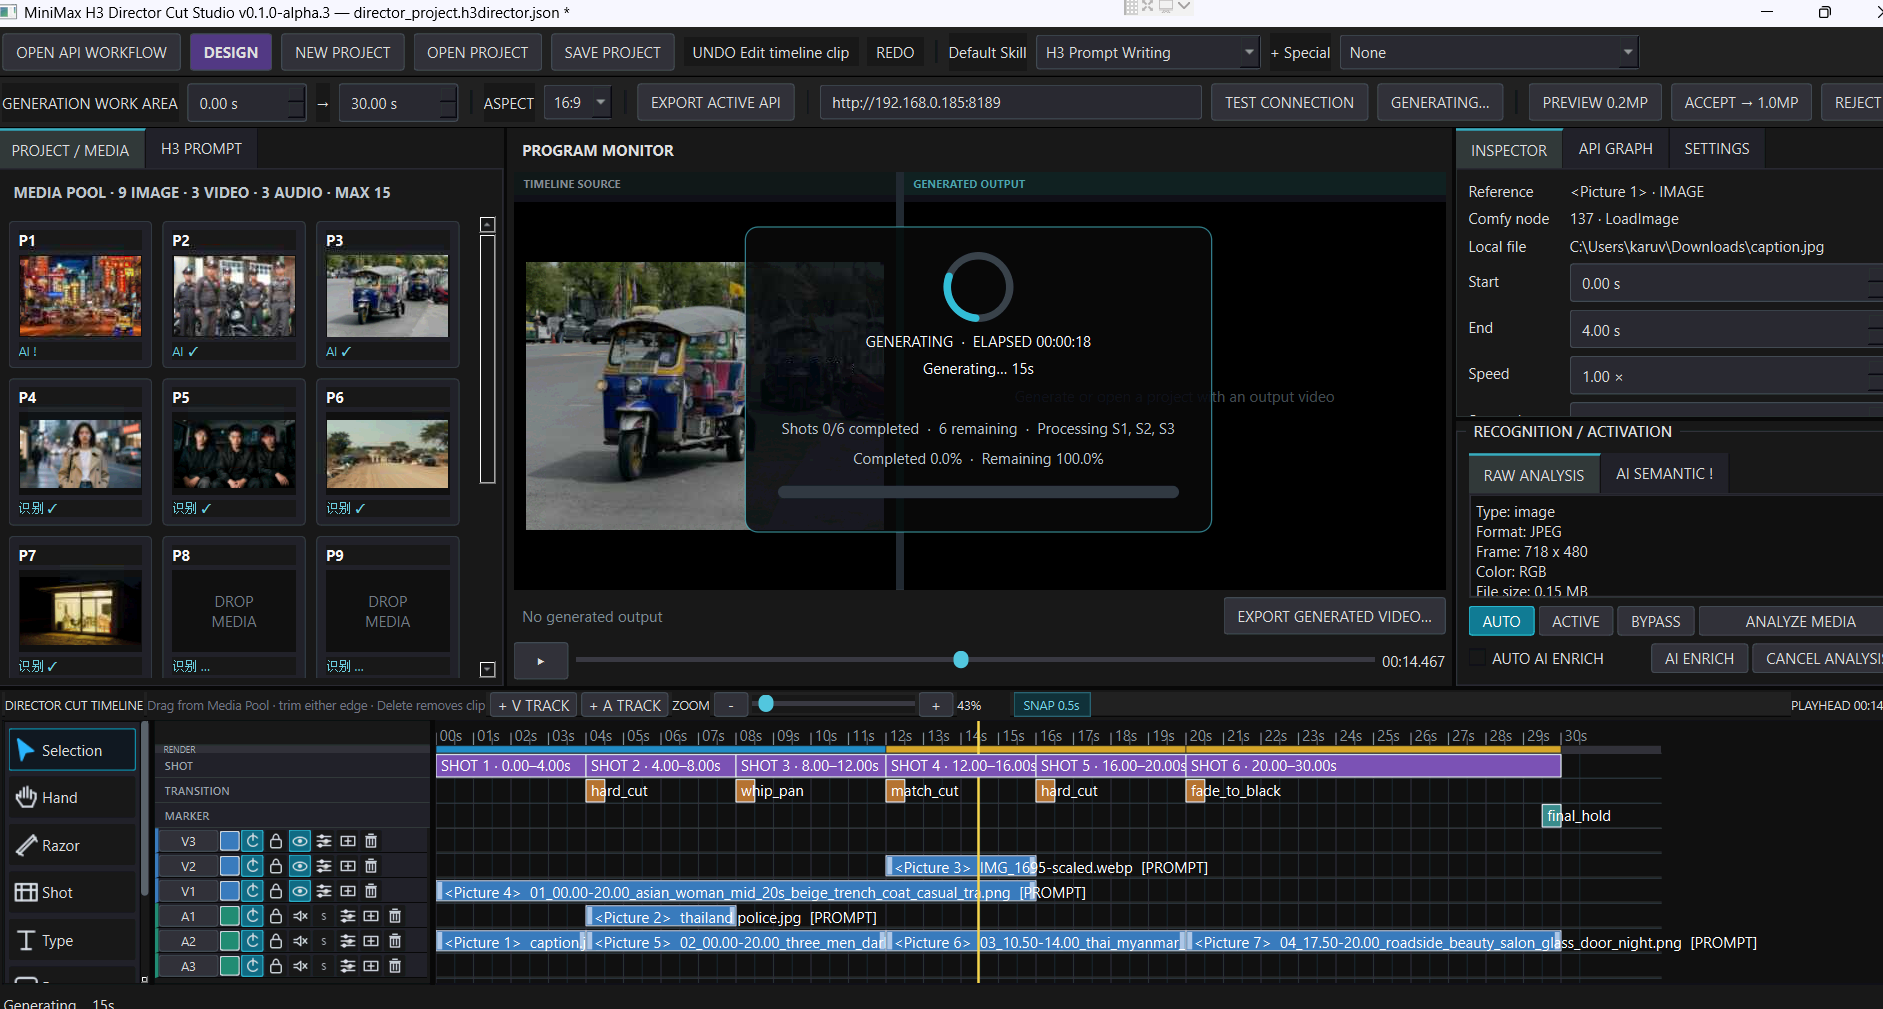
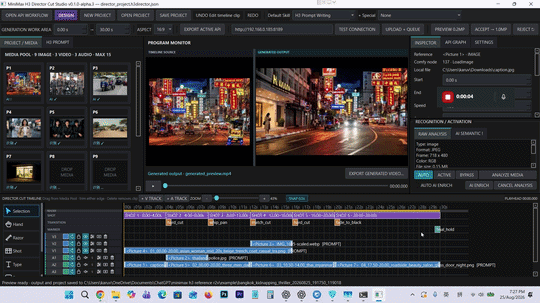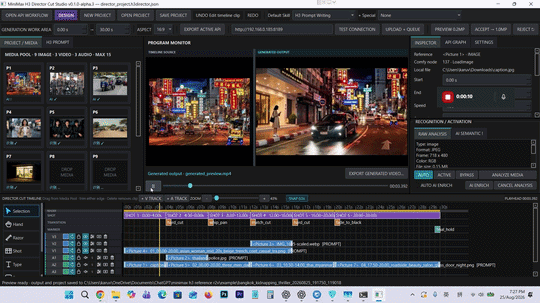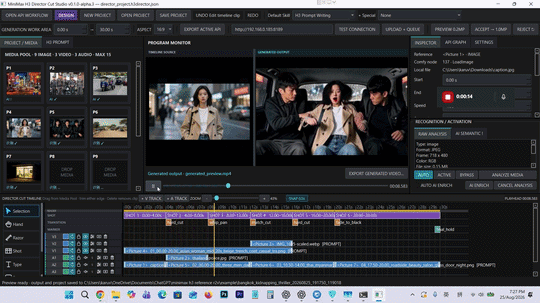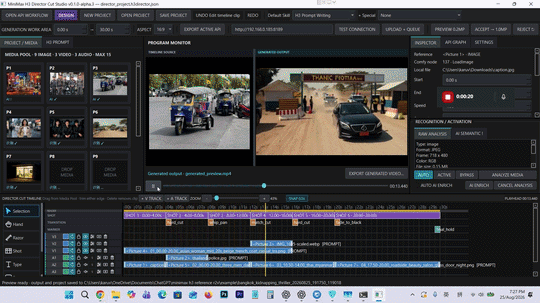
第6步 你觉得preview 符合你的要求就点击accept 1.0mp 继续输出高清就可以了,
如果不要,你就点击reject, 或者你想直接输出高清就直接点击upload + queue, 他就会发送去你的comfyui server 处理
-
心血来潮,创作一个群像搞笑Talk Show短片,只要上载一个照片,里面的人物可以跟着讲一个搞笑段子
提示词如下:
请根据已经加载的@P1,创作一部45秒的群像搞笑Talk Show短片。
P1人物分析规则:
先分析P1中完整、清晰、属于主要群像的前景人物数量,不得固定假设五个人。忽略画面边缘被裁切的局部身体、背景路人、反射、海报、雕像、人体模型或重复形象。
按照P1开场构图从左到右,把完整主要人物依次建立为S1、S2、S3……SN。每个Speaker必须始终对应同一名P1人物,不得因为运镜、切近景、性别或发言顺序而交换编号。
P1是全片人物身份、脸孔、发型、年龄感、身形、完整服装、鞋子、配饰、原始人物数量、人物相对位置、背景场景、色调与视觉媒介的最高事实。P1是真人就保持真人,P1是漫画就保持原漫画线条与上色,P1是3D就保持3D,P1是插画就保持插画。禁止把漫画真人化、真人卡通化或创造通用替代演员。
剧情与表演规则:
按照实际完整人物数量自动编排,不限制一定是五个人。一人时创作单口喜剧;两人时创作双人吐槽与反转;三人时安排开题、升级与收尾;四人或以上时让每人各自拥有一个主要搞笑段落,并让其他人物做自然无声反应。
喜剧发生在P1原本可见场景中。笑点来自人物性格差异、误会、抢话、反应和时间节奏,保持友好、自然和略带荒诞,不使用恶意羞辱或无关受伤闹剧。
建立接近P1原构图的开场群像,然后按照从左到右的人物账本,让每一名完整主要人物依次拥有一次清晰、可辨认的发言Beat,最后回到群像完成共同反转或最终包袱。运镜可以使用自然平移、短距离横移、重新构图和轻微推近;每个Shot只使用一个主要运镜,并尽量在发言者背景保留其他人的反应。
对白规则:
使用自然、口语化、有节奏的普通话对白,可带轻松的马来西亚华人口语感。根据实际人物数量自动创作简洁台词,必须优先压缩AI创作对白以适应45秒,不要为了保留冗长台词把影片自动延长到70秒以上。至少保留15%的时间给无对白反应、笑声、环境声、运镜和最终画面。
每位完整主要人物至少获得一句主要台词。每一句最终对白分别建立为独立、可编辑的Text Layer,设置explicit_user_requested=true,并使用对应的动态Speaker S1……SN。不得把对白埋入Shot Prompt。
每个Dialogue或Voice-over Text Layer必须设置voice_gender为male、female或auto。只根据对应P1人物的实际身份或用户明确说明选择male或female;无法可靠判断时使用auto。禁止按照S1、S2的奇偶编号猜测性别。voice_gender必须同时约束H3原生声线与外部TTS声线,整句不得中途变成另一种性别声线。
每一个Dialogue或Voice-over事件都必须建立在自己的可见Timeline轨道上(D1、D2、D3……或对应旁白轨道);同一个Speaker稍后再次发言也使用新的轨道,不复用前一条。独立轨道用于归属、编辑和避免前一句被后一句覆盖,不代表H3原生混合声音已经成为独立音频Stem。
每条非重叠对白期间,只有指定Speaker移动嘴唇和下颚;其他人物保持非发声嘴形,通过侧眼、眉毛、转头、憋笑、摇头、姿势或小手势做无声反应。默认Overlap Policy为AUTO,并按顺序说话处理:上一句结束后至少保留1.0秒闭嘴、无对白的释放区,供人物反应、环境声和非人声Foley继续,下一句才可开始。只有剧本明确要求打断、齐声或同时反应才使用OVERLAP并放入不同音轨,不得因为时间排得太紧自动产生重叠。Voice-over不驱动画面人物嘴形。
素材规则:
把P1登记为覆盖0.00秒至最终实际时长的whole_design h3_reference,并让每个Segment持续加载P1。
普通Talk Show不得生成任何新的演员、人物肖像、人物动作图或群像参考图。不要自动生成P2-P9陌生人物,不要让Z-Image重新设计P1人物;图片media_requests保持为空。近景、表情、嘴形和动作直接由H3依据P1完成。
声音规则:
对白必须听起来属于P1可见空间内的真实人物,保留自然距离、人物方位、呼吸、停顿和现场反射。持续保留环境底噪、服装动作、座椅或脚步、相机或现场物件的同步Foley。对白出现时环境声和Foley不得消失;只有非叙事背景音乐可以适度降低。禁止新增无来源对白。
画面限制:
禁止替换人物、换脸、复制人物、改变人物数量、随机换装、改变年龄、改变原始画风、生成陌生演员、增加无来源主要人物、错乱嘴形、让听众跟随发言者一起对嘴、烧入对白字幕、Logo、水印、UI或无关文字。
最后0.5至1.0秒必须完成最终笑点并保持稳定Final Hold,不得开始新对白或新动作。
本次Talk Show主题或补充要求:
请让P1中的每位完整主要人物围绕“大家原本只想谁买单,最后却为了谁买单互相推卸”各自说一段自然搞笑的话,结尾由所有人把责任指向镜头外的摄影者。
-
私人会所小段子。。。
请根据已经加载的@P1,创作一部45秒的群像搞笑Talk Show短片。
P1人物分析规则:
先分析P1中完整、清晰、属于主要群像的前景人物数量,不得固定假设五个人。忽略画面边缘被裁切的局部身体、背景路人、反射、海报、雕像、人体模型或重复形象。
按照P1开场构图从左到右,把完整主要人物依次建立为S1、S2、S3……SN。每个Speaker必须始终对应同一名P1人物,不得因为运镜、切近景、性别或发言顺序而交换编号。
P1是全片人物身份、脸孔、发型、年龄感、身形、完整服装、鞋子、配饰、原始人物数量、人物相对位置、背景场景、色调与视觉媒介的最高事实。P1是真人就保持真人,P1是漫画就保持原漫画线条与上色,P1是3D就保持3D,P1是插画就保持插画。禁止把漫画真人化、真人卡通化或创造通用替代演员。
剧情与表演规则:
按照实际完整人物数量自动编排,不限制一定是五个人。一人时创作单口喜剧;两人时创作双人吐槽与反转;三人时安排开题、升级与收尾;四人或以上时让每人各自拥有一个主要搞笑段落,并让其他人物做自然无声反应。
喜剧发生在P1原本可见场景中。笑点来自人物性格差异、误会、抢话、反应和时间节奏,保持友好、自然和略带荒诞,不使用恶意羞辱或无关受伤闹剧。
建立接近P1原构图的开场群像,然后按照从左到右的人物账本,让每一名完整主要人物依次拥有一次清晰、可辨认的发言Beat,最后回到群像完成共同反转或最终包袱。运镜可以使用自然平移、短距离横移、重新构图和轻微推近;每个Shot只使用一个主要运镜,并尽量在发言者背景保留其他人的反应。
对白规则:
使用自然、口语化、有节奏的普通话对白,可带轻松的马来西亚华人口语感。根据实际人物数量自动创作简洁台词,必须优先压缩AI创作对白以适应45秒,不要为了保留冗长台词把影片自动延长到70秒以上。至少保留15%的时间给无对白反应、笑声、环境声、运镜和最终画面。
每位完整主要人物至少获得一句主要台词。每一句最终对白分别建立为独立、可编辑的Text Layer,设置explicit_user_requested=true,并使用对应的动态Speaker S1……SN。不得把对白埋入Shot Prompt。
每个Dialogue或Voice-over Text Layer必须设置voice_gender为male、female或auto。只根据对应P1人物的实际身份或用户明确说明选择male或female;无法可靠判断时使用auto。禁止按照S1、S2的奇偶编号猜测性别。voice_gender必须同时约束H3原生声线与外部TTS声线,整句不得中途变成另一种性别声线。
每一个Dialogue或Voice-over事件都必须建立在自己的可见Timeline轨道上(D1、D2、D3……或对应旁白轨道);同一个Speaker稍后再次发言也使用新的轨道,不复用前一条。独立轨道用于归属、编辑和避免前一句被后一句覆盖,不代表H3原生混合声音已经成为独立音频Stem。
每条非重叠对白期间,只有指定Speaker移动嘴唇和下颚;其他人物保持非发声嘴形,通过侧眼、眉毛、转头、憋笑、摇头、姿势或小手势做无声反应。默认Overlap Policy为AUTO,并按顺序说话处理:上一句结束后至少保留1.0秒闭嘴、无对白的释放区,供人物反应、环境声和非人声Foley继续,下一句才可开始。只有剧本明确要求打断、齐声或同时反应才使用OVERLAP并放入不同音轨,不得因为时间排得太紧自动产生重叠。Voice-over不驱动画面人物嘴形。
素材规则:
把P1登记为覆盖0.00秒至最终实际时长的whole_design h3_reference,并让每个Segment持续加载P1。
普通Talk Show不得生成任何新的演员、人物肖像、人物动作图或群像参考图。不要自动生成P2-P9陌生人物,不要让Z-Image重新设计P1人物;图片media_requests保持为空。近景、表情、嘴形和动作直接由H3依据P1完成。
声音规则:
对白必须听起来属于P1可见空间内的真实人物,保留自然距离、人物方位、呼吸、停顿和现场反射。持续保留环境底噪、服装动作、座椅或脚步、相机或现场物件的同步Foley。对白出现时环境声和Foley不得消失;只有非叙事背景音乐可以适度降低。禁止新增无来源对白。
画面限制:
禁止替换人物、换脸、复制人物、改变人物数量、随机换装、改变年龄、改变原始画风、生成陌生演员、增加无来源主要人物、错乱嘴形、让听众跟随发言者一起对嘴、烧入对白字幕、Logo、水印、UI或无关文字。
最后0.5至1.0秒必须完成最终笑点并保持稳定Final Hold,不得开始新对白或新动作。
本次Talk Show主题或补充要求:
请让P1中的每位完整主要人物围绕“大家原本只想正常喝酒拍一张合照,最后却为了谁喝醉互相推卸”各自说一段自然搞笑的话,结尾由所有人把责任指向镜头外的摄影者。
-
-




 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!