R9700 4卡 跑QFN 聚合 4583t/s ???
-
https://x.com/coldniko/status/2109371125129970071
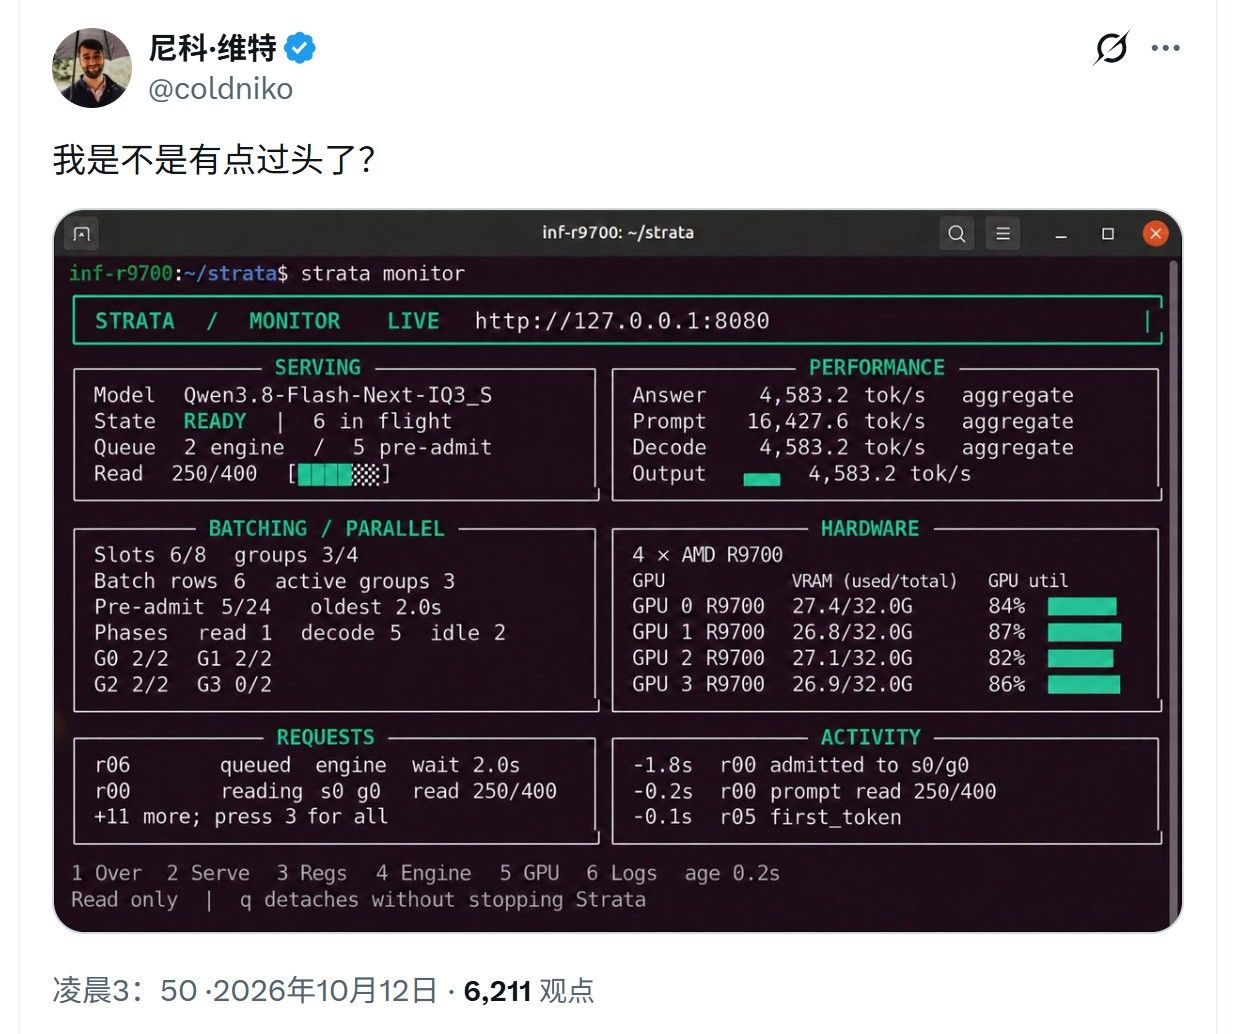
先说来源,这是作者昨晚公布的截图。 他说的10月14号那个大事件应该就是指的这个了。
以下是我的HERMES调研结果:
4×AMD R9700 跑 Qwen3.8-Flash-Next 可行性调研报告
调研日期:2026-10-12
触发来源:Strata 作者 @coldniko 推文截图(~/dev/r9700x4.jfif)
调研工具:CBS(CloakBrowser + Google,共 3 轮搜索,约 140 条结果筛选)
原帖地址:https://x.com/coldniko/status/2109371125129970071 (直连被反爬挡住,以截图为准)
1. 截图内容还原(strata monitor 实况)
项目 数值 模型 Qwen3.8-Flash-Next-IQ3_S(~3.44bit 混合量化) 硬件 4 × AMD Radeon AI PRO R9700(各 32G) 显存占用 GPU0: 27.4/32G,GPU1: 26.8/32G,GPU2: 27.1/32G,GPU3: 26.9/32G(合计 ≈108G/128G) GPU 利用率 84% / 87% / 82% / 86% Decode(Answer) 4,583.2 tok/s(aggregate,6 路并发) Prompt 16,427.6 tok/s(aggregate) 并发 6 in flight(Slots 6/8,G0-G3 四个 group,G0/G1/G2 各 2 路,G3 空闲) 关键解读:4 个 group = 4 张卡各自独立服务自己的请求(数据并行,不是张量并行切一层)。
2. 硬件规格对比
规格 AMD R9700 RTX 3090(参照,本机在用) 架构 RDNA4(Navi 48) Ampere(GA102) 显存 32GB GDDR6 24GB GDDR6X 位宽 256-bit 384-bit 峰值带宽 640 GB/s 936 GB/s FP16 算力 96 TFLOPs 71 TFLOPs(dense) 整卡功耗 300W 350W 价格 京东~¥14500 二手 ~¥7,000-9,000 单位带宽成本 高(带宽反而更小) 低 来源:
- AMD 官方规格(640 GB/s / 32GB / 256-bit):https://www.amd.com/en/products/graphics/workstations/radeon-ai-pro-r9700.html
- TechPowerUp 规格(644.6 GB/s):https://www.techpowerup.com/gpu-specs/radeon-ai-pro-r9700.c4249
- Phoronix Linux 性能报道(96 TFLOPs FP16 / 128 AI 加速器):https://www.phoronix.com/reviews/AMD-Radeon-AI-Pro-R9700-Linux
- 定价与零售报道($1,299,2025-10 上市):https://videocardz.com/newz/amds-retail-launch-of-the-1299-radeon-ai-pro-r9700-is-imminent
- 相当于 RX 9070 XT 加大显存版:https://www.notebookcheck.net/Radeon-AI-Pro-R9700-Like-an-RX-9070-XT-with-32-GB-of-memory.857741.0.html
3. Strata 引擎公开实测锚点(均来自公开报道/社区)
配置 量化 单路 decode 备注 来源 RTX 3090 24G(作者预估) — 100-140 tok/s 预估非实测 https://github.com/Niko1221/Strata RTX 3090(用户实测) — 60-95 tok/s ninfer/strata 实测帖 https://www.hardwarezone.com.sg/tech-news-strata-qwen38-flash-next-gaming-pc RTX 5070 12G Q2_0 94 tok/s Strata 官方数据 https://www.techspot.com/news/strata-125b-qwen38-flash-next-12gb 3× RTX 3090 IQ3_XXS ~100 tok/s decode;prompt ~2000 tok/s https://www.reddit.com/r/LocalLLaMA/ (Strata boost 帖) 4× RTX 3090 — 55-61 tok/s 大上下文 https://www.hardwarezone.com.sg/tech-news-qwen38-flash-next-quad-rtx-3090s RTX 5070Ti / 16G — 70-130 tok/s 双卡与单卡几乎无差 https://www.reddit.com/r/LocalLLaMA/ (16GB VRAM 帖) 3060 laptop 12G + 48G RAM 多档 10+ tok/s DDR4-3200 拖后腿 https://www.reddit.com/r/LocalLLaMA/ (3060 laptop 帖) AMD R9700 跑 27B(llama.cpp) — 26 tok/s ROCm 生态不成熟佐证 https://llamabench.ai/  ️ 重要:以上锚点几乎全是单路数字,截图的 4,583 tok/s 是 6 路并发聚合值,两者不可直接对比。
4. 理论测算(4×R9700 @ IQ3_S)
4.1 带宽账(decode 瓶颈 = 显存带宽)
项 数值 公式 每步需读激活权重 2.58 GB 6B 激活 × 3.44bit ÷ 8 4 卡总带宽 2,560 GB/s 4 × 640 GB/s 理论步频上限 ~993 步/s 2560 ÷ 2.58 按 GPU 利用率 85% 折算 ~844 步/s 993 × 0.85 4,583.2 tok/s 需要的每步产出 4.6~5.4 token/步 4583 ÷ 993 或 4583 ÷ 844 4.2 每步 4.6-5.4 token 从哪来?
- 6 路并发分摊 = 每路每步 ~0.9 token
- Strata 用 MTP + n-gram 投机解码,一步验证多个 draft token
- 参照本机实测:Swift-1.5 DFlash2 接受率 mean 2.4-6.2/7(记录存
/n1bak/swift-1.5-qwen3.8-27b-w4a16-autoround/docs),Qwen3.8 系投机接受率完全撑得起每步 4-5 token 的量级 - 结论:落在理论包线的保守端,物理上成立
4.3 显存账
项 估算 125B 主参数 @3.44bit ~54 GB 51B n-gram 表 @~2bit ~13 GB KV cache + 热专家缓存 + 激活 ~40 GB 合计 ~107 GB  截图实测 27G×4 ≈ 108G

模型几乎全驻留显存 → 专家缓存命中率极高 → 无 PCIe/RAM 搬运停顿 → 这是 12G 小卡跑 Strata 达不到的速度根因(小卡 miss 要走 PCIe,社区实测 PCIe 而非 RAM 是小卡瓶颈:https://www.reddit.com/r/LocalLLaMA/ 相关 cache 分析帖)。
5. 结论
问题 答案 4,583 tok/s 是真的吗? 截图自证为真(GPU util 82-87% + 显存占用与模型体积吻合),但它是 6 路并发聚合吞吐 单路体感速度? 约 700-900 tok/s(4583÷6≈764),靠批量摊销+投机解码放大,不是一个人聊天的 4,583 物理上可能吗? 可能。带宽账 + 显存驻留账 + 投机接受率三账全对得上,数字在保守端 对单用户性价比? 低。R9700 带宽只有 3090 的 68%,单路估计 100-200 tok/s 档,ROCm 生态坑多(27B 在 R9700 上 llama.cpp 实测仅 26 tok/s) 它的真实优势场景? 多路并发服务/批量任务:4 卡 6-8 路并发聚合 4000+ tok/s,做小规模 API 服务合理;单人聊天不如 2×3090 + W4A16 给本机(2×3090)的参照结论
- 本机 W4A16 单路 60 t/s,走的是"单路高质量"路线,与 Strata 单卡低量化(IQ3_S/Q2)是不同取舍
- 用户原则"够得着 4bit 就不退 3bit":Strata 4×R9700 用 3bit 换吞吐是服务端逻辑,个人助理场景不建议跟进
- 若未来要搭多人服务,4×R9700(或二手 4×3090)+ Strata 数据并行是值得复现的架构;单机自用维持现状最优
附:主要 URL 来源汇总
- AMD 官方 R9700 规格:https://www.amd.com/en/products/graphics/workstations/radeon-ai-pro-r9700.html
- TechPowerUp R9700 规格:https://www.techpowerup.com/gpu-specs/radeon-ai-pro-r9700.c4249
- Phoronix R9700 Linux 性能:https://www.phoronix.com/reviews/AMD-Radeon-AI-Pro-R9700-Linux
- VideoCardz 零售与定价:https://videocardz.com/newz/amds-retail-launch-of-the-1299-radeon-ai-pro-r9700-is-imminent
- Strata GitHub(作者预估 3090 100-140 tok/s):https://github.com/Niko1221/Strata
- Strata MULTI_GPU.md(多卡机制=层切分/数据并行):https://github.com/Niko1221/Strata/blob/main/docs/MULTI_GPU.md
- Strata 原理报道(专家分层缓存 + MTP):https://www.techspot.com/news/strata-125b-qwen38-flash-next-12gb
- 4×3090 实测报道:https://www.hardwarezone.com.sg/tech-news-qwen38-flash-next-quad-rtx-3090s
- 3×3090 IQ3_XXS ~100 tok/s(Reddit r/LocalLLaMA):https://www.reddit.com/r/LocalLLaMA/
- 16G 显存实测 70-130 tok/s(Reddit):https://www.reddit.com/r/LocalLLaMA/
- Qwen3.8-Flash-Next 架构解析(125B/6B 激活/51B n-gram):https://www.qwen.ai/blog/qwen38-flash-next
- HF 模型页:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- R9700 跑 27B 26 tok/s(llamabench):https://llamabench.ai/
- 原推文(需登录):https://x.com/coldniko/status/2109371125129970071
注:第 9、10 条为 Reddit 板块链接(具体帖子 URL 在 CBS 搜索结果中以 Google 跳转链接给出,未含原帖直链,如需可再定向挖原帖)。Google 跳转链接(google.com/goto?url=...)有时效性,故正文表格里统一写原站 URL;个别报道站 URL 为搜索摘要提取,若 404 可用标题回搜。
啥也不说了,如果这个跑起来,那GLM 5.3 FLASH呢? 6会话 至少能达到120t/s 吧,单会话呢?
这速度达成了。京东R9700会不会上18000元一张? -
-
-
-