5090 32G + 128G 内存跑Strata驱动Qwen 3.8 Flash也不够?框架多会话有Bug,32G显存以上建议暂时跑27B + SGLang,等待Qwen4.0大更新!
-
论坛有网友发帖说,他是用5090 32G这张显卡,加上128G的内存来驱动Strata,跑这个千问3.8 Flash Next这个火热的模型。但是呢,他单会话的体验还可以;如果是多会话长上下文,那体验就非常糟糕,意思就是并发能力不强。问这个问题有没有解?讲实话啊,现在这个Strata主力的优化方向还是单会话长上下文,它这个多会话是有问题的。就是它在多个slot之间切换的话,会导致一个什么样的问题呢?它之前已经算过的这个KV缓存,它可能无法正确地识别。这个是框架本身的bug,应该是暂时没有解的。
但是呢,我们知道Strata是一个刚刚出来不久、然后在整个圈子里可以说是非常火爆的框架,有大量的人员参与这个开源项目的研发维护。可能就是由于作者本人精力有限,导致现在有一些bug没有及时解决。但是,作为一个如此火爆、可以说掀起了行业革命的新框架,它本身的技术底子就非常不错。我相信这样的bug不久之后就会得到解决。其实现在新的版本每天都会发,然后每隔一段时间就有重大进步。很有可能这个视频发完,或者说我正在这里对着镜头BB录像的时候,这些技术团队已经在解决这个问题了。
那不用担心啊,如果你的硬件本身达标,128G的内存,尤其是DDR4、DDR5这种高性能的内存,再加上5090 32G这样的高逼格显卡,强算力,带宽也是非常充足,那么你完全不用担心,再过一段时间它自然就能跑了。现在你也不要着急,不要急着进行技术验证。如果你一定要当下立刻找一个能干活的方案,那么我就给你推荐:你有32G显存,就直接上SGLang跑这个NVFP4权重,也就是4比特量化版本的千问27B。由于有HiCache技术的存在,32G又是SGLang一个比较经典的入门显存要求,再加上Blackwell架构的NVFP4加持,它的体验是非常好的。
你也不用担心显存不够,因为你32G的显存扣除框架开销,再减去4比特量化版本的模型权重之后,还有相当长的上下文空间。当然了,单纯用显存,你肯定跑不了多会话长上下文。不过由于你有128G内存,用HiCache技术,这个在论坛已经经过广泛测试了,是非常成熟的,你就可以开非常长的上下文。这个时候你多并发,你TM开4并发,甚至按照5090这种性能,给它开6并发、8并发都可能能搞。我之前用4090 48G加上64G的DDR3内存,使用DFlash,就是放一个小的草稿模型。我自己实测开了四个会话,其中有两个是长上下文会话,两个128K的;另外两个是中等长度的,32K还是64K我忘记了。但是这是我实测的,没有问题。我相信对于绝大多数人来说,基本上有4个会话左右就够用了。
必须要说明,我当时测的时候还没有开启HiCache。如果开启HiCache,体验可能会更好一点。但是由于我的内存本身是DDR3,而且也不大,才64G,所以体验可能没有使用5090那么好。你手中如果有5090,而且是DDR5内存,主板是PCIe 5.0 x16带宽,那你使用HiCache的体验肯定比我要好一点。短期内,你如果有立刻就要工作的迫切需求,是有这种方案的。
那你说什么千问27B,很多人说没有千问3.8 Flash Next聪明。这个跑分,包括你感觉到的聪明,只是你长链任务中的一个部分。你执行长链任务,它明显没有27B快,尤其是你使用5090这种高带宽、强算力的旗舰卡,双方速度上的差距会非常明显。而且我说实话,就算你用千问3.8 Flash Next这个模型,它在任务规划方面,与在线的DeepSeek V4.1 Flash、GPT-6.1 Sol,或者Claude 5.5 Sonnet这样的有性价比的模型,我觉得能力上还是有差距的。
如果你是Claude或者GPT的订阅用户,那么你花不了多少钱。比如GPT的20美金套餐,像我平时用它来开发维护我的APP,然后做一些复杂任务的规划,把脏活累活交给千问27B去做,实际上消耗不了几个钱,额度完全够。你不用担心它蠢,它的智商是非常充足的。它与千问3.8 Flash Max不是谁强谁弱,尽管3.8 Flash Max跑分明显高一点,但是它们的实际体验,我个人认为没有什么差距,最起码在我的体感上,我认为执行长链任务的时候,27B表现更好一点、更稳定一点。
当然了,3.8 Flash Next这个模型后续会有进步,因为它本身这个Next的意思就是4.0技术的预演版。升级到4.0之后,由于模型权重本身的优化,加上Strata框架的优化,到时候Strata加上千问4.0 Flash Next,一定能够跑出非常亮眼的成绩。但是这个4.0 Flash什么时候出,官方不知道。不过很快,就这个月月底,我们就能用上千问4.0 27B。我相信相比于3.8 27B,这次阿里巴巴一定不会让我们失望,因为它从3.5到3.6再到3.8,每一次进步都非常明显。这个4.0又号称是大的代际革新,那我相信千问27B在月底一定会掀起一轮狂潮。到时候各个主播、各大平台都会疯狂测试它,我们也会稍微跟进一下。如果论坛有比较牛逼的朋友测试,我们很有可能就不做重复造轮子的工作了,直接剽窃水一期。
然后我再提一下关于模型怎么选择、怎么选框架。当下我给两个个人比较推荐的方案。如果你是32G显存以下,比如24G,像7900 XTX、3090 24G单卡,或者5080 16G、5070 Ti、5060 Ti 16G,或者显存更低,我建议你们把精力放在购置更大的内存上。因为内存现在虽然也贵,但是比起显存来说便宜得多,单位价格要便宜得多。你们去升级内存,然后跑千问3.8 Flash Next,或者战未来、跑未来的千问4.0 Flash,这都是比较好的选择。因为24G显存,无论是XTX还是3090,跑千问27B都选不了SGLang,因为SGLang本身框架开销比较大,对显存要求比较高。如果用llama.cpp、NInfer,那么都能跑得比较好。但是如果要用SGLang,体验不会好,因为扣除框架开销之后,能用来缓存的显存余量非常低,用SGLang体验就不好。用NInfer、HaloGen或者DFlash,在跑特定卡的时候表现其实都还可以,但是跟Strata比起来都有很大差距。稍微花点钱升级一下内存,为了Strata绝对是值得的。
如果你的显存大于等于32G,包括4080S 32G魔改卡、RTX Pro 4500、4090 48G、RTX Pro 5000 48G,其实当下都没有必要急着上千问3.8 Flash Max,因为这个模型,包括Strata这个架构,现在都还是半成品。你要它稳定工作,肯定没有二次计费省心。这个时候,你通过SGLang加上DFlash或者DSpark技术,再加上HiCache,去跑千问27B,很短时间内就能够获得一个稳定干活、智力在线的模型,多会话没有什么问题。
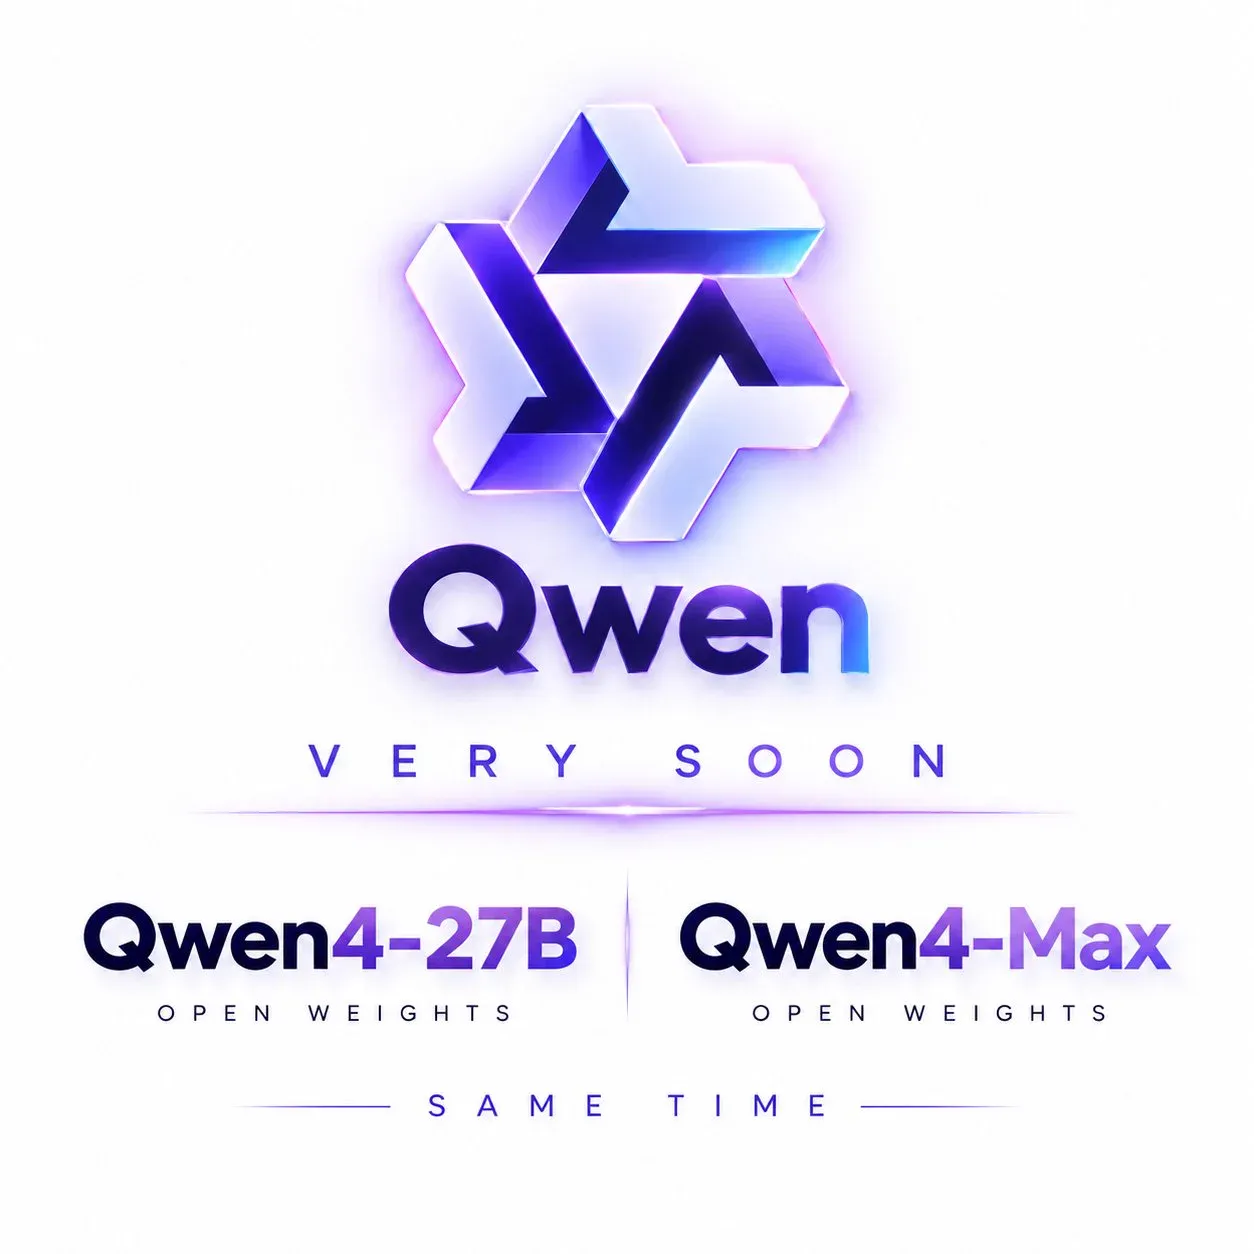
然后我们还要特别提一下刚才所说的千问4.0 27B,它一定是一个有革命性提升、非常值得期待的甜点模型。阿里巴巴应该会隔一段时间再把千问4.0 Flash放出来。第一是为了把模型打造得更好一点;第二是要把热度吃足嘛。它不可能27B刚刚发布,大家还没有玩嗨,社区热度还没有上来,开源的红利还没有吃透,就把千问4.0 Flash放出来,这肯定不至于这样。它肯定是等27B让大家吃足红利、生态弄起来、阿里巴巴吃足红利之后,才会把4.0 Flash放出来。
就我个人的理解,在27B这个尺寸上,它完全可以把agent、编程,包括系统配置、写脚本这些工作吃透,权重尺寸是足够的。剩下来的一些能力,你说支持库不足,其实我觉得很好解决,现在有网络、有检索嘛。一切复杂工作交给AI之后,本质上都是编程,只要你能把编程这一块做好,把工具调用这一块做好,推理的时候再能保持非常高的一致性、减少幻觉,那么这个模型本身就非常难打,27B是足够做到的。
好吧,我们总结一下:如果你的显存是32G以上,我建议大家短期内不要折腾Strata了,就让社区慢慢优化。你把非常牛逼、显存很高的显卡用来跑SGLang,然后用27B来干活。有些复杂的规划任务就交给在线模型,比如DeepSeek V4.1 Flash、GPT-6.1 Sol、Claude Sonnet或者Opus,都可以。如果你的显存小于32G,是24G及以下,不会有什么方案比Strata更有性价比。你们现在折腾它的单会话长上下文工作,满足大多数人的需求,它现在体验不错,现在就能干活,现在就能为你挣钱。但是如果你想要多会话,尤其是多会话长上下文,那就稍微等一等嘛。我觉得最多就个把月吧,个把月的事情,啊,个把两个月的事情,不用担心。可以断言,两个月之内这个生态一定会非常成熟,快的话可能一个多月就搞定了。对未来不要有焦虑。
-
-
-
-
证明strata 这些策略是对的,让nvidia做事。。。到时候ai 用户可以更加愿意购买他的16g显卡,又或者证明在64g rtx spark 里达到可用又高ts
-
我4080s 32g,现在更喜欢用qfn而不是27b,只因为不想显卡太热,27b显卡一直呼呼响, qfn安静多了
-
@kos-or 我之前查了下 是用户用claude 改代码 用claude 提交
并不是官方下场看來應該是, 可能是Github 判斷或解析作者時的方式差異
ChatGPT的分析 :
GitHub 會解析這種署名,並可能將 AI 顯示在共同作者或 Contributors 區域。
但這不是安全認證,任何能修改 Commit 訊息的人都可以寫入這類署名。GitHub 是否正確對應帳號,還取決於作者身分解析機制。
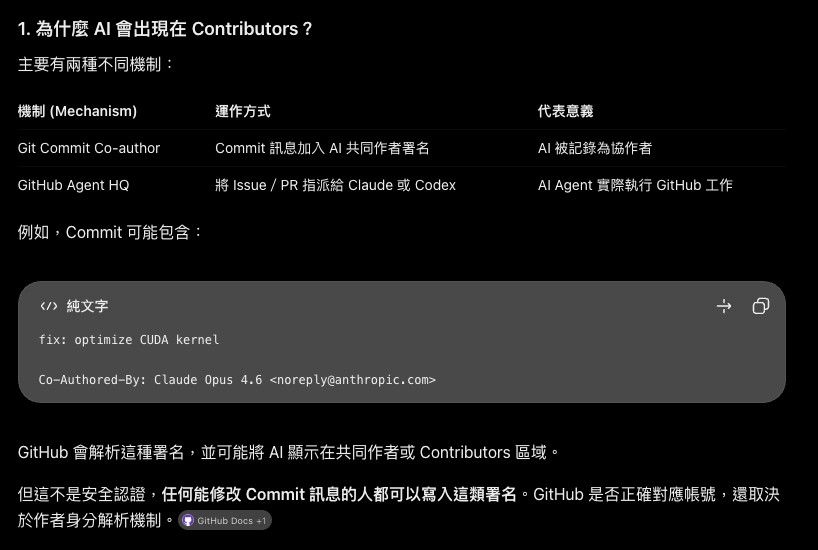
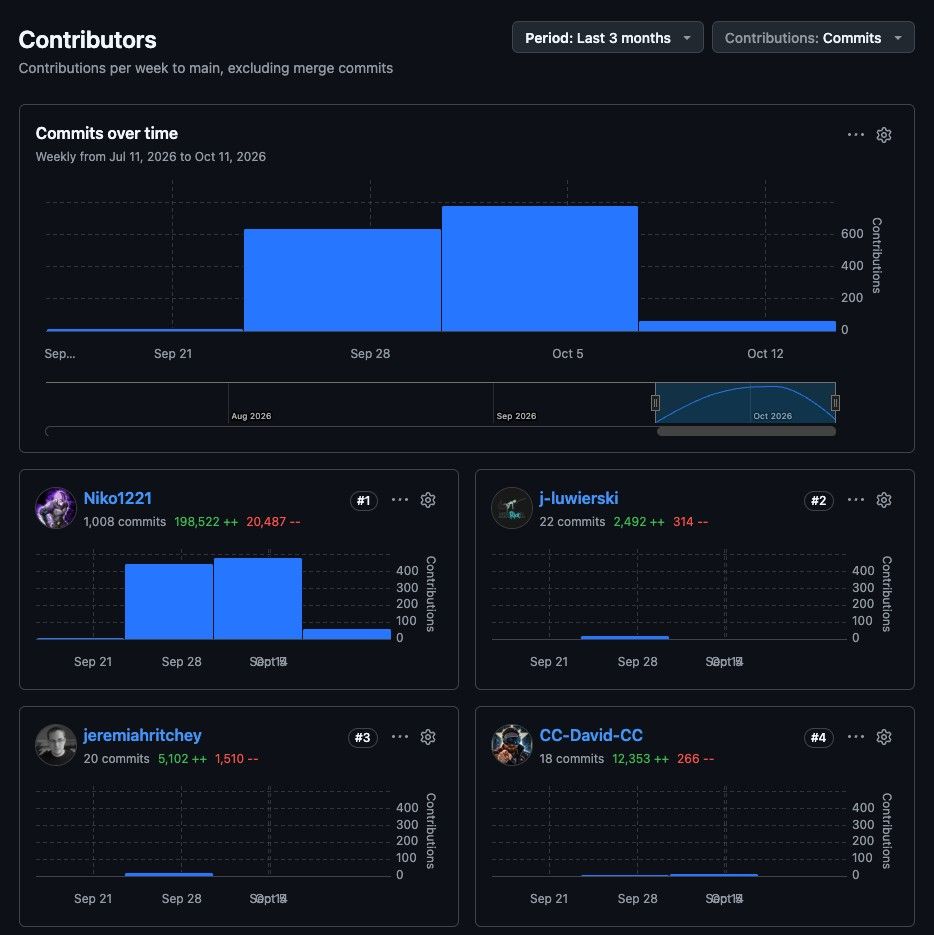
這就奇怪了Strata Contributors的 Claude 標誌消失了, 但其他專案Contributors還有Claude 的官方標誌
如果是用户用claude 改代码 用claude 提交, 然後以官方Claude Github帳戶提交? 當然或許Niko把這樣的方式禁止了 避免混亂NInfer Contributors : Claude 官方帳戶目前有在NInfer project中
https://github.com/Neroued/ninfer
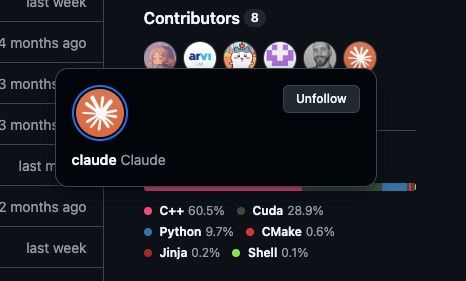
Strata Contributors
https://github.com/Niko1221/Strata
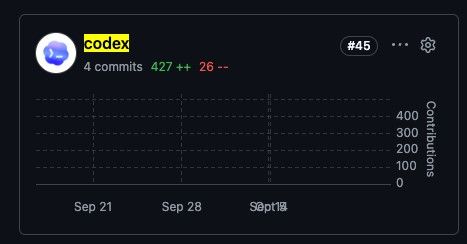
Claude github account 消失了, 只剩下 Codex github account
-
-
@kos-or 我之前查了下 是用户用claude 改代码 用claude 提交
并不是官方下场@kos-or 我之前查了下 是用户用claude 改代码 用claude 提交
并不是官方下场是的,確認+1。