
新手请教16G显存32G内存装哪个版本的模型
-
-
32G物理内存少了,翻一倍到64G才摸到strata跑qwen3.8-flash-next的门槛
看看其它大神怎么说吧,反正我觉得蛮尴尬的,高不成低不就,跑啥都缺资源
@joker_chang 对,我现在就尴尬在这里,有点冲动想加内存了,但是不知道加了内存后部署了本地模型,会不会得到自己想要的结果……买内存的钱是用来买token划算还是本地部署划算,一直纠结中
-
-
要看你计划做什么,其实锤哥在他的视频中说过无数次了,除非有数据安全的要求,肯定是在线API香,你买一根ddr5的钱够你用好久好久了。
@joker_chang 也是
 倒没什么数据安全要求,就是看到说什么token自由,有点心动
-
-
各位大佬,看到很多本地部署大模型的视频,但是现在陷入了尴尬的局面,5080显卡16G显存+32Gddr5内存,到底是部署27B版本的模型还是部署125B的轻量化的模型呢?请各位大佬指点

@long-cheng
你这个配置有点尴尬,先跑一个轻量的Qwen3.8-27B试一试,以后升级内存还是跑QFN效果更好一点。可以参考下面这个帖子。
https://lcz.me/topic/2250 -
-
@long-cheng
你这个配置有点尴尬,先跑一个轻量的Qwen3.8-27B试一试,以后升级内存还是跑QFN效果更好一点。可以参考下面这个帖子。
https://lcz.me/topic/2250 -
@perter OKOK,我去看看
@long-cheng
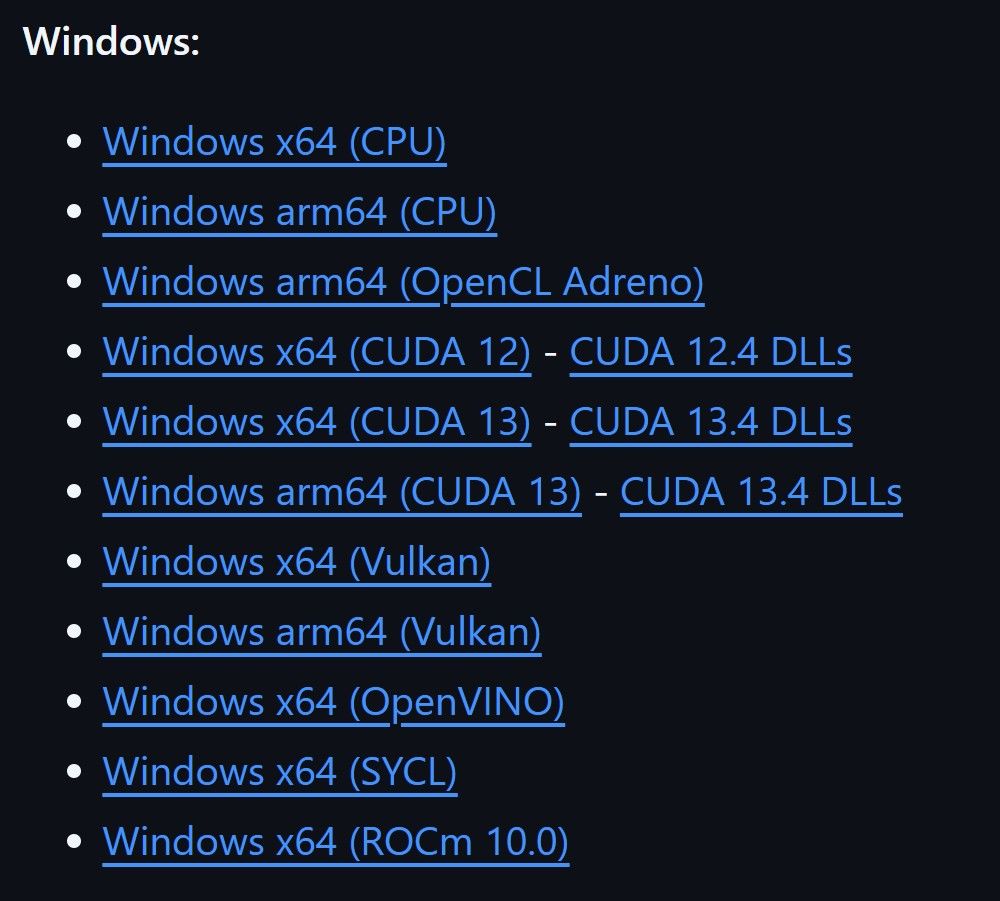
https://github.com/ggml-org/llama.cpp/releases
先下载这两个文件后解压合并到一个文件夹,再把模型文件下载放到指定的文件夹即可。
Windows x64 (CUDA 13)
CUDA 13.4 DLLs
-
-
@un1980 厉害厉害

-
-
就等于你租房子和买房子的道理是一样。。。。
东西越来也贵,价格越来也高,1 就现在买,2就是等崩盘,3就是租token
如果你连32g 都要想半天的话,其实可以先试一试先租token,
然而等你token钱花的七七八八,你就会想起为什么当初不干脆去买
我们所谓的token钱很省的代价是包月,5小时限制,每个星期固定reset,如果api 形式就必须度量你可以承担的消费数额 -
16G显存可以试试Ninfer。
我用笔记本跑的情况,供参考 https://lcz.me/topic/2381
32K CTX太小了,Agent得不停压缩上下文,作为本地大模型,至少64K以上,17K tps才可用。




