跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. 請問關於Qwen3.8-Flash-Next

請問關於Qwen3.8-Flash-Next

已定时 已固定 已锁定 已移动 随便聊聊
qwen-flashstrata本地模型
13 帖子 6 发布者 459 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 怪物怪
    怪物怪
    怪物
    体面乡绅 硕果累累
    编写于 最后由 编辑
    #1

    各位前輩大家好,
    我現在使用的是qwen 3.8 27B Q8的版本256K上下文
    用Hermes開的時候,大概佔41.5G VRAM,
    同時叫他開ComfyUI使用minimax H3生成視訊的時候,
    會用到94.5G VRAM,GPU使用率常常100%,CPU 4%,記憶體40%(76G)
    聽說用Strata跑Qwen3.8-Flash-Next 可以用比較少的VRAM
    不知道我192G記憶體跟96G VRAM,適合跑哪一個版本的Qwen3.8-Flash-Next ?
    我希望精度高一點,但是不要占用超過40G VRAM,
    這樣的版本要到哪裡下載呢?
    因為我看不懂英文,所以對很多訊息都很模糊,又不知道怎麼搜索論壇,
    請各位前輩指導一下,
    謝謝

    johnnybegoodJ perterP 2 条回复 最后回复
    0
    • 怪物怪 怪物

      各位前輩大家好,
      我現在使用的是qwen 3.8 27B Q8的版本256K上下文
      用Hermes開的時候,大概佔41.5G VRAM,
      同時叫他開ComfyUI使用minimax H3生成視訊的時候,
      會用到94.5G VRAM,GPU使用率常常100%,CPU 4%,記憶體40%(76G)
      聽說用Strata跑Qwen3.8-Flash-Next 可以用比較少的VRAM
      不知道我192G記憶體跟96G VRAM,適合跑哪一個版本的Qwen3.8-Flash-Next ?
      我希望精度高一點,但是不要占用超過40G VRAM,
      這樣的版本要到哪裡下載呢?
      因為我看不懂英文,所以對很多訊息都很模糊,又不知道怎麼搜索論壇,
      請各位前輩指導一下,
      謝謝

      johnnybegoodJ
      johnnybegoodJ
      johnnybegood
      王侯将相
      编写于 最后由 编辑
      #2

      @怪物 如果是 8bit 精度的话, 应该就是这么大了, 换什么版本都差不多。 关键是 minimax H3 跑的时候, 我 3090 24G 都能跑的很顺的, 所以应该不用操心这个把。

      怪物怪 1 条回复 最后回复
      0
      • kop wangK
        kop wangK
        kop wang
        易有太极
        编写于 最后由 编辑
        #3

        可以参照我的帖https://lcz.me/topic/2189/12

        IQ3_XXS,然后把专家控制在15000,大概就是40vram。

        但是问题是,太多专家在RAM中,会明显拖慢速度。无法发挥出moe模型prefill和decode压力小的优势。

        虚心交流,一起进步

        怪物怪 1 条回复 最后回复
        0
        • kop wangK
          kop wangK
          kop wang
          易有太极
          编写于 最后由 编辑
          #4

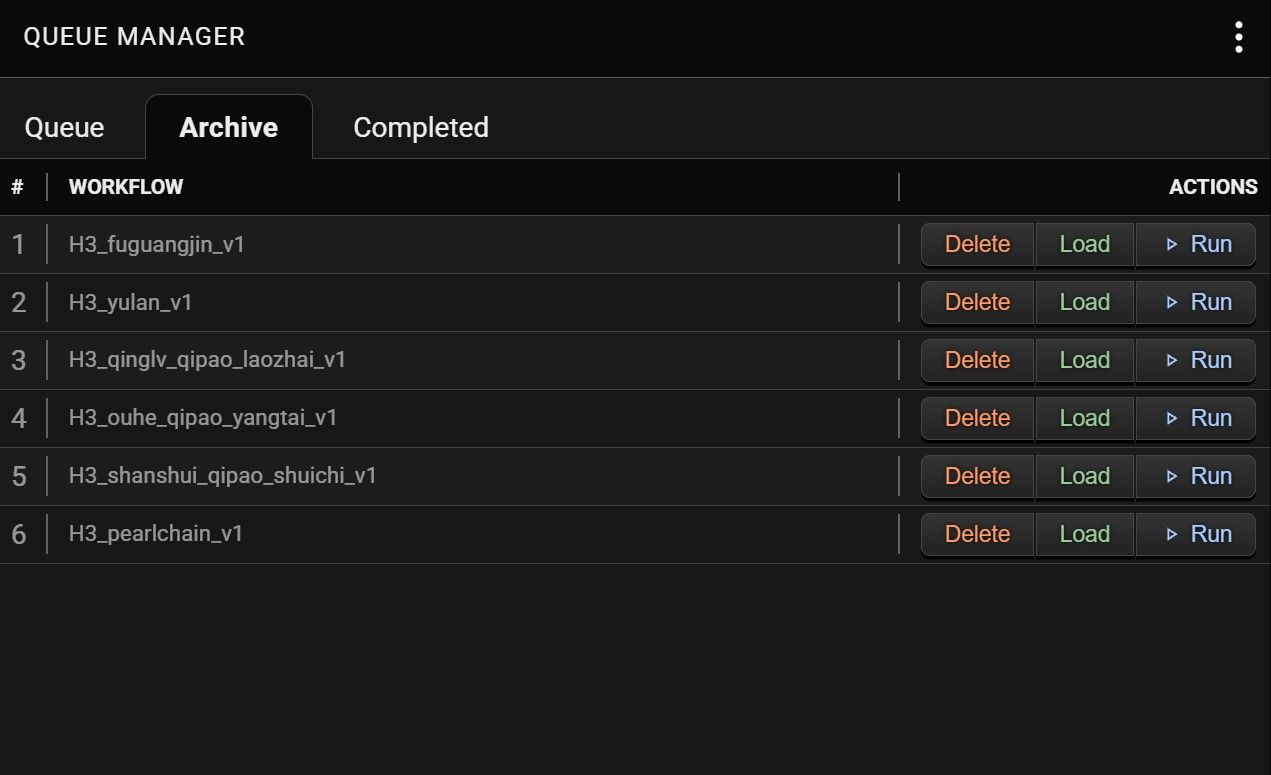
          btw:其实agent来直接驱动comfyUI并且等验收,相对而言是比较低效的。
          我的做法更多的是,让agent生成一系列的comfyUI任务,然后利用comfyUI的ComfyUI Queue Manager插件实现归档队列。

          然后夜深人静的时候再集中跑。
          image.jpeg

          虚心交流,一起进步

          怪物怪 1 条回复 最后回复
          1
          • T
            T
            tester12340
            体面乡绅 硕果累累
            编写于 最后由 编辑
            #5

            @怪物 hermes agent 不建议用桌面版。

            怪物怪 1 条回复 最后回复
            0
            • 怪物怪 怪物

              各位前輩大家好,
              我現在使用的是qwen 3.8 27B Q8的版本256K上下文
              用Hermes開的時候,大概佔41.5G VRAM,
              同時叫他開ComfyUI使用minimax H3生成視訊的時候,
              會用到94.5G VRAM,GPU使用率常常100%,CPU 4%,記憶體40%(76G)
              聽說用Strata跑Qwen3.8-Flash-Next 可以用比較少的VRAM
              不知道我192G記憶體跟96G VRAM,適合跑哪一個版本的Qwen3.8-Flash-Next ?
              我希望精度高一點,但是不要占用超過40G VRAM,
              這樣的版本要到哪裡下載呢?
              因為我看不懂英文,所以對很多訊息都很模糊,又不知道怎麼搜索論壇,
              請各位前輩指導一下,
              謝謝

              perterP
              perterP
              perter
              贵族大夫 硕果累累
              编写于 最后由 编辑
              #6

              @怪物
              Strata运行Qwen3.8-Flash-Next时,想保留多少显存可以自己指定,比如保留8G显存。

              "--vram-reserve-mib",
              "8192",
              
              怪物怪 1 条回复 最后回复
              0
              • M
                M
                marsempire
                编写于 最后由 编辑
                #7

                装个沉浸式翻译插件翻译一下网页不就好了,或者让ai给你手搓一个翻译插件,跑一个本地翻译模型

                这年头不懂英文也无所谓了

                1 条回复 最后回复
                0
                • kop wangK kop wang

                  btw:其实agent来直接驱动comfyUI并且等验收,相对而言是比较低效的。
                  我的做法更多的是,让agent生成一系列的comfyUI任务,然后利用comfyUI的ComfyUI Queue Manager插件实现归档队列。

                  然后夜深人静的时候再集中跑。
                  image.jpeg

                  怪物怪
                  怪物怪
                  怪物
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #8

                  @kop-wang 原來可以這樣,雖然我還看不懂(因為看不懂英文),但是知道這個方向,可以請AI研究一下,謝謝

                  1 条回复 最后回复
                  0
                  • T tester12340

                    @怪物 hermes agent 不建议用桌面版。

                    怪物怪
                    怪物怪
                    怪物
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #9

                    @tester12340 用手機版嗎?我手機是用telegram連hermes,可是不太會操作

                    1 条回复 最后回复
                    0
                    • perterP perter

                      @怪物
                      Strata运行Qwen3.8-Flash-Next时,想保留多少显存可以自己指定,比如保留8G显存。

                      "--vram-reserve-mib",
                      "8192",
                      
                      怪物怪
                      怪物怪
                      怪物
                      体面乡绅 硕果累累
                      编写于 最后由 编辑
                      #10

                      @perter 好的,謝謝

                      1 条回复 最后回复
                      0
                      • johnnybegoodJ johnnybegood

                        @怪物 如果是 8bit 精度的话, 应该就是这么大了, 换什么版本都差不多。 关键是 minimax H3 跑的时候, 我 3090 24G 都能跑的很顺的, 所以应该不用操心这个把。

                        怪物怪
                        怪物怪
                        怪物
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #11

                        @johnnybegood 好的,謝謝

                        1 条回复 最后回复
                        0
                        • kop wangK kop wang

                          可以参照我的帖https://lcz.me/topic/2189/12

                          IQ3_XXS,然后把专家控制在15000,大概就是40vram。

                          但是问题是,太多专家在RAM中,会明显拖慢速度。无法发挥出moe模型prefill和decode压力小的优势。

                          怪物怪
                          怪物怪
                          怪物
                          体面乡绅 硕果累累
                          编写于 最后由 编辑
                          #12

                          @kop-wang 好的,謝謝

                          1 条回复 最后回复
                          0
                          • T
                            T
                            tester12340
                            体面乡绅 硕果累累
                            编写于 最后由 编辑
                            #13

                            @怪物 我的意思是说要用 cli。 桌面占用资源,而且会搞的很乱。 cli 接 telegrame 手机和 telegrame 桌面,很轻 很爽。每个bot 都隔离,定义专属职位。 用cron做定期任务。 我现在有大概10个bot 每天做不同的事情,而且记得一定要加自我学习,和自我完善。

                            1 条回复 最后回复
                            0

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组