
7900 XTX 的可能性探索|单卡篇(五)续:Hipfire 27B 的生产部署、模型质量与 Agent 实战
-
上一篇介绍了 Hipfire 在 RX 7900 XTX 上的推理性能,单卡 8K 上下文实现了 2682 t/s Prefill 和 169.4 t/s Decode,64K 上下文仍有 119.5 t/s Decode。
部署到实际使用环境后,这次继续测试四个方面:框架功能与限制、Hermes Agent 实际运行、标准题集质量,以及不同思考档位的效果。最后再让模型交几份有趣的编程作业。
结论优先,跑了三天测试,没有出现死循环,未发现影响主要功能的严重 Bug,能用,够用,单卡7900XTX好用
 ,我已经把自己单卡的生产环境换了这个推理框架。
一、Hipfire 框架与专属 MQ4-XTS 模型
1. 测试环境
项目 配置 GPU RX 7900 XTX 24GB,单卡 GPU 架构 AMD RDNA3 / gfx1100 推理框架 Hipfire v0.4.2.1 Commit 6b363a56a1ae模型 Qwen3.8-27B MQ4-XTS KV Cache Q8 显存管理 HIP VMM 推测解码 DFlash API OpenAI-compatible Agent Hermes Hipfire 是针对 AMD GPU 优化的推理框架。与常见的通用模型运行方案相比,其特色是专属 MQ4-XTS 模型格式、VMM 显存管理和 DFlash 推测解码。
这里测试的不是普通 GGUF Q4 文件,而是 Hipfire 框架与 MQ4-XTS 模型组合的整体表现。
2. 主要功能和实测情况
功能 测试情况 DFlash 推测解码 8K 下 169.4 t/s,约为 AR 的 3.39 倍 Q8 KV Cache 已用于所有主要长上下文性能测试 VMM 显存管理 已启用,支持按需映射 上下文 128K、160K 实测成功,约 176K OOM Prompt Cache 前缀复用已验证 视觉输入 简单图片、色块和示意图测试通过 Tool Calling 已接入 Hermes 并完成实际工具调用 思考档位 支持请求 Off / Low / Medium 并发 主要性能测试为 C1,尚无充分多并发验收 3. Prompt Cache
早期测试中,曾关注过 Hipfire 的前缀缓存能力。
后续生产环境验证确认,重复请求能够复用前缀 KV。在一次测试中:
指标 首次请求 重复请求 命中缓存 tokens — 6656 墙钟耗时 约 2.9s 约 0.3s 这是一次特定测试的结果,不代表所有任务都能获得相同加速,也不意味着模型具备无限容量的历史 KV 存储。
4. 实际限制

KV 显存硬边界
当前单卡 24GB、MQ4-XTS、Q8 KV 配置下:
- 128K:通过
- 160K:通过
- 约 176K:OOM (Q8KV下24G显存有点捉襟见肘这是硬伤,但是实测Q4 KV会严重损失速度,只能Q8)
因此,较高的逻辑上下文配置不等于对应长度一定能够实际运行。这个边界是当前模型及显存配置的实测限制,而不是 Hipfire 框架通用的固定上限。
并发能力
已有吞吐成绩主要来自 C1 单并发、Cold Context 测试。多并发吞吐、延迟以及显存压力尚无充分验证。
量化格式与兼容性
MQ4-XTS 是这套框架的专属模型格式。普通 Q4/GGUF 量化和 MQ4-XTS 不能直接等同;此前其他四位量化路径的失败现象也不能据此归因于 MQ4-XTS。
二、部署生产环境:Hermes Agent 能不能真正干活?
完成性能测试后,将 Hipfire 27B 接入 Hermes,作为实际 Agent 的推理后端。
这部分没有停留在简单问答,而是测试文件读写、工具调用、调查分析、代码调试、多轮执行和视觉输入。
1. 基础功能验收
测试 结果 基础 Tool Calling PASS 文件读取与调查 PASS 多步骤工具调用 PASS Coding / Debug PASS 视觉图片输入 PASS Prompt Cache 命中 PASS 动态思考请求 PASS(请求切换) 多轮 Agent 工作流 PASS 2. Coding / Debug
在预设问题的代码与配置调查中,模型成功定位三处缺陷。
一次 Medium 测试记录:
指标 实测 找到的问题 3 处 思考 tokens(测试记录) 约 10,558 墙钟时间 约 34s 3. 多轮 Agent 工作流
一次完整任务的执行记录:
指标 结果 LLM 调用 5 次 工具调用 6 次 工具重试 0 次 总耗时 413s 最终状态 PASS 这一结果说明模型能够驱动 Hermes 完成多轮工具链任务,但单次成功不能等同于长期 Agent 可靠性统计。
4. 视觉能力
启用视觉组件并设置
vision_mode=auto后:任务 结果 耗时 纯红图片识别 PASS — RGB 三色带识别 PASS 2.5s 双框技术示意图 PASS 5.31s
三、模型质量:标准题集实测
本次使用五套标准题集,共 3,711 道题,考察数学、知识、科学推理及代码生成能力。测试使用本地固定题集和自定义评分脚本。
1. 题集及特点
题集 测试重点 GSM8K 多步骤数学应用题 MMLU 多学科知识与理解能力 GPQA 高难度科学知识与推理 AIME 2025 竞赛级数学推理 HumanEval Python 代码生成与实际执行 2. 已完成成绩
题集 Hipfire 27B MQ4-XTS 说明 GSM8K 1283/1319,97.3% 完整评分 MMLU 1773/2000,88.7% 固定 2000 题子集 GPQA 158/194,81.4% 198 题中 4 题未评分 AIME 2025 26/30,86.7% 4 题截断 HumanEval 153/164,93.3% 修正执行评分,Off 测试方法说明:
- temperature = 0
- 原始输出上限 = 16,384 tokens
- GPQA/AIME 部分原始截断题选择性以 32,768 tokens 补测
- 历史全量运行缺少逐请求思考档位记录
- 使用本地题集及自定义评测脚本
因此,GPQA 和 AIME 表中的成绩含有混合输出预算,不应理解成全部题目在完全统一的 16K 上限下取得。
四、这个27B模型思考档位差别有多大?Off、Low、Medium
为了观察开启思考后的收益,又进行了两组独立测试。
1. 60 题综合推理专项
包括数学、知识、科学推理及部分代码生成题。五道代码生成题没有在这一组执行评分。
指标 Off Low Medium 正确/有效评分 42/55 49/54 50/54 正确率 76.4% 90.7% 92.6% 中位耗时 1.6s 17.8s 15.4s P90 耗时 97.8s 85.2s 99.0s 中位 completion tokens 71 372 439 Off 到 Low 提升明显,Low 到 Medium 的正确率差距较小。
2. HumanEval 164 题完整测试
同一套 164 道编程题分别使用 Off、Low、Medium 生成,并用修正后的同一评分器执行。
指标 Off Low Medium 通过数 153 156 157 Pass@1 93.3% 95.1% 95.7% 中位耗时 0.79s* 2.69s 3.04s P90 耗时 1.46s* 5.20s 6.67s 中位 completion tokens 151 527 633 请求错误 0 0 0 输出截断 0 0 0 Off 耗时来自服务恢复后保存完整计时记录的 143 题,正确率按完整 164 题统计。
逐题比较:
对比 前者独胜 后者独胜 同分 Off vs Low 4 7 153 Off vs Medium 3 7 154 Low vs Medium 1 2 161 Low 比 Off 多通过 3 题,Medium 比 Low 再多通过 1 题。
Medium 的中位 completion tokens 比 Low 增加约 20%,中位耗时增加约 13%。
对于这组编程题,Low 显示出比较好的质量与耗时平衡。但独立函数生成不能代替长期 Agent 工程任务测试。
总体来看,模型质量符合一款 27B、约 4-bit 量化模型的正常预期水平。Hipfire 更突出的优势仍然是释放了7900XTX单卡推理性能并提高了实际运行效率。
五、实际案例:让 Hipfire 27B 画图、编程,做游戏
标准题集之外,还让模型生成一些可以直接在浏览器中查看和运行的作品。
这些测试更直观,也能暴露单纯选择题不容易发现的问题。
可视化 Agent 实战总结
最后使用 Hermes Agent,让 Hipfire 27B 完成四类可视化编程任务:模拟时钟、鹈鹕骑自行车、贪吃蛇游戏和动态太阳系。
每项分别请求 Off、Low、Medium 三档,共进行 12 项独立测试。
项目 Off Low Medium 模拟时钟 PASS(修复后) PASS PASS 鹈鹕骑自行车 PASS(两轮修复) PASS(修复后) PASS(修复后) 贪吃蛇游戏 PASS PASS PASS 动态太阳系 PASS(8 行星) PASS(6 行星) PASS(8 行星) 最终 12/12 项通过,成功率 100%。
这些作品均由 Hermes Agent 使用文件工具生成,并在离线 Chromium 中进行结构、视觉或功能验收。贪吃蛇的增长、计分、碰撞及重启逻辑通过测试;动态太阳系的行星运动、暂停、继续和速度调节同样通过。
需要说明,测试发送了不同的思考档位请求,但未获得实际生效档位的充分证明,因此不依据这 12 项结果判断 Off、Low、Medium 的真实性能差异。
这组结果主要说明:Hipfire 27B 已能够驱动 Hermes 完成具有一定复杂度的可视化开发任务,包括生成文件、调用工具和自主修复。
1. 鹈鹕骑自行车:SVG 与 HTML 动画
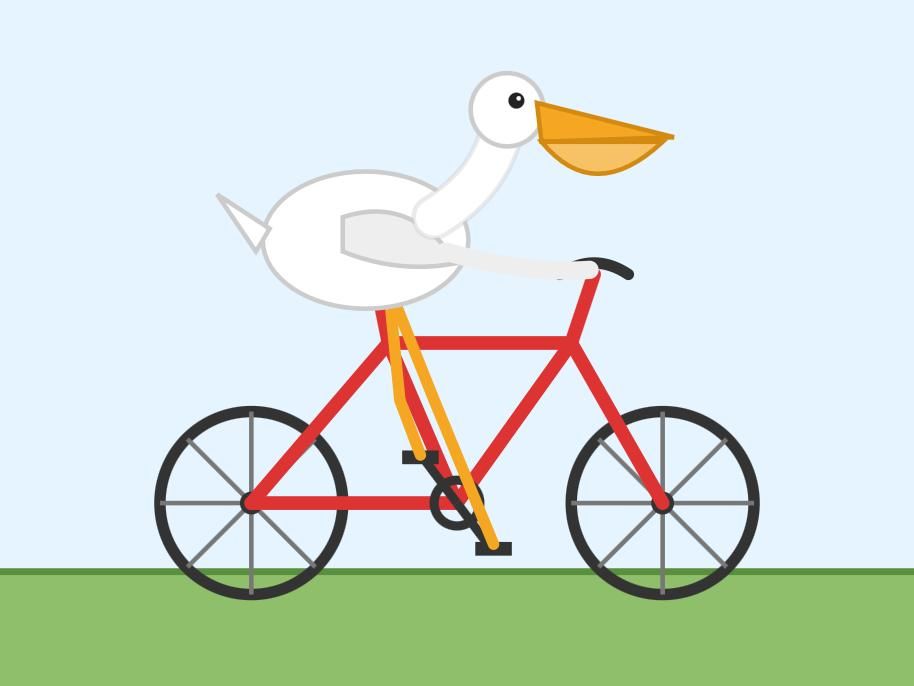
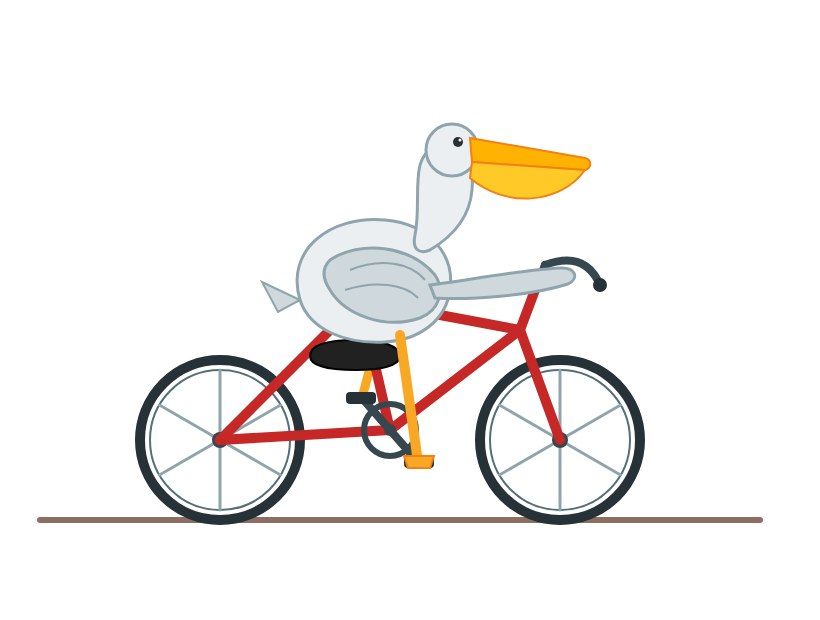
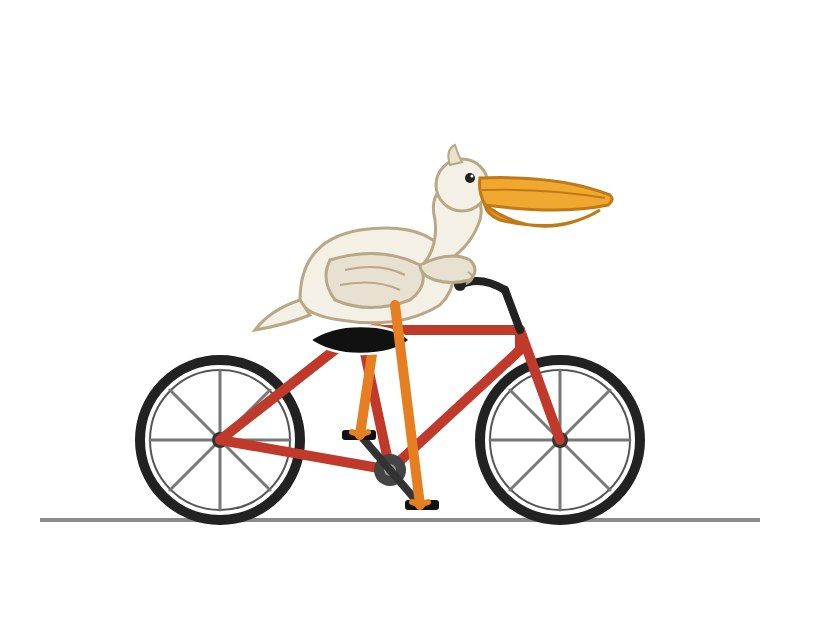
首先要求模型画一只骑自行车的鹈鹕。
静态 SVG 测试:
指标 Thinking Off Thinking Medium 生成耗时 13.65s 28.11s Completion tokens 2372 3942 文件大小 4617 B 4538 B 渲染 PASS PASS 两个版本都具备基本的鹈鹕与自行车结构。Medium 版本增加了更完整的车架、车座、双踏板与背景元素。
以下插图从上到下分别是 思考模式 off,low,medium
随后要求模型生成动态 HTML 页面。
指标 结果 生成耗时 44.98s Completion tokens 5578 HTML 大小 约 5.97 KB 外部依赖 无 SVG + JavaScript 是 Chromium 截帧 PASS 动画实现了车轮旋转、双腿踩踏板、车辆横向移动和鹈鹕身体轻微起伏。
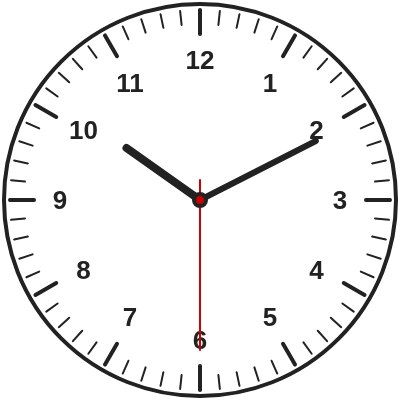
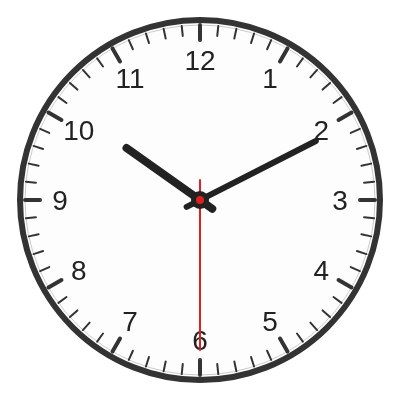
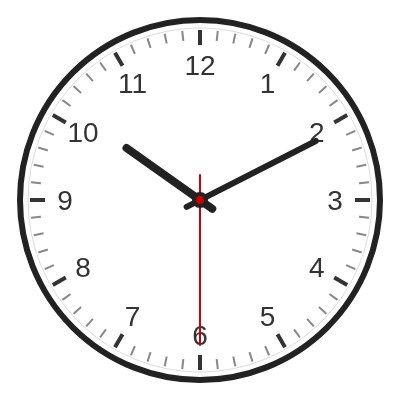
2. SVG 模拟时钟:10:10:30
让 Hermes Agent 生成一个带 12 个数字、60 个刻度以及时分秒三根指针的模拟时钟。
模型档位 最终结果 备注 27B Off PASS 修复后通过 27B Low PASS 144 秒,6 次文件工具调用 27B Medium PASS 结构和视觉检查通过 三个版本均已完成渲染验收。验收标准包括刻度数量、数字位置与指针角度。
3. 贪吃蛇:从代码到可玩的游戏
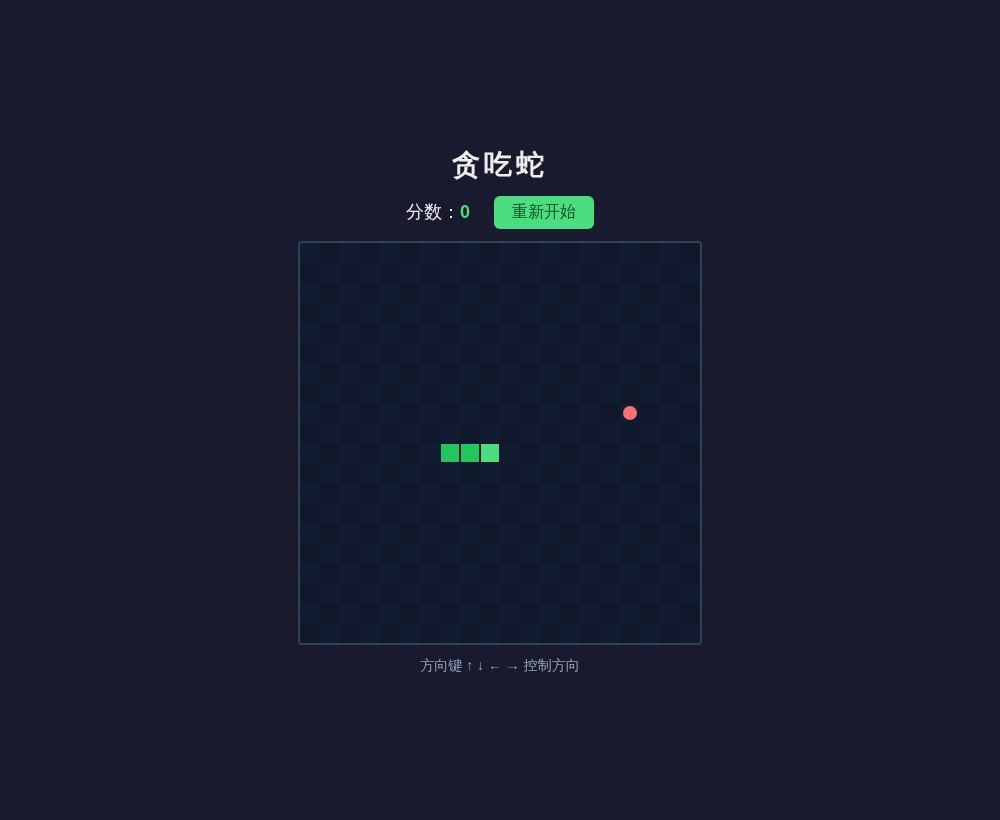
接下来是经典的 Snake 游戏。
要求生成单文件 HTML,支持方向键控制、随机食物、蛇身增长、得分、碰撞判断和重新开始。
指标 Off Low Medium 最终结果 PASS PASS PASS 总耗时 43s 125s 76.31s 工具调用 3 次 4 次 3 次 输出 tokens 3,784 4,012 7,609 离线 Chromium 验收确认两个版本的游戏逻辑能够运行。
测试为可重复验证碰撞与计分,采用手动推进游戏步进的方法,不作为真实连续帧率测试。
snake_27b_off.html
snake_27b_low.html4. 动态太阳系
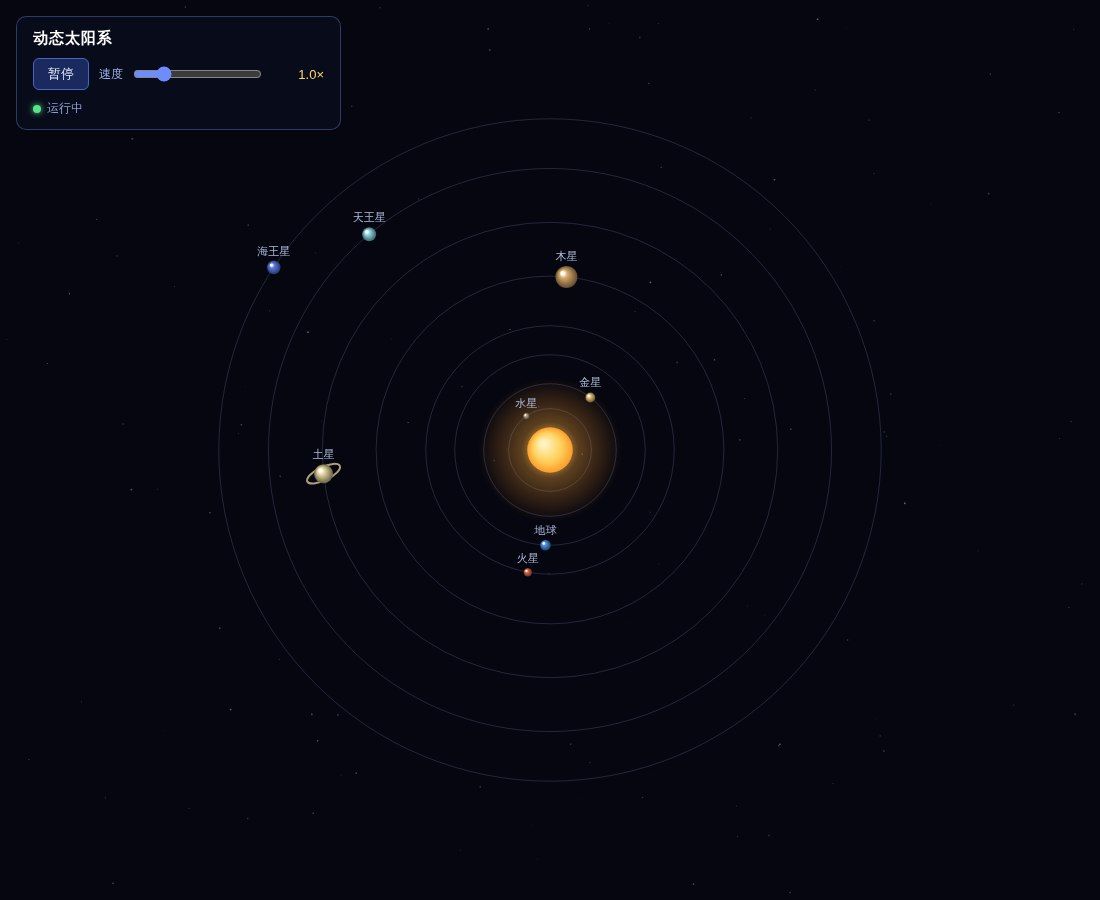
最后一项要求生成动态太阳系页面,包含多个行星、不同轨道半径与运动速度,以及暂停和速度调节功能。
27B_Off_Solar_System.html
27B_Low_Solar_System.html
27B_Medium_Solar_System.html注:搞笑啦,居然是思考off模式最好,图像好看,行星速度差值表现也靠谱的多。这道题上,开思考没带来更好的成品。
结语
从最初的 Prefill、Decode 性能测试,到生产环境部署、Hermes 工具调用、标准题集及实际编程作品,Hipfire 27B MQ4-XTS 在单张 RX 7900 XTX 上展现了相当完整的本地推理能力。
最有代表性的几个数字:
- 2682 t/s Prefill、169.4 t/s Decode:8K 上下文 DFlash 实测
- 160K:当前 Q8 KV 配置下的已验证长上下文长度 (据此我设的Hermes 192K 上下文, 75%压缩阈值。DSH则自用许多)
- 97.3% GSM8K、88.7% MMLU
- 93.3% / 95.1% / 95.7%:HumanEval Off / Low / Medium
- Hermes 工具调用、Coding/Debug、多轮任务和基础视觉均已通过验证
与此同时,长上下文显存边界、多并发能力、特定量化路径兼容性、服务异常及长期 Agent 稳定性仍存在明确的工程限制。
对 RX 7900 XTX 而言,Hipfire 的价值不只是某一个 Benchmark 数字,而是通过针对 gfx1100 的软件优化,让一张 24GB RDNA3 显卡在速度、模型质量和实际应用之间取得了新的平衡。
-
-
-
-
-
@6cccccc 兄弟DeepSeek Flash现在好用不贵,你完全可以试试用DeepSeek先驱动你的本地Agent跑图跑视频。我实际测下来,7900XTX的生图速度,大概是比4080S要慢20%~40%,大多数出图每张也就是慢几秒到十几秒的事儿;比R9700慢一点或者差不多。或者你切换着用,做几个一键启动卸载脚本,27B或者Strata FN(如果你内存够的话)和COMFYUI按需加载,PCI4X16加载和卸载模型也就是几秒的事儿。
Ben-Lee 说:
@6cccccc 兄弟DeepSeek Flash现在好用不贵,你完全可以试试用DeepSeek先驱动你的本地Agent跑图跑视频。我实际测下来,7900XTX的生图速度,大概是比4080S要慢20%~40%,大多数出图每张也就是慢几秒到十几秒的事儿;比R9700慢一点或者差不多。或者你切换着用,做几个一键启动卸载脚本,27B或者Strata FN(如果你内存够的话)和COMFYUI按需加载,PCI4X16加载和卸载模型也就是几秒的事儿。
我现在就在用DeepSeek Flash 新版本挺不错的,不过有时候还是想折腾一下本地的,之前deepseek有时候会出现不怎么稳定的情况,不知道咋回事。昨天试了一下27B的(用qoder),感觉视觉那块有点问题,不能在读取图片+调用工具。可能得分开用才行。


