
Qwen3.8-27B 长上下文实测:5060 Ti NInfer 对比 7900 XTX Vulkan / ROCm
-
Qwen3.8-27B 长上下文实测:5060 Ti NInfer 对比 7900 XTX Vulkan / ROCm
最近跑 Qwen3.8-27B,总觉得 5060 Ti 上的 NInfer 比 7900 XTX 上的 llama.cpp 更利索,尤其是一次塞入很长的上下文时。另一边,长对话又经常卡在输入阶段,最后报 300 秒超时。
于是拿同一份输入,把三套能在手头机器上运行的方案测了一遍,从 512 token 逐渐加到 32K、64K,再往 128K、160K、192K 走。
结果比较明确:这套 5060 Ti NInfer 在已测的 32K~160K 各档,冷输入都比 XTX Vulkan 快;160K 的等待从 506.2 秒缩短到 306.5 秒,减少约 39.4%。 不过短输入的生成速度,XTX Vulkan 仍然更高。AMD 的 NInfer 社区移植版在长输入下掉速很明显,64K 冷输入已经要 638.6 秒,后面就停了。
测试日期:2026-10-21。
测的三套配置
方案 权重 KV 缓存 输入分块 7900 XTX 24GB + llama.cpp Vulkan UD-Q4_K_S GGUF K/V 均为 q4_0 512 RTX 5060 Ti 16GB + NInfer v1.5 Q3/Q4/Q5 混合,约 3.953 BPW Q4 group64 1792 7900 XTX 24GB + NInfer ROCm 社区版 旧版 v2 Q4/Q5/Q6 混合,embedding/head 为 W8 INT8 1024 这里有个需要提前说明的差别:AMD 的社区移植版源自较旧的 NInfer v0.6.1,和 NVIDIA 上的 v1.5 不是同一版本。 三套权重和 KV 格式也不同,回答质量没有做对齐测试。因此这些结果比较的是手头实际能用的推理方案,不能把所有差距都算到显卡芯片头上,也不能据此认定同等回答质量下谁更快。
5060 Ti 测试时功耗上限为 180W,负载时 PCIe 链路为 3.0 ×4,使用 host embedding。三组测速统一使用 MTP-3。
怎么测的
三组喂入完全相同的整数 token ID,避免同样字数经过不同模板后变成不同 token 数。使用同一份 workflow 语料;超过原始 118001 token 的部分,将完整原序列重复后截取。这适合观察性能和容量,不用于证明长文本理解能力。
全部是单槽、单请求、greedy,关闭跨请求的前缀复用。这里的“冷输入”是指模型已加载,但这次输入没有命中前缀缓存,不包含模型从硬盘加载的时间。
基础档每档两轮,取算术均值。128K 起,NVIDIA 每档两轮,Vulkan 为节省长测时间每档一轮。基础的 512、32K、64K 档在输入处理后继续生成 512 token;118001 及以上继续生成 2048 token。首个输出统一计入输入处理阶段。
基础档统一总容量为 131072。128K 起按“输入 + 2049 个输出 token”向上取整到 4096 的倍数,作为当档总容量;同一档两套后端使用相同容量。文中的 1K = 1024 token;118001 单独列原始数值,约为 115.2K。
下表的冷输入时间是引擎 prefill 耗时。llama.cpp 另测了 HTTP 首字延迟,NInfer 用的是 bench 内部计时,所以不把两者说成完全相同口径的网络首字时间。
冷输入处理耗时
单位:秒,越低越好。
输入 token XTX Vulkan 5060 Ti NInfer XTX NInfer ROCm 512 0.80 0.50 1.26 32K 48.99 36.12 202.52 64K 123.70 84.35 638.60 118001 299.01 187.75 停止测试 128K 351.43 219.57 停止测试 160K 506.15 306.49 停止测试 192K 684.48 显存预留不足 停止测试 32K 时,5060 Ti NInfer 比 XTX Vulkan 少等约 26%;64K 少等约 32%;118001 token 时少等约 37%;160K 时少等约 39%。长输入下的差距,和我实际使用时的感觉基本一致。
AMD NInfer 的 64K 两轮分别是 632.4 秒、644.8 秒,平均 638.6 秒,已经超过十分钟。对我的交互用途来说,这个等待时间不合适,118001 及后面的档位就取消了。表里的“停止测试”不代表显存不足。
输入处理后的生成速度
单位:token/s,越高越好。
输入 token XTX Vulkan 5060 Ti NInfer XTX NInfer ROCm 512 67.54 55.95 49.63 32K 63.70 60.70 17.85 64K 57.10 62.55 11.70 118001 39.67 47.45 停止测试 128K 43.23 50.01 停止测试 160K 34.98 41.17 停止测试 192K 34.24 显存预留不足 停止测试 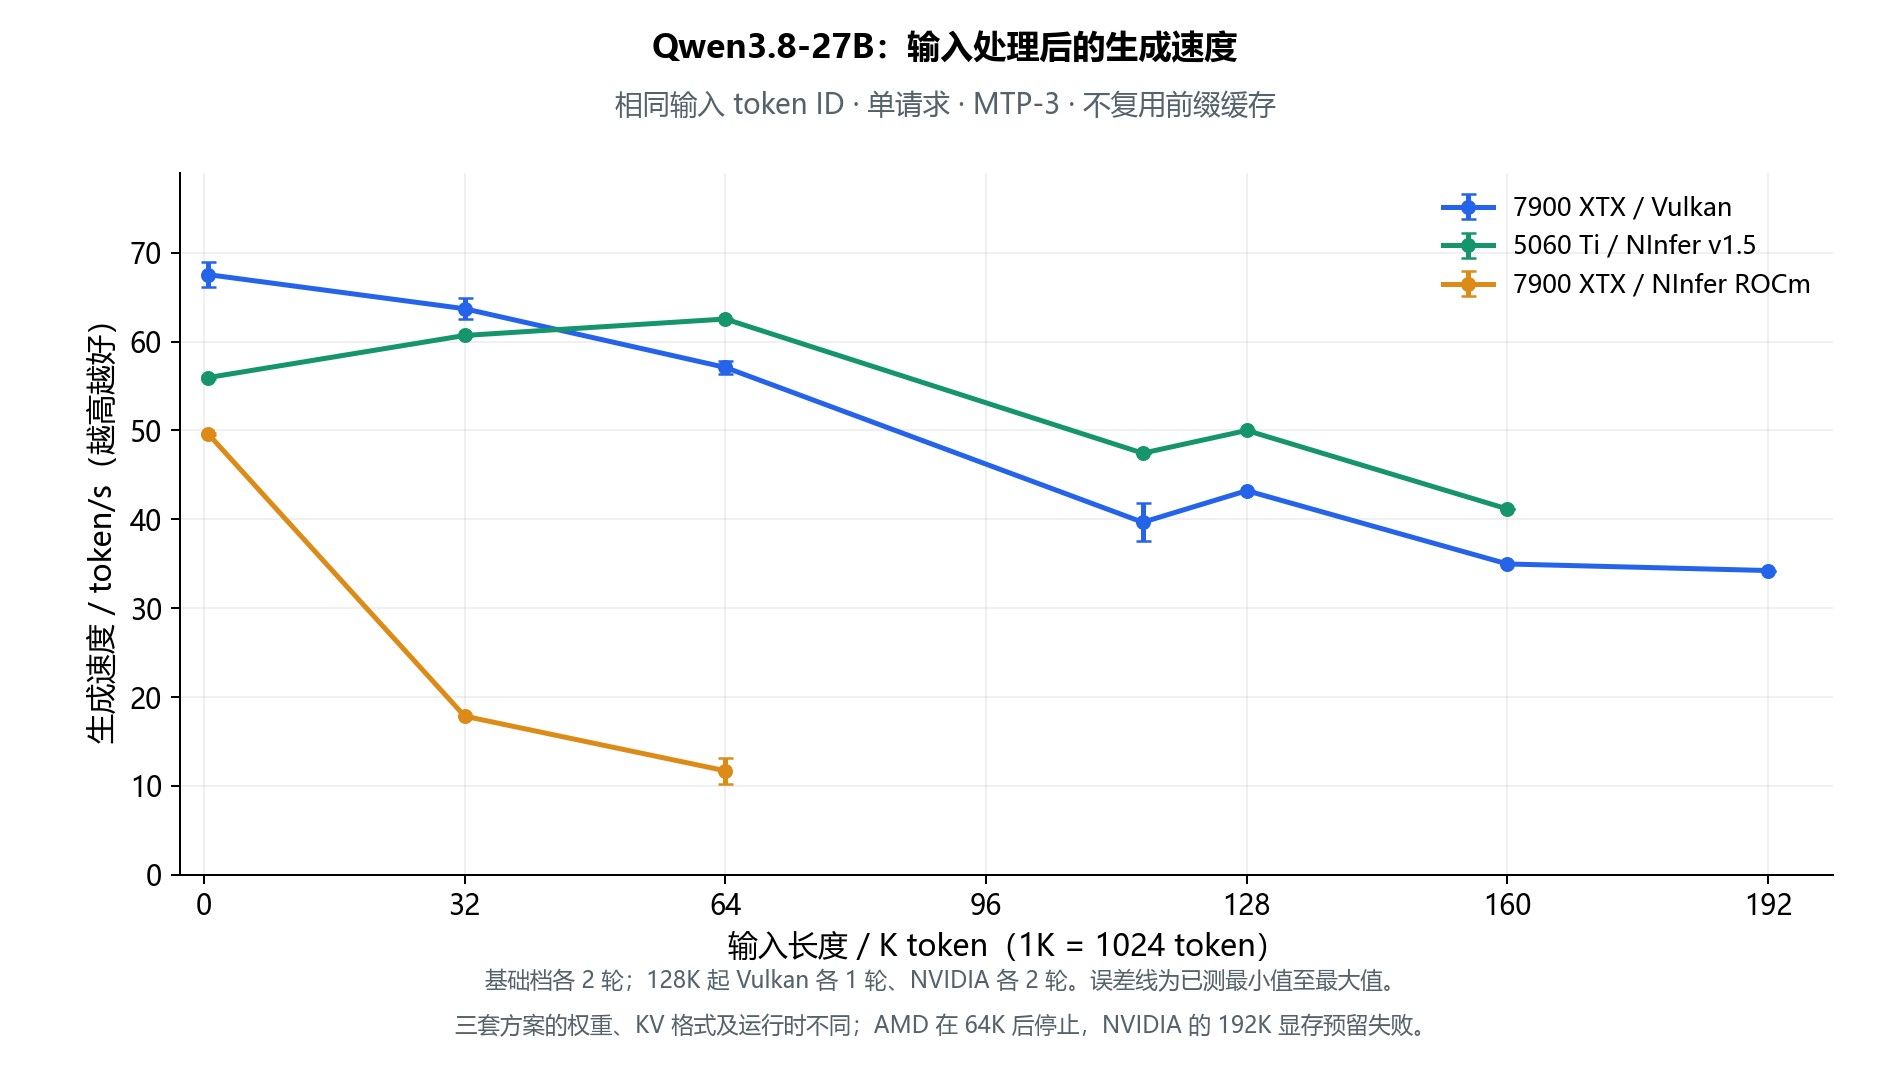
512 token 短输入时,XTX Vulkan 约 67.5 token/s,5060 Ti NInfer 约 56.0 token/s,XTX 更快。到 64K 及以上的已测共同档位,5060 Ti NInfer 的生成速度开始占优,160K 时约为 41.2 对 35.0 token/s。
所以只看短输入的生成 token/s,很容易忽略长上下文真正让人难受的那段等待:模型要先把整段输入处理完,才能开始正常输出。
192K 和 300 秒超时
5060 Ti NInfer 成功完成了 160K;192K 在运行时显存预留阶段失败,所需预留比可用空间多约 462 MiB。160K 是本次最大已验证档位,精确边界没有继续细分,不能把它当成所有配置下的硬上限。
XTX Vulkan 完整跑通了 192K,但冷输入用了 684.5 秒,约 11.4 分钟。后续扫描按冷输入达到 600 秒就不再加长的规则收口,这轮完成后便停止了,224K 没测。这里碰到的是我设定的实用性截止,并没有测到它的显存极限。
这也解释了之前调用端的 300 秒超时:XTX Vulkan 在 118001 token 时,两轮 HTTP 首字延迟已经达到 298.83 秒、299.23 秒。稍微增加输入、排队或其他开销,就可能超过 300 秒。5060 Ti 虽然更快,160K 冷输入也用了约 306.5 秒,同样跨过了这个等待上限。
我现在怎么用
XTX 上继续用 Vulkan,服务配置改为总容量 256K、双槽各 128K。每槽预留 8K 输出后,输入上限大约是 120K。这个数字表示装得下多少,不表示塞满后还能很快返回。
按这次冷输入成绩,XTX 的 64K 大约要两分钟,118001 token 接近五分钟。如果希望交互时少等一些,我会优先把冷输入控制在 64K 左右;日常对话如果命中前缀缓存,后续等待可能明显缩短,本次没有把缓存收益算进去。
双槽方便同时跑两个会话,不会自动加速同一条长请求;两会话同时繁忙时的速度,本次没有测。至于再加一张 7900 XTX 能提升多少,这轮也没有双卡实测,暂时不给翻倍之类的估计。
对我当前的用途,5060 Ti 上这套 NInfer 更适合长输入;XTX Vulkan 则保留了较好的短输入生成速度和更大的已验证输入容量。AMD 的这个旧版 NInfer 移植分支,现阶段我先不拿来跑长上下文。
复现信息和测试范围
- llama.cpp:
a8d9a7e1e55f5b613f297504d9e159807ec3a99b。 - NVIDIA NInfer:toddballinger/ninfer-5080,commit
e4edd6d5c5f9f7996de0f3d9f6c311e883452580。 - AMD NInfer:Jerry-Lee661/NInfer-AMD-ROCm,commit
bab0b0d3fa1034b63cc2171eb1cb0310315663ec,gfx1100,HIP 7.15 / clang 23。 - AMD 编译时补了测速目标需要的 profiler 兼容头和 HIP 链接设置;两种 NInfer 加了计时区间外的逐轮结果保存,计算内核均未修改。
- 原始语料 SHA256:
5b08da2c7b7ea5cafad2fab5699dccbcbce86040d8a37219b8c21f094d1d1eb7。 - 每档仅一到两轮;基础测试期间后台有受限 CPU 编译和模型下载,没有同一 GPU 的并行推理。结果用于本机方案选择,保留一定主机侧波动。
- 未测回答质量、双会话吞吐、双卡扩展,也未推断其他 ROCm 后端的表现。附件 CSV 为本次完成的 29 轮测量;图中连线用于阅读,不代表中间所有长度均已测试。
- llama.cpp:
-
Qwen3.8-27B 长上下文实测:5060 Ti NInfer 对比 7900 XTX Vulkan / ROCm
最近跑 Qwen3.8-27B,总觉得 5060 Ti 上的 NInfer 比 7900 XTX 上的 llama.cpp 更利索,尤其是一次塞入很长的上下文时。另一边,长对话又经常卡在输入阶段,最后报 300 秒超时。
于是拿同一份输入,把三套能在手头机器上运行的方案测了一遍,从 512 token 逐渐加到 32K、64K,再往 128K、160K、192K 走。
结果比较明确:这套 5060 Ti NInfer 在已测的 32K~160K 各档,冷输入都比 XTX Vulkan 快;160K 的等待从 506.2 秒缩短到 306.5 秒,减少约 39.4%。 不过短输入的生成速度,XTX Vulkan 仍然更高。AMD 的 NInfer 社区移植版在长输入下掉速很明显,64K 冷输入已经要 638.6 秒,后面就停了。
测试日期:2026-10-21。
测的三套配置
方案 权重 KV 缓存 输入分块 7900 XTX 24GB + llama.cpp Vulkan UD-Q4_K_S GGUF K/V 均为 q4_0 512 RTX 5060 Ti 16GB + NInfer v1.5 Q3/Q4/Q5 混合,约 3.953 BPW Q4 group64 1792 7900 XTX 24GB + NInfer ROCm 社区版 旧版 v2 Q4/Q5/Q6 混合,embedding/head 为 W8 INT8 1024 这里有个需要提前说明的差别:AMD 的社区移植版源自较旧的 NInfer v0.6.1,和 NVIDIA 上的 v1.5 不是同一版本。 三套权重和 KV 格式也不同,回答质量没有做对齐测试。因此这些结果比较的是手头实际能用的推理方案,不能把所有差距都算到显卡芯片头上,也不能据此认定同等回答质量下谁更快。
5060 Ti 测试时功耗上限为 180W,负载时 PCIe 链路为 3.0 ×4,使用 host embedding。三组测速统一使用 MTP-3。
怎么测的
三组喂入完全相同的整数 token ID,避免同样字数经过不同模板后变成不同 token 数。使用同一份 workflow 语料;超过原始 118001 token 的部分,将完整原序列重复后截取。这适合观察性能和容量,不用于证明长文本理解能力。
全部是单槽、单请求、greedy,关闭跨请求的前缀复用。这里的“冷输入”是指模型已加载,但这次输入没有命中前缀缓存,不包含模型从硬盘加载的时间。
基础档每档两轮,取算术均值。128K 起,NVIDIA 每档两轮,Vulkan 为节省长测时间每档一轮。基础的 512、32K、64K 档在输入处理后继续生成 512 token;118001 及以上继续生成 2048 token。首个输出统一计入输入处理阶段。
基础档统一总容量为 131072。128K 起按“输入 + 2049 个输出 token”向上取整到 4096 的倍数,作为当档总容量;同一档两套后端使用相同容量。文中的 1K = 1024 token;118001 单独列原始数值,约为 115.2K。
下表的冷输入时间是引擎 prefill 耗时。llama.cpp 另测了 HTTP 首字延迟,NInfer 用的是 bench 内部计时,所以不把两者说成完全相同口径的网络首字时间。
冷输入处理耗时
单位:秒,越低越好。
输入 token XTX Vulkan 5060 Ti NInfer XTX NInfer ROCm 512 0.80 0.50 1.26 32K 48.99 36.12 202.52 64K 123.70 84.35 638.60 118001 299.01 187.75 停止测试 128K 351.43 219.57 停止测试 160K 506.15 306.49 停止测试 192K 684.48 显存预留不足 停止测试 32K 时,5060 Ti NInfer 比 XTX Vulkan 少等约 26%;64K 少等约 32%;118001 token 时少等约 37%;160K 时少等约 39%。长输入下的差距,和我实际使用时的感觉基本一致。
AMD NInfer 的 64K 两轮分别是 632.4 秒、644.8 秒,平均 638.6 秒,已经超过十分钟。对我的交互用途来说,这个等待时间不合适,118001 及后面的档位就取消了。表里的“停止测试”不代表显存不足。
输入处理后的生成速度
单位:token/s,越高越好。
输入 token XTX Vulkan 5060 Ti NInfer XTX NInfer ROCm 512 67.54 55.95 49.63 32K 63.70 60.70 17.85 64K 57.10 62.55 11.70 118001 39.67 47.45 停止测试 128K 43.23 50.01 停止测试 160K 34.98 41.17 停止测试 192K 34.24 显存预留不足 停止测试 512 token 短输入时,XTX Vulkan 约 67.5 token/s,5060 Ti NInfer 约 56.0 token/s,XTX 更快。到 64K 及以上的已测共同档位,5060 Ti NInfer 的生成速度开始占优,160K 时约为 41.2 对 35.0 token/s。
所以只看短输入的生成 token/s,很容易忽略长上下文真正让人难受的那段等待:模型要先把整段输入处理完,才能开始正常输出。
192K 和 300 秒超时
5060 Ti NInfer 成功完成了 160K;192K 在运行时显存预留阶段失败,所需预留比可用空间多约 462 MiB。160K 是本次最大已验证档位,精确边界没有继续细分,不能把它当成所有配置下的硬上限。
XTX Vulkan 完整跑通了 192K,但冷输入用了 684.5 秒,约 11.4 分钟。后续扫描按冷输入达到 600 秒就不再加长的规则收口,这轮完成后便停止了,224K 没测。这里碰到的是我设定的实用性截止,并没有测到它的显存极限。
这也解释了之前调用端的 300 秒超时:XTX Vulkan 在 118001 token 时,两轮 HTTP 首字延迟已经达到 298.83 秒、299.23 秒。稍微增加输入、排队或其他开销,就可能超过 300 秒。5060 Ti 虽然更快,160K 冷输入也用了约 306.5 秒,同样跨过了这个等待上限。
我现在怎么用
XTX 上继续用 Vulkan,服务配置改为总容量 256K、双槽各 128K。每槽预留 8K 输出后,输入上限大约是 120K。这个数字表示装得下多少,不表示塞满后还能很快返回。
按这次冷输入成绩,XTX 的 64K 大约要两分钟,118001 token 接近五分钟。如果希望交互时少等一些,我会优先把冷输入控制在 64K 左右;日常对话如果命中前缀缓存,后续等待可能明显缩短,本次没有把缓存收益算进去。
双槽方便同时跑两个会话,不会自动加速同一条长请求;两会话同时繁忙时的速度,本次没有测。至于再加一张 7900 XTX 能提升多少,这轮也没有双卡实测,暂时不给翻倍之类的估计。
对我当前的用途,5060 Ti 上这套 NInfer 更适合长输入;XTX Vulkan 则保留了较好的短输入生成速度和更大的已验证输入容量。AMD 的这个旧版 NInfer 移植分支,现阶段我先不拿来跑长上下文。
复现信息和测试范围
- llama.cpp:
a8d9a7e1e55f5b613f297504d9e159807ec3a99b。 - NVIDIA NInfer:toddballinger/ninfer-5080,commit
e4edd6d5c5f9f7996de0f3d9f6c311e883452580。 - AMD NInfer:Jerry-Lee661/NInfer-AMD-ROCm,commit
bab0b0d3fa1034b63cc2171eb1cb0310315663ec,gfx1100,HIP 7.15 / clang 23。 - AMD 编译时补了测速目标需要的 profiler 兼容头和 HIP 链接设置;两种 NInfer 加了计时区间外的逐轮结果保存,计算内核均未修改。
- 原始语料 SHA256:
5b08da2c7b7ea5cafad2fab5699dccbcbce86040d8a37219b8c21f094d1d1eb7。 - 每档仅一到两轮;基础测试期间后台有受限 CPU 编译和模型下载,没有同一 GPU 的并行推理。结果用于本机方案选择,保留一定主机侧波动。
- 未测回答质量、双会话吞吐、双卡扩展,也未推断其他 ROCm 后端的表现。附件 CSV 为本次完成的 29 轮测量;图中连线用于阅读,不代表中间所有长度均已测试。
- llama.cpp:
-
-
这组数据的价值在「同一输入、同一容量」控制得比较干净,但结论要限定在「手头这三套方案」,不是 5060 Ti 对 7900 XTX 的芯片对比:NInfer v1.5 和 AMD 社区版 v0.6.1 差了一代,权重与 KV 格式也不同(3.953 BPW vs Q4_K_S,KV q4_0 vs Q4 group64),预填差距里多少来自内核、多少来自量化,这份测试分不开。
长上下文真正卡的是 prefill 的算力与带宽,不是 tg。5060 Ti 在 32K 以上反超,主要是 NInfer 的 chunked prefill 和 attention 内核更适配长序列;XTX Vulkan 到 160K 已经 506 秒,按 600 秒收口是合理的。
几个可落地的调整:
- 300 秒是调用端超时,不是模型上限。把客户端读超时提到 600 秒,或先返回任务号再轮询,比换卡便宜。
- XTX 上先调大 ubatch/batch,并确认 flash attention 已开;Vulkan 后端对长 prefill 的 kernel 选择比 CUDA 粗,ubatch 太小会把 prefill 拆得过碎。
- 192K 差 462 MiB 是 KV 预留,不是权重;把单槽容量从 256K 降到 224K 或 192K,或把 KV 换 q8_0/q5_1,能把这部分让出来。
- 前缀缓存对 agent 和多轮场景的收益,通常比 prefill 再快 10% 更大;建议把缓存命中率也记进表里。
你现在 XTX 256K 双槽、每槽 128K、输入上限 120K 是容量优先的配置;交互场景把冷输入压在 64K 左右,和你的体感一致。
-
我就是这个 ROCm 项目的移植者,这个移植基本上要放弃了。涉及内核层的地方 AMD 水太深,不如试试 hipfire。
这个构筑跑 Bonsai2 NInfer v2 的无投机解码也不到 60-70 token/s。补充一下你测到的长上下文掉速:这版移植的 attention 是 SIMT 逐 key 环,没有 flash-attention 分块,长上下文下 prefill 和生成会随 key 数近似线性退化。这是结构短板,项目已经暂停,不会再修了。
口径说明:上面 60-70 是 Bonsai2 PQ2 工件(2.13 bit)的无投机数字;你测的 AMD 列是官方 v2 工件(Q4/Q5/Q6,20 GB),权重和量化不同,不能直接对表。官方 v2 工件在这版移植上我们只做过短测,nospec 约 34 token/s,长上下文同样受 attention 结构限制。
最新单卡实测(greedy、int8 KV;NInfer 数字取 10 对交错或 3 跑中位,PQ2 工件):
口径(单卡) t/s 相对主门 103.8 3080Ti 契约(主门来源, serve MTP d2 中文) 103.8 100% 7900XTX 已知最强: PrismML serve ngram 60.69 58.5% 7900XTX llama.cpp 本传(27B 级) 41.7 40.2% NInfer@7900XTX CLI nospec (int8 KV) 65.2 62.8% NInfer@7900XTX CLI MTP d2 (验收 1.81) 45.6 43.9% NInfer@7900XTX serve nospec 57.9 55.8% NInfer@7900XTX serve MTP d2 (验收约 1.77) 40.2 38.7% 几点口径说明:
- 主门 103.8 来自 3080Ti 的 serve MTP d2 中文,跨卡跨工件,只当标尺用。
- 同为 7900XTX,hipfire 官方数据 AR 51.63 / MTP 87.52 / DFlash 131.69,但它是 4.458 bpw 工件,我们这套是 2.13 bit 的 PQ2,不是同质量口径,仅供参考。
- 你测的 64K 638.6 秒、生成 11.7 t/s,和上面的长上下文短板描述一致。



