-
-
我发觉这张主板是 PCIe x16 slots with Gen4。。。
@imbiplaza-ASUS 哥,這前兩年掛天堂m買的,,,,禿然就派上用場了 XD
-
@CHIA-AN-YANG 请教一下7900XTX Strata Qwen3.8 Flash Next IQ3_S 你这边的思考模式是怎么设置的。我这边但凡开了思考,哪怕是low都是雷霆大思考,时间花的别27B的低思考模式还长
-
@CHIA-AN-YANG 请教一下7900XTX Strata Qwen3.8 Flash Next IQ3_S 你这边的思考模式是怎么设置的。我这边但凡开了思考,哪怕是low都是雷霆大思考,时间花的别27B的低思考模式还长
@Ben-Lee ## 這是我當初的問題與後來改善的情況
一開始在雙 RTX 3060 上用 Strata 跑 Qwen3.8 Flash Next 時,長任務會反覆呼叫 read_file、search_files、terminal,忽略已成功的工具結果,最後卡到 Hermes 的迭代或護欄上限。短問答和單次工具測試正常,所以當時一度誤以為已經修好。
後來查到不是顯卡數量或單一思考開關造成,而是幾個因素疊在一起:
- Sampling 沒設好,Strata 落到 greedy。 10/08 交接記錄,當時設定缺少 sampling,Strata 用了 temperature=0。加上明確的 sampling 後,簡單的單次 terminal 測試能正常結束;但後續長任務仍會循環,這一步沒有單獨根治問題。10/08 handoff (handoffs/2026-10-08_handoff.md:38)
- 工具結果在模板裡被標成 user。 Hermes 傳回 role=tool 的結果,Qwen 模板卻把它序列化成新的使用者訊息。10/09 用同一個 prompt、維持 none 思考設定做對照,修模板前工具呼叫 7 次、重跑同一命令 4 次;改為保留 tool 角色後降到 3 次。這是當時最直接支持「模板格式會誘發重跑」的對照證據。10/09 handoff (handoffs/2026-10-09_handoff.md:31) · 原始 Codex 對話 (/home/jaran/.codex/sessions/2026/10/09/rollout-2026-10-09T14-04-28-01a11f43-51e9-7500-9072-125d98605bed.jsonl)
- 思考設定也改過,但不是確定的單一解法。 曾為了不讓 Telegram 顯示推理內容設 none,之後改測 low,再改為 medium,並調整 reasoning 回傳、預算和復原設定。受控小任務有成功,但改成 low 或 medium 都沒有證明能解決所有長任務。
而且模板修正後,實際 Telegram 長任務仍有失敗紀錄;10/10 又看到任務中有舊路徑、重複搜尋和背景 review 等問題。後來再整理路由與 Skill、停用背景 review、調整 sampling、reasoning 和錯誤熔斷,加上切換到 7900 XTX、新模型與新 session,才逐步變得正常。現有紀錄沒有一組嚴格前後對照能指出「最後就是某一項單獨修好」。
所以最穩妥的回顧是:雙 3060 當時確實遇到 Strata/Qwen 長任務工具循環;sampling 和 role=tool 模板修正都有證據改善行為,後續還配合 reasoning、Hermes 設定和路由整理。問題後來不再明顯,但無法從舊紀錄證明單一根因或唯一的最後修復。10/10 handoff (handoffs/2026-10-10_handoff.md:188) · 10/11 handoff (handoffs/2026-10-11_handoff.md:17)
又補查了一輪
我最早在雙 RTX 3060 上跑 Strata IQ3_S,當時有一筆約 107K context 的工具呼叫成功;明確的工具循環問題,是後來換跑 uncensored IQ4_XS 時才記錄到。模型會忽略成功的工具結果,重複讀檔、搜尋或執行命令。
排查中發現幾項可能因素:早期 sampling 曾缺失而落到 greedy;Qwen 模板曾把工具結果 role=tool 錯標成 user;Hermes 的 reasoning、路由、背景 review 和工具失敗處理也經過多輪調整。修正工具角色後,同一個受控任務的重複呼叫由 7 次降到 3 次;但當時真實長任務仍有失敗紀錄。
後來我實際使用時沒有再遇到死循環,但當時同時換過模型、顯卡與多項設定,沒有單變因 A/B,因此不能確定是哪一項讓問題消失。uncensored IQ4_XS 可能是因素之一,不能當成已證實的根因。
目前是 RX 7900 XTX 24GB、128GB RAM,Strata 0.1.45/ROCm 10.0,模型為 GSQ-RCO abliterated IQ3_S,262K context、單卡 HIP。Strata sampling 設為 temperature=0.6, top_p=0.95, top_k=20, min_p=0, repetition_penalty=1.0, presence_penalty=0;reasoning budget 8192、reasoning_loop_recovery=recover。Hermes Agent 的 reasoning effort 設為 medium,目前模板保留工具結果的 role=tool。
再補一個重要區別:目前這台跑的仍是 abliterated IQ3_S,不是官方原版模型;所以即使最近沒再遇到循環,也不能據此認定「只要換官方版就能修好」。
-
-
,
 T terry 将此主题从 AI Agent 移至此处
-
感覺系統記憶體頻寬影響prefill速度很大,
我目前也是用7900XTX;差別是平台是5900X+X570,
只有DDR4 雙通道.目前用的是DDR4 3600 128G,
頻寬測試結果如下:
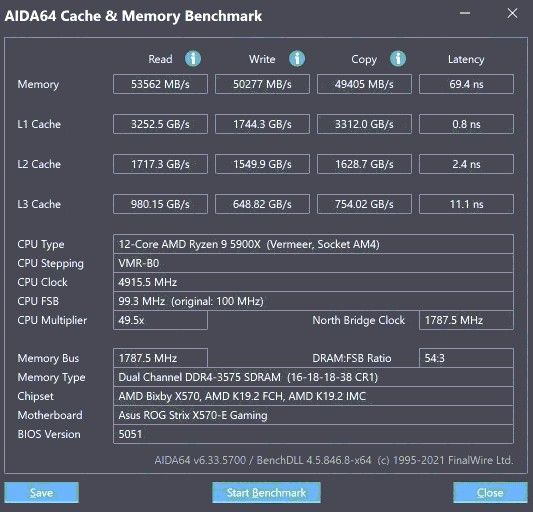
prefill速度觀察opencode長任務過程,
最高大概就900出頭破不了千,
使用的模型 / 設定皆與本篇相同;
僅因開啟視覺支援後常常發生non-finite logits (#879)錯誤,
故將MTP spec調整至2降低發生機率.昨天將版本升級至0.1.45.3後還沒發生non-finite logits (#879)錯誤,
有考慮把MTP spec調回4試試. -
昨晚又讓agent優化 7900XTX 提速度70+ tok/s
Strata 0.1.45 / GSQ-RCO IQ3_S 速度優化:完整過程與證據
- 日期:2026-10-22(台北時間)
- 服務:
gsq-rco-qwen3.8-flash-next-iq3_s,Strata 0.1.45,AMD RX 7900 XTX / gfx1100 - 結論:正式設定從
--pool-workers 15改為37。同一組約99K fresh prompt 配對測試,15 workers 中位 67.3 tok/s;37 workers 中位 75.2 tok/s,提升 11.7%。正式服務重啟後重跑同一組 prompt,37 workers 中位 74.6 tok/s,相較同一控制中位提升 10.8%。正式設定下另有短 prompt smoke 81.2 tok/s。
1. 為什麼原本速度沒起來
社群 #2938 的速度設定採
--pool-workers 15,測試 CPU 是 Ryzen 9 9950X、16 核 / 32 執行緒。本機是 38 個實體核心 / 76 執行緒的 Xeon Ice Lake-SP;照抄15 workers,使 CPU 專家計算池沒有用滿。本機原版與社群在其他主要參數、模型和 GPU 類型上相近,但 CPU 核心數不同,因此 worker 數需要按本機重新測。來源:Strata #2938。A/B 中把其他模型與引擎參數固定,只改
--pool-workers;同一 99K prompt 的 MTP draft 數也相同或接近,37 workers 的 decode 毫秒仍較短。這是本輪速度差距的直接證據,不是只依賴規格推論。2. 測試環境與固定設定
- Model ID:
gsq-rco-qwen3.8-flash-next-iq3_s;同一份本機 GSQ-RCO IQ3_S pack、兩片 GGUF、expert profile 與 MTP runtime。 - Strata:
v0.1.45/ commit477ac13cbe8e582c20484871ce459d20d82df09d;HIP gfx1100 binary SHA-256:1b31f33cd9cb393e0db85381b396b9179ad51936131d9a8cea1e4d1b3188a57e。 - 固定參數:expert-cache 7700(實際9048 slots / 17.16 GiB)、
pcie-frac 0、prefillauto:32768、spec4 / min-p0.5、MTP、262144 context、KVk8v4/ resident32768、pool其他設定與 vision 不變。hipBLASLt table 48 rows / gfx1100 / 100401。 - 池寬測試前已移除與 #2938 不同的
--mmap-experts、--resident-cpu-experts以及--mtp-window 65536覆寫;最後用 v0.1.45 預設 MTP window32768。STRATA_PREFILL_RING=96、STRATA_IO_THREADS=32保留。 - 15與37設定 diff 只有
--pool-workers一行;見 configuration.diff。前後 JSON、原始 engine logs、執行器 probe 與 hashes 都在本資料夾。
3. 可重現的 benchmark 方法
正式比較採相同 prompt 文字和 tag 次序
vw / xj / kq,兩邊都 fresh prompt、cached/reused tokens 為0;每筆輸出256 tokens。API sampling:temperature0、top-k1、top-p1、min-p0、seed42、reasoning_effort none。輸入是同一段英文段落重複2020次,實際 token 數為99,004 / 99,005 / 99,005;完整產生方法在 99k-probe.py。主要計時直接取 Strata engine log 的
read in ms、generated in ms行;decode tok/s = generated tokens / decode seconds。每筆也記錄 drafts accepted/offered 和 expert-cache hit rate。原始行及 line number 見 matched-engine-excerpts.txt,完整 log snapshot 見 pool15-engine.log、pool37-engine.log 和 active-final-engine.log。4. 同一 99K prompt 的配對 A/B
Tag 實際 prompt tokens 15 workers decode 15 MTP accepted 37 workers decode 37 MTP accepted 配對提升 vw 99,004 57.6 132 / 223 65.3 132 / 223 +13.4% xj 99,005 67.3 152 / 214 75.2 152 / 214 +11.7% kq 99,005 70.1 158 / 201 77.9 160 / 220 +11.1% 中位數 — 67.3 — 75.2 — +11.7% 同組 prefill 中位數為15 workers 1714.7 tok/s、37 workers 1712.4 tok/s,幾乎相同;變化集中在 decode。前兩個 tag 的 MTP accepted/offered 完全相同,速度仍快約12%;第三組接受率接近,37 workers 仍快11.1%。這把主要改善指向 CPU 專家池的處理速度。
正式重啟後重複 A 組
正式服務以37 workers重新載入,再用相同三個 prompt 重跑一次:64.6 / 74.6 / 77.4 tok/s,中位 74.6;MTP acceptance 仍隨 prompt 變化。相較相同控制組67.3,中位提升 10.8%。三個 paired gain 為 +12.2% / +10.8% / +10.4%。正式重跑 engine 行在 active-final-engine.log 的2148、2161、2170行,控制組在 pool15-engine.log 的1896、1906、1915行。
短 prompt 同樣支持 worker 數改善:15 workers
67.5 / 68.7 / 66.5(中位67.5);24 workers75.5 / 75.6 / 74.7(中位75.5);37 workers78.7 / 78.8 / 78.0(中位78.7)。正式設定最後一筆短測為81.2 tok/s,原始行在 active log 第1997行。逐筆數值與 acceptance 在 matched excerpts 和完整 logs 可核對。5. 試過但沒有保留的設定
37 workers 下試
--pcie-frac 0.10:短 prompt 中位81.4 tok/s,高於 PCIe0 短測78.7;但99K三筆是52.9 / 75.8 / 80.9,中位75.8,對 PCIe0 的75.2沒有穩定的長上下文收益,且波動更大,所以正式設定仍用pcie-frac 0。相關 config 和原始 log 保存在 pool37-pcie010-config.json 與 pool37-pcie010-engine.log。6. 正式設定與服務讀回
正式檔案 正式設定檔 現設
--pool-workers 37。修改前設定備份:pool15-config.json,正式檔案 SHA-256 與 backup SHA-256 記在 SHA256SUMS.txt;設定 diff 只有15→37。正式啟動器重啟後 API 讀回:health
loaded=true,版本0.1.45,model ID 正確,37 workers、PCIe0、context262144、KV k8v4 / resident32768、expert slots9048,最終 live state idle / queue0。完整唯讀快照在 final-runtime-readback.json。7. 限制與操作紀錄
- 輸出速度仍會隨 MTP acceptance 波動;正式37-worker 99K重跑範圍64.6–77.4 tok/s,所以這是中位提速,不代表每一個生成都固定超過70。
- 社群 issue 沒公布可逐字重放的整段 prompt;本輪固定自製重複英文 prompt,池寬兩臂完全相同,適合做配對比較,但不等於逐字複製社群 prompt。
- 未測工具任務品質或長時間 soak;本證據只證明同一 engine 的 decode throughput 有提升。
- 一次切換時,我的 idle guard 與停止命令曾因 shell 錯誤串接而中斷一筆正在進行中的請求。該請求不在 benchmark 統計中;服務隨即恢復,之後都用連續 idle / queue0 guard 切換。這次操作錯誤已寫入今日 handoff。
8. 證據清單
- 15 workers 原始引擎紀錄、24 workers 原始紀錄、37 workers A/B 原始紀錄、37 workers + PCIe0.10 原始紀錄、正式服務最後重跑紀錄
- matched engine excerpts(含來源行號)、配對結果 CSV、正式 API 讀回
- 15 workers 原設定、37 workers 正式設定、設定差異、SHA-256 manifest
- short prompt probe、99K prompt probe
9. 原始 Codex session 與速度提升歸因
- 本輪調速原始對話:
rollout-2026-10-22T08-39-50-01a1610c-c932-7b93-bec6-3b230939d093.jsonl。本機舊測在 0.1.45、15 workers 下約 98K decode 中位數只有 59.3 tok/s;隨後查到本機是 38 核 Xeon,而抄用的社群配置為 15 workers、Ryzen 16 核。 - 本次實際提速變更是把唯一的
--pool-workers參數由 15 改為 37;configuration.diff顯示除此以外設定相同。15→24→37 workers 逐級對照後,37 workers 的短 prompt 中位數 78.7 tok/s,99K 長 prompt 配對中位數 75.2 tok/s。PCIe 0.10 方案未保留。 - 正式重啟後再次用相同 99K prompt/tag 測得 64.6 / 74.6 / 77.4 tok/s,中位數 74.6;15-worker 控制組中位數 67.3,配對提升約 10.8%。因此「70 多」是多筆測試的中位數附近,不是每次固定值;正式重跑最低一筆為 64.6 tok/s。
- 這項 A/B 證明的是本機合成 decode workload 下增加 CPU expert-pool workers 有可重現的速度改善,不代表 Hermes 工具任務、品質或長時間穩定性提升。測試 prompt 非社群逐字原文,且這輪沒有工具任務/soak 測試。逐筆原始行、CSV、config diff 與 SHA-256 manifest 均保留在本資料夾。
-
感覺系統記憶體頻寬影響prefill速度很大,
我目前也是用7900XTX;差別是平台是5900X+X570,
只有DDR4 雙通道.目前用的是DDR4 3600 128G,
頻寬測試結果如下:
prefill速度觀察opencode長任務過程,
最高大概就900出頭破不了千,
使用的模型 / 設定皆與本篇相同;
僅因開啟視覺支援後常常發生non-finite logits (#879)錯誤,
故將MTP spec調整至2降低發生機率.昨天將版本升級至0.1.45.3後還沒發生non-finite logits (#879)錯誤,
有考慮把MTP spec調回4試試. -
Strata IQ3_S 速度優化前後與原始 Log
日期:2026-10-22(台北時間)
本文件把優化前、逐步調整、負對照和正式重跑的原始 Strata engine log 摘錄合併在同一份 Markdown。以下 log 行保留原文、來源檔名與原始行號,可直接複製到貼文,不依賴本機檔案連結。結論
這次把速度推到 70 多 tok/s 的主要有效改動是
--pool-workers從 15 增至 37。本機是 Xeon 38 核 / 76 執行緒;原先照用社群 16 核主機的 15 workers,沒有充分使用本機 CPU expert pool。測試 15 workers 24 workers 37 workers 結果 短 prompt,1494 tokens、512 輸出,中位數 67.5 tok/s 75.5 tok/s 78.7 tok/s 37 比 15 快約 16.6% 同一組約 99K prompt、256 輸出,中位數 67.3 tok/s 未測長 prompt 75.2 tok/s 配對提升約 11.7% 正式重啟後同組 99K prompt,中位數 控制組 67.3 tok/s — 74.6 tok/s 重跑仍快約 10.8% 正式服務短 prompt smoke — — 81.2 tok/s 單次 smoke,不當作中位數 測試條件
- 同一模型:GSQ-RCO abliterated IQ3_S,model ID
gsq-rco-qwen3.8-flash-next-iq3_s。 - 同一引擎:Strata 0.1.45、HIP gfx1100、RX 7900 XTX。
- 15/24/37 workers 配對測試中,唯一設定差異是
--pool-workers;configuration.diff的原文如下:
--- pool15-config.json +++ pool37-config.json @@ -14,7 +14,7 @@ "--pcie-frac", "0.0", "--pool-workers", - "15", + "37", "--prefill", "auto:32768", "--spec",- 長 prompt 每次實際輸入 99,004–99,005 tokens,輸出上限 256 tokens,
cache reuse=0。短 prompt 使用 1494-token fresh prompt,輸出上限 512 tokens。 - benchmark 的 API sampling 固定為 temperature 0、top-k 1、top-p 1、min-p 0、seed 42、
reasoning_effort=none;這是速度測試條件,不是 Hermes Agent 的日常 reasoning 設定。 - Prefill 在各組約 1,712–1,735 tok/s,變動很小;提升主要出現在 decode。
原始 Strata Log:15 workers 優化前
來源
pool15-engine.log。啟動行顯示 15 workers;三筆相同 99K prompt 的 decode 為 57.6、67.3、70.1 tok/s,中位數 67.3。pool15-engine.log:1835 [strata] 2026-10-22 00:53:00 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 15 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision pool15-engine.log:1853 strata generate: 15 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15, the host thread on 0 (draining too) (--host-core first) pool15-engine.log:1862 strata generate: 15 expert-pool workers + the host thread pool15-engine.log:1896 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57473 ms (1722.6 tok/s), 256 generated in 4445 ms (57.6 tok/s), drafts accepted 132 of 223, 4 checkpoints pool15-engine.log:1897 strata serve: decode expert cache hit rate: 78.1% (130028 hits / 166560 lookups) pool15-engine.log:1906 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57737 ms (1714.7 tok/s), 256 generated in 3806 ms (67.3 tok/s), drafts accepted 152 of 214, 4 checkpoints pool15-engine.log:1907 strata serve: decode expert cache hit rate: 79.6% (121464 hits / 152640 lookups) pool15-engine.log:1915 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57815 ms (1712.4 tok/s), 256 generated in 3652 ms (70.1 tok/s), drafts accepted 158 of 201, 4 checkpoints pool15-engine.log:1916 strata serve: decode expert cache hit rate: 80.2% (115908 hits / 144480 lookups)15-worker short prompt control 的三筆原始輸出:
pool15-engine.log:1780 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1925 ms (776.1 tok/s), 512 generated in 7587 ms (67.5 tok/s), drafts accepted 312 of 454, 1 checkpoints
pool15-engine.log:1795 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1936 ms (771.6 tok/s), 512 generated in 7450 ms (68.7 tok/s), drafts accepted 313 of 455, 1 checkpoints
pool15-engine.log:1800 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1934 ms (772.4 tok/s), 512 generated in 7702 ms (66.5 tok/s), drafts accepted 310 of 463, 1 checkpoints
中間值:24 workers
短 prompt 三筆為 75.4、75.5、75.6 tok/s;另有正式追加一筆 74.7。這是短 prompt 的中間檔位,沒有以 24 workers 跑同一組 99K 長 prompt。
pool24-engine.log:3 [strata] 2026-10-22 00:44:27 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 24 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
pool24-engine.log:21 strata generate: 24 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24, the host thread on 0 (draining too) (--host-core first)
pool24-engine.log:30 strata generate: 24 expert-pool workers + the host thread
pool24-engine.log:63 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1910 ms (782.4 tok/s), 512 generated in 6790 ms (75.4 tok/s), drafts accepted 314 of 461, 1 checkpoints
pool24-engine.log:94 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1917 ms (779.4 tok/s), 512 generated in 6784 ms (75.5 tok/s), drafts accepted 314 of 461, 1 checkpoints
pool24-engine.log:108 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1920 ms (778.0 tok/s), 512 generated in 6771 ms (75.6 tok/s), drafts accepted 309 of 466, 1 checkpoints
pool24-engine.log:112 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1921 ms (777.8 tok/s), 512 generated in 6853 ms (74.7 tok/s), drafts accepted 308 of 461, 1 checkpoints
原始 Strata Log:37 workers 優化後
短 prompt 三筆為 78.7、78.8、78.0 tok/s,中位數 78.7。99K 長 prompt 三筆為 65.3、75.2、77.9 tok/s,中位數 75.2。前三組中前兩組 MTP 接受數相同,但 decode 仍提高。
pool37-engine.log:3 [strata] 2026-10-22 00:47:14 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
pool37-engine.log:21 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
pool37-engine.log:30 strata generate: 37 expert-pool workers + the host thread
pool37-engine.log:63 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1906 ms (783.7 tok/s), 512 generated in 6505 ms (78.7 tok/s), drafts accepted 314 of 461, 1 checkpoints
pool37-engine.log:76 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1915 ms (780.3 tok/s), 512 generated in 6495 ms (78.8 tok/s), drafts accepted 309 of 466, 1 checkpoints
pool37-engine.log:89 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1909 ms (782.7 tok/s), 512 generated in 6565 ms (78.0 tok/s), drafts accepted 308 of 461, 1 checkpoints
pool37-engine.log:111 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57555 ms (1720.1 tok/s), 256 generated in 3923 ms (65.3 tok/s), drafts accepted 132 of 223, 4 checkpoints
pool37-engine.log:121 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57818 ms (1712.4 tok/s), 256 generated in 3405 ms (75.2 tok/s), drafts accepted 152 of 214, 4 checkpoints
pool37-engine.log:130 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58614 ms (1689.1 tok/s), 256 generated in 3288 ms (77.9 tok/s), drafts accepted 160 of 220, 4 checkpoints
負對照:37 workers 下測試 PCIe 0.10,但沒有保留
短 prompt 雖然到 80.6–82.9 tok/s,99K 長 prompt 波動很大:52.9、75.8、80.9,中位數 75.8,和 PCIe 0 的 75.2 差異不構成穩定收益,因此正式設定仍用 PCIe 0。
pool37-pcie010-engine.log:3 [strata] 2026-10-22 00:57:30 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.10 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
pool37-pcie010-engine.log:21 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
pool37-pcie010-engine.log:64 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1907 ms (783.5 tok/s), 512 generated in 6352 ms (80.6 tok/s), drafts accepted 315 of 447, 1 checkpoints
pool37-pcie010-engine.log:77 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 5043 ms (296.3 tok/s), 512 generated in 6177 ms (82.9 tok/s), drafts accepted 328 of 434, 1 checkpoints
pool37-pcie010-engine.log:91 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1910 ms (782.1 tok/s), 512 generated in 6288 ms (81.4 tok/s), drafts accepted 319 of 440, 1 checkpoints
pool37-pcie010-engine.log:104 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57510 ms (1721.5 tok/s), 256 generated in 4840 ms (52.9 tok/s), drafts accepted 149 of 250, 4 checkpoints
pool37-pcie010-engine.log:114 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58265 ms (1699.2 tok/s), 256 generated in 3377 ms (75.8 tok/s), drafts accepted 156 of 227, 4 checkpoints
pool37-pcie010-engine.log:118 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58953 ms (1679.4 tok/s), 256 generated in 3165 ms (80.9 tok/s), drafts accepted 165 of 210, 4 checkpoints
正式設定重啟後重跑:37 workers
正式 launcher 重啟後,短 prompt smoke 是 81.2 tok/s;同組 99K prompt 重跑為 64.6、74.6、77.4,中位數 74.6。此組最低一筆低於 70,表示 70+ 是中位附近,不是每次固定速度。
active-final-engine.log:1936 [strata] 2026-10-22 01:03:00 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
active-final-engine.log:1954 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
active-final-engine.log:1997 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1914 ms (780.4 tok/s), 512 generated in 6306 ms (81.2 tok/s), drafts accepted 316 of 453, 1 checkpoints
active-final-engine.log:2148 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57069 ms (1734.8 tok/s), 256 generated in 3964 ms (64.6 tok/s), drafts accepted 132 of 223, 4 checkpoints
active-final-engine.log:2161 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57501 ms (1721.8 tok/s), 256 generated in 3432 ms (74.6 tok/s), drafts accepted 152 of 214, 4 checkpoints
active-final-engine.log:2170 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57655 ms (1717.2 tok/s), 256 generated in 3307 ms (77.4 tok/s), drafts accepted 157 of 211, 4 checkpoints
結果界線
- 這是速度測試,不是 coding、Hermes 工具任務或 Telegram 任務測試;沒有測工具結果正確率、任務完成率或 soak。
- 短測 1494-token prompt 生成 512 tokens;99K prompt 生成 256 tokens。99K prompt 是本機固定合成英文段落,不是社群文章逐字 prompt。
- 速度改善最有力的證據是同模型/同 engine/同 prompt 下 worker-only 配對 A/B,再加正式重啟重跑;不能推論每一種 prompt 都會固定 75 tok/s。
- 15/24/37、PCIe 負對照和正式重跑的上述原始 engine log 行已直接嵌入本文,不需讀者存取本機檔案或點擊附件連結。
- 同一模型:GSQ-RCO abliterated IQ3_S,model ID