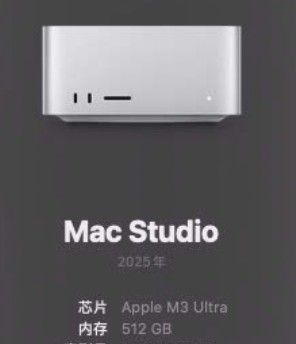
求M3 Ultra 512G 内存 模型推荐
-
-
-
-
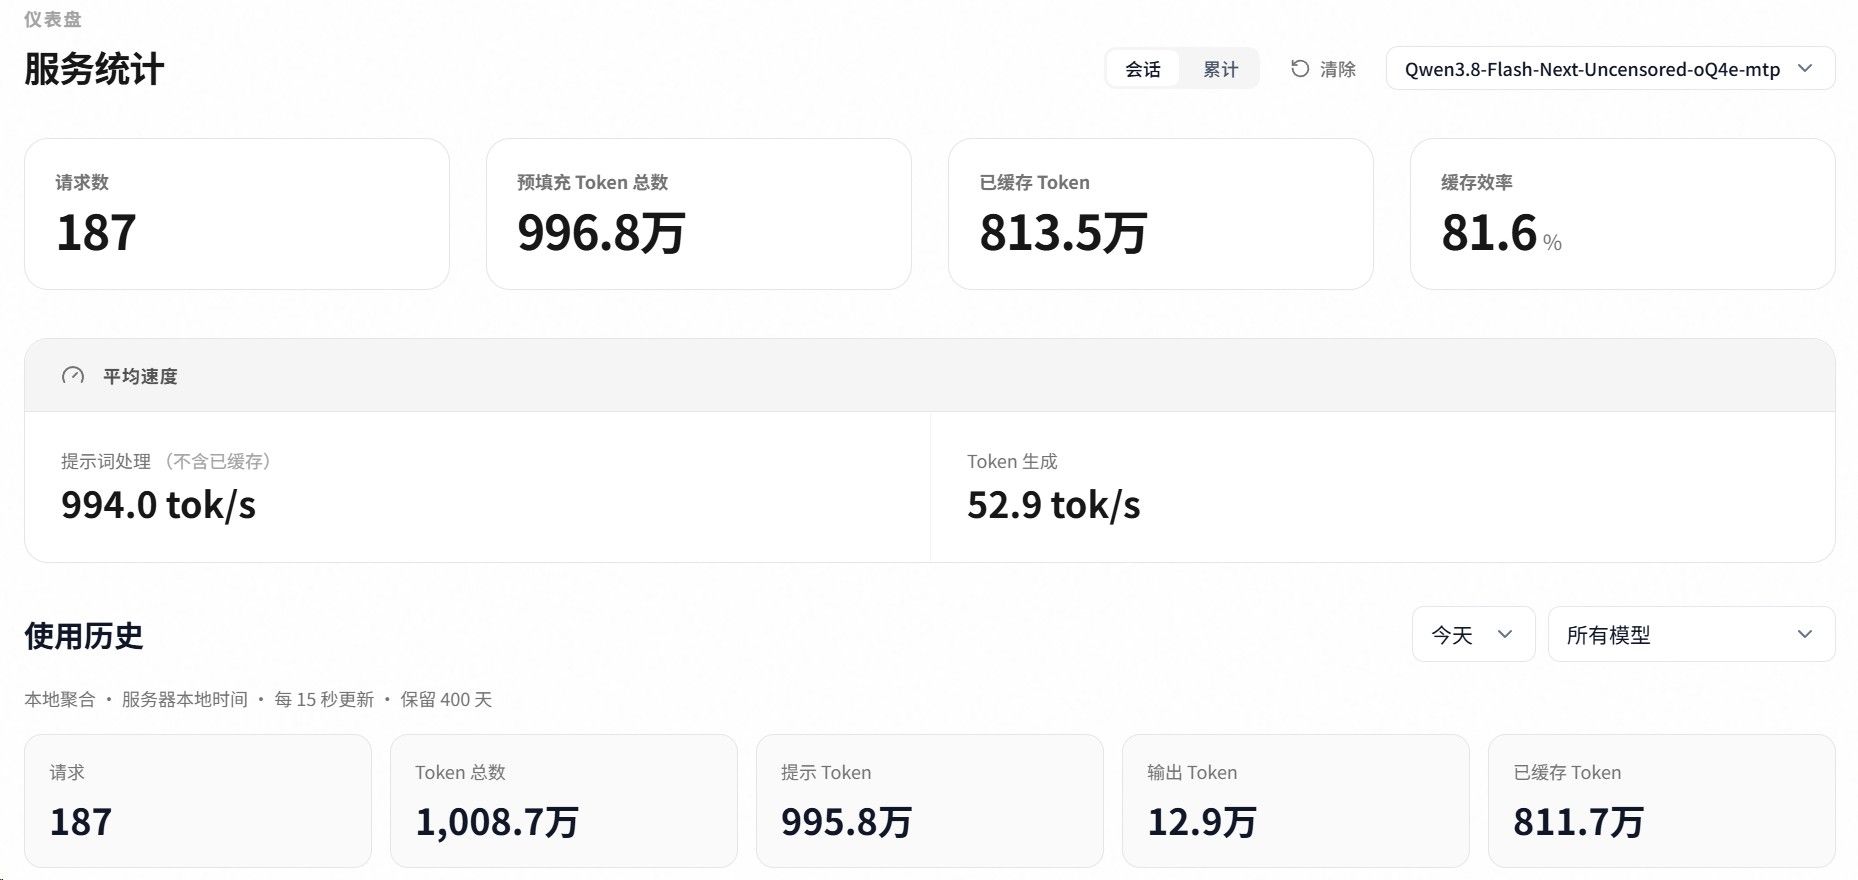
我记得M3U不是800GB/s的内存带宽吗?只有52.9 tok/s不应该啊。
https://github.com/nace-ai/kapitsa
关注下这个项目,专门为苹果优化的框架:
自报数(基准是它自己出的,口径需自行验证):
M4 Pro 48GB 上 Qwen3.6-35B-A3B 4bit decode 153.7/178.9 t/s、prefill 4K 1169 t/s;
Qwen3.8-27B 4bit decode 63.0/67.3(次优 45.3),prefill 4K 389(次优 136,2.6–2.9×);
不开投机时全引擎只有 13.3 t/s,即它一半的功劳来自投机解码。
M5 Max 128GB:35B-A3B decode 249.8/297.4、27B decode 72.9/83.7、Flash-Next 180B-A7B 101.8/107.6(内存 70.5GB vs oMLX 103.9GB)。 -
-
现在我使用的是omlx跑Qwen3.8-Flash-Next-Uncensored-oQ4e-mtp 它速度确实比较快
有没有更快的,qwen有时候会思考挺久的,我用它主要就是 搜资料 跑脚本什么的