跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 求M3 Ultra 512G 内存 模型推荐

求M3 Ultra 512G 内存 模型推荐

已定时 已固定 已锁定 已移动 LLM讨论区
apple-m3本地模型
6 帖子 6 发布者 184 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • OJmmO
    OJmmO
    OJmm
    编写于 最后由 编辑
    #1

    现在我使用的是omlx跑Qwen3.8-Flash-Next-Uncensored-oQ4e-mtp 它速度确实比较快
    有没有更快的,qwen有时候会思考挺久的,我用它主要就是 搜资料 跑脚本什么的
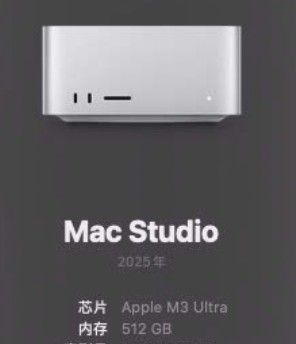
    image.jpeg
    image.jpeg

    johnnybegoodJ 1 条回复 最后回复
    0
    • kop wangK
      kop wangK
      kop wang
      易有太极
      编写于 最后由 编辑
      #2

      综合能力、速度等角度,我觉得降个量化精度到Q3级别,也就如此了。
      qwen3.6-35B-A3B肯定会快,但是能力降太多了,没有实际意义。

      虚心交流,一起进步

      1 条回复 最后回复
      0
      • fcmeF
        fcmeF
        fcme
        王侯将相
        编写于 最后由 编辑
        #3

        对,也就只能换那个IQ3xxs的版本,日常做办公类的完全没有任何问题。
        https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF

        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

        1 条回复 最后回复
        0
        • babyedi3B
          babyedi3B
          babyedi3
          编写于 最后由 编辑
          #4

          我记得M3U不是800GB/s的内存带宽吗?只有52.9 tok/s不应该啊。
          https://github.com/nace-ai/kapitsa
          关注下这个项目,专门为苹果优化的框架:
          自报数(基准是它自己出的,口径需自行验证):
          M4 Pro 48GB 上 Qwen3.6-35B-A3B 4bit decode 153.7/178.9 t/s、prefill 4K 1169 t/s;
          Qwen3.8-27B 4bit decode 63.0/67.3(次优 45.3),prefill 4K 389(次优 136,2.6–2.9×);
          不开投机时全引擎只有 13.3 t/s,即它一半的功劳来自投机解码。
          M5 Max 128GB:35B-A3B decode 249.8/297.4、27B decode 72.9/83.7、Flash-Next 180B-A7B 101.8/107.6(内存 70.5GB vs oMLX 103.9GB)。

          1 条回复 最后回复
          0
          • terryT
            terryT
            terry
            易有太极
            编写于 最后由 terry 编辑
            #5

            建议去关注SGLang,这个才是苹果的正解,M3 Ultra带宽虽然不如M5,但是800G也是很强了,它的缺点是算力弱了点,SGLang官方有移植版本,社区也有改进版。最近官方MLX版本支持了radix tree,这个玩意意味着你512G想要跑DS V4.1 Flash,硬件和软件底子都有了。它的效果是任何框架都不能比的。不过说稳定性还不好,你可以让AI Agent去研究下。

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            0
            • OJmmO OJmm

              现在我使用的是omlx跑Qwen3.8-Flash-Next-Uncensored-oQ4e-mtp 它速度确实比较快
              有没有更快的,qwen有时候会思考挺久的,我用它主要就是 搜资料 跑脚本什么的
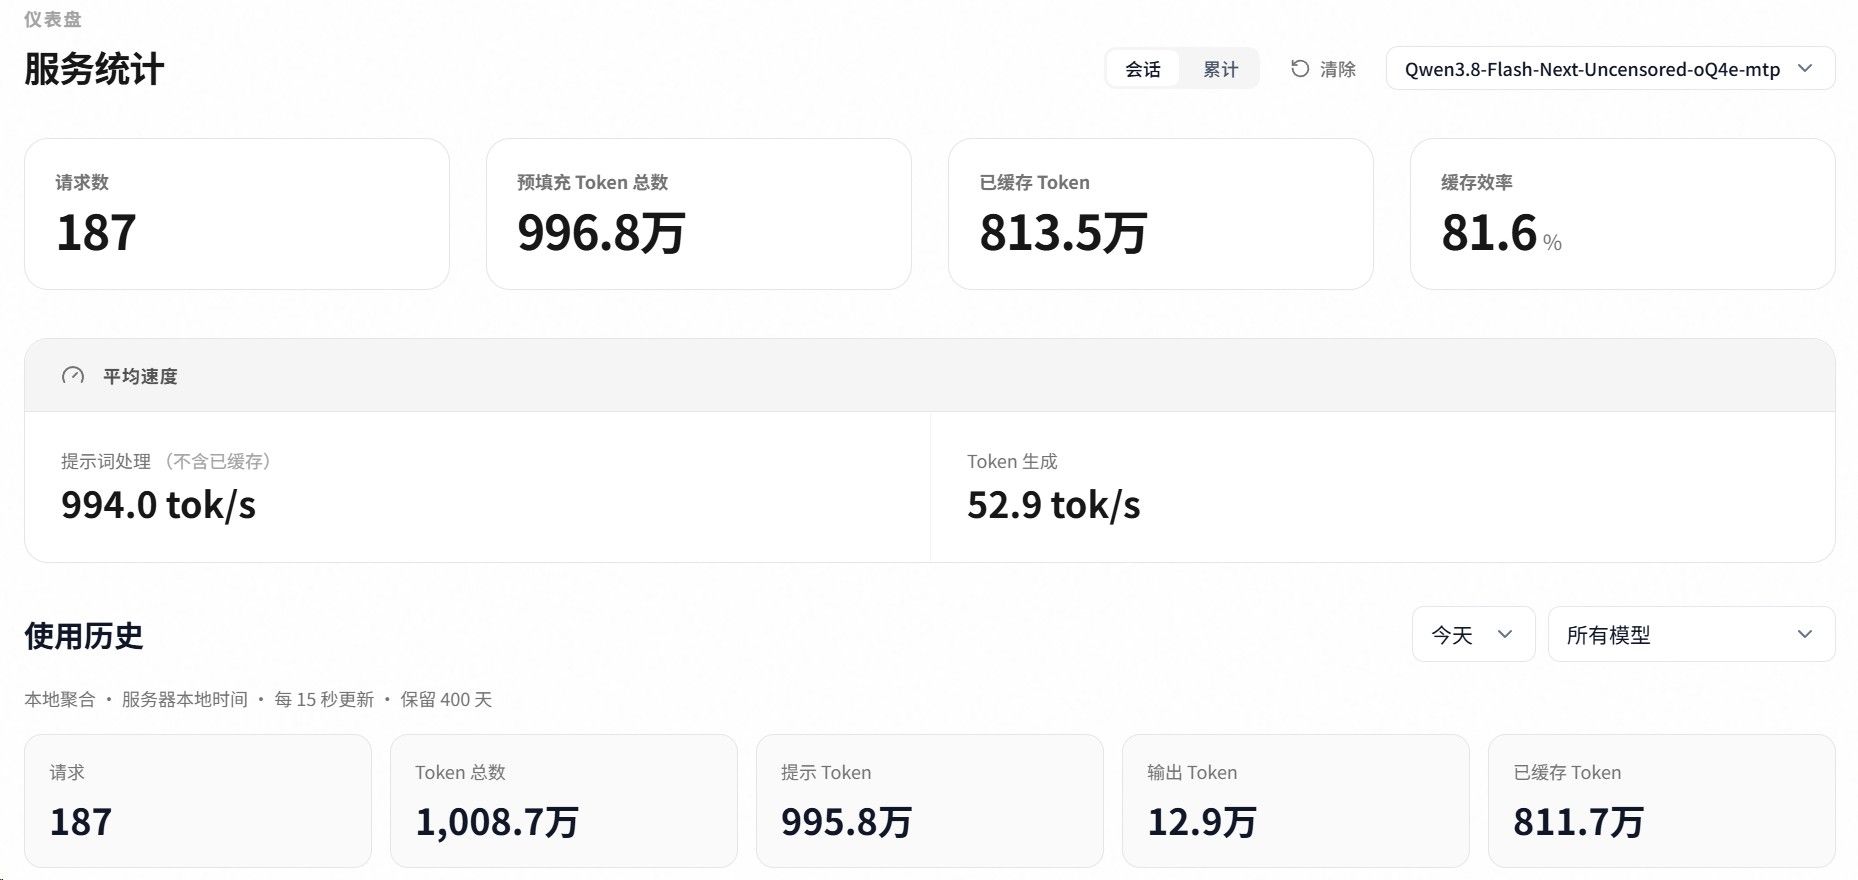
              image.jpeg
              image.jpeg

              johnnybegoodJ
              johnnybegoodJ
              johnnybegood
              王侯将相
              编写于 最后由 编辑
              #6

              @OJmm 机器是好机器, 但跑大模型真的不是它的赛道。

              1 条回复 最后回复
              0

              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

              有了你的建议,这篇帖子会更精彩哦 💗

              注册 登录
              回复
              • 在新帖中回复
              登录后回复
              • 从旧到新
              • 从新到旧
              • 最多赞同


              • 登录

              • 登录或注册以进行搜索。
              • 第一个帖子
                最后一个帖子
              0
              • 版块
              • 最新
              • 标签
              • 热门
              • 用户
              • 群组