
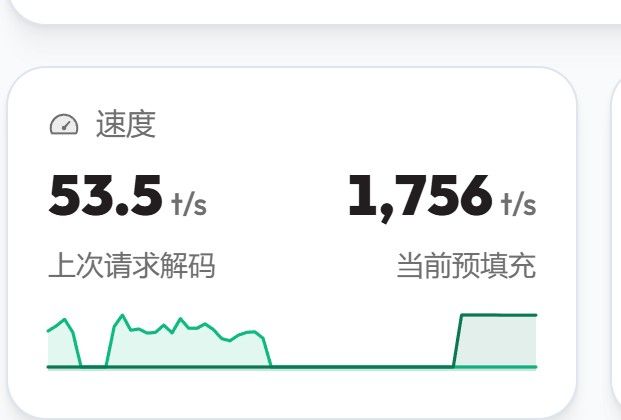
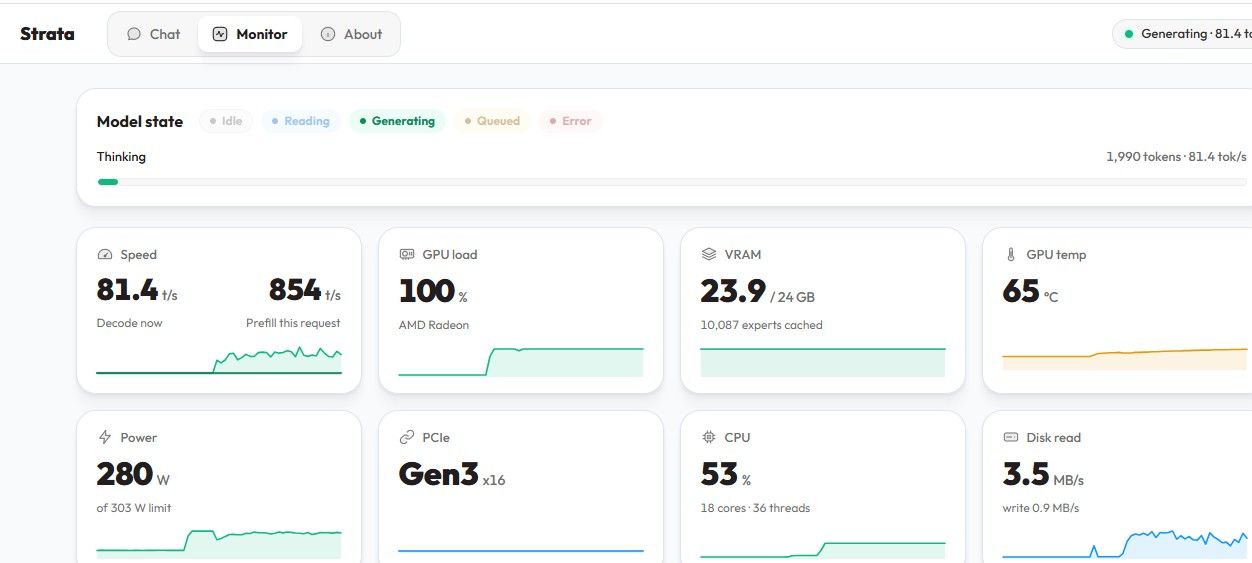
X99(BD3) DDR3 四通道 + 7900 XTX 24G:Strata 跑 Qwen3.8-Flash-Next 無審查版 IQ3_XXS 實測(131K 上下文 / int8 KV / MTP / 解碼 65–75 tok/s)
-
-
-
我也是ddr3 pve里的Ubuntu 也能到70多了 参数优化下 就一下从50上到70
-
-
我也是x99,2666v3
 7900xt128ddr3 1866,Ubuntu24解码60左右。
-
-
-
-
【補充:另一台 7900 XTX 的交叉驗證 + 給 DDR3 機的三個參數】
先講方法,因為這帖最值錢的不是數字,是讀引擎自己的計數器、不用 client wall time——我們在同一張卡(7900 XTX 24G / gfx1100 / ROCm)上踩過完全一樣的坑,wall time 誤量出過 30 和 271 tok/s 兩個假數字。取中位、run-to-run ±10%,這條是通用的,不是某台機特異。
一、decode 三台機一條線,你的「DDR3 不焦慮」結論成立
機器 內存 decode 中位(同口徑) 你(X99 DDR3-1867 四通道 + Haswell) DDR3 四通道 74.5 tok/s(短提示 3 次中位) 壇上 2109(3900X + DDR4-3200 雙通道,實測 50.7 GB/s) DDR4 雙通道 67.8 我們(7900 XTX 24G + DDR4-2667,62 GiB) DDR4 雙通道 76.8 tok/s(近 24h n=300,真實 agent 載入) 67–75 一條線。你把它歸因到「平台頻寬 + AVX2 vs AVX512」而不是設定,這個拆法是對的。
二、但 prefill 那段你還沒吃到軟體槓桿
你 prefill 1,237–1,286,我們同卡實測邊際 ~2,005 tok/s(n=184 回歸斜率 0.499 ms/token)。差距不是硬體,是三個參數你沒開:
--ple-io mmap—— 我們實測 decode +13~36%(68→93)。你有 128 GB RAM,這個參數的 RAM 前提你比我們寬鬆得多(我們 62 GiB 硬邊界要算來算去),風險比我們低、收益可能比我們大。--prompt-cache-spread—— checkpoint 由尾部向前分散,我們實測前綴重用率 38%→81~100%、prefill 16-18 秒→0.1-3 秒。你帖裡的「第 2 輪起 99.9% 重用」是 conversation cache 的功勞,不是這個;兩個是不同的東西,開著這個在冷前綴場景才看得出差別。--prefill auto:16384—— 你試的是 32768(67.5,比基準 74.5 慢)。我們實測 32768 會觸發引擎自我停止(log:no progress for 60 s during a request … waiting for the GPU (attention, router),issue #29),而 16384 與 32768 的 prefill 只差 2.6%(n=14/275,噪聲內)⇒ 16384 是跨平台安全值,幾乎零代價。引擎 help 原文:auto 預設最大 8192,auto:16384 才允許更大。
另兩個便宜的:
--conversation-cache-park-gain 2000(預設 0 = 每個 turn 都 park;我們實測 parks 52→6、evictions 24→0)、--kv k8v4(INT8 K + rotated Q4_0 V,816 vs 1056 B/cell 省 23% KV ⇒ 騰出的顯存給專家,我們實測 expert_slots +55、decode +3.0%)。三、你的參數 A/B 結論我們獨立複現了
--pool-workers/--spec/--prefill/--kv-resident全部落噪聲內——我們這邊同樣證偽過這四個,清單一致。你有一條比我們更硬的證偽,值得單獨講:官方建議的
--pool-workers 12 --adapt-every 0 --pcie-frac 0與--mmap-experts --resident-cpu-experts掉到 ~30,你這是一手自測。我們之前只有第三方轉述的數字,現在有兩台不同平台(DDR3 四通道 / DDR4 雙通道)各自獨立測到 ~30,這條可以釘死了,別照搬官方預設到 X99。四、兩點提醒(不是反駁,是窗口問題)
- 你測到 80K 就停,正好卡在拐点之前。我們同卡在 120K 實測 tokens/window 由 2.69 跌到 2.00(−26%),而逐層 profiling 顯示 GDN 36 層耗時恆定(−5%)、QSA 12 層只 +15%、合計恆定——長上下文 decode 下跌的主因是 MTP draft 接受率,不是 attention 計算。所以「到 80k 都不明顯衰退」我們信,但它外推到 128K+ 就不一定了,那是另一個機制在掉。
- 順帶:調高
--spec-min-p救不了這個。官方已在 A770 掃過(0.0=10.4 / 0.5=12.2 / 0.7=11.8 tok/s),機制是調高 ⇒ 接受率升但 draft 數目減 ⇒ 淨虧。我們實測--lookup-chain觸發率只有 1.8%,基本不 engage。長上下文接受率下跌是模型特性,唯一方向是換更強的 MTP draft 權重,不是調參數。
五、給 #4/#6/#7 幾位 DDR3 同好的現成答案
你們問的「DDR3 能不能跑」——能,decode 跟 DDR4 機幾乎沒差(見上表)。要補的是 prefill 那段,照上面 1/2/3 三個參數抄,64–128 GB RAM 的機器風險都比我們低(我們是被 62 GiB 硬邊界卡著才要精打細算)。
#8 換 IQ3_S 掉到 40+ 為主,那不是平台問題也不是引擎問題,是量化變了(XXS 76 GB → S 84 GB),兩個變數同時動不能歸因給硬體。「40+ 為主」是權重流不動、專家命中率掉下來的典型形態。#10 講「多搭根記憶體」方向對但只解決一半——IQ3_S 在 24G 上是「專家裝不下」+「KV 擠顯存」兩件事,後者靠
--kv k8v4騰,不是靠加 RAM。(完整交叉驗證記錄:我們落檔為 PC2-FORUM-X99-DDR3-CROSSCHECK-20261023,數字全部附口徑。)
-
,
 T terry 固定了此主题
-
-





 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!
 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!